Tendencias en el aprendizaje automático 2026: los cambios tecnológicos y su impacto en las empresas

12 de noviembre de 2026 17 min leer
Responsable de los departamentos de Big Data, IA, aprendizaje automático y ciencia de datos
Experto verificado
Todos los artículos de Innowise están escritos por autores con experiencia práctica. Entienden el tema más allá de la teoría y aportan conocimientos basados en proyectos reales.
11+ años de experiencia
Experto verificado
11+ años de experiencia
Philip crea infraestructuras de datos que aportan claridad. Se centra en el «porqué» de los datos y diseña sistemas que procesan volúmenes masivos y los transforman en información útil, al tiempo que se asegura de que la visión técnica se mantenga clara y orientada a los objetivos.
Experiencia
Big data IA & ML Python
Hablemos

Principales conclusiones

  • El aprendizaje automático en 2026 se está volviendo más práctico. Gran parte de los avances se centran en la reutilización, la eficiencia, la supervisión, la calibración y en facilitar la ejecución de los modelos en entorno de producción.
  • Los modelos preentrenados y auto-supervisados están cambiando la cantidad de trabajo que hay que realizar desde cero. Los modelos base tabulares, las representaciones visuales reutilizables y los datos de entrenamiento sintéticos pueden reducir parte del trabajo habitual de entrenamiento y etiquetado.
  • Las limitaciones de implementación son más importantes que los buenos resultados en las pruebas de rendimiento. La latencia, la memoria, el consumo energético, la deriva, el rendimiento de los subgrupos y el coste de la inferencia pueden ser más importantes que conseguir mejorar la precisión en otra fracción de un por ciento.
  • Estas mismas tendencias están transformando flujos de trabajo muy distintos. En el sector minorista, esto se refleja en las previsiones y las recomendaciones; en la banca, en el fraude y el riesgo crediticio; en la sanidad, en la priorización de pacientes; en la industria manufacturera, en el mantenimiento predictivo y la detección de defectos; y en la logística, en las horas estimadas de llegada y la predicción de retrasos.
  • Hay algunas áreas prometedoras que aún se encuentran en una fase muy temprana de desarrollo. El aprendizaje continuo, el aprendizaje automático causal, los modelos híbridos, la adaptación entre dominios y la predicción que tiene en cuenta la incertidumbre parecen útiles, pero yo distinguiría entre lo que ya se ha demostrado y lo que está listo para su implementación.
Resumir artículo con IA

El aprendizaje automático ya no es interesante. Esa es la tendencia.

O, al menos, gran parte de los avances interesantes se están produciendo en ámbitos que no dan mucho juego a la hora de crear titulares: reducir en 40 milisegundos el tiempo de inferencia, entrenar con menos etiquetas, reutilizar un modelo en lugar de crear otro nuevo, descubrir por qué un sistema con una precisión del 96 % sigue fallando con el mismo grupo de usuarios.

Y esto probablemente sea una buena noticia. Creo que la mayoría de las empresas no necesitan realmente un gran avance en el aprendizaje automático. No les importaría contar con un buen modelo que siga funcionando cuando cambien los datos, que no cueste una fortuna mantenerlo en marcha y que avise cuando empiece a comportarse de forma extraña.

Veamos, pues, las últimas tendencias en aprendizaje automático para ver hacia dónde se dirige este trabajo.

Pon el aprendizaje automático a trabajar

Panorama general y previsiones del mercado del aprendizaje automático

El mercado del aprendizaje automático está creciendo rápidamente. Pero nadie se pone de acuerdo sobre cuál es su tamaño exacto.

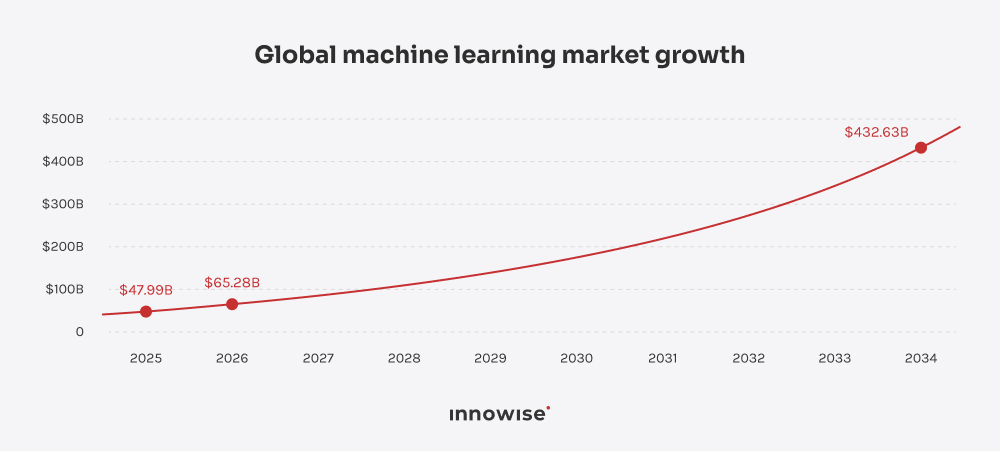
Fortune Business Insights estima que el mercado mundial del aprendizaje automático alcanzará 65 280 millones de dólares en 2026 y prevé que llegue a 432 630 millones de dólares en 2034. The Business Research Company ofrece una estimación mucho mayor para ese mismo año: 127 940 millones de dólares en 2026, cifra que aumentará hasta 445 250 millones de dólares en 2030.

Global machine learning market growth 2025-2034.

Eso supone casi el doble para 2026. En general, esto nos indica que el “mercado del aprendizaje automático” es una categoría sorprendentemente elástica: los distintos analistas incluyen diferentes combinaciones de software, infraestructura, servicios y hardware.

Los detalles de las previsiones también resultan útiles. Fortune prevé que la implementación en la nube represente el 53,14 % del mercado del aprendizaje automático en 2026, con las grandes empresas representando el 55,61 % y IT y telecomunicaciones con un 17,56 % del uso final.

Por su parte, Gartner prevé que el gasto en plataformas de IA para la ciencia de datos y el aprendizaje automático alcance los 26 440 millones de dólares en 2026, lo que supone un aumento del 36,3 % respecto a 2025.

Por eso, yo no me fijaría demasiado en una sola cifra gigantesca del mercado. Lo importante es la tendencia: el gasto está aumentando, la nube acapara una gran parte de las implementaciones y las herramientas relacionadas con el aprendizaje automático se están convirtiendo en un mercado considerable por sí mismas.

Ahora, veamos las tendencias recientes en el propio aprendizaje automático.

Tendencias actuales en el aprendizaje automático

Algunas de las principales tendencias en aprendizaje automático son nuevas. Otras llevan años entre nosotros y solo ahora están adquiriendo la viabilidad suficiente como para salir del ámbito de los equipos de investigación. Para ser sincero, me interesa más el segundo grupo, pero, en fin, vamos al grano.

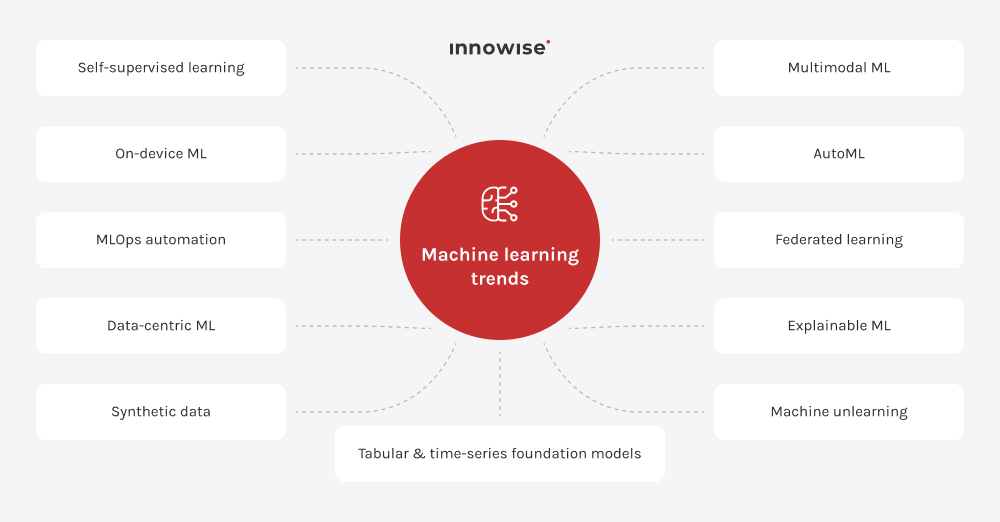
Key machine learning trends this year.

Modelos de base para datos tabulares y series temporales

Las tablas están viviendo su momento "Foundation Model".

En junio de 2026, Google presentó TabFM, un modelo para la clasificación y regresión tabular que puede realizar predicciones en nuevos conjuntos de datos sin necesidad de pasar por el proceso habitual de entrenamiento específico para cada tarea ni de ajuste de hiperparámetros. Google lo probó en 38 conjuntos de datos de clasificación y 13 de regresión, incluidas tablas con hasta 150 000 muestras.

¿Qué tiene de curioso? La forma en que se entrenó. No existe un gigantesco almacén público de tablas empresariales limpias, por lo que Google generó cientos de millones de conjuntos de datos sintéticos en su lugar.

Yo no descartaría XGBoost todavía. Para muchos problemas de datos estructurados, los modelos convencionales siguen siendo más baratos, más fáciles de depurar y muy difíciles de superar. Pero la idea de abrir un nuevo conjunto de datos y obtener una referencia decente sin tener que pasar por otra maratón de ajustes resulta bastante atractiva.

Y las series temporales van en la misma dirección. El TimesFM de Google está preentrenado con grandes conjuntos de datos de series temporales y puede generar previsiones «zero-shot» para conjuntos de datos que no ha visto antes. El atractivo es similar al de TabFM: se requiere menos entrenamiento específico para cada tarea cada vez que alguien necesita una nueva previsión de demanda, tráfico o capacidad.

¿Sustituiría con él todos los procesos de previsión existentes? No. Pero merece la pena probarlo cuando la alternativa es otra ronda de entrenamiento y ajuste del modelo desde cero.

El aprendizaje autosupervisado requiere menos etiquetas

El etiquetado de datos es una de esas tareas que todo el mundo considera esencial, pero por la que nadie está dispuesto a pagar.

El aprendizaje autosupervisado sortea parte de ese problema aprendiendo primero representaciones útiles a partir de datos sin etiquetar y, a continuación, adaptándolas a un conjunto de datos etiquetados más pequeño.

El DINOv3 de Meta es un buen ejemplo. Se entrenó con 1.7 mil millones de imágenes sin etiquetas humanas, y el modelo más grande alcanzó los 7 mil millones de parámetros. La misma estructura visual «congelada» puede entonces dar soporte a tareas como la clasificación, la detección de objetos, la segmentación y el seguimiento.

Para las empresas que cuentan con años de fotos de inspección, imágenes satelitales, imágenes médicas o vídeos sin etiquetar, esto cambia un poco la ecuación económica. Es posible que sigas necesitando etiquetas, pero quizá no varios millones de ellas.

Los modelos más pequeños vuelven a despertar interés

Un modelo tan bonito que necesita un centro de datos para responder a una pregunta sencilla tiene un atractivo limitado en un teléfono, un sensor, una cámara o un controlador industrial.

Por eso, la compresión de modelos sigue acaparando cada vez más atención: la cuantificación reduce la precisión numérica, la poda elimina los pesos menos útiles y la destilación transfiere el conocimiento a un modelo más pequeño. El propio kit de herramientas de optimización de TensorFlow’s propio conjunto de herramientas de optimización enumera la latencia, el uso de memoria, el consumo energético y el tamaño del modelo como restricciones fundamentales para el despliegue en el borde.

Aquí no hay nada gratis. Si se comprime de forma demasiado agresiva, la precisión disminuye.

La tarea consiste en encontrar el punto en el que nadie lo note, salvo en la factura de la infraestructura.

MLOps cada vez es menos opcional

Entrenar el modelo nunca fue todo el trabajo. Simplemente dedicamos una cantidad sorprendente de tiempo a fingir que sí lo era.

Una vez que un sistema de aprendizaje automático está en producción, alguien tiene que saber qué conjunto de datos lo generó, qué versión del código lo entrenó, si los datos de entrada han cambiado, si el rendimiento está variando, cuándo se permite volver a entrenarlo y cómo revertir una versión defectuosa.

Las herramientas están reflejando esto. MLflow 3, por ejemplo, ha ampliado su arquitectura de gestión de modelos para ofrecer un linaje más sólido y una mejor comparación entre las versiones de los modelos y los experimentos.

Probablemente sea una de las tendencias de aprendizaje automático menos glamurosas de la lista, y una de las que yo me tomaría más en serio.

Los datos sintéticos se someten a una prueba de realidad

Los datos sintéticos parecen una idea estupenda. ¿Faltan ejemplos? Crea algunos.

Eso puede funcionar. También puede hacer que un modelo sea muy bueno a la hora de comprender un mundo artificial que, en realidad, no existe del todo.

Un artículo de investigación de Apple de 2026 analizó la combinación de datos de entrenamiento reales y sintéticos y descubrió algo más útil que el simple hecho de que “los datos sintéticos ayudan”. Sus resultados sugieren que puede existir una proporción óptima: al añadir datos sintéticos, el rendimiento mejora hasta cierto punto, pero luego empieza a empeorar a medida que las distribuciones sintéticas y reales se alejan demasiado entre sí.

El aprendizaje automático multimodal se aplica a la predicción habitual

"Multimodal" no tiene por qué referirse necesariamente a un modelo capaz de analizar tu foto y escribir un poema sobre ella.

En el caso del aprendizaje automático predictivo, puede ser mucho menos emocionante y mucho más útil: imagen del producto + descripción + precio, exploración médica + historial del paciente, lecturas de sensores + notas de mantenimiento.

Las herramientas actuales de AutoGluon, por ejemplo, pueden combinar datos de imágenes, texto, tablas y documentos para tareas que incluyen la clasificación y la regresión.

Lo complicado viene después. ¿Qué ocurre si falta la imagen? ¿O si el sensor deja de funcionar? ¿O si una fuente de datos llega dos horas más tarde que las demás?

Eso debe formar parte de la evaluación, no ser una sorpresa que se descubra tras el lanzamiento.

AutoML sigue eliminando las partes aburridas

La selección de modelos, el ajuste de hiperparámetros, el ensamblaje de modelos y algunas partes del procesamiento de características: gran parte de esto ya se puede automatizar bastante bien.

Bien.

No estoy convencido de que un ingeniero de aprendizaje automático con un sueldo elevado tenga que pasar una tarde probando manualmente 47 combinaciones de tasa de aprendizaje y profundidad de árbol solo para demostrar su dedicación al oficio.

Lo que AutoML no automatiza muy bien es decidir si el objetivo tiene sentido, si los datos de entrenamiento revelan información del futuro, si la métrica de evaluación refleja el coste empresarial o si el modelo debería existir siquiera.

Esos siguen siendo problemas incómodamente humanos.

El aprendizaje federado aún no es sinónimo de privacidad

El aprendizaje federado presenta una configuración muy atractiva: permite entrenar modelos en varios dispositivos u organizaciones sin necesidad de trasladar todos los datos sin procesar a una base de datos central.

Útil, sí. ¿Privado de forma automática? No.

El NIST ha documentado ataques que pueden recuperar información de las actualizaciones del modelo intercambiadas durante el entrenamiento federado, y recomienda medidas de protección adicionales en lugar de considerar la descentralización en sí misma como una garantía de privacidad.

Y las implementaciones reales son complicadas. Los distintos dispositivos tienen capacidades de cálculo diferentes, los participantes desaparecen, las distribuciones de datos varían y las suposiciones de seguridad se rompen. El informe de revisión de la implementación de 2024 del NIST pone de manifiesto con bastante claridad la brecha entre la teoría del aprendizaje federado y los sistemas de producción.

Un experto citado en dicho informe, el Dr. Mat Weldon, de la Oficina Nacional de Estadística del Reino Unido, lo expresó mejor de lo que yo podría hacerlo:

“Es más fácil diseñar una nueva arquitectura de aprendizaje federado que realizar un ataque simulado contra ella.”

Es cierto.

La explicabilidad se vuelve menos formal

Durante años, añadir un gráfico SHAP a un panel de control podía hacer que un modelo pareciera satisfactoriamente “explicable”.

Es un listón muy bajo.

El NIST distingue entre explicabilidad, es decir, comprender cómo un sistema ha generado un resultado, y interpretabilidad, que se refiere al significado de ese resultado en su contexto. Sus directrices también recomiendan probar los métodos de explicación antes de su implementación, en lugar de dar por sentado que la explicación es correcta solo porque el gráfico parezca convincente.

Los investigadores del NIST publicaron un trabajo en 2026 sobre la validación explicable y la reducción de características, lo cual resulta interesante porque acerca la explicabilidad a las pruebas del modelo, en lugar de dejarla como una capa añadida a posteriori.

Me gusta esa orientación. Una explicación debería ser algo que probemos, no un adorno para la ficha del modelo.

El «desaprendizaje» de las máquinas se convierte en un auténtico reto de ingeniería

Supongamos que alguien te pide que borres sus datos.

Boras el registro de la base de datos.

Bien.

¿Pero qué pasa con el modelo que ya se ha entrenado con esos datos?

Ahí es donde entra en juego el "desaprendizaje automático": eliminar la influencia de datos de entrenamiento concretos sin tener que volver a entrenar todo el modelo desde cero. En junio de 2026, Google Research publicó un marco para auditar si un modelo «desaprendido» se comporta realmente más como un modelo recién reentrenado que como el original.

Y esa segunda parte es importante. Olvidar algo es un problema. Demostrar que el modelo lo ha olvidado es otro.

El «desaprendizaje» de las máquinas sigue estando mucho más cerca de la investigación activa que de las herramientas empresariales habituales, pero yo le prestaría atención. En el momento en que «borra mis datos» tenga que significar algo más que borrar una fila, esto dejará de ser teórico.

Crea una solución de aprendizaje automático para tu empresa

Cómo las tendencias en inteligencia artificial están transformando los flujos de trabajo en todos los sectores

La misma tendencia en el aprendizaje automático puede comportarse de forma muy diferente una vez que se integra en un flujo de trabajo real. En el sector minorista, una inferencia más rápida puede suponer actualizar las recomendaciones mientras el cliente sigue navegando por la web. En el sector manufacturero, puede significar detectar un defecto antes de que el producto haya avanzado por la línea de producción.

  • Educación
  • Venta al por menor y comercio electrónico
  • Banca y finanzas
  • Salud
  • Fabricación
  • Logística y transporte

Educación

Las plataformas educativas ya disponen de una gran cantidad de datos: respuestas, intentos, tiempos de respuesta, ejercicios omitidos y progreso en los cursos. Lo más difícil es convertir todo eso en algo útil sin pretender que un modelo comprenda a un alumno mejor que un profesor.

El aprendizaje automático ya era el el segmento tecnológico más importante del mercado de la inteligencia artificial aplicada a la educación en 2025, siendo el seguimiento del rendimiento, la personalización y la tutoría inteligente algunas de sus principales aplicaciones.

  • Adapta la dificultad y la secuencia de los ejercicios basándose en los resultados anteriores, en lugar de obligar a todo el mundo a seguir el mismo camino.
  • Predecir el riesgo de abandono escolar a partir de patrones como la disminución de la participación, los fracasos repetidos o los largos intervalos entre sesiones.
  • Detectar antes las lagunas de conocimiento y revisar el programa antes de que el alumno llegue al siguiente tema sin estar en absoluto preparado.
Venta al por menor y comercio electrónico

El sector minorista lleva años utilizando el aprendizaje automático, pero los cambios más interesantes se están produciendo en cuanto a la velocidad y la variedad de datos. Las previsiones pueden actualizarse con mayor frecuencia, las recomendaciones pueden basarse en algo más que el historial de compras y la búsqueda visual puede combinar imágenes con descripciones de productos y datos del catálogo.

  • Prever la demanda y automatizar la reposición utilizando el historial de ventas, la estacionalidad, las promociones y datos operativos más recientes.
  • Personalizar las recomendaciones a partir del comportamiento de navegación y compra, en lugar de segmentos de clientes estáticos.
  • Mejorar la búsqueda de productos mediante la combinación de datos de texto e imágenes, lo cual resulta útil cuando el cliente no sabe cómo se llama el artículo, pero tiene una foto.

Banca y finanzas

En el sector bancario, la supervisión de los modelos, la explicabilidad y la deriva son aspectos que resulta difícil pasar por alto. Los patrones de fraude cambian, el comportamiento de los clientes cambia, y un modelo que parecía adecuado hace seis meses puede resultar muy costoso en muy poco tiempo.

El mercado global de aprendizaje automático en banca El mercado tenía un valor aproximado de 40 000 millones de dólares en 2025 y se prevé que alcance aproximadamente 150 000 millones de dólares para 2034según Fortune Business Insights.

  • Detectar transacciones sospechosas y clasificar los casos para que los investigadores empiecen por los que parecen más peligrosos.
  • Explica decisiones crediticias mostrando qué factores eran los que más influían en la puntuación.
  • Supervisar la deriva del modelo a medida que cambian las técnicas de fraude, los hábitos de gasto y los perfiles de los clientes.

Salud

La asistencia sanitaria es uno de esos ámbitos en los que una buena cifra de referencia no es, ni mucho menos, suficiente. Los modelos pueden comportarse de forma diferente según el hospital, el grupo de pacientes, los dispositivos y el entorno clínico, por lo que la calibración y la supervisión son tan importantes como los datos brutos rendimiento predictivo.

Se estima que el mercado mundial de análisis predictivo en el sector sanitario asciende a 19 700 millones de dólares en 2026 por Investigación de Grand View, que prevé que alcance 49 300 millones de dólares para 2033.

  • Detectar los primeros signos de deterioro, incluido el riesgo de sepsis, antes de que la situación se haga evidente desde el punto de vista clínico.
  • Predecir el riesgo de reingreso y dar prioridad al seguimiento de los pacientes con mayor probabilidad de volver.
  • Clasificar los casos para su revisión para que los profesionales sanitarios puedan centrar su atención en los casos en los que el riesgo previsto es mayor.

Fabricación

El sector manufacturero es probablemente el ejemplo más claro para el aprendizaje automático en el propio dispositivo. Si una cámara está inspeccionando piezas que se desplazan por una línea de producción, a menudo no tiene mucho sentido enviar todas las imágenes a la nube y esperar una respuesta.

El mercado general de la inteligencia artificial en el sector manufacturero se estima en 9.85 mil millones de dólares en 2026, utilizando el aprendizaje automático y la visión artificial para el mantenimiento predictivo, la inspección, el control de calidad y la planificación de la producción.

  • Predecir los fallos de los equipos en función de las vibraciones, la temperatura, la presión y el historial de mantenimiento.
  • Detectar defectos mediante visión artificial mientras el producto aún se encuentra en la línea de producción.
  • Predecir la calidad del producto a partir de los parámetros de fabricación antes de la inspección final.

Logística y transporte

La logística está plagada de problemas de predicción, lo que la convierte en un campo de aplicación ideal para el aprendizaje automático: horas de llegada, retrasos, demanda en los almacenes, tráfico, cambios de ruta, conexiones perdidas.

El Se estima que el mercado del aprendizaje automático en el sector logístico alcanzará los 5.3 mil millones de dólares en 2026 y se prevé que alcance 44 500 millones de dólares para 2035según Perspectivas del mercado mundial.

En este caso, la incertidumbre también es importante. “Llegada prevista a las 14:10” y “Llegada prevista a las 14:10, pero no estamos seguros” son dos datos muy diferentes para alguien que está esperando en un muelle de carga.

  • Predecir las horas de llegada teniendo en cuenta los retrasos históricos, las condiciones del tráfico y la posición de los vehículos en tiempo real.
  • Retrasos previstos en los envíos con suficiente antelación para adaptar los planes de almacén o de entrega.
  • Prever la duración de los desplazamientos y la demanda para facilitar la planificación de rutas y la asignación de la flota.

Educación

Las plataformas educativas ya disponen de una gran cantidad de datos: respuestas, intentos, tiempos de respuesta, ejercicios omitidos y progreso en los cursos. Lo más difícil es convertir todo eso en algo útil sin pretender que un modelo comprenda a un alumno mejor que un profesor.

El aprendizaje automático ya era el el segmento tecnológico más importante del mercado de la inteligencia artificial aplicada a la educación en 2025, siendo el seguimiento del rendimiento, la personalización y la tutoría inteligente algunas de sus principales aplicaciones.

  • Adapta la dificultad y la secuencia de los ejercicios basándose en los resultados anteriores, en lugar de obligar a todo el mundo a seguir el mismo camino.
  • Predecir el riesgo de abandono escolar a partir de patrones como la disminución de la participación, los fracasos repetidos o los largos intervalos entre sesiones.
  • Detectar antes las lagunas de conocimiento y revisar el programa antes de que el alumno llegue al siguiente tema sin estar en absoluto preparado.

Venta al por menor y comercio electrónico

El sector minorista lleva años utilizando el aprendizaje automático, pero los cambios más interesantes se están produciendo en cuanto a la velocidad y la variedad de datos. Las previsiones pueden actualizarse con mayor frecuencia, las recomendaciones pueden basarse en algo más que el historial de compras y la búsqueda visual puede combinar imágenes con descripciones de productos y datos del catálogo.

  • Prever la demanda y automatizar la reposición utilizando el historial de ventas, la estacionalidad, las promociones y datos operativos más recientes.
  • Personalizar las recomendaciones a partir del comportamiento de navegación y compra, en lugar de segmentos de clientes estáticos.
  • Mejorar la búsqueda de productos mediante la combinación de datos de texto e imágenes, lo cual resulta útil cuando el cliente no sabe cómo se llama el artículo, pero tiene una foto.

Banca y finanzas

En el sector bancario, la supervisión de los modelos, la explicabilidad y la deriva son aspectos que resulta difícil pasar por alto. Los patrones de fraude cambian, el comportamiento de los clientes cambia, y un modelo que parecía adecuado hace seis meses puede resultar muy costoso en muy poco tiempo.

El mercado global de aprendizaje automático en banca El mercado tenía un valor aproximado de 40 000 millones de dólares en 2025 y se prevé que alcance aproximadamente 150 000 millones de dólares para 2034según Fortune Business Insights.

  • Detectar transacciones sospechosas y clasificar los casos para que los investigadores empiecen por los que parecen más peligrosos.
  • Explica decisiones crediticias mostrando qué factores eran los que más influían en la puntuación.
  • Supervisar la deriva del modelo a medida que cambian las técnicas de fraude, los hábitos de gasto y los perfiles de los clientes.

Salud

La asistencia sanitaria es uno de esos ámbitos en los que una buena cifra de referencia no es, ni mucho menos, suficiente. Los modelos pueden comportarse de forma diferente según el hospital, el grupo de pacientes, los dispositivos y el entorno clínico, por lo que la calibración y la supervisión son tan importantes como los datos brutos rendimiento predictivo.

Se estima que el mercado mundial de análisis predictivo en el sector sanitario asciende a 19 700 millones de dólares en 2026 por Investigación de Grand View, que prevé que alcance 49 300 millones de dólares para 2033.

  • Detectar los primeros signos de deterioro, incluido el riesgo de sepsis, antes de que la situación se haga evidente desde el punto de vista clínico.
  • Predecir el riesgo de reingreso y dar prioridad al seguimiento de los pacientes con mayor probabilidad de volver.
  • Clasificar los casos para su revisión para que los profesionales sanitarios puedan centrar su atención en los casos en los que el riesgo previsto es mayor.

Fabricación

El sector manufacturero es probablemente el ejemplo más claro para el aprendizaje automático en el propio dispositivo. Si una cámara está inspeccionando piezas que se desplazan por una línea de producción, a menudo no tiene mucho sentido enviar todas las imágenes a la nube y esperar una respuesta.

El mercado general de la inteligencia artificial en el sector manufacturero se estima en 9.85 mil millones de dólares en 2026, utilizando el aprendizaje automático y la visión artificial para el mantenimiento predictivo, la inspección, el control de calidad y la planificación de la producción.

  • Predecir los fallos de los equipos en función de las vibraciones, la temperatura, la presión y el historial de mantenimiento.
  • Detectar defectos mediante visión artificial mientras el producto aún se encuentra en la línea de producción.
  • Predecir la calidad del producto a partir de los parámetros de fabricación antes de la inspección final.

Logística y transporte

La logística está plagada de problemas de predicción, lo que la convierte en un campo de aplicación ideal para el aprendizaje automático: horas de llegada, retrasos, demanda en los almacenes, tráfico, cambios de ruta, conexiones perdidas.

El Se estima que el mercado del aprendizaje automático en el sector logístico alcanzará los 5.3 mil millones de dólares en 2026 y se prevé que alcance 44 500 millones de dólares para 2035según Perspectivas del mercado mundial.

En este caso, la incertidumbre también es importante. “Llegada prevista a las 14:10” y “Llegada prevista a las 14:10, pero no estamos seguros” son dos datos muy diferentes para alguien que está esperando en un muelle de carga.

  • Predecir las horas de llegada teniendo en cuenta los retrasos históricos, las condiciones del tráfico y la posición de los vehículos en tiempo real.
  • Retrasos previstos en los envíos con suficiente antelación para adaptar los planes de almacén o de entrega.
  • Prever la duración de los desplazamientos y la demanda para facilitar la planificación de rutas y la asignación de la flota.
El modelo que sale mejor parado en las pruebas comparativas no siempre es el que yo elegiría para ponerlo en producción. Una vez que se tienen en cuenta la latencia, el coste de la infraestructura, la deriva y el mantenimiento, un modelo ligeramente menos preciso puede convertirse fácilmente en la mejor decisión desde el punto de vista de la ingeniería.
Dmitry Nazarevich, CTO.
Dmitry Nazarevich
Director de Tecnología

Tendencias futuras del aprendizaje automático

Algunas ideas de aprendizaje automático ya resultan útiles hoy en día. Otras aún necesitan mejores pruebas comparativas, recursos informáticos más económicos o algunas experiencias desagradables en producción antes de que pueda considerarlas listas.

Estas son las tendencias emergentes en aprendizaje automático a las que seguiría prestando atención.

  • Cross-domain generalization and adaptation icon.

    Generalización y adaptación entre dominios

    Uno de los problemas más antiguos del aprendizaje automático sigue muy vigente: si entrenas un modelo en un entorno y luego lo trasladas a otro ligeramente diferente, verás cómo disminuye su rendimiento.

    La generalización de dominio trata de conseguir que los modelos se mantengan válidos en distribuciones de datos que no han visto antes. Un estudio de 2026 sobre la clasificación de patrones en entornos desconocidos describe exactamente este problema: los cambios en los sensores, las condiciones de adquisición u otras características del dominio pueden ser suficientes para perjudicar gravemente a un modelo.

    La versión práctica es fácil de imaginar. Un modelo de visión artificial entrenado en una fábrica tiene que funcionar en otra fábrica con cámaras diferentes. Un modelo médico se traslada a otro hospital. Un modelo de detección de fraudes se enfrenta a un nuevo grupo de clientes.

    Sospecho que esto dejará de ser una especialidad de investigación para convertirse más bien en un requisito básico de implementación.

  • Continual learning icon.

    Aprendizaje continuo

    La mayoría de los modelos de producción siguen aprendiendo por etapas: recopilan nuevos datos, se vuelven a entrenar, se validan y se vuelven a implementar.

    El aprendizaje continuo tiene como objetivo lograr un proceso más fluido. El modelo sigue aprendiendo a medida que llegan nuevos datos, sin olvidar lo que ya sabía.

    Esa última parte es la trampa.

    Una revisión sistemática de 2026 de 189 artículos sobre el aprendizaje continuo revisados por pares sigue identificando el olvido catastrófico como uno de los problemas centrales de este campo: aprender algo nuevo puede perjudicar el rendimiento en tareas anteriores.

    Por eso, no sustituiría la recualificación programada por el aprendizaje continuo solo porque el nombre suene mejor. Pero en lo que respecta a la detección de fraudes, los sistemas industriales, los sistemas de recomendación y otros entornos que cambian constantemente, el atractivo es evidente.

  • Hybrid ML models icon.

    Modelos híbridos de aprendizaje automático

    Hay algo un poco curioso en pasar años intentando que las redes neuronales aprendan todo a partir de los datos, para luego descubrir que la física conocida sigue siendo útil.

    El NeuralGCM de Google es un buen ejemplo. Combina el aprendizaje automático con un solucionador atmosférico basado en la física, en lugar de encargar a uno de ellos todo el trabajo. En un estudio publicado en Nature, el modelo generó previsiones meteorológicas y climáticas competitivas utilizando entre tres y cinco órdenes de magnitud menos de recursos computacionales que los modelos convencionales comparables.

    Esa idea va mucho más allá del tiempo.

    Si ya conocemos las restricciones físicas, las normas de ingeniería u otras relaciones propias del ámbito, introducirlas en el modelo puede tener más sentido que pedirle a una red neuronal que redescubra la gravedad a partir de una hoja de cálculo.

  • Causal ML icon.

    Aprendizaje automático causal

    La predicción responde a preguntas como:

    ¿Quiénes son los clientes con mayor probabilidad de darse de baja?

    Las empresas suelen querer saber cuál es la siguiente pregunta:

    ¿Quién se quedará si les ofrecemos un descuento?

    Esa es una pregunta sobre la causalidad.

    El aprendizaje automático causal combina el aprendizaje automático con la inferencia causal para estimar qué podría suceder ante diferentes intervenciones. Este campo ya se está utilizando para estimar los efectos de tratamientos individualizados en medicina, aunque los investigadores siguen advirtiendo de que las hipótesis erróneas y los factores de confusión pueden dar lugar a conclusiones convincentes pero equivocadas.

    Creo que esta es una de las líneas de trabajo más interesantes en este ámbito, porque cambia la finalidad del modelo. La predicción describe un futuro probable. El aprendizaje automático causal intenta indicarte si hacer algo lo modificará.

    Un problema mucho más difícil.

    Es mucho más útil.

  • Uncertainty-aware predictions icon.

    Predicciones que tienen en cuenta la incertidumbre

    Un modelo que indica “un 92 % de confianza” transmite tranquilidad.

    También puede que sea una tontería.

    La calibración de la incertidumbre trata de hacer coincidir el nivel de confianza con la precisión predictiva real. Un estudio publicado en Nature Machine Intelligence en 2026 describe la calibración como esencial para una implementación fiable del aprendizaje automático, precisamente porque los modelos modernos pueden mostrar un alto nivel de confianza a pesar de estar equivocados.

    El cambio en la distribución agrava aún más la situación. Un estudio de 2026 Scientific Reports reveló que los modelos predictivos pueden perder tanto rendimiento como calibración cuando se aplican a conjuntos de datos heterogéneos del mundo real.

    Para las empresas, el resultado útil no es un modelo que siempre dé una respuesta. A veces, el mejor modelo es aquel que dice, en esencia: No estoy muy seguro de esto, pásaselo a una persona.

    Me gustaría ver mucho más de eso.

¿Necesitas ayuda para elegir el enfoque de aprendizaje automático adecuado?

Próximos pasos: cómo pueden las empresas aplicar las tendencias tecnológicas en materia de aprendizaje automático

La peor forma de utilizar esta lista es elegir una tendencia solo porque suena de moda y luego buscar un problema al que aplicarla.

Empieza, en cambio, por ese problema empresarial tan molesto.

01
Define qué aspectos hay que mejorar

¿Previsiones más precisas? ¿Menos falsas alertas de fraude? ¿Menor coste de inferencia? ¿Inspecciones más rápidas? Elige primero el resultado deseado y utiliza el proceso actual como punto de referencia.

02
Comprueba si los datos lo respaldan

Antes de comparar modelos, hay que tener en cuenta las etiquetas, los valores perdidos, los derechos de acceso, el desequilibrio entre clases, la cobertura y si los datos de producción se parecerán a los utilizados para el entrenamiento. Es precisamente aquí donde muchos proyectos de aprendizaje automático pierden rápidamente su atractivo.

03
Compara lo nuevo con lo aburrido

Si se está barajando la posibilidad de utilizar un modelo preentrenado, un sistema AutoML o una arquitectura multimodal, pruébalo comparándolo con una referencia más sencilla en las mismas condiciones: mismos datos, mismas métricas, mismos límites de latencia y mismo objetivo empresarial.

Si el modelo más complejo ofrece un margen de beneficio del 0,3 % y su funcionamiento cuesta cuatro veces más, necesitaría una razón de peso para mantenerlo.

04
Pruébalo en un entorno en el que el fallo no sea grave

Utiliza datos representativos y pon a prueba los casos que más probabilidades tienen de causar problemas: datos de entrada que faltan, clases poco frecuentes, dispositivos inusuales, segmentos de clientes más vulnerables, picos de carga. Decide de antemano qué te llevaría a suspender la prueba piloto.

05
Asignar un propietario al modelo tras su lanzamiento

Alguien debe supervisar la deriva, la latencia, el coste, la calibración, el rendimiento de los subgrupos y la métrica empresarial que el modelo debía mejorar. También debe decidir cuándo volver a entrenarlo, revertirlo, sustituirlo o, simplemente, desactivarlo.

Y sí, a veces la conclusión correcta es que la nueva tendencia en aprendizaje automático no supone una mejora suficiente como para justificar ningún cambio.

Eso también se considera una evaluación satisfactoria.

arrow-icon.arrow-icon.
01 Define qué aspectos hay que mejorar

¿Previsiones más precisas? ¿Menos falsas alertas de fraude? ¿Menor coste de inferencia? ¿Inspecciones más rápidas? Elige primero el resultado deseado y utiliza el proceso actual como punto de referencia.

arrow-icon.arrow-icon.
02 Comprueba si los datos lo respaldan

Antes de comparar modelos, hay que tener en cuenta las etiquetas, los valores perdidos, los derechos de acceso, el desequilibrio entre clases, la cobertura y si los datos de producción se parecerán a los utilizados para el entrenamiento. Es precisamente aquí donde muchos proyectos de aprendizaje automático pierden rápidamente su atractivo.

arrow-icon.arrow-icon.
03 Compara lo nuevo con lo aburrido

Si se está barajando la posibilidad de utilizar un modelo preentrenado, un sistema AutoML o una arquitectura multimodal, pruébalo comparándolo con una referencia más sencilla en las mismas condiciones: mismos datos, mismas métricas, mismos límites de latencia y mismo objetivo empresarial.

Si el modelo más complejo ofrece un margen de beneficio del 0,3 % y su funcionamiento cuesta cuatro veces más, necesitaría una razón de peso para mantenerlo.

arrow-icon.arrow-icon.
04 Pruébalo en un entorno en el que el fallo no sea grave

Utiliza datos representativos y pon a prueba los casos que más probabilidades tienen de causar problemas: datos de entrada que faltan, clases poco frecuentes, dispositivos inusuales, segmentos de clientes más vulnerables, picos de carga. Decide de antemano qué te llevaría a suspender la prueba piloto.

arrow-icon.arrow-icon.
05 Asignar un propietario al modelo tras su lanzamiento

Alguien debe supervisar la deriva, la latencia, el coste, la calibración, el rendimiento de los subgrupos y la métrica empresarial que el modelo debía mejorar. También debe decidir cuándo volver a entrenarlo, revertirlo, sustituirlo o, simplemente, desactivarlo.

Y sí, a veces la conclusión correcta es que la nueva tendencia en aprendizaje automático no supone una mejora suficiente como para justificar ningún cambio.

Eso también se considera una evaluación satisfactoria.

Aplicaciones y tendencias del aprendizaje automático en la práctica: Innowise: casos prácticos

Todos los casos prácticos
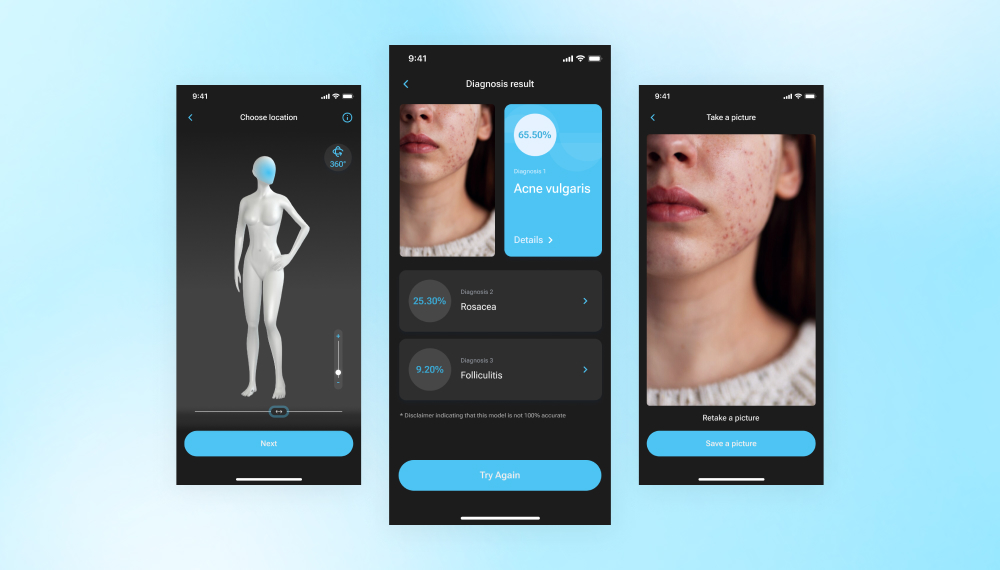
Desarrollo de una aplicación de escáner cutáneo con IA para dermatólogos
Una aplicación de inteligencia artificial que hemos desarrollado utiliza el aprendizaje profundo y el reconocimiento de imágenes para evaluar rápidamente afecciones cutáneas y ofrecer diagnósticos preliminares a partir de fotografías.
30 afecciones dermatológicas reconocidas
Desarrollo de un sistema de monitorización remota de pacientes basado en IA
Hemos desarrollado una aplicación para el cuidado de heridas como parte del software de monitorización remota de pacientes y hemos implementado un análisis basado en inteligencia artificial para realizar una evaluación precisa.
de dos niveles sistema de roles de usuario
100% cumplimiento normativo del sistema
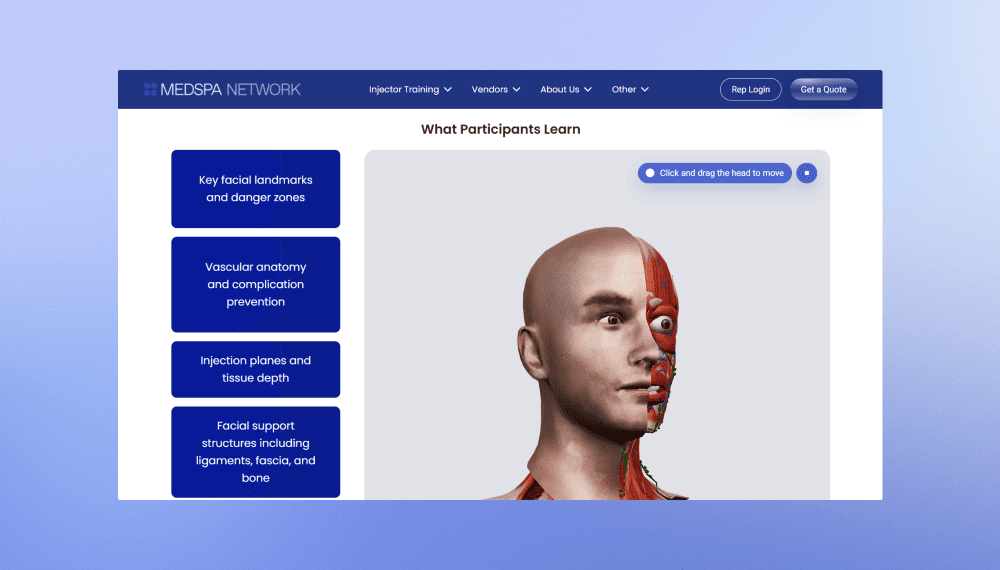
Rediseño y reconstrucción de la página web de MedSpa Network
Innowise rediseñó la página web de MedSpa Network en WordPress, lo que permitió a su equipo gestionar las actualizaciones diarias de los contenidos.
2 meses desde el inicio hasta el lanzamiento
3-5 clientes potenciales por semana, frente a 1 al mes
Ver caso práctico
Opinión de un cliente
Ver caso práctico
Client review logo. Opinión de un cliente
MedSpa Network website redesign and rebuild.
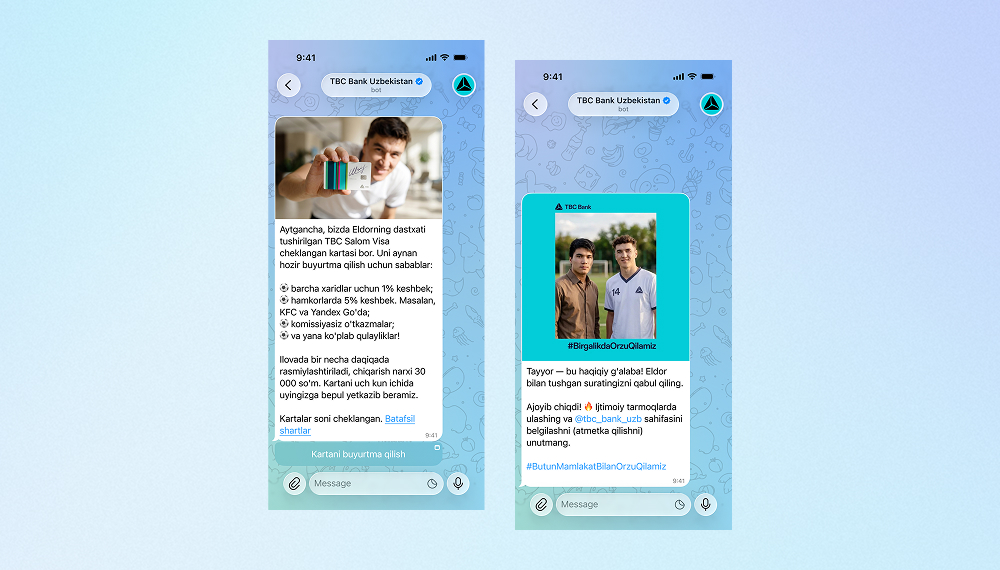
Bot de IA para la campaña de marketing del TBC Bank
Innowise ha creado un bot bilingüe para Telegram que genera selfies generados por IA con el embajador de marca de TBC Bank, una estrella del fútbol.
3,000 usuarios activos
2 idiomas disponibles
Ver caso práctico
Opinión de un cliente
Ver caso práctico
Client review logo. Opinión de un cliente
AI Telegram bot..
Definición de la estrategia de producto para la plataforma de préstamos en bitcoins de Bitlendex
Innowise llevó a cabo una fase de análisis inicial para Bitlendex, ayudando al cliente a transformar un concepto de producto en fase inicial en un modelo de negocio validado y un MVP claramente definido.
1 mes para una fase de investigación exhaustiva
Sistema de asesoramiento financiero para Bonnfinanz
Innowise ayudó a Bonnfinanz a desarrollar un sistema de asesoramiento y gestión basado en la web que permite el trabajo a distancia y la interacción directa con el cliente.
Plataforma de recarga de vehículos eléctricos con facturación flexible
Innowise contribuyó a modernizar la plataforma de movilidad eléctrica de SMART/LAB mejorando sus funciones de facturación, pago, gestión de transacciones y generación de informes.
>50% una tramitación más rápida de la facturación y los pagos
Transformación DevOps cloud-native de FinXP
Innowise ayudó a FinXP a modernizar su infraestructura de servicios financieros mediante la migración de las API y aplicaciones heredadas basadas en PHP a una arquitectura nativa de la nube.
11 Aplicaciones trasladadas a Azure App Service
100% Infraestructura como código
01 / 01
Close popup icon

Conclusión

En 2026, se está dedicando más esfuerzo a los modelos reutilizables, a mejores representaciones, a reducir la huella de inferencia, a la supervisión, a la calibración y a averiguar qué ocurre cuando un modelo se encuentra con datos que no estaban en el conjunto de entrenamiento.

Probablemente ese sea el cambio útil que hay que tener en cuenta. Un enfoque más novedoso solo es mejor si se adapta al problema, a los datos, a la infraestructura y a la forma en que se va a utilizar el modelo. Si un modelo más antiguo funciona igual de bien y es más fácil de ejecutar, quédate con el modelo más antiguo. Si un modelo base ahorra semanas de entrenamiento, utilízalo. Si ninguno de los dos supera una prueba piloto adecuada, pasa a otra cosa.

La tendencia en sí misma nunca es la razón.

Si estás evaluando qué enfoques de aprendizaje automático tienen sentido para un producto o flujo de trabajo real, nuestro equipo de consultoría en aprendizaje automático puede ayudarte con la arquitectura, la selección de modelos, la validación y la implementación.

FAQ

El aprendizaje automático (ML) es una rama de la inteligencia artificial en la que los modelos aprenden patrones a partir de los datos y los utilizan para realizar predicciones o tomar decisiones sin que sea necesario escribir cada regla manualmente.

En la práctica, esto puede significar predecir la demanda, detectar el fraude, evaluar el riesgo, recomendar productos, detectar defectos o prever cuándo es probable que falle un equipo.

La IA es la categoría general. El aprendizaje automático es una forma de crear sistemas de IA a partir del aprendizaje a partir de datos. El aprendizaje profundo es un subconjunto del aprendizaje automático basado en redes neuronales con muchas capas.

Así pues, la relación es bastante sencilla: el aprendizaje profundo forma parte del aprendizaje automático, y el aprendizaje automático forma parte de la IA.

Desde luego que sí.

El «gradient boosting», los bosques aleatorios, la regresión logística y otros métodos consolidados siguen siendo opciones sólidas para muchos problemas relacionados con datos estructurados. Pueden resultar más rápidos, más económicos y más fáciles de explicar que los enfoques más recientes basados en el aprendizaje profundo.

Un modelo no queda obsoleto por el mero hecho de que exista otro más a la moda.

Normalmente, los más tediosos: mala calidad de los datos, etiquetas que faltan, infraestructura deficiente, titularidad poco clara, restricciones de privacidad, problemas de integración y falta de personal que comprenda tanto el modelo como el proceso empresarial que lo rodea.

Hay otra razón más: a veces, el sistema de aprendizaje automático propuesto no mejora lo suficiente el proceso actual como para justificar el trabajo que conlleva.

Vale la pena averiguarlo cuanto antes.

AutoML puede encargarse de algunas partes de la selección de modelos, el ajuste de hiperparámetros, el procesamiento de características, la combinación de modelos y la experimentación.

Los seres humanos aún deben decidir qué debe predecir el modelo, si los datos tienen sentido, qué errores son los más importantes, cómo debe medirse el éxito y si el sistema final es lo suficientemente seguro y útil como para ponerlo en marcha.

AutoML puede realizar experimentos. Sin embargo, no puede decidir si merecía la pena llevarlos a cabo.

El aprendizaje automático en el propio dispositivo resulta adecuado cuando la latencia es un factor importante, la conectividad es inestable, el ancho de banda es limitado o los datos confidenciales deben permanecer en el dispositivo.

La contrapartida es el hardware. Los dispositivos más pequeños tienen limitaciones más estrictas en cuanto a memoria, potencia de cálculo y energía, por lo que los modelos suelen necesitar compresión u otras optimizaciones antes de poder ejecutarse en ellos sin problemas.

Para la mayoría de las empresas, no.

El aprendizaje automático cuántico sigue siendo, en gran medida, un tema de investigación. Existen experimentos relacionados con la optimización, los núcleos cuánticos y los modelos híbridos cuánticos-clásicos, pero el aprendizaje automático convencional sigue siendo mucho más práctico para los sistemas de producción habituales en 2026.

Si hoy en día alguien propusiera el aprendizaje automático cuántico para un problema de predicción rutinario, lo primero que le preguntaría es qué es exactamente lo que no ha conseguido hacer el modelo convencional.

Mostrar todo

Índice

Pon el aprendizaje automático a trabajar

    Contáctenos

    Reserve una llamada o rellene el siguiente formulario. Nos pondremos en contacto con usted en cuanto revisemos su solicitud.

    Envíenos un mensaje de voz
    Adjuntar documentos
    Subir archivo

    Puede adjuntar 1 archivo de hasta 2 MB. Formatos de archivo válidos: pdf, jpg, jpeg, png.

    Al hacer clic en «Enviar», usted consiente que Innowise trate sus datos personales de acuerdo con nuestra Política de privacidad para proporcionarle información relevante. Al facilitar su número de teléfono, acepta que podamos contactar con usted mediante llamadas de voz, SMS y aplicaciones de mensajería. Pueden aplicarse tarifas por llamadas, mensajes y datos.

    También puede enviarnos su solicitud
    a contact@innowise.com
    ¿Qué pasa después?
    1

    Una vez recibida y revisada su solicitud, nos pondremos en contacto con usted para analizar en detalle las necesidades de su proyecto y firmar un acuerdo de confidencialidad.

    2

    Tras examinar sus deseos, necesidades y expectativas, nuestro equipo elaborará una propuesta de proyecto con el alcance del trabajo, el tamaño del equipo, el plazo y los costes estimados.

    3

    Concertaremos una reunión con usted para revisar la propuesta y concretar los detalles.

    4

    Por último, firmaremos el contrato y empezaremos a trabajar en su proyecto de inmediato.

    Más servicios que cubrimos

    arrow