Tendances en matière d'apprentissage automatique 2026: les évolutions technologiques et leur impact sur les entreprises

12 novembre 2026 17 minutes de lecture
Responsable des départements Big Data, IA/ML/DS
Expert certifié
Chaque article publié sur Innowise est rédigé par des auteurs dotés d'une expérience concrète. Ils maîtrisent le sujet au-delà de la théorie et apportent un éclairage issu de projets réels.
11+ ans d'expérience
Expert certifié
11+ ans d'expérience
Philip crée des infrastructures de données qui apportent de la clarté. Il se concentre sur le « pourquoi » des données, en concevant des systèmes qui transforment des volumes massifs en informations exploitables, tout en veillant à ce que la vision technique reste claire et ciblée.
Expertise
Big data IA & ML Python
Parlons-en

Principaux enseignements

  • Le ML en 2026 gagne en praticité. Une grande partie des progrès concerne la réutilisation, l'efficacité, la surveillance, l'étalonnage et la simplification de l'exécution des modèles en production.
  • Les modèles pré-entraînés et auto-supervisés modifient l'ampleur du travail à réaliser à partir de zéro. Les modèles de base tabulaires, les représentations visuelles réutilisables et les données d'entraînement synthétiques permettent de réduire une partie du travail habituel d'entraînement et d'étiquetage.
  • Les contraintes de déploiement sont plus importantes que les bons résultats aux tests de performance. La latence, la mémoire, la consommation d'énergie, la dérive, les performances des sous-groupes et le coût de l'inférence peuvent avoir plus d'importance que de gagner encore une fraction de pour cent en précision.
  • Ces mêmes tendances transforment des processus de travail très différents. Dans le commerce de détail, cela se traduit par des prévisions et des recommandations ; dans le secteur bancaire, par la lutte contre la fraude et la gestion du risque de crédit ; dans le secteur de la santé, par la hiérarchisation des patients ; dans l'industrie manufacturière, par la maintenance prédictive et la détection des défauts ; dans la logistique, par les heures d'arrivée estimées et la prévision des retards.
  • Certains domaines prometteurs en sont encore à un stade très précoce de développement. L'apprentissage continu, l'apprentissage automatique causal, les modèles hybrides, l'adaptation inter-domaines et les prévisions tenant compte de l'incertitude semblent tous utiles, mais je ferais la distinction entre ce qui a déjà été démontré et ce qui est prêt à être déployé.
Résumé par l'IA

Le ML, c'est ennuyeux désormais. C'est la tendance.

Ou, du moins, une grande partie des avancées intéressantes se produit dans des domaines qui ne font pas vraiment les gros titres : réduire le temps d’inférence de 40 millisecondes, entraîner un modèle avec moins d’étiquettes, réutiliser un modèle au lieu d’en construire un autre, comprendre pourquoi un système précis à 96 % continue de se tromper systématiquement avec le même groupe d’utilisateurs.

Et c’est probablement une bonne nouvelle. Je pense que la plupart des entreprises n’ont pas vraiment besoin d’une avancée spectaculaire en matière d’apprentissage automatique. Elles se contenteraient volontiers d’un bon modèle qui continue de fonctionner lorsque les données changent, dont l’exploitation ne coûte pas une fortune et qui donne un avertissement lorsqu’il commence à se comporter de manière étrange.

Examinons donc les dernières tendances en matière d’apprentissage automatique pour voir où mènent ces travaux.

Mettez le ML à contribution

Aperçu et prévisions du marché de l'apprentissage automatique

Le marché du ML connaît une croissance rapide. Mais personne ne s'accorde vraiment sur son ampleur.

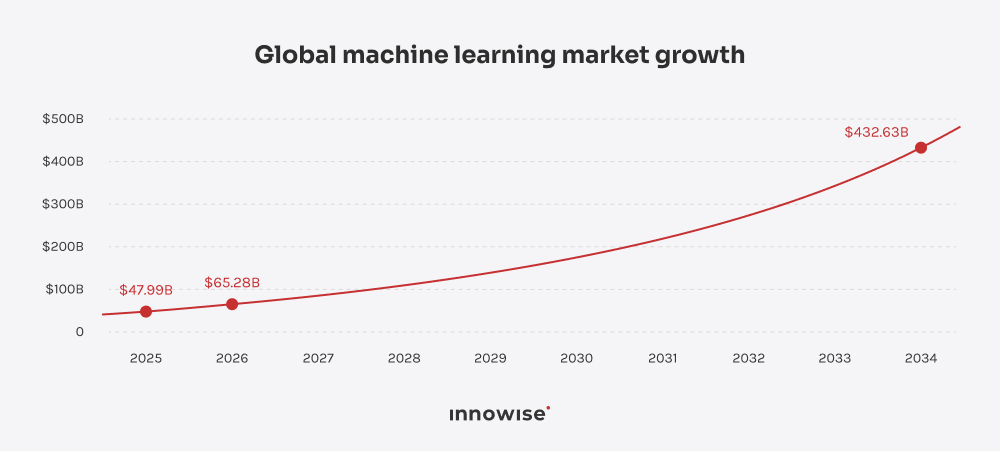
Fortune Business Insights estime le marché mondial de l'apprentissage automatique à 65,28 milliards de dollars en 2026 et prévoit qu'il atteindra 432,63 milliards de dollars d'ici 2034. The Business Research Company avance une estimation bien plus élevée pour la même année : 127,94 milliards de dollars en 2026, pour atteindre 445,25 milliards de dollars d’ici 2030.

Global machine learning market growth 2025-2034.

Cela représente presque un doublement d’ici 2026. Cela nous montre surtout que le “ marché de l’apprentissage automatique ” est une catégorie étonnamment élastique : selon les analystes, la composition de ce marché varie, allant des logiciels aux infrastructures, en passant par les services et le matériel.

Les détails contenus dans ces prévisions sont également utiles. Fortune prévoit que le déploiement dans le cloud représentera 53,14 % du marché de l’apprentissage automatique en 2026, les grandes entreprises représentant 55,61 % et IT et les télécommunications représentant 17,56 % de l’utilisation finale.

Par ailleurs, Gartner prévoit que les dépenses consacrées aux plateformes d’IA pour la science des données et l’apprentissage automatique atteindront 26,44 milliards de dollars en 2026, soit une hausse de 36,3 % par rapport à 2025.

Je ne m’attacherais donc pas trop à un seul chiffre global. Ce qui est utile, c’est la tendance : les dépenses augmentent, le cloud occupe une part importante des déploiements, et les outils liés à l’apprentissage automatique constituent désormais un marché à part entière de taille considérable.

Voyons maintenant les tendances récentes en matière d’apprentissage automatique lui-même.

Tendances actuelles en matière d'apprentissage automatique

Certaines des principales tendances en matière d’apprentissage automatique sont récentes. D’autres existent depuis des années et ne deviennent que maintenant suffisamment exploitables pour sortir du cadre des équipes de recherche. Pour être honnête, c’est le deuxième groupe qui m’intéresse le plus, mais bon, entrons dans le vif du sujet.

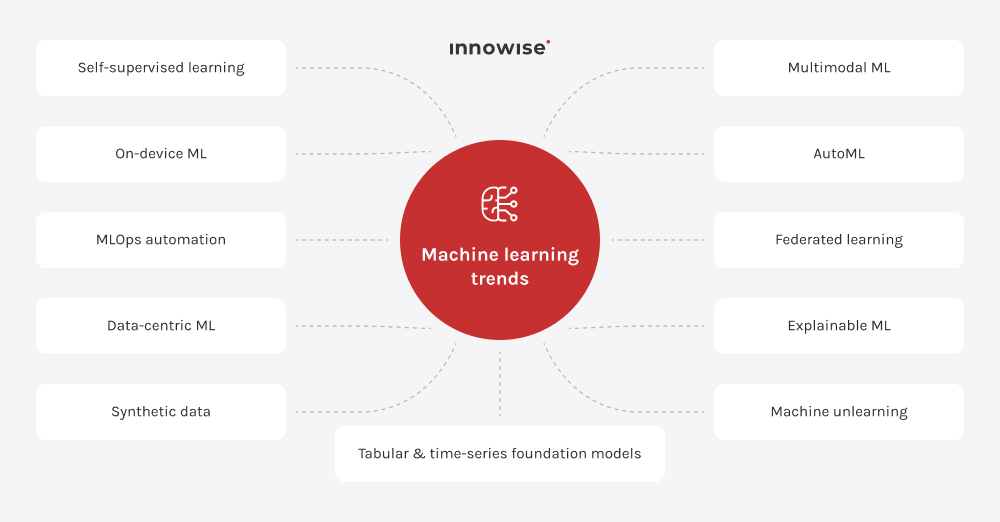
Key machine learning trends this year.

Modèles de base pour les données tabulaires et les séries chronologiques

Les tableaux connaissent leur heure de gloire grâce au modèle " foundation ".

En juin 2026, Google a présenté TabFM, un modèle de classification et de régression tabulaires capable de faire des prédictions sur de nouveaux ensembles de données sans passer par les étapes habituelles d’entraînement spécifique à la tâche et de réglage des hyperparamètres. Google l’a testé sur 38 ensembles de données de classification et 13 de régression, y compris des tableaux contenant jusqu’à 150 000 échantillons.

En quoi ce modèle est-il particulier ? C’est la manière dont il a été entraîné. Comme il n’existe pas d’énorme entrepôt public de tableaux d’entreprise nettoyés, Google a généré à la place des centaines de millions d’ensembles de données synthétiques.

Je ne supprimerais pas XGBoost pour l’instant. Pour de nombreux problèmes liés aux données structurées, les modèles conventionnels restent moins coûteux, plus faciles à déboguer et très difficiles à surpasser. Mais l’idée d’ouvrir un nouvel ensemble de données et d’obtenir une base de référence décente sans devoir se lancer dans un nouveau marathon de réglages est plutôt séduisante.

Et les séries chronologiques suivent la même tendance. Le modèle de Google TimesFM de Google est pré-entraîné sur de vastes collections de données de séries chronologiques et peut produire des prévisions « zero-shot » pour des ensembles de données qu’il n’a jamais vus auparavant. L’intérêt est similaire à celui de TabFM : moins d’entraînement spécifique à chaque fois qu’on a besoin d’une nouvelle prévision de demande, de trafic ou de capacité.

Est-ce que je remplacerais tous les pipelines de prévision existants par celui-ci ? Non. Mais cela vaut la peine de le tester lorsque l’alternative consiste à recommencer de zéro l’entraînement et le réglage d’un modèle.

L'apprentissage auto-supervisé nécessite moins d'étiquettes

L'étiquetage des données fait partie de ces tâches dont tout le monde s'accorde à dire qu'elles sont essentielles, mais pour lesquelles personne n'est vraiment enthousiaste à l'idée de payer.

L’apprentissage auto-supervisé contourne en partie ce problème en apprenant d’abord des représentations utiles à partir de données non étiquetées, puis en les adaptant à un ensemble de données étiquetées plus restreint.

Le DINOv3 de Meta en est un bon exemple. Il a été entraîné sur 1,7 milliard d’images sans étiquettes humaines, le plus grand modèle atteignant 7 milliards de paramètres. La même architecture visuelle « gelée » peut ensuite prendre en charge des tâches telles que la classification, la détection d’objets, la segmentation et le suivi.

Pour les entreprises qui disposent depuis des années de photos d’inspection, d’images satellites, d’imagerie médicale ou de vidéos non étiquetées, cela modifie quelque peu la donne économique. Vous aurez peut-être encore besoin d’étiquettes. Mais peut-être pas plusieurs millions.

Les petits modèles suscitent à nouveau l'intérêt

Un beau modèle qui nécessite un centre de données pour répondre à une simple question n'a qu'un attrait limité sur un téléphone, un capteur, un appareil photo ou un contrôleur industriel.

C’est pourquoi la compression des modèles suscite de plus en plus d’intérêt : la quantification réduit la précision numérique, l’élagage supprime les poids les moins utiles, et la distillation transfère les connaissances vers un modèle plus petit. TensorFlowpropose une boîte à outils d’optimisation qui identifie la latence, l’utilisation de la mémoire, la consommation d’énergie et la taille du modèle comme des contraintes essentielles pour le déploiement en périphérie.

Il n’y a pas de solution miracle. Une compression trop agressive entraîne une baisse de la précision.

Le défi consiste à trouver le juste équilibre, sans que personne ne s’en aperçoive, sauf la facture d’infrastructure.

Le MLOps devient de moins en moins facultatif

L'entraînement du modèle n'a jamais constitué l'intégralité du travail. Nous avons simplement passé un temps fou à faire comme si c'était le cas.

Une fois qu’un système d’apprentissage automatique est en production, quelqu’un doit savoir quel ensemble de données l’a généré, quelle version du code a servi à son entraînement, si les données d’entrée ont changé, si les performances dérivent, quand un réentraînement est autorisé et comment revenir en arrière en cas de version défectueuse.

Les outils en tiennent compte. MLflow 3, par exemple, a étendu son architecture de gestion des modèles pour renforcer la traçabilité et la comparaison entre les versions des modèles et les expériences.

C’est probablement l’une des tendances les moins glamour de cette liste en matière d’apprentissage automatique, mais aussi l’une de celles que je prendrais le plus au sérieux.

Les données synthétiques sont confrontées à la réalité

Les données synthétiques semblent vraiment pratiques. Il manque des exemples ? Créez-en.

Ça peut marcher. Ça peut aussi permettre à un modèle d’être très performant pour comprendre un monde artificiel qui n’existe pas vraiment.

Un article de recherche d’Apple datant de 2026 s’est penché sur le mélange de données d’entraînement réelles et synthétiques et a mis en évidence quelque chose de plus utile que le simple fait que “ les données synthétiques aident ”. Leurs résultats suggèrent qu’il peut exister un rapport optimal : l’ajout de données synthétiques améliore les performances jusqu’à un certain point, puis celles-ci commencent à se détériorer à mesure que les distributions synthétiques et réelles s’éloignent trop l’une de l’autre.

L'apprentissage automatique multimodal s'étend aux prédictions courantes

Le terme " multimodal " ne désigne pas nécessairement un modèle capable de commenter votre photo et d'écrire un poème à son sujet.

Dans le cadre du machine learning prédictif, cela peut être bien moins spectaculaire, mais bien plus utile : image d’un produit + description + prix, examen médical + antécédents du patient, relevés de capteurs + notes de maintenance.

Les outils AutoGluon actuels, par exemple, peuvent combiner des données d’images, de texte, de tableaux et de documents pour des tâches telles que la classification et la régression.

Le problème se pose plus tard. Que se passe-t-il lorsque l’image manque ? Ou que le capteur tombe en panne ? Ou qu’une source de données arrive avec deux heures de retard par rapport aux autres ?

Cela doit faire partie de l’évaluation, et non être une surprise découverte après le lancement.

L'AutoML ne cesse de nous épargner les tâches fastidieuses

Sélection de modèles, réglage des hyperparamètres, apprentissage par ensemble, certaines étapes du traitement des caractéristiques : bon nombre de ces tâches peuvent déjà être automatisées de manière assez satisfaisante.

Très bien.

Je ne suis pas convaincu qu’un ingénieur en apprentissage automatique hautement rémunéré doive passer un après-midi à tester manuellement 47 combinaisons de taux d’apprentissage et de profondeur d’arbre simplement pour prouver son dévouement à son métier.

Ce qu’AutoML n’automatise pas très bien, c’est de déterminer si la cible est pertinente, si les données d’entraînement révèlent des informations sur l’avenir, si la métrique d’évaluation reflète le coût pour l’entreprise, ou encore si le modèle a tout simplement lieu d’être.

Ces questions restent, malheureusement, du ressort de l’humain.

L'apprentissage fédéré ne garantit toujours pas la confidentialité

L'apprentissage fédéré présente un principe très séduisant : il permet d'effectuer un apprentissage sur plusieurs appareils ou au sein de plusieurs organisations sans avoir à transférer l'ensemble des données brutes vers une base de données centrale.

Utile, certes. Mais pas automatiquement confidentiel.

Le NIST a répertorié des attaques permettant de récupérer des informations à partir des mises à jour de modèles échangées lors de l’entraînement fédéré, et recommande des protections supplémentaires plutôt que de considérer la décentralisation en soi comme une garantie de confidentialité.

Et les déploiements réels sont chaotiques. Les appareils ont des capacités de calcul différentes, des participants disparaissent, les distributions de données varient, les hypothèses de sécurité ne tiennent pas. L’étude de mise en œuvre 2024 du NIST met clairement en évidence le fossé entre la théorie bien ordonnée de l’apprentissage fédéré et les systèmes en production.

Un expert cité dans ce rapport, le Dr Mat Weldon de l’Office national des statistiques du Royaume-Uni, l’a mieux exprimé que je ne saurais le faire :

“ Il est plus facile de concevoir une nouvelle architecture d’apprentissage fédéré que de la tester en tant qu’équipe rouge. ”

C’est vrai.

L'explicabilité perd de son caractère solennel

Pendant des années, l'ajout d'un graphique SHAP à un tableau de bord pouvait donner l'impression qu'un modèle était “ explicable ”, ce qui était plutôt satisfaisant.

C'est un critère peu exigeant.

Le NIST fait la distinction entre l’explicabilité, c’est-à-dire la compréhension de la manière dont un système a produit un résultat, et l’interprétabilité, c’est-à-dire la signification de ce résultat dans son contexte. Ses recommandations préconisent également de tester les méthodes d’explication avant leur déploiement, plutôt que de supposer que l’explication est correcte simplement parce que le graphique semble convaincant.

Les chercheurs du NIST ont publié en 2026 sur la validation explicable et la réduction des caractéristiques, ce qui est intéressant car cela rapproche l’explicabilité des tests de modèles plutôt que de la considérer comme une couche ajoutée a posteriori.

J’apprécie cette orientation. Une explication devrait être quelque chose que l’on teste, et non une simple décoration pour la fiche du modèle.

Le « désapprentissage » des machines devient un véritable enjeu technique

Imaginons que quelqu'un vous demande de supprimer ses données.

Vous supprimez l'enregistrement correspondant dans la base de données.

Très bien.

Mais qu'en est-il du modèle qui a déjà été entraîné à partir de ces données ?

C'est là qu'intervient le désapprentissage automatique : supprimer l'influence de données d'entraînement spécifiques sans avoir à réentraîner l'intégralité du modèle à partir de zéro. En juin 2026, Google Research a publié un cadre permettant de vérifier si un modèle “ désappris ” se comporte réellement davantage comme un modèle fraîchement réentraîné que comme le modèle d’origine.

Et ce deuxième aspect est crucial. Oublier quelque chose est un problème. Prouver que le modèle l’a oublié en est un autre.

Le désapprentissage automatique est encore bien plus proche de la recherche active que des outils d’entreprise courants, mais je garderais un œil dessus. Dès que « supprimer mes données » devra signifier plus que la simple suppression d’une ligne, cela cessera d’être théorique.

Créez une solution d'apprentissage automatique pour votre entreprise

Comment les tendances en matière d'apprentissage automatique transforment les processus de travail dans tous les secteurs d'activité

Une même tendance en matière d'apprentissage automatique peut se traduire de manière très différente une fois intégrée à un flux de travail réel. Dans le secteur de la grande distribution, une inférence plus rapide peut permettre de mettre à jour les recommandations pendant que le client est encore en train de parcourir les rayons. Dans le secteur industriel, cela peut permettre de détecter un défaut avant que le produit n'ait déjà progressé sur la chaîne de production.

  • Éducation
  • Commerce de détail et commerce électronique
  • Banque et finance
  • Santé
  • Industrie manufacturière
  • Logistique et transport

Éducation

Les plateformes éducatives disposent déjà d'une grande quantité de données : réponses, tentatives, temps de réponse, exercices sautés, progression dans les cours. Le plus difficile est d'en tirer quelque chose d'utile sans prétendre qu'un modèle comprend un élève mieux qu'un enseignant.

L'apprentissage automatique était déjà le le segment technologique le plus important du marché de l'IA dans l'éducation en 2025, avec notamment le suivi des performances, la personnalisation et le tutorat intelligent parmi les principales applications.

  • Adapter la difficulté et l'enchaînement des exercices en fonction des résultats antérieurs, plutôt que d'imposer à tout le monde le même parcours.
  • Prédire le risque de décrochage scolaire à partir de tendances telles que la baisse de la participation, les échecs répétés ou les longs intervalles entre les séances.
  • Identifier plus tôt les lacunes dans les connaissances et de revoir son programme avant que l'élève n'aborde le sujet suivant sans y être du tout préparé.
Commerce de détail et commerce électronique

Le secteur de la grande distribution utilise le machine learning depuis des années, mais les évolutions les plus intéressantes concernent la rapidité et la diversité des données. Les prévisions peuvent être mises à jour plus fréquemment, les recommandations peuvent s'appuyer sur d'autres éléments que l'historique d'achats, et la recherche visuelle peut associer des images à des descriptions de produits et à des données de catalogue.

  • Prévoir la demande et automatiser le réapprovisionnement en s'appuyant sur l'historique des ventes, la saisonnalité, les promotions et des données opérationnelles plus récentes.
  • Personnaliser les recommandations à partir des comportements de navigation et d'achat plutôt que de segments de clientèle statiques.
  • Améliorer la recherche de produits en associant des données textuelles et visuelles, ce qui s'avère utile lorsque le client ne connaît pas le nom de l'article mais dispose d'une photo.

Banque et finance

C'est dans le secteur bancaire que la surveillance des modèles, leur explicabilité et leur dérive deviennent difficiles à ignorer. Les schémas de fraude évoluent, le comportement des clients change, et un modèle qui semblait performant il y a six mois peut très vite s'avérer très coûteux.

Le marché mondial de la l'apprentissage automatique dans le secteur bancaire Ce marché représentait environ 40 milliards de dollars en 2025 et devrait atteindre environ 150 milliards de dollars d'ici 2034, selon Fortune Business Insights.

  • Détecter les transactions suspectes et classer les dossiers par ordre de priorité afin que les enquêteurs commencent par ceux qui semblent présenter le plus de risques.
  • Expliquez décisions de crédit en mettant en évidence les facteurs qui avaient la plus forte influence sur un score.
  • Surveiller la dérive du modèle à mesure que les techniques de fraude, les habitudes de consommation et les profils des clients évoluent.

Santé

Le secteur de la santé fait partie de ces domaines où un simple chiffre de référence est loin d'être suffisant. Les modèles peuvent se comporter différemment selon les hôpitaux, les groupes de patients, les appareils et les contextes cliniques ; c'est pourquoi l'étalonnage et la surveillance revêtent autant d'importance que les données brutes. performance prédictive.

Le marché mondial de l'analyse prédictive dans le secteur de la santé est estimé à 19,7 milliards de dollars en 2026 par Grand View Research, qui prévoit qu'il atteindra 49,3 milliards de dollars d'ici 2033.

  • Identifier les premiers signes de détérioration, y compris le risque de septicémie, avant que la situation ne devienne cliniquement évidente.
  • Prédire le risque de réadmission et donner la priorité au suivi des patients les plus susceptibles de revenir.
  • Claser les dossiers en vue de leur examen afin que les cliniciens puissent concentrer leurs efforts là où le risque prévu est le plus élevé.

Industrie manufacturière

Le secteur industriel est sans doute l'exemple le plus parlant pour le ML embarqué. Lorsqu’une caméra inspecte des pièces qui défilent sur une chaîne de production, il n’est souvent pas très judicieux d’envoyer chaque image vers le cloud et d’attendre une réponse.

Le marché global de l'IA dans le secteur industriel est estimé à 9,85 milliards de dollars en 2026, l'apprentissage automatique et la vision par ordinateur étant utilisés pour la maintenance prédictive, l'inspection, le contrôle qualité et la planification de la production.

  • Prévoir les défaillances des équipements en fonction des vibrations, de la température, de la pression et de l'historique d'entretien.
  • Détecter les défauts grâce à la vision par ordinateur tant que le produit se trouve encore sur la chaîne de production.
  • Prédire la qualité des produits à partir des paramètres de fabrication avant le contrôle final.

Logistique et transport

La logistique regorge de problèmes de prévision, ce qui en fait un terrain de jeu naturel pour l'apprentissage automatique : heures d'arrivée, retards, demande dans les entrepôts, circulation, changements d'itinéraire, correspondances manquées.

Le Le marché de l'apprentissage automatique dans le secteur de la logistique est estimé à 5,3 milliards de dollars en 2026 et devrait atteindre 44,5 milliards de dollars d'ici 2035, selon Aperçu du marché mondial.

Ici aussi, l'incertitude a son importance. “ Arrivée prévue à 14 h 10 ” et “ Arrivée prévue à 14 h 10, mais on n'en est pas vraiment sûr ” sont deux informations très différentes pour quelqu'un qui attend sur un quai de chargement.

  • Estimer les heures d'arrivée en tenant compte des retards passés, des conditions de circulation et de la position en temps réel des véhicules.
  • Retards prévus dans les livraisons suffisamment tôt pour adapter les plans relatifs à l'entrepôt ou à la livraison.
  • Estimer la durée des trajets et la demande pour faciliter la planification des itinéraires et la répartition de la flotte.

Éducation

Les plateformes éducatives disposent déjà d'une grande quantité de données : réponses, tentatives, temps de réponse, exercices sautés, progression dans les cours. Le plus difficile est d'en tirer quelque chose d'utile sans prétendre qu'un modèle comprend un élève mieux qu'un enseignant.

L'apprentissage automatique était déjà le le segment technologique le plus important du marché de l'IA dans l'éducation en 2025, avec notamment le suivi des performances, la personnalisation et le tutorat intelligent parmi les principales applications.

  • Adapter la difficulté et l'enchaînement des exercices en fonction des résultats antérieurs, plutôt que d'imposer à tout le monde le même parcours.
  • Prédire le risque de décrochage scolaire à partir de tendances telles que la baisse de la participation, les échecs répétés ou les longs intervalles entre les séances.
  • Identifier plus tôt les lacunes dans les connaissances et de revoir son programme avant que l'élève n'aborde le sujet suivant sans y être du tout préparé.

Commerce de détail et commerce électronique

Le secteur de la grande distribution utilise le machine learning depuis des années, mais les évolutions les plus intéressantes concernent la rapidité et la diversité des données. Les prévisions peuvent être mises à jour plus fréquemment, les recommandations peuvent s'appuyer sur d'autres éléments que l'historique d'achats, et la recherche visuelle peut associer des images à des descriptions de produits et à des données de catalogue.

  • Prévoir la demande et automatiser le réapprovisionnement en s'appuyant sur l'historique des ventes, la saisonnalité, les promotions et des données opérationnelles plus récentes.
  • Personnaliser les recommandations à partir des comportements de navigation et d'achat plutôt que de segments de clientèle statiques.
  • Améliorer la recherche de produits en associant des données textuelles et visuelles, ce qui s'avère utile lorsque le client ne connaît pas le nom de l'article mais dispose d'une photo.

Banque et finance

C'est dans le secteur bancaire que la surveillance des modèles, leur explicabilité et leur dérive deviennent difficiles à ignorer. Les schémas de fraude évoluent, le comportement des clients change, et un modèle qui semblait performant il y a six mois peut très vite s'avérer très coûteux.

Le marché mondial de la l'apprentissage automatique dans le secteur bancaire Ce marché représentait environ 40 milliards de dollars en 2025 et devrait atteindre environ 150 milliards de dollars d'ici 2034, selon Fortune Business Insights.

  • Détecter les transactions suspectes et classer les dossiers par ordre de priorité afin que les enquêteurs commencent par ceux qui semblent présenter le plus de risques.
  • Expliquez décisions de crédit en mettant en évidence les facteurs qui avaient la plus forte influence sur un score.
  • Surveiller la dérive du modèle à mesure que les techniques de fraude, les habitudes de consommation et les profils des clients évoluent.

Santé

Le secteur de la santé fait partie de ces domaines où un simple chiffre de référence est loin d'être suffisant. Les modèles peuvent se comporter différemment selon les hôpitaux, les groupes de patients, les appareils et les contextes cliniques ; c'est pourquoi l'étalonnage et la surveillance revêtent autant d'importance que les données brutes. performance prédictive.

Le marché mondial de l'analyse prédictive dans le secteur de la santé est estimé à 19,7 milliards de dollars en 2026 par Grand View Research, qui prévoit qu'il atteindra 49,3 milliards de dollars d'ici 2033.

  • Identifier les premiers signes de détérioration, y compris le risque de septicémie, avant que la situation ne devienne cliniquement évidente.
  • Prédire le risque de réadmission et donner la priorité au suivi des patients les plus susceptibles de revenir.
  • Claser les dossiers en vue de leur examen afin que les cliniciens puissent concentrer leurs efforts là où le risque prévu est le plus élevé.

Industrie manufacturière

Le secteur industriel est sans doute l'exemple le plus parlant pour le ML embarqué. Lorsqu’une caméra inspecte des pièces qui défilent sur une chaîne de production, il n’est souvent pas très judicieux d’envoyer chaque image vers le cloud et d’attendre une réponse.

Le marché global de l'IA dans le secteur industriel est estimé à 9,85 milliards de dollars en 2026, l'apprentissage automatique et la vision par ordinateur étant utilisés pour la maintenance prédictive, l'inspection, le contrôle qualité et la planification de la production.

  • Prévoir les défaillances des équipements en fonction des vibrations, de la température, de la pression et de l'historique d'entretien.
  • Détecter les défauts grâce à la vision par ordinateur tant que le produit se trouve encore sur la chaîne de production.
  • Prédire la qualité des produits à partir des paramètres de fabrication avant le contrôle final.

Logistique et transport

La logistique regorge de problèmes de prévision, ce qui en fait un terrain de jeu naturel pour l'apprentissage automatique : heures d'arrivée, retards, demande dans les entrepôts, circulation, changements d'itinéraire, correspondances manquées.

Le Le marché de l'apprentissage automatique dans le secteur de la logistique est estimé à 5,3 milliards de dollars en 2026 et devrait atteindre 44,5 milliards de dollars d'ici 2035, selon Aperçu du marché mondial.

Ici aussi, l'incertitude a son importance. “ Arrivée prévue à 14 h 10 ” et “ Arrivée prévue à 14 h 10, mais on n'en est pas vraiment sûr ” sont deux informations très différentes pour quelqu'un qui attend sur un quai de chargement.

  • Estimer les heures d'arrivée en tenant compte des retards passés, des conditions de circulation et de la position en temps réel des véhicules.
  • Retards prévus dans les livraisons suffisamment tôt pour adapter les plans relatifs à l'entrepôt ou à la livraison.
  • Estimer la durée des trajets et la demande pour faciliter la planification des itinéraires et la répartition de la flotte.
Le modèle qui remporte le test comparatif n'est pas toujours celui que je choisirais pour la mise en production. Une fois pris en compte la latence, le coût de l'infrastructure, la dérive et la maintenance, un modèle légèrement moins précis peut facilement s'avérer être le meilleur choix d'un point de vue technique.
Dmitry Nazarevich, CTO.
Dmitry Nazarevich
Directeur des Technologies (CTO)

Tendances futures en matière d'apprentissage automatique

Certaines idées en matière d’apprentissage automatique sont déjà utiles aujourd’hui. D’autres ont encore besoin de meilleurs tests de performance, de ressources informatiques moins coûteuses ou de quelques expériences difficiles en production avant que je ne les considère comme prêtes.

Voici les tendances émergentes en apprentissage automatique que je continuerais à suivre.

  • Cross-domain generalization and adaptation icon.

    Généralisation et adaptation inter-domaines

    L'un des problèmes les plus anciens du machine learning reste d'actualité : lorsqu'on entraîne un modèle dans un environnement donné, puis qu'on le transpose dans un environnement légèrement différent, on constate une baisse de ses performances.

    La généralisation de domaine vise à permettre aux modèles de rester valables sur des distributions de données qu’ils n’ont jamais rencontrées auparavant. Une étude de 2026 sur la classification de motifs dans des environnements inconnus décrit précisément ce problème : des changements au niveau des capteurs, des conditions d’acquisition ou d’autres caractéristiques du domaine peuvent suffire à nuire considérablement à un modèle.

    On imagine facilement comment cela se passe dans la pratique. Un modèle de vision artificielle entraîné dans une usine doit fonctionner dans une autre usine équipée de caméras différentes. Un modèle médical est transféré dans un autre hôpital. Un modèle de détection des fraudes doit traiter une nouvelle population de clients.

    Je pense que cela deviendra moins une spécialité de recherche qu'une exigence fondamentale en matière de déploiement.

  • Continual learning icon.

    Apprentissage continu

    La plupart des modèles de production fonctionnent encore par étapes : collecte de nouvelles données, réentraînement, validation, puis nouveau déploiement.

    L'apprentissage continu vise à obtenir un résultat plus fluide. Le modèle continue d'apprendre à mesure que de nouvelles données arrivent, sans pour autant oublier ce qu'il savait auparavant.

    C'est justement là que réside le hic.

    Une revue systématique de 2026 portant sur 189 articles évalués par des pairs consacrés à l’apprentissage continu identifie toujours l’oubli catastrophique comme l’un des problèmes centraux de ce domaine : l’apprentissage de quelque chose de nouveau peut nuire à la performance dans des tâches plus anciennes.

    Je ne remplacerais donc pas la formation continue programmée par l'apprentissage continu simplement parce que le terme sonne mieux. Mais pour la détection des fraudes, les systèmes industriels, les systèmes de recommandation et d'autres environnements en constante évolution, l'intérêt est évident.

  • Hybrid ML models icon.

    Modèles d'apprentissage automatique hybrides

    Il y a quelque chose d'un peu drôle à passer des années à essayer d'apprendre aux réseaux neuronaux tout ce qu'ils peuvent tirer des données, pour finalement découvrir que les lois de la physique connues peuvent encore s'avérer utiles.

    Le modèle NeuralGCM de Google en est un bon exemple. Il combine l'apprentissage automatique à un solveur atmosphérique fondé sur la physique, plutôt que de confier l'intégralité de la tâche à l'un ou à l'autre. Dans étude publiée dans Nature, le modèle a produit des prévisions météorologiques et climatiques performantes tout en utilisant trois à cinq ordres de grandeur de ressources de calcul en moins que des modèles conventionnels comparables.

    Cette idée va bien au-delà de la météo.

    Si l'on connaît déjà les contraintes physiques, les règles d'ingénierie ou d'autres relations propres au domaine, il peut être plus judicieux de les intégrer au modèle plutôt que de demander à un réseau neuronal de redécouvrir la gravité à partir d'une feuille de calcul.

  • Causal ML icon.

    Apprentissage automatique causal

    La prédiction permet de répondre à des questions telles que :

    Qui est susceptible de résilier son abonnement ?

    Les entreprises souhaitent généralement connaître la question suivante :

    Qui restera si nous leur accordons une réduction ?

    C'est une question de causalité.

    L'apprentissage automatique causal (Causal ML) combine l'apprentissage automatique et l'inférence causale pour estimer ce qui pourrait se produire en fonction de différentes interventions. Ce domaine est déjà utilisé pour estimer les effets individualisés des traitements en médecine, bien que les chercheurs soulignent encore que des hypothèses erronées et des facteurs de confusion peuvent conduire à des conclusions convaincantes mais fausses.

    Je pense que c'est l'une des pistes les plus intéressantes ici, car cela modifie la finalité du modèle. La prédiction décrit un avenir probable. L'apprentissage automatique causal cherche à déterminer si une action donnée est susceptible de modifier cet avenir.

    Un problème bien plus difficile.

    C'est bien plus utile.

  • Uncertainty-aware predictions icon.

    Prévisions tenant compte de l'incertitude

    Un modèle indiquant un “ niveau de confiance de 92 % ” est rassurant.

    C'est peut-être aussi n'importe quoi.

    L'étalonnage de l'incertitude vise à aligner le niveau de confiance sur la précision prédictive réelle. Une étude publiée en 2026 dans Nature Machine Intelligence en 2026 décrit l'étalonnage comme essentiel pour un déploiement fiable de l'apprentissage automatique, précisément parce que les modèles modernes peuvent afficher un niveau de confiance élevé tout en se trompant.

    L'évolution de la répartition aggrave encore la situation. Une étude publiée en 2026 dans Scientific Reports a révélé que les modèles prédictifs peuvent perdre à la fois en performance et en étalonnage lorsqu’ils sont appliqués à des ensembles de données hétérogènes issus du monde réel.

    Pour les entreprises, ce qui importe, ce n’est pas un modèle qui donne toujours une réponse. Parfois, le meilleur modèle est celui qui dit, en substance : Je ne suis pas tout à fait sûr de celle-là, confiez-la à un humain.

    J'aimerais voir beaucoup plus de choses comme ça.

Vous avez besoin d'aide pour choisir la bonne approche d'apprentissage automatique ?

Prochaines étapes : comment les entreprises peuvent-elles mettre en œuvre les nouvelles tendances en matière de technologie d'apprentissage automatique ?

La pire façon d'utiliser cette liste est de choisir une tendance simplement parce qu'elle semble d'actualité, puis de chercher un problème auquel l'associer.

Commencez plutôt par ce problème professionnel qui vous agace.

01
Définir les points à améliorer

Des prévisions plus précises ? Moins de fausses alertes de fraude ? Une réduction des coûts liés à l'inférence ? Une inspection plus rapide ? Choisissez d'abord le résultat souhaité et conservez le processus actuel comme référence.

02
Vérifiez si les données permettent de corroborer cette hypothèse

Avant de comparer les modèles, examinez les étiquettes, les valeurs manquantes, les droits d'accès, le déséquilibre entre les classes, la couverture, et vérifiez si les données de production ressembleront à celles utilisées pour l'entraînement. C'est également à ce stade que de nombreux projets d'apprentissage automatique perdent très vite de leur attrait.

03
Compare la nouveauté à ce qui est ennuyeux

Si vous envisagez d'utiliser un modèle pré-entraîné, un système AutoML ou une architecture multimodale, testez-le par rapport à une référence plus simple, dans les mêmes conditions : mêmes données, mêmes indicateurs, mêmes limites de latence, même objectif métier.

Si le modèle complexe offre un gain de 0,3 % mais coûte quatre fois plus cher à exploiter, il faudrait une très bonne raison pour que je décide de le conserver.

04
Testez-le dans un contexte où un échec n'est pas fatal

Utilisez des données représentatives et testez les cas les plus susceptibles de poser problème : données d'entrée manquantes, classes rares, appareils atypiques, segments de clientèle les plus vulnérables, pics de charge. Déterminez à l'avance les circonstances qui vous amèneraient à interrompre le projet pilote.

05
Attribuer un propriétaire au modèle après son lancement

Il faut surveiller la dérive, la latence, le coût, l'étalonnage, les performances des sous-groupes, ainsi que l'indicateur métier que le modèle était censé améliorer. Il faut également décider quand le réentraîner, revenir à une version antérieure, le remplacer ou simplement le désactiver.

Et oui, il arrive parfois que la conclusion qui s'impose soit que la nouvelle tendance en matière d'apprentissage automatique n'apporte pas suffisamment d'améliorations pour justifier un changement.

Cela compte également comme une évaluation réussie.

arrow-icon.arrow-icon.
01 Définir les points à améliorer

Des prévisions plus précises ? Moins de fausses alertes de fraude ? Une réduction des coûts liés à l'inférence ? Une inspection plus rapide ? Choisissez d'abord le résultat souhaité et conservez le processus actuel comme référence.

arrow-icon.arrow-icon.
02 Vérifiez si les données permettent de corroborer cette hypothèse

Avant de comparer les modèles, examinez les étiquettes, les valeurs manquantes, les droits d'accès, le déséquilibre entre les classes, la couverture, et vérifiez si les données de production ressembleront à celles utilisées pour l'entraînement. C'est également à ce stade que de nombreux projets d'apprentissage automatique perdent très vite de leur attrait.

arrow-icon.arrow-icon.
03 Compare la nouveauté à ce qui est ennuyeux

Si vous envisagez d'utiliser un modèle pré-entraîné, un système AutoML ou une architecture multimodale, testez-le par rapport à une référence plus simple, dans les mêmes conditions : mêmes données, mêmes indicateurs, mêmes limites de latence, même objectif métier.

Si le modèle complexe offre un gain de 0,3 % mais coûte quatre fois plus cher à exploiter, il faudrait une très bonne raison pour que je décide de le conserver.

arrow-icon.arrow-icon.
04 Testez-le dans un contexte où un échec n'est pas fatal

Utilisez des données représentatives et testez les cas les plus susceptibles de poser problème : données d'entrée manquantes, classes rares, appareils atypiques, segments de clientèle les plus vulnérables, pics de charge. Déterminez à l'avance les circonstances qui vous amèneraient à interrompre le projet pilote.

arrow-icon.arrow-icon.
05 Attribuer un propriétaire au modèle après son lancement

Il faut surveiller la dérive, la latence, le coût, l'étalonnage, les performances des sous-groupes, ainsi que l'indicateur métier que le modèle était censé améliorer. Il faut également décider quand le réentraîner, revenir à une version antérieure, le remplacer ou simplement le désactiver.

Et oui, il arrive parfois que la conclusion qui s'impose soit que la nouvelle tendance en matière d'apprentissage automatique n'apporte pas suffisamment d'améliorations pour justifier un changement.

Cela compte également comme une évaluation réussie.

Applications et tendances de l'apprentissage automatique dans la pratique : Études de cas d'Innowise

Toutes les études de cas
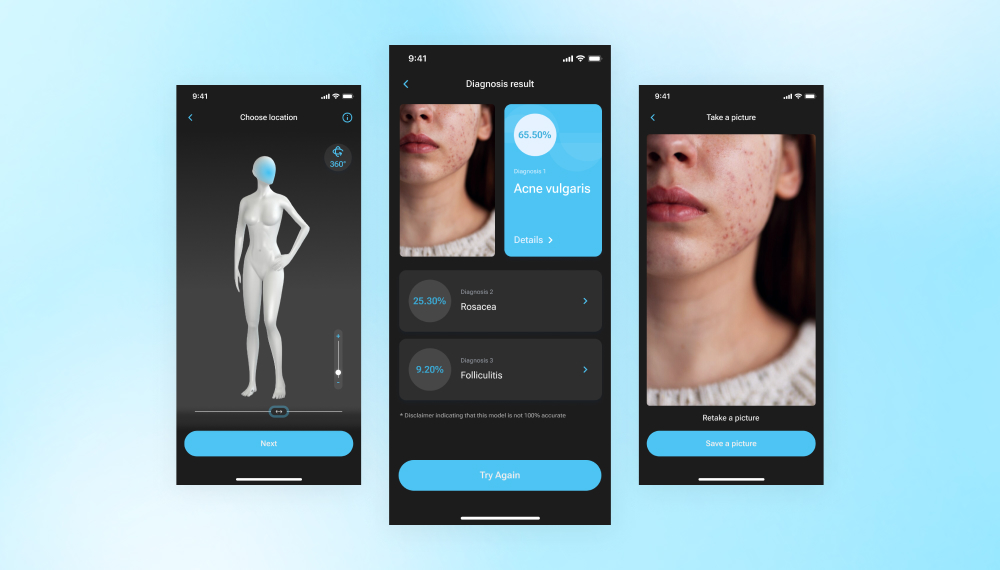
Développement d'une application de scan cutané par un dermatologue IA
Une application d'IA que nous avons développée utilise l'apprentissage profond et la reconnaissance d'images pour évaluer rapidement l'état de la peau et établir des diagnostics préliminaires à partir de photos.
30 affections dermatologiques prises en charge
Mise en place d'un système de télésurveillance des patients basé sur l'IA
Nous avons développé une application dédiée au traitement des plaies dans le cadre du logiciel de télésurveillance des patients et mis en place un système d'analyse basé sur l'intelligence artificielle pour garantir une évaluation précise.
à deux niveaux système de rôles utilisateur
100% conformité du système
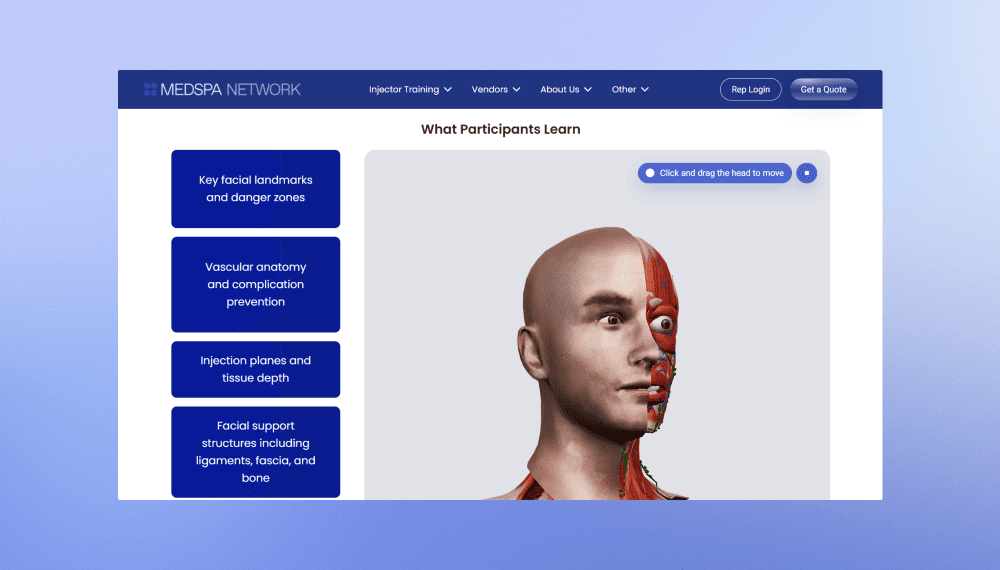
Refonte et reconstruction du site web de MedSpa Network
Innowise a refondu le site web de MedSpa Network sur WordPress, permettant ainsi à son équipe de gérer elle-même les mises à jour quotidiennes du contenu.
2 mois entre le coup d'envoi et le lancement
3-5 3 à 5 prospects par semaine (contre 1 par mois auparavant)
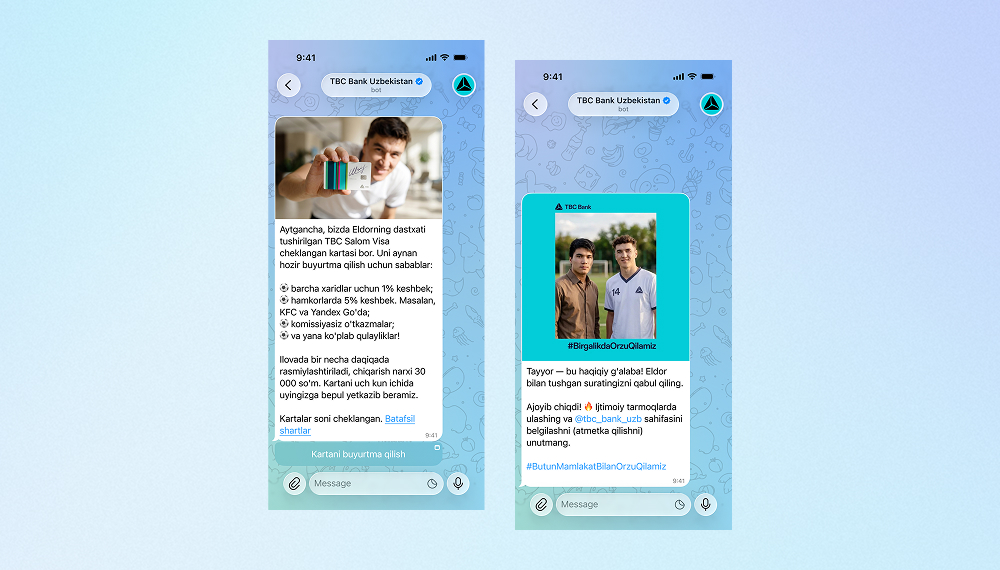
Bot IA pour la campagne marketing de TBC Bank
Innowise a développé un bot Telegram bilingue qui génère des selfies créés par l'IA avec l'ambassadeur de marque de la TBC Bank, une star du football.
3,000 utilisateurs actifs
2 langues prises en charge
Définition de la stratégie produit pour la plateforme de prêt de bitcoins de Bitlendex
Innowise a mené une phase d'analyse pour Bitlendex, aidant ainsi le client à transformer un concept de produit à un stade précoce en un modèle économique validé et en un MVP clairement défini.
1 mois pour une phase de découverte complète
Système de conseil financier pour Bonnfinanz
Innowise a aidé Bonnfinanz à mettre en place un système de conseil et de gestion en ligne qui facilite le travail à distance et permet une interaction directe avec le client.
Plateforme de recharge pour véhicules électriques avec facturation flexible
Innowise a contribué à la modernisation de la plateforme de mobilité électrique de SMART/LAB en améliorant ses fonctionnalités de facturation, de paiement, de gestion des transactions et de reporting.
>50% accélération de la facturation et du traitement des paiements
Transformation DevOps cloud-native de FinXP
Innowise a aidé FinXP à moderniser son infrastructure de services financiers en migrant ses API et applications héritées basées sur PHP vers une architecture native pour le cloud.
11 Applications migrées vers Azure App Service
100% Infrastructure as Code
01 / 01
Close popup icon

Conclusion

En 2026, les efforts portent davantage sur les modèles réutilisables, l’amélioration des représentations, la réduction de l’empreinte d’inférence, la surveillance, l’étalonnage et la compréhension de ce qui se passe lorsqu’un modèle est confronté à des données qui ne figuraient pas dans l’ensemble d’apprentissage.

C’est sans doute l’évolution utile à garder à l’esprit. Une nouvelle approche n’est meilleure que si elle est adaptée au problème, aux données, à l’infrastructure et à la manière dont le modèle sera utilisé. Si un ancien modèle offre des performances équivalentes et est plus facile à exécuter, conservez-le. Si un modèle de base permet de gagner plusieurs semaines d’entraînement, utilisez-le. Si aucun des deux ne passe le cap d’un pilote en bonne et due forme, passez à autre chose.

La tendance en elle-même n’est jamais la raison.

Si vous évaluez quelles approches d’apprentissage automatique sont pertinentes pour un produit ou un flux de travail concret, notre équipe de conseil en apprentissage automatique peut vous aider en matière d’architecture, de sélection de modèles, de validation et de déploiement.

FAQ

L'apprentissage automatique (ML) est une branche de l'intelligence artificielle dans laquelle des modèles apprennent des modèles à partir de données et les utilisent pour établir des prévisions ou prendre des décisions sans qu'aucune règle ne soit définie manuellement.

Concrètement, cela peut consister à prévoir la demande, à détecter les fraudes, à évaluer les risques, à recommander des produits, à repérer des défauts ou à prévoir quand un équipement est susceptible de tomber en panne.

L'IA est une catégorie générale. L'apprentissage automatique est une méthode permettant de créer des systèmes d'IA en tirant des enseignements des données. L'apprentissage profond est un sous-ensemble de l'apprentissage automatique qui repose sur des réseaux neuronaux comportant de nombreuses couches.

La relation est donc assez simple : l'apprentissage profond s'inscrit dans le cadre de l'apprentissage automatique, et l'apprentissage automatique s'inscrit dans le cadre de l'IA.

Tout à fait.

Le « gradient boosting », les forêts aléatoires, la régression logistique et d’autres méthodes éprouvées restent des choix judicieux pour de nombreux problèmes liés aux données structurées. Elles peuvent s’avérer plus rapides, moins coûteuses et plus faciles à expliquer que les nouvelles approches d’apprentissage profond.

Un modèle ne devient pas obsolète simplement parce qu’il en existe un autre plus tendance.

En général, ce sont les aspects les plus rébarbatifs : mauvaise qualité des données, étiquettes manquantes, infrastructure insuffisante, responsabilité mal définie, restrictions en matière de confidentialité, problèmes d’intégration et manque de personnel capable de comprendre à la fois le modèle et les processus métier qui l’entourent.

Il y a aussi un autre problème : parfois, le système d'apprentissage automatique proposé n'améliore pas suffisamment le processus existant pour justifier le travail nécessaire.

Il vaut mieux le savoir dès le début.

L'AutoML peut prendre en charge certaines étapes de la sélection de modèles, du réglage des hyperparamètres, du traitement des caractéristiques, de l'assemblage de modèles et de l'expérimentation.

Il revient toujours aux humains de déterminer ce que le modèle doit prédire, si les données sont cohérentes, quelles sont les erreurs les plus importantes, comment mesurer la réussite, et si le système final est suffisamment sûr et utile pour être déployé.

AutoML peut mener des expériences. Il ne peut toutefois pas déterminer si l'expérience valait la peine d'être menée.

Le machine learning embarqué est particulièrement adapté lorsque la latence est un facteur déterminant, que la connectivité est instable, que la bande passante est limitée ou que les données sensibles doivent rester sur place.

Le compromis réside au niveau du matériel. Les appareils plus petits sont soumis à des contraintes plus strictes en matière de mémoire, de puissance de calcul et de consommation d'énergie ; les modèles doivent donc généralement être compressés ou optimisés d'une autre manière avant de pouvoir fonctionner correctement sur ces appareils.

Pour la plupart des entreprises, non.

L'apprentissage automatique quantique reste encore largement un sujet de recherche. Des expériences sont menées dans les domaines de l'optimisation, des noyaux quantiques et des modèles hybrides quantiques-classiques, mais l'apprentissage automatique classique reste de loin plus pratique pour les systèmes de production courants dans 2026.

Si quelqu’un proposait aujourd’hui d’utiliser l’apprentissage automatique quantique pour résoudre un problème de prévision courant, je lui demanderais d’abord en quoi exactement le modèle classique a échoué.

Montrer tout

Table des matières

Mettez le ML à contribution

    Contactez-nous

    Réservez un appel ou remplissez le formulaire ci-dessous. Nous vous contacterons dès que nous aurons examiné votre demande.

    Envoyez-nous un message vocal
    Joindre des documents
    Téléverser un fichier

    Vous pouvez joindre un fichier d'une taille maximale de 2 Mo. Formats de fichiers valables : pdf, jpg, jpeg, png.

    En cliquant sur « Envoyer », vous consentez au traitement de vos données personnelles par Innowise conformément à notre Politique de confidentialité afin de vous fournir des informations pertinentes. En soumettant votre numéro de téléphone, vous acceptez que nous puissions vous contacter par appels vocaux, SMS et applications de messagerie. Des frais d'appel, de message et de transfert de données peuvent s'appliquer.

    Vous pouvez également nous envoyer votre
    demande à contact@innowise.com
    Que se passe-t-il ensuite?
    1

    Une fois votre demande reçue et examinée, nous vous contacterons afin de préciser les besoins de votre projet et de signer un accord de confidentialité.

    2

    Après avoir examiné vos souhaits, vos besoins et vos attentes, notre équipe élaborera une proposition de projet avec l'étendue des travaux, la taille de l'équipe, les délais et les coûts estimés.

    3

    Nous organiserons une réunion avec vous pour discuter de la proposition et finaliser les détails.

    4

    Enfin, nous signerons le contrat et commencerons immédiatement à travailler sur votre projet.

    Autres services couverts

    arrow