Trendy w dziedzinie uczenia maszynowego 2026: zmiany technologiczne i ich wpływ na biznes

12 listopada 2026 r. Czas czytania: 17 minut
Kierownik działów Big Data, AI/ML/DS
Zweryfikowany ekspert
Każdy artykuł na stronie Innowise jest tworzony przez autorów posiadających praktyczne doświadczenie. Rozumieją oni dany temat nie tylko z teoretycznego punktu widzenia, ale także dzielą się spostrzeżeniami wynikającymi z rzeczywistych projektów.
11+ lat doświadczenia
Zweryfikowany ekspert
11+ lat doświadczenia
Philip tworzy infrastruktury danych, które zapewniają przejrzystość. Skupia się na „dlaczego” stojącym za danymi, projektując systemy, które przetwarzają ogromne ilości informacji w użyteczne wnioski, jednocześnie dbając o to, by wizja techniczna pozostała ostra i celowa.
Wiedza
Big data AI i ML Python
Poznajmy się

Najważniejsze wnioski

  • Uczenie maszynowe w 2026 staje się coraz bardziej praktyczne. Znaczna część postępów dotyczy ponownego wykorzystania, wydajności, monitorowania, kalibracji oraz ułatwiania uruchamiania modeli w środowisku produkcyjnym.
  • Modele wstępnie wytrenowane i modele oparte na samokontroli zmieniają zakres prac, które trzeba wykonać od podstaw. Tabularne modele bazowe, reprezentacje wizualne wielokrotnego użytku oraz syntetyczne dane szkoleniowe mogą ograniczyć część typowych zadań związanych ze szkoleniem i oznaczaniem danych.
  • Ograniczenia związane z wdrożeniem mają większe znaczenie niż zwycięstwa w testach porównawczych. Opóźnienia, pamięć, zużycie energii, dryft, wydajność podgrup oraz koszt wnioskowania mogą mieć większe znaczenie niż wyciskanie kolejnego ułamka procenta dokładności.
  • Te same trendy zmieniają bardzo zróżnicowane procesy robocze. W handlu detalicznym przejawia się to w prognozowaniu i rekomendacjach; w bankowości – w zakresie oszustw i ryzyka kredytowego; w służbie zdrowia – w ustalaniu priorytetów opieki nad pacjentami; w przemyśle – w konserwacji predykcyjnej i wykrywaniu usterek; w logistyce – w szacowaniu czasu przybycia (ETA) i przewidywaniu opóźnień.
  • Kilka obiecujących obszarów wciąż znajduje się w fazie rozwoju. Ciągłe uczenie się, uczenie maszynowe oparte na związkach przyczynowych, modele hybrydowe, adaptacja międzydomenowa oraz prognozowanie uwzględniające niepewność – wszystkie te rozwiązania wydają się przydatne, ale rozróżniłbym to, co zostało już zademonstrowane, od tego, co jest gotowe do wdrożenia.
Podsumuj artykuł za pomocą AI

Uczenie maszynowe stało się nudne. Taka jest obecnie tendencja.

A przynajmniej wiele interesujących postępów ma miejsce w obszarach, które nie nadają się na sensacyjne nagłówki: skrócenie czasu wnioskowania o 40 milisekund, uczenie się przy użyciu mniejszej liczby etykiet, ponowne wykorzystanie modelu zamiast tworzenia nowego, ustalenie, dlaczego system o 96-procentowej dokładności wciąż popełnia błędy w odniesieniu do tej samej grupy użytkowników.

I to prawdopodobnie dobra wiadomość. Uważam, że większość firm tak naprawdę nie potrzebuje wielkiego przełomu w dziedzinie uczenia maszynowego. Nie miałyby nic przeciwko dobremu modelowi, który działa nawet przy zmianach danych, nie kosztuje fortuny w eksploatacji i ostrzega, gdy zaczyna zachowywać się dziwnie.

Przyjrzyjmy się zatem najnowszym trendom w uczeniu maszynowym, aby zobaczyć, w jakim kierunku zmierzają te prace.

Wykorzystaj uczenie maszynowe

Przegląd rynku uczenia maszynowego i prognozy

Rynek uczenia maszynowego szybko się rozwija. Jednak nie ma zgody co do tego, jak duży jest ten rynek.

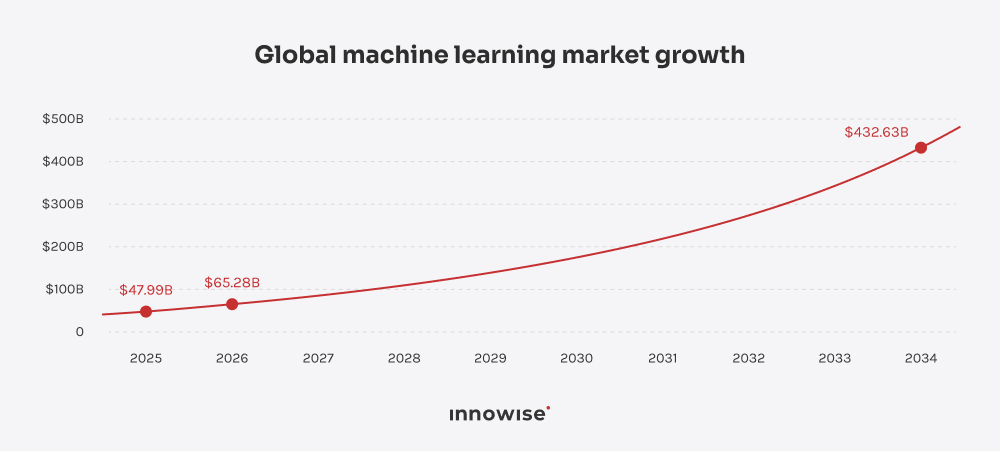
Fortune Business Insights szacuje wartość globalnego rynku uczenia maszynowego na 65,28 mld dolarów w 2026 r. i przewiduje, że do 2034 r. osiągnie on wartość 432,63 mld dolarów. The Business Research Company podaje znacznie wyższe szacunki na ten sam rok: 127,94 mld dolarów w 2026 r., a do 2030 r. wartość ta wzrośnie do 445,25 mld dolarów.

Global machine learning market growth 2025-2034.

To prawie dwukrotna różnica w perspektywie roku 2026. Przede wszystkim pokazuje to, że “rynek uczenia maszynowego” jest kategorią zaskakująco elastyczną: różni analitycy uwzględniają różne kombinacje oprogramowania, infrastruktury, usług i sprzętu.

Szczegóły zawarte w prognozach są również przydatne. Magazyn "Fortune" przewiduje, że wdrożenia w chmurze będą stanowić 53,14% rynku uczenia maszynowego w 2026 r., przy czym udział dużych przedsiębiorstw wyniesie 55,61% oraz branża IT i telekomunikacyjna – 17,56% końcowego wykorzystania.

Tymczasem firma Gartner przewiduje, że wydatki na platformy AI do analizy danych i uczenia maszynowego osiągną w 2026 r. poziom 26,44 mld dolarów, co oznacza wzrost o 36,3% w porównaniu z rokiem 2025.

Nie przywiązywałbym więc zbytniej wagi do jednej, ogromnej liczby rynkowej. Istotny jest kierunek: wydatki rosną, chmura ma duży udział we wdrożeniach, a narzędzia związane z uczeniem maszynowym stają się samodzielnym, znaczącym rynkiem.

Przyjrzyjmy się teraz samym najnowszym trendom w dziedzinie uczenia maszynowego.

Aktualne trendy w dziedzinie uczenia maszynowego

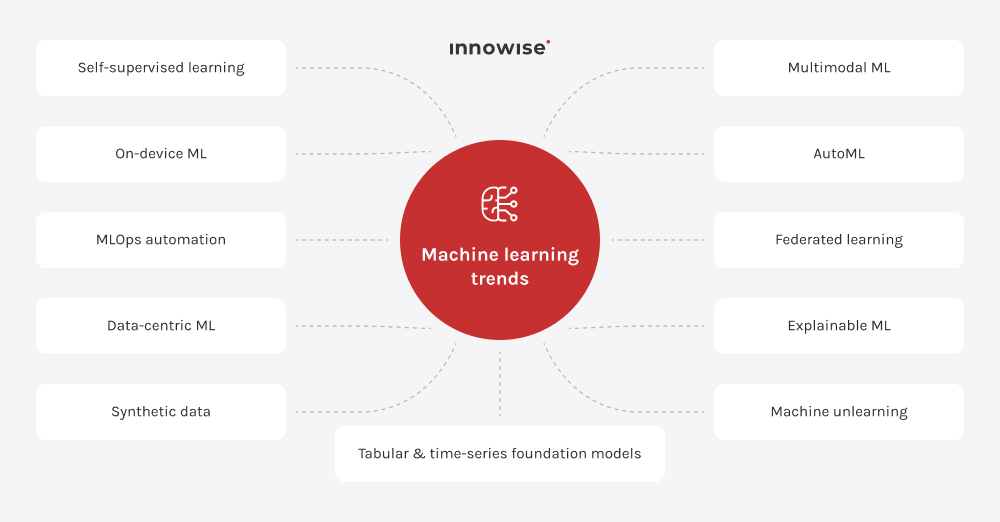
Niektóre z najważniejszych trendów w dziedzinie uczenia maszynowego są nowe. Inne istnieją już od lat i dopiero teraz stają się na tyle praktyczne, że mogą wyjść poza krąg zespołów badawczych. Szczerze mówiąc, bardziej interesuje mnie ta druga grupa, ale w każdym razie przejdźmy do rzeczy.

Key machine learning trends this year.

Modele podstawowe dla danych tabelarycznych i szeregów czasowych

Tabele przeżywają swój moment w modelu Foundation.

W czerwcu 2026 r. firma Google wprowadziła TabFM, model do klasyfikacji i regresji tabelarycznej, który może generować prognozy na nowych zbiorach danych bez konieczności przeprowadzania typowego dla danego zadania szkolenia i dostrajania hiperparametrów. Firma Google przetestowała go na 38 zbiorach danych do klasyfikacji i 13 do regresji, w tym na tabelach zawierających nawet 150 000 próbek.

Co jest w tym ciekawego? Sposób, w jaki model został wytrenowany. Nie istnieje żadna gigantyczna publiczna baza czystych tabel korporacyjnych, więc Google wygenerowało zamiast tego setki milionów syntetycznych zbiorów danych.

Nie usuwałbym jeszcze XGBoost. W przypadku wielu problemów związanych z danymi ustrukturyzowanymi konwencjonalne modele są nadal tańsze, łatwiejsze do debugowania i bardzo trudne do pokonania. Jednak pomysł otwarcia nowego zbioru danych i uzyskania przyzwoitej wartości bazowej bez kolejnego maratonu dostrajania jest całkiem atrakcyjny.

Również szereg czasu zmierza w tym samym kierunku. Model Google TimesFM firmy Google jest wstępnie wytrenowany na dużych zbiorach danych szeregów czasowych i potrafi generować prognozy typu zero-shot dla zbiorów danych, których wcześniej nie widział. Atrakcyjność tego rozwiązania jest podobna do TabFM: mniej szkolenia ukierunkowanego na konkretne zadania za każdym razem, gdy ktoś potrzebuje nowej prognozy popytu, ruchu lub przepustowości.

Czy zastąpiłbym nim wszystkie istniejące procesy prognozowania? Nie. Ale warto to przetestować, gdy alternatywą jest kolejna runda szkolenia i dostrajania modelu od podstaw.

Uczenie się bez nadzoru wymaga mniejszej liczby etykiet

Oznaczanie danych to jedno z tych zadań, co do których wszyscy zgadzają się, że są niezbędne, ale nikt nie jest chętny, by za nie płacić.

Uczenie się bez nadzoru pozwala częściowo obejść ten problem, polegając najpierw na wyuczeniu się użytecznych reprezentacji na podstawie danych nieoznaczonych, a następnie dostosowaniu ich do mniejszego zbioru danych oznaczonych.

Dobrym przykładem jest model DINOv3 firmy Meta. Został on wytrenowany na 1,7 miliarda obrazów bez etykiet nadanych przez człowieka, a największy model osiągnął 7 miliardów parametrów. Ta sama zamrożona struktura wizualna może następnie obsługiwać zadania takie jak klasyfikacja, wykrywanie obiektów, segmentacja i śledzenie.

Dla firm dysponujących wieloletnim zbiorem nieoznaczonych zdjęć kontrolnych, zdjęć satelitarnych, obrazów medycznych lub nagrań wideo zmienia to nieco ekonomię przedsięwzięcia. Etykiety mogą nadal być potrzebne. Tylko że być może nie będzie ich kilka milionów.

Mniejsze modele znów stają się coraz bardziej interesujące

Piękny model, który potrzebuje centrum danych, by odpowiedzieć na proste pytanie, ma ograniczony urok w przypadku telefonu, czujnika, aparatu fotograficznego czy sterownika przemysłowego.

Dlatego kompresja modeli cieszy się coraz większym zainteresowaniem: kwantyzacja zmniejsza precyzję numeryczną, przycinanie usuwa mniej przydatne wagi, a destylacja przenosi wiedzę do mniejszego modelu. Własny zestaw narzędzi optymalizacyjnych TensorFlowwłasny zestaw narzędzi optymalizacyjnych wymienia opóźnienia, zużycie pamięci, pobór mocy oraz rozmiar modelu jako główne ograniczenia wdrożenia na urządzeniach brzegowych.

Nie ma tu nic za darmo. Zbyt agresywna kompresja powoduje spadek dokładności.

Zadaniem jest znalezienie punktu, w którym nikt tego nie zauważy, z wyjątkiem rachunku za infrastrukturę.

MLOps staje się coraz mniej opcjonalne

Trenowanie modelu nigdy nie było całym zadaniem. Po prostu spędziliśmy zaskakująco dużo czasu, udając, że tak właśnie jest.

Gdy system uczenia maszynowego zostanie uruchomiony, ktoś musi wiedzieć, który zbiór danych go wygenerował, która wersja kodu go wytrenowała, czy dane wejściowe uległy zmianie, czy wydajność ulega wahaniom, kiedy dozwolone jest ponowne trenowanie oraz jak cofnąć nieudaną aktualizację.

Narzędzia odzwierciedlają tę sytuację. MLflow 3, na przykład, rozszerzyło swoją architekturę zarządzania modelami o lepsze śledzenie pochodzenia oraz porównywanie wersji modeli i eksperymentów.

Jest to prawdopodobnie jeden z najmniej efektownych trendów w uczeniu maszynowym na tej liście, a jednocześnie jeden z tych, które traktowałbym najpoważniej.

Dane syntetyczne poddane weryfikacji w praktyce

Dane syntetyczne brzmią niezwykle wygodnie. Brakuje przykładów? Stwórz je sam.

To może się sprawdzić. Może też sprawić, że model będzie bardzo dobrze rozumiał sztuczny świat, który tak naprawdę nie istnieje.

W artykule badawczym firmy Apple z 2026 roku przeanalizowano połączenie prawdziwych i syntetycznych danych szkoleniowych i odkryto coś bardziej przydatnego niż stwierdzenie, że “dane syntetyczne pomagają”. Wyniki sugerują, że może istnieć optymalny stosunek: dodanie danych syntetycznych poprawia wydajność do pewnego momentu, a następnie zaczyna się pogarszać, gdy rozkłady danych syntetycznych i rzeczywistych zbytnio się od siebie oddalają.

Uczenie maszynowe oparte na wielu modach wkracza w obszar zwykłych prognoz

Termin "multimodalny" nie musi oznaczać modelu, który potrafi omówić Twoje zdjęcie i napisać o nim wiersz.

W przypadku uczenia maszynowego służącego do prognozowania może to być znacznie mniej ekscytujące, ale o wiele bardziej użyteczne: zdjęcie produktu + opis + cena, wynik badania medycznego + historia pacjenta, odczyty czujników + notatki dotyczące konserwacji.

Na przykład obecne narzędzia AutoGluon potrafią łączyć dane obrazowe, tekstowe, tabelaryczne i dokumentowe do zadań takich jak klasyfikacja i regresja.

I tu pojawia się problem. Co się stanie, gdy zabraknie obrazu? Albo czujnik przestanie działać? Albo jedno źródło danych dotrze dwie godziny później niż pozostałe?

To musi być uwzględnione w ocenie, a nie stanowić niespodziankę odkrytą po uruchomieniu systemu.

AutoML wciąż eliminuje nudne zadania

Wybór modelu, dostrajanie hiperparametrów, uczenie zespołowe, niektóre etapy przetwarzania cech: wiele z tych czynności można już całkiem nieźle zautomatyzować.

Dobrze.

Nie jestem przekonany, czy wysoko opłacany inżynier ML musi spędzać popołudnie na ręcznym testowaniu 47 kombinacji tempa uczenia się i głębokości drzewa tylko po to, by udowodnić swoje oddanie tej dziedzinie.

To, czego AutoML nie automatyzuje zbyt dobrze, to podejmowanie decyzji, czy cel ma sens, czy dane szkoleniowe ujawniają informacje z przyszłości, czy metryka oceny odzwierciedla koszty biznesowe, czy też w ogóle model powinien istnieć.

To nadal są kłopotliwe problemy, które musi rozwiązać człowiek.

Uczenie federacyjne wciąż nie oznacza prywatności

Uczenie federacyjne ma bardzo atrakcyjną koncepcję: umożliwia szkolenie modeli na wielu urządzeniach lub w wielu organizacjach bez konieczności przenoszenia wszystkich surowych danych do jednej centralnej bazy danych.

Przydatne, to prawda. Ale czy zapewnia automatyczną prywatność? Nie.

NIST udokumentował ataki, które pozwalają odzyskać informacje z aktualizacji modeli wymienianych podczas uczenia federacyjnego i zaleca stosowanie dodatkowych zabezpieczeń zamiast traktowania samej decentralizacji jako gwarancji prywatności.

A rzeczywiste wdrożenia są chaotyczne. Różne urządzenia mają różną moc obliczeniową, uczestnicy znikają, rozkłady danych się różnią, a założenia dotyczące bezpieczeństwa ulegają naruszeniu. Przegląd wdrożeń NIST z 2024 r. dość wyraźnie pokazuje rozbieżność między zgrabną teorią uczenia federacyjnego a systemami produkcyjnymi.

Jeden z cytowanych tam ekspertów, dr Mat Weldon z brytyjskiego Urzędu Statystycznego, ujął to lepiej niż ja:

“Łatwiej jest zaprojektować nową architekturę uczenia federacyjnego niż przeprowadzić na niej testy typu red team.”

Słuszna uwaga.

Wyjaśnialność staje się mniej formalna

Przez lata dodanie wykresu SHAP do pulpitu nawigacyjnego mogło sprawiać, że model wydawał się w satysfakcjonujący sposób “wyjaśnialny”.

To dość niska poprzeczka.

NIST rozróżnia między wyjaśnialnością, czyli zrozumieniem, w jaki sposób system wygenerował wynik, a interpretowalnością, czyli znaczeniem tego wyniku w danym kontekście. W swoich wytycznych zaleca również przetestowanie metod wyjaśniania przed wdrożeniem, zamiast zakładać, że wyjaśnienie jest poprawne tylko dlatego, że wykres wygląda przekonująco.

Naukowcy z NIST opublikowali w 2026 r. pracę na temat wyjaśnialnej walidacji i redukcji cech, co jest interesujące, ponieważ zbliża wyjaśnialność do testowania modeli, zamiast traktować ją jako warstwę dodawaną później.

Podoba mi się ten kierunek. Wyjaśnienie powinno być czymś, co testujemy, a nie ozdobą karty modelu.

Oduczanie się maszyn staje się prawdziwym wyzwaniem inżynieryjnym

Załóżmy, że ktoś poprosi cię o usunięcie swoich danych.

Usuwasz rekord z bazy danych.

W porządku.

A co z modelem, który został już na nich wytrenowany?

W tym miejscu pojawia się oduczenie maszynowe: usuwanie wpływu konkretnych danych szkoleniowych bez konieczności ponownego trenowania całego modelu od zera. W czerwcu 2026 r. Google Research opublikowało framework służący do weryfikacji, czy model poddany procesowi “unlearning” rzeczywiście zachowuje się bardziej jak świeżo ponownie wytrenowany model niż jak model pierwotny.

I ta druga część ma znaczenie. Zapomnienie czegoś to jeden problem. Udowodnienie, że model o tym zapomniał, to zupełnie inna sprawa.

Oduczanie się maszyn wciąż jest znacznie bliższe aktywnym badaniom niż rutynowym narzędziom korporacyjnym, ale warto mieć to na uwadze. W momencie, gdy „usuń moje dane” będzie musiało oznaczać coś więcej niż tylko usunięcie wiersza, przestanie to być teorią.

Stwórz rozwiązanie oparte na uczeniu maszynowym dla swojej firmy

Jak trendy w dziedzinie uczenia maszynowego zmieniają procesy pracy w różnych branżach

Ten sam trend w dziedzinie uczenia maszynowego może przejawiać się zupełnie inaczej, gdy zostanie wdrożony w rzeczywistym procesie roboczym. W handlu detalicznym szybsze wnioskowanie może oznaczać aktualizację rekomendacji jeszcze w trakcie przeglądania asortymentu przez klienta. W przemyśle może to oznaczać wykrycie wady, zanim produkt dotrze dalej na linii produkcyjnej.

  • Edukacja
  • Handel detaliczny i elektroniczny
  • Bankowość i finanse
  • Opieka zdrowotna
  • Produkcja
  • Logistyka i transport

Edukacja

Platformy edukacyjne dysponują już ogromną ilością danych: odpowiedziami, próbami rozwiązania zadań, czasem reakcji, pominiętymi zadaniami, postępami w kursie. Trudniejsze jest przekształcenie tych danych w coś użytecznego, nie udając przy tym, że model rozumie ucznia lepiej niż nauczyciel.

Uczenie maszynowe było już największy segment technologiczny na rynku sztucznej inteligencji w edukacji w 2025 r., a do głównych zastosowań należą monitorowanie wyników, personalizacja oraz inteligentne systemy nauczania.

  • Dostosuj poziom trudności ćwiczeń i ich kolejność w oparciu o dotychczasowe wyniki, zamiast zmuszać wszystkich do podążania tą samą ścieżką.
  • Przewidywanie ryzyka przedwczesnego zakończenia nauki na podstawie takich tendencji, jak spadająca frekwencja, powtarzające się niepowodzenia lub długie przerwy między sesjami.
  • Wcześniejsze wykrywanie luk w wiedzy oraz wprowadzić zmiany w planie zajęć, zanim uczeń przejdzie do kolejnego tematu, będąc całkowicie nieprzygotowanym.
Handel detaliczny i elektroniczny

Branża detaliczna korzysta z uczenia maszynowego już od lat, ale najciekawsze zmiany dotyczą szybkości i różnorodności danych. Prognozy mogą być aktualizowane częściej, rekomendacje mogą opierać się nie tylko na historii zakupów, a wyszukiwanie wizualne może łączyć obrazy z opisami produktów i danymi katalogowymi.

  • Prognozowanie popytu i automatyzacja uzupełniania zapasów w oparciu o historię sprzedaży, sezonowość, promocje oraz najświeższe dane operacyjne.
  • Spersonalizuj rekomendacje na podstawie zachowań związanych z przeglądaniem i zakupami, a nie na podstawie statycznych segmentów klientów.
  • Ulepszenie wyszukiwania produktów poprzez połączenie danych tekstowych i graficznych, co jest przydatne, gdy klient nie zna nazwy produktu, ale dysponuje jego zdjęciem.

Bankowość i finanse

W sektorze bankowym trudno zignorować kwestie monitorowania modeli, ich wyjaśnialności oraz dryftu. Wzorce oszustw ulegają zmianom, zmienia się zachowanie klientów, a model, który jeszcze sześć miesięcy temu wydawał się dobry, może bardzo szybko stać się bardzo kosztowny.

Globalny rynek uczenie maszynowe w bankowości W 2025 r. wartość rynku wynosiła około 40 miliardów dolarów i według prognoz ma osiągnąć poziom około 150 miliardów dolarów do 2034 rokuzgodnie z Fortune Business Insights.

  • Wykrywanie podejrzanych transakcji oraz klasyfikować sprawy tak, aby śledczy zajmowali się najpierw tymi, które wydają się najbardziej ryzykowne.
  • Wyjaśnij decyzje kredytowe poprzez wskazanie, które czynniki miały największy wpływ na wynik.
  • Monitorowanie odchylenia modelu w miarę jak zmieniają się techniki oszustw, wzorce wydatkowania oraz profile klientów.

Opieka zdrowotna

Opieka zdrowotna to jedna z tych dziedzin, w których sama dobra wartość odniesienia wcale nie wystarcza. Modele mogą zachowywać się różnie w zależności od szpitala, grupy pacjentów, urządzeń i warunków klinicznych, dlatego kalibracja i monitorowanie mają równie duże znaczenie, jak surowe dane skuteczność prognostyczna.

Globalny rynek analityki predykcyjnej w sektorze opieki zdrowotnej szacuje się na 19,7 mld dolarów w 2026 r. autor: Grand View Research,, która przewiduje, że osiągnie 49,3 mld dolarów do 2033 r..

  • Rozpoznawanie wczesnych oznak pogorszenia stanu, w tym ryzyko sepsy, zanim sytuacja stanie się klinicznie oczywista.
  • Ocena ryzyka ponownej hospitalizacji oraz nadać priorytet działaniom następczym w przypadku pacjentów, u których istnieje większe prawdopodobieństwo powrotu.
  • Klasyfikacja spraw do rozpatrzenia dzięki czemu lekarze mogą skupić swoją uwagę na obszarach, w których przewidywane ryzyko jest najwyższe.

Produkcja

Przemysł wytwórczy jest prawdopodobnie najbardziej oczywistym przykładem do uczenia maszynowego na urządzeniu. Jeśli kamera monitoruje części przemieszczające się wzdłuż linii produkcyjnej, często nie ma sensu wysyłać każdego obrazu do chmury i czekać na odpowiedź.

Szerszy rynek sztucznej inteligencji w przemyśle wytwórczym szacuje się na 9,85 mld dolarów w 2026 r., przy czym uczenie maszynowe i wizja komputerowa są wykorzystywane do konserwacji predykcyjnej, kontroli, kontroli jakości oraz planowania produkcji.

  • Przewidywanie awarii sprzętu na podstawie wibracji, temperatury, ciśnienia oraz historii konserwacji.
  • Wykrywanie wad za pomocą wizji komputerowej gdy produkt znajduje się jeszcze na linii produkcyjnej.
  • Prognozowanie jakości produktu na podstawie parametrów produkcyjnych przed kontrolą końcową.

Logistyka i transport

Logistyka obfituje w problemy związane z prognozowaniem, co sprawia, że jest naturalnym polem do zastosowania uczenia maszynowego: czasy przyjazdu, opóźnienia, zapotrzebowanie magazynowe, ruch drogowy, zmiany tras, nieudane przesiadki.

Wykorzystanie Wartość rynku uczenia maszynowego w logistyce szacowana jest na 5,3 mld dolarów w 2026 roku i według prognoz ma osiągnąć 44,5 mld dolarów do 2035 r.zgodnie z Global Market Insights.

W tym przypadku niepewność też ma znaczenie. “Przewidywany czas przyjazdu: 14:10” i “Przewidywany czas przyjazdu: 14:10, ale tak naprawdę nie jesteśmy tego pewni” to dwie zupełnie różne informacje dla osoby czekającej przy rampie załadunkowej.

  • Przewidywanie godzin przyjazdu w oparciu o dane historyczne dotyczące opóźnień, warunki na drogach oraz aktualne pozycje pojazdów.
  • Przewidywane opóźnienia w dostawach na tyle wcześnie, by można było dostosować plany magazynowe lub dostawcze.
  • Prognozowanie czasu podróży i popytu w celu wsparcia planowania tras i przydzielania pojazdów.

Edukacja

Platformy edukacyjne dysponują już ogromną ilością danych: odpowiedziami, próbami rozwiązania zadań, czasem reakcji, pominiętymi zadaniami, postępami w kursie. Trudniejsze jest przekształcenie tych danych w coś użytecznego, nie udając przy tym, że model rozumie ucznia lepiej niż nauczyciel.

Uczenie maszynowe było już największy segment technologiczny na rynku sztucznej inteligencji w edukacji w 2025 r., a do głównych zastosowań należą monitorowanie wyników, personalizacja oraz inteligentne systemy nauczania.

  • Dostosuj poziom trudności ćwiczeń i ich kolejność w oparciu o dotychczasowe wyniki, zamiast zmuszać wszystkich do podążania tą samą ścieżką.
  • Przewidywanie ryzyka przedwczesnego zakończenia nauki na podstawie takich tendencji, jak spadająca frekwencja, powtarzające się niepowodzenia lub długie przerwy między sesjami.
  • Wcześniejsze wykrywanie luk w wiedzy oraz wprowadzić zmiany w planie zajęć, zanim uczeń przejdzie do kolejnego tematu, będąc całkowicie nieprzygotowanym.

Handel detaliczny i elektroniczny

Branża detaliczna korzysta z uczenia maszynowego już od lat, ale najciekawsze zmiany dotyczą szybkości i różnorodności danych. Prognozy mogą być aktualizowane częściej, rekomendacje mogą opierać się nie tylko na historii zakupów, a wyszukiwanie wizualne może łączyć obrazy z opisami produktów i danymi katalogowymi.

  • Prognozowanie popytu i automatyzacja uzupełniania zapasów w oparciu o historię sprzedaży, sezonowość, promocje oraz najświeższe dane operacyjne.
  • Spersonalizuj rekomendacje na podstawie zachowań związanych z przeglądaniem i zakupami, a nie na podstawie statycznych segmentów klientów.
  • Ulepszenie wyszukiwania produktów poprzez połączenie danych tekstowych i graficznych, co jest przydatne, gdy klient nie zna nazwy produktu, ale dysponuje jego zdjęciem.

Bankowość i finanse

W sektorze bankowym trudno zignorować kwestie monitorowania modeli, ich wyjaśnialności oraz dryftu. Wzorce oszustw ulegają zmianom, zmienia się zachowanie klientów, a model, który jeszcze sześć miesięcy temu wydawał się dobry, może bardzo szybko stać się bardzo kosztowny.

Globalny rynek uczenie maszynowe w bankowości W 2025 r. wartość rynku wynosiła około 40 miliardów dolarów i według prognoz ma osiągnąć poziom około 150 miliardów dolarów do 2034 rokuzgodnie z Fortune Business Insights.

  • Wykrywanie podejrzanych transakcji oraz klasyfikować sprawy tak, aby śledczy zajmowali się najpierw tymi, które wydają się najbardziej ryzykowne.
  • Wyjaśnij decyzje kredytowe poprzez wskazanie, które czynniki miały największy wpływ na wynik.
  • Monitorowanie odchylenia modelu w miarę jak zmieniają się techniki oszustw, wzorce wydatkowania oraz profile klientów.

Opieka zdrowotna

Opieka zdrowotna to jedna z tych dziedzin, w których sama dobra wartość odniesienia wcale nie wystarcza. Modele mogą zachowywać się różnie w zależności od szpitala, grupy pacjentów, urządzeń i warunków klinicznych, dlatego kalibracja i monitorowanie mają równie duże znaczenie, jak surowe dane skuteczność prognostyczna.

Globalny rynek analityki predykcyjnej w sektorze opieki zdrowotnej szacuje się na 19,7 mld dolarów w 2026 r. autor: Grand View Research,, która przewiduje, że osiągnie 49,3 mld dolarów do 2033 r..

  • Rozpoznawanie wczesnych oznak pogorszenia stanu, w tym ryzyko sepsy, zanim sytuacja stanie się klinicznie oczywista.
  • Ocena ryzyka ponownej hospitalizacji oraz nadać priorytet działaniom następczym w przypadku pacjentów, u których istnieje większe prawdopodobieństwo powrotu.
  • Klasyfikacja spraw do rozpatrzenia dzięki czemu lekarze mogą skupić swoją uwagę na obszarach, w których przewidywane ryzyko jest najwyższe.

Produkcja

Przemysł wytwórczy jest prawdopodobnie najbardziej oczywistym przykładem do uczenia maszynowego na urządzeniu. Jeśli kamera monitoruje części przemieszczające się wzdłuż linii produkcyjnej, często nie ma sensu wysyłać każdego obrazu do chmury i czekać na odpowiedź.

Szerszy rynek sztucznej inteligencji w przemyśle wytwórczym szacuje się na 9,85 mld dolarów w 2026 r., przy czym uczenie maszynowe i wizja komputerowa są wykorzystywane do konserwacji predykcyjnej, kontroli, kontroli jakości oraz planowania produkcji.

  • Przewidywanie awarii sprzętu na podstawie wibracji, temperatury, ciśnienia oraz historii konserwacji.
  • Wykrywanie wad za pomocą wizji komputerowej gdy produkt znajduje się jeszcze na linii produkcyjnej.
  • Prognozowanie jakości produktu na podstawie parametrów produkcyjnych przed kontrolą końcową.

Logistyka i transport

Logistyka obfituje w problemy związane z prognozowaniem, co sprawia, że jest naturalnym polem do zastosowania uczenia maszynowego: czasy przyjazdu, opóźnienia, zapotrzebowanie magazynowe, ruch drogowy, zmiany tras, nieudane przesiadki.

Wykorzystanie Wartość rynku uczenia maszynowego w logistyce szacowana jest na 5,3 mld dolarów w 2026 roku i według prognoz ma osiągnąć 44,5 mld dolarów do 2035 r.zgodnie z Global Market Insights.

W tym przypadku niepewność też ma znaczenie. “Przewidywany czas przyjazdu: 14:10” i “Przewidywany czas przyjazdu: 14:10, ale tak naprawdę nie jesteśmy tego pewni” to dwie zupełnie różne informacje dla osoby czekającej przy rampie załadunkowej.

  • Przewidywanie godzin przyjazdu w oparciu o dane historyczne dotyczące opóźnień, warunki na drogach oraz aktualne pozycje pojazdów.
  • Przewidywane opóźnienia w dostawach na tyle wcześnie, by można było dostosować plany magazynowe lub dostawcze.
  • Prognozowanie czasu podróży i popytu w celu wsparcia planowania tras i przydzielania pojazdów.
Model, który wygrywa w teście porównawczym, nie zawsze jest tym, który wybrałbym do wdrożenia w produkcji. Gdy weźmie się pod uwagę opóźnienia, koszty infrastruktury, odchylenia i konserwację, nieco mniej dokładny model może z łatwością okazać się lepszym rozwiązaniem z technicznego punktu widzenia.
Dmitry Nazarevich, CTO.
Dmitry Nazarevich
Dyrektor ds. technologii

Przyszłe trendy w dziedzinie uczenia maszynowego

Niektóre pomysły z dziedziny uczenia maszynowego już dziś okazują się przydatne. Inne wciąż wymagają lepszych testów porównawczych, tańszych zasobów obliczeniowych lub kilku nieprzyjemnych doświadczeń w środowisku produkcyjnym, zanim będę mógł uznać je za gotowe.

Oto nowe trendy w uczeniu maszynowym, które warto obserwować.

  • Cross-domain generalization and adaptation icon.

    Uogólnianie i adaptacja międzydomenowa

    Jedna z najstarszych trudności związanych z uczeniem maszynowym nadal pozostaje aktualna: wystarczy wytrenować model w jednym środowisku, przenieść go do nieco innego i od razu zauważymy spadek wydajności.

    Uogólnienie domenowe ma na celu zapewnienie, by modele radziły sobie z rozkładami danych, których wcześniej nie widziały. Badanie z 2026 roku dotyczące klasyfikacji wzorców w nieznanych środowiskach opisuje właśnie ten problem: zmiany w czujnikach, warunkach pozyskiwania danych lub innych cechach domeny mogą wystarczyć, by poważnie osłabić model.

    Łatwo sobie wyobrazić praktyczne zastosowanie. Model rozpoznawania obrazu, wytrenowany w jednej fabryce, musi działać w innej fabryce wyposażonej w inne kamery. Model medyczny zostaje przeniesiony do innego szpitala. Model wykrywający oszustwa analizuje nową grupę klientów.

    Podejrzewam, że z czasem będzie to w mniejszym stopniu specjalizacja badawcza, a w większym – podstawowy wymóg wdrożeniowy.

  • Continual learning icon.

    Ciągłe uczenie się

    Większość modeli produkcyjnych nadal uczy się etapami: gromadzenie nowych danych, ponowne szkolenie, walidacja, ponowne wdrożenie.

    Celem uczenia ciągłego jest osiągnięcie płynniejszego działania. Model nieustannie się uczy w miarę napływania nowych danych, nie zapominając przy tym o tym, co już wiedział.

    Właśnie w tej ostatniej części tkwi haczyk.

    W przeglądzie systematycznym z 2026 roku obejmującym 189 recenzowanych artykułów dotyczących uczenia się ciągłego nadal wskazuje się na katastrofalne zapominanie jako jeden z głównych problemów tej dziedziny: nauka nowych rzeczy może negatywnie wpływać na wyniki w starszych zadaniach.

    Nie zastąpiłbym więc zaplanowanych szkoleń ciągłym uczeniem się tylko dlatego, że ta nazwa brzmi lepiej. Jednak w przypadku wykrywania oszustw, systemów przemysłowych, rekomendacji i innych środowisk, które nieustannie się zmieniają, zalety takiego podejścia są oczywiste.

  • Hybrid ML models icon.

    Hybrydowe modele uczenia maszynowego

    Jest w tym coś nieco zabawnego – poświęcać lata na próby nauczenia sieci neuronowych wszystkiego na podstawie danych, by w końcu odkryć, że znane prawa fizyki wciąż mogą się przydać.

    Dobrym przykładem jest model NeuralGCM firmy Google. Łączy on uczenie maszynowe z opartym na fizyce solwerem atmosferycznym, zamiast powierzać całość zadania tylko jednej z tych metod. W badaniu opublikowanym w Nature model ten generował konkurencyjne prognozy pogody i klimatu, zużywając przy tym od trzech do pięciu rzędów wielkości mniej zasobów obliczeniowych niż porównywalne modele konwencjonalne.

    Ta koncepcja wykracza daleko poza kwestie pogodowe.

    Jeśli znamy już ograniczenia fizyczne, zasady inżynieryjne lub inne zależności charakterystyczne dla danej dziedziny, wprowadzenie ich do modelu może mieć większy sens niż proszenie sieci neuronowej o ponowne odkrycie grawitacji na podstawie arkusza kalkulacyjnego.

  • Causal ML icon.

    Uczenie maszynowe oparte na związkach przyczynowych

    Prognozowanie pozwala odpowiedzieć na takie pytania, jak:

    Kto może zrezygnować z usług?

    Firmy zazwyczaj chcą usłyszeć następujące pytanie:

    Kto zostanie, jeśli zaoferujemy im zniżkę?

    To jest pytanie o związek przyczynowy.

    Uczenie maszynowe oparte na przyczynowości łączy uczenie maszynowe z wnioskowaniem przyczynowym w celu oszacowania, co może się wydarzyć w wyniku różnych interwencji. Dziedzina ta jest już wykorzystywana do szacowania zindywidualizowanych efektów leczenia w medycynie, choć naukowcy wciąż ostrzegają, że błędne założenia i czynniki zakłócające mogą prowadzić do przekonujących, ale błędnych wniosków.

    Myślę, że jest to jeden z ciekawszych kierunków badań w tej dziedzinie, ponieważ zmienia przeznaczenie modelu. Prognozowanie opisuje prawdopodobną przyszłość. Uczenie maszynowe oparte na związkach przyczynowych próbuje określić, czy podjęcie określonego działania wpłynie na tę przyszłość.

    Znacznie trudniejszy problem.

    O wiele bardziej przydatny.

  • Uncertainty-aware predictions icon.

    Prognozy uwzględniające niepewność

    Model wskazujący “92% poziom ufności” budzi zaufanie.

    Może to być też bzdura.

    Kalibracja niepewności ma na celu dostosowanie poziomu pewności do rzeczywistej dokładności prognoz. W artykule opublikowanym w Nature Machine Intelligence w 2026 r. opisują kalibrację jako niezbędny element niezawodnego wdrażania uczenia maszynowego właśnie dlatego, że współczesne modele mogą wykazywać wysoki poziom pewności, a jednocześnie popełniać błędy.

    Zmiana struktury dystrybucji jeszcze pogarsza tę sytuację. W badaniu opublikowanym w 2026 r. w czasopiśmie Scientific Reports stwierdzono, że modele predykcyjne mogą tracić zarówno wydajność, jak i kalibrację po przeniesieniu na heterogeniczne, rzeczywiste zbiory danych.

    Dla firm przydatnym rezultatem nie jest model, który zawsze podaje odpowiedź. Czasami lepszym modelem jest taki, który w gruncie rzeczy mówi: Nie jestem tego do końca pewien, przekaż to człowiekowi.

    Chciałbym widzieć tego znacznie więcej.

Potrzebujesz pomocy w wyborze odpowiedniego podejścia do uczenia maszynowego?

Kolejne kroki: jak firmy mogą wdrażać najnowsze trendy w dziedzinie technologii uczenia maszynowego

Najgorszym sposobem korzystania z tej listy jest wybranie jakiegoś trendu tylko dlatego, że wydaje się aktualny, a następnie szukanie problemu, do którego można go przypisz.

Zacznij raczej od tego irytującego problemu biznesowego.

01
Określ, co należy poprawić

Bardziej trafne prognozy? Mniej fałszywych alertów o oszustwach? Niższe koszty wnioskowania? Szybsza kontrola? Najpierw wybierz oczekiwany rezultat, a obecny proces potraktuj jako punkt odniesienia.

02
Sprawdź, czy dane to potwierdzają

Zanim zaczniesz porównywać modele, zwróć uwagę na etykiety, brakujące wartości, uprawnienia dostępu, nierównowagę klas, zasięg oraz to, czy dane produkcyjne będą przypominały dane wykorzystane do szkolenia. To właśnie w tym momencie wiele projektów z zakresu uczenia maszynowego bardzo szybko traci na atrakcyjności.

03
Porównaj to, co nowe, z tym, co nudne

Jeśli rozważasz zastosowanie wstępnie wytrenowanego modelu, systemu AutoML lub architektury multimodalnej, przetestuj go w porównaniu z prostszym modelem odniesienia w tych samych warunkach. Te same dane, te same wskaźniki, te same limity opóźnień, ten sam cel biznesowy.

Jeśli ten skomplikowany model zapewnia przewagę rzędu 0,3%, a jego eksploatacja kosztuje cztery razy więcej, to musiałbym mieć naprawdę dobry powód, żeby go zatrzymać.

04
Wprowadź to w miejscach, gdzie porażka nie będzie miała poważnych konsekwencji

Należy korzystać z reprezentatywnych danych i przetestować scenariusze, które najprawdopodobniej spowodują problemy: brakujące dane wejściowe, rzadkie klasy, nietypowe urządzenia, słabsze segmenty klientów, szczytowe obciążenia. Należy z góry ustalić, co skłoniłoby Państwa do przerwania programu pilotażowego.

05
Po uruchomieniu przypisz właściciela do modelu

Ktoś musi monitorować odchylenia, opóźnienia, koszty, kalibrację, wydajność podgrup oraz wskaźniki biznesowe, które model miał poprawić. Należy również zdecydować, kiedy należy go ponownie wytrenować, przywrócić poprzednią wersję, wymienić lub po prostu wyłączyć.

I tak, czasami właściwym wnioskiem jest to, że nowy trend w dziedzinie uczenia maszynowego nie przynosi wystarczającej poprawy, by uzasadnić wprowadzenie jakichkolwiek zmian.

To również można uznać za udaną ocenę.

arrow-icon.arrow-icon.
01 Określ, co należy poprawić

Bardziej trafne prognozy? Mniej fałszywych alertów o oszustwach? Niższe koszty wnioskowania? Szybsza kontrola? Najpierw wybierz oczekiwany rezultat, a obecny proces potraktuj jako punkt odniesienia.

arrow-icon.arrow-icon.
02 Sprawdź, czy dane to potwierdzają

Zanim zaczniesz porównywać modele, zwróć uwagę na etykiety, brakujące wartości, uprawnienia dostępu, nierównowagę klas, zasięg oraz to, czy dane produkcyjne będą przypominały dane wykorzystane do szkolenia. To właśnie w tym momencie wiele projektów z zakresu uczenia maszynowego bardzo szybko traci na atrakcyjności.

arrow-icon.arrow-icon.
03 Porównaj to, co nowe, z tym, co nudne

Jeśli rozważasz zastosowanie wstępnie wytrenowanego modelu, systemu AutoML lub architektury multimodalnej, przetestuj go w porównaniu z prostszym modelem odniesienia w tych samych warunkach. Te same dane, te same wskaźniki, te same limity opóźnień, ten sam cel biznesowy.

Jeśli ten skomplikowany model zapewnia przewagę rzędu 0,3%, a jego eksploatacja kosztuje cztery razy więcej, to musiałbym mieć naprawdę dobry powód, żeby go zatrzymać.

arrow-icon.arrow-icon.
04 Wprowadź to w miejscach, gdzie porażka nie będzie miała poważnych konsekwencji

Należy korzystać z reprezentatywnych danych i przetestować scenariusze, które najprawdopodobniej spowodują problemy: brakujące dane wejściowe, rzadkie klasy, nietypowe urządzenia, słabsze segmenty klientów, szczytowe obciążenia. Należy z góry ustalić, co skłoniłoby Państwa do przerwania programu pilotażowego.

arrow-icon.arrow-icon.
05 Po uruchomieniu przypisz właściciela do modelu

Ktoś musi monitorować odchylenia, opóźnienia, koszty, kalibrację, wydajność podgrup oraz wskaźniki biznesowe, które model miał poprawić. Należy również zdecydować, kiedy należy go ponownie wytrenować, przywrócić poprzednią wersję, wymienić lub po prostu wyłączyć.

I tak, czasami właściwym wnioskiem jest to, że nowy trend w dziedzinie uczenia maszynowego nie przynosi wystarczającej poprawy, by uzasadnić wprowadzenie jakichkolwiek zmian.

To również można uznać za udaną ocenę.

Zastosowania i trendy w dziedzinie uczenia maszynowego w praktyce: Innowise – studia przypadków

Wszystkie case studies
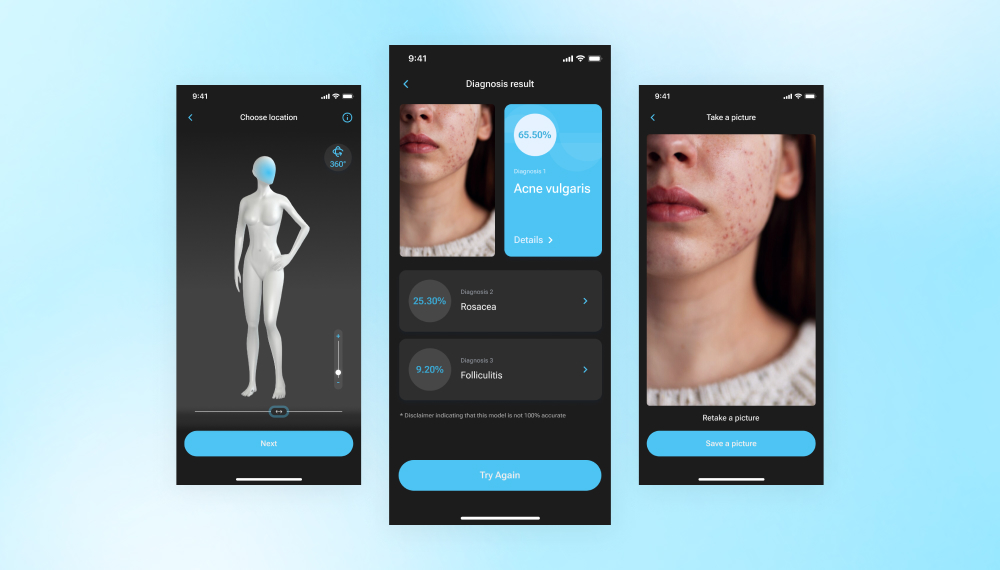
Tworzenie aplikacji do skanowania skóry z wykorzystaniem sztucznej inteligencji (AI)
Stworzona przez nas aplikacja oparta na sztucznej inteligencji wykorzystuje uczenie głębokie i rozpoznawanie obrazów do szybkiej oceny stanu skóry, przedstawiając wstępną diagnozę na podstawie zdjęć.
30 schorzenia dermatologiczne objęte programem
Tworzenie systemu zdalnego monitorowania pacjentów opartego na sztucznej inteligencji
Stworzyliśmy aplikację do opieki nad ranami w ramach oprogramowania do zdalnego monitorowania pacjentów i wdrożyliśmy analizę opartą na sztucznej inteligencji, która zapewnia dokładną ocenę.
2-poziomowy system ról użytkowników
100% zgodność systemu
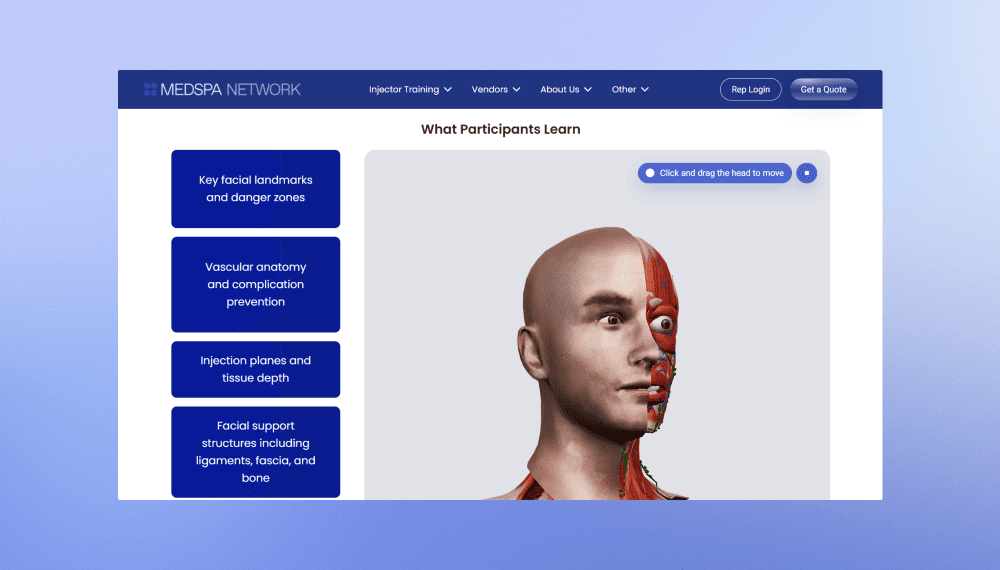
Przeprojektowanie i przebudowa strony internetowej MedSpa Network
Firma Innowise przebudowała stronę internetową MedSpa Network w oparciu o platformę WordPress, zapewniając zespołowi tej firmy możliwość samodzielnego wprowadzania codziennych aktualizacji treści.
2 miesiące od rozpoczęcia projektu do uruchomienia
3-5 leadów tygodniowo zamiast 1 leada miesięcznie
Zobacz studium przypadku
Client review logo. Opinia klienta
MedSpa Network website redesign and rebuild.
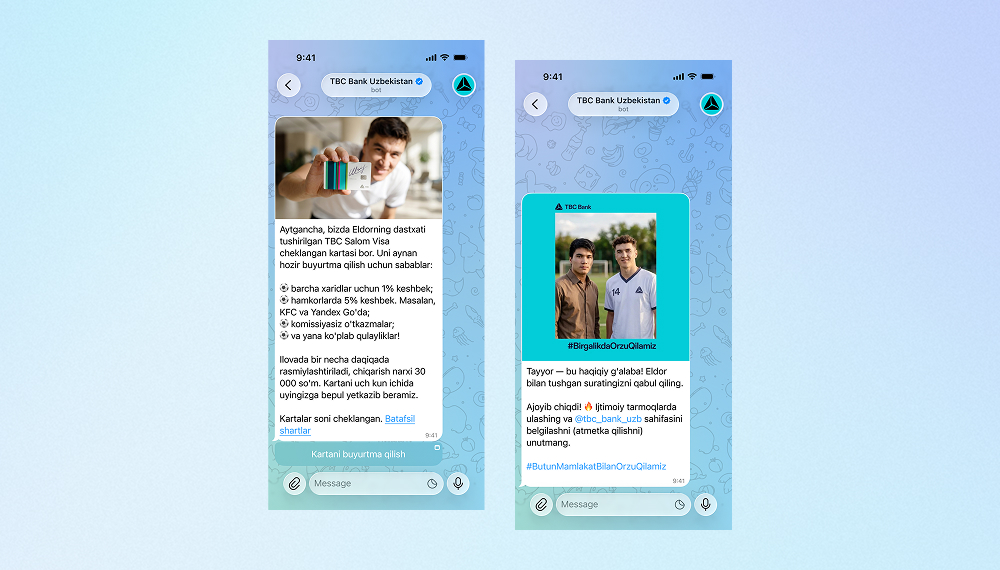
Bot oparty na sztucznej inteligencji na potrzeby kampanii marketingowej TBC Banku
Firma Innowise stworzyła dwujęzycznego bota na Telegramie, który generuje selfie tworzone przez sztuczną inteligencję z udziałem gwiazdy piłki nożnej, pełniącej rolę ambasadora marki TBC Bank.
3,000 zaangażowani użytkownicy
2 obsługiwane języki
Zobacz studium przypadku
Client review logo. Opinia klienta
AI Telegram bot..
Określenie strategii produktowej dla platformy pożyczkowej Bitlendex opartej na bitcoinie
Firma Innowise przeprowadziła fazę analizy wstępnej dla Bitlendex, pomagając klientowi przekształcić koncepcję produktu na wczesnym etapie rozwoju w sprawdzony model biznesowy oraz jasno zdefiniowany MVP.
1 miesiąc na cały etap rozpoznania
System doradztwa finansowego dla Bonnfinanz
Firma Innowise pomogła Bonnfinanz w stworzeniu internetowego systemu doradztwa i administracji, który umożliwia pracę mobilną oraz bezpośrednią interakcję z klientem.
Platforma do ładowania pojazdów elektrycznych z elastycznym systemem rozliczeń
Firma Innowise przyczyniła się do modernizacji platformy e-mobilności SMART/LAB poprzez ulepszenie jej funkcji związanych z rozliczeniami, płatnościami, zarządzaniem transakcjami oraz raportowaniem.
>50% szybsze rozliczanie i przetwarzanie płatności
Transformacja cloud-native DevOps firmy FinXP
Innowise pomogło firmie FinXP zmodernizować infrastrukturę usług finansowych poprzez migrację starszych interfejsów API i aplikacji opartych na języku PHP do architektury natywnej dla chmury.
11 aplikacji przeniesiono do Azure App Service
100% Infrastruktura jako kod
01 / 01
Close popup icon

Podsumowanie

W 2026> coraz więcej pracy poświęca się modelom wielokrotnego użytku, lepszym reprezentacjom, mniejszym śladom wnioskowania, monitorowaniu, kalibracji oraz ustalaniu, co się dzieje, gdy model napotyka dane, których nie było w zbiorze szkoleniowym.

To prawdopodobnie ta przydatna zmiana, o której warto pamiętać. Nowsze podejście jest lepsze tylko wtedy, gdy pasuje do problemu, danych, infrastruktury i sposobu, w jaki model będzie wykorzystywany. Jeśli starszy model działa równie dobrze i jest łatwiejszy w obsłudze, pozostań przy nim. Jeśli model bazowy pozwala zaoszczędzić tygodnie szkolenia, należy z niego skorzystać. Jeśli żaden z nich nie przejdzie pomyślnie odpowiedniego etapu pilotażowego, należy przejść dalej.

Sam trend nigdy nie jest powodem.

Jeśli zastanawiasz się, które podejścia do uczenia maszynowego mają sens w przypadku rzeczywistego produktu lub przepływu pracy, nasz zespół konsultantów ds. uczenia maszynowego może pomóc w zakresie architektury, wyboru modelu, walidacji i wdrożenia.

FAQ

Uczenie maszynowe (ML) to dziedzina sztucznej inteligencji, w której modele wyodrębniają wzorce z danych i wykorzystują je do formułowania prognoz lub podejmowania decyzji bez konieczności ręcznego definiowania wszystkich reguł.

W praktyce może to oznaczać prognozowanie popytu, wykrywanie oszustw, ocenę ryzyka, rekomendowanie produktów, wykrywanie usterek lub przewidywanie, kiedy sprzęt może ulec awarii.

Sztuczna inteligencja to szeroka kategoria. Uczenie maszynowe to jedna z metod tworzenia systemów sztucznej inteligencji poprzez uczenie się na podstawie danych. Uczenie głębokie jest podkategorią uczenia maszynowego opartą na wielowarstwowych sieciach neuronowych.

Związek ten jest więc dość prosty: uczenie głębokie stanowi część uczenia maszynowego, a uczenie maszynowe – część sztucznej inteligencji.

Zdecydowanie tak.

Metody takie jak gradient boosting, lasy losowe, regresja logistyczna i inne sprawdzone techniki nadal stanowią dobry wybór w przypadku wielu zadań związanych z danymi ustrukturyzowanymi. Mogą one być szybsze, tańsze i łatwiejsze do wyjaśnienia niż nowsze podejścia oparte na uczeniu głębokim.

Model nie staje się przestarzały tylko dlatego, że pojawił się bardziej modny.

Zazwyczaj są to te nudne kwestie: niska jakość danych, brakujące etykiety, słaba infrastruktura, niejasna struktura własnościowa, ograniczenia dotyczące prywatności, problemy z integracją oraz zbyt mała liczba osób, które rozumieją zarówno model, jak i związane z nim procesy biznesowe.

Jest jeszcze jedna kwestia: czasami proponowany system uczenia maszynowego nie usprawnia istniejącego procesu na tyle, by uzasadnić nakład pracy.

Warto się o tym dowiedzieć jak najwcześniej.

AutoML może zajmować się niektórymi etapami doboru modeli, dostrajania hiperparametrów, przetwarzania cech, łączenia modeli oraz przeprowadzania eksperymentów.

Ludzie nadal muszą zdecydować, co model powinien przewidywać, czy dane mają sens, które błędy mają największe znaczenie, jak należy mierzyć sukces oraz czy gotowy system jest wystarczająco bezpieczny i użyteczny, by go wdrożyć.

AutoML może przeprowadzać eksperymenty. Nie potrafi jednak ocenić, czy warto było je przeprowadzić.

Uczenie maszynowe na urządzeniu ma sens, gdy istotne jest opóźnienie, łączność jest niestabilna, przepustowość jest ograniczona lub dane wrażliwe powinny pozostać na urządzeniu.

Kompromis dotyczy sprzętu. Mniejsze urządzenia mają bardziej ograniczone zasoby pamięci, mocy obliczeniowej i energii, więc modele zazwyczaj wymagają kompresji lub innych optymalizacji, zanim będą mogły na nich płynnie działać.

W przypadku większości firm – nie.

Kwantowe uczenie maszynowe nadal pozostaje w dużej mierze tematem badawczym. Prowadzone są eksperymenty dotyczące optymalizacji, jąder kwantowych oraz hybrydowych modeli kwantowo-klasycznych, jednak konwencjonalne uczenie maszynowe pozostaje znacznie bardziej praktycznym rozwiązaniem dla zwykłych systemów produkcyjnych w 2026.

Gdyby ktoś proponował dziś wykorzystanie kwantowego uczenia maszynowego do rutynowego zadania prognozowania, najpierw zapytałbym, w czym dokładnie zawiódł zwykły model.

Pokaż wszystko

Spis treści

Wykorzystaj uczenie maszynowe

    Skontaktuj się z nami

    Umów się na rozmowę lub wypełnij poniższy formularz, a my odezwiemy się do Ciebie po przetworzeniu Twojego zgłoszenia.

    Wyślij nam wiadomość głosową
    Załącz dokumenty
    Prześlij plik

    Można załączyć 1 plik o rozmiarze do 2 MB. Prawidłowe formaty plików: pdf, jpg, jpeg, png.

    Klikając "Wyślij", wyrażasz zgodę na przetwarzanie Twoich danych osobowych przez Innowise zgodnie z naszą Polityką prywatności w celu przekazania Ci odpowiednich informacji. Podając numer telefonu, zgadzasz się na kontakt za pośrednictwem połączeń głosowych, SMS-ów lub komunikatorów. Mogą obowiązywać opłaty za połączenia, wiadomości i transmisję danych.

    Możesz także wysłać swoje zapytanie
    na contact@innowise.com
    Co dalej?
    1

    Po otrzymaniu i przeanalizowaniu Twojego zapytania skontaktujemy się z Tobą, aby omówić szczegółowe wymagania dotyczące projektu i podpisać umowę o zachowaniu poufności (NDA).

    2

    Po zapoznaniu się z Twoimi potrzebami i oczekiwaniami nasz zespół przygotuje propozycję realizacji projektu, uwzględniającą zakres prac, liczebność zespołu, przewidywany czas realizacji i szacunkowe koszty.

    3

    Zorganizujemy spotkanie w celu omówienia oferty i ustalenia szczegółów.

    4

    Na koniec podpiszemy umowę, błyskawicznie rozpoczynając pracę nad projektem.

    Interesują Cię inne usługi?

    arrow