Trends im Bereich des maschinellen Lernens 2026: Technologiewandel und Auswirkungen auf die Wirtschaft

12. November 2026 17 Minuten Lesezeit
Leiter der Abteilungen Big Data, KI/ML/DS
Verifizierter Experte
Jeder Artikel bei Innowise stammt von Autoren mit praktischer Erfahrung. Sie verstehen das Thema nicht nur theoretisch, sondern bringen auch Erkenntnisse aus konkreten Projekten ein.
11+ Jahre Erfahrung
Verifizierter Experte
11+ Jahre Erfahrung
Philip baut Dateninfrastrukturen auf, die für Klarheit sorgen. Er konzentriert sich auf das „Warum“ hinter den Daten und entwirft Systeme, die riesige Datenmengen in verwertbare Erkenntnisse umwandeln und gleichzeitig sicherstellen, dass die technische Vision klar und zielgerichtet bleibt.
Fachwissen
Big Data KI & ML Python
Gespräch vereinbaren

Wichtige Erkenntnisse

  • ML im Jahr 2026 wird immer praxisnaher. Ein Großteil der Fortschritte betrifft die Wiederverwendbarkeit, Effizienz, Überwachung, Kalibrierung und die Vereinfachung des Betriebs von Modellen in der Produktion.
  • Vortrainierte und selbstüberwachte Modelle verändern den Umfang dessen, was von Grund auf neu entwickelt werden muss. Tabellarische Grundmodelle, wiederverwendbare visuelle Darstellungen und synthetische Trainingsdaten können einen Teil des üblichen Trainings- und Beschriftungsaufwands reduzieren.
  • Einsatzbeschränkungen sind wichtiger als Siege bei Benchmark-Tests. Latenz, Speicherbedarf, Energieverbrauch, Drift, Leistung von Untergruppen und Inferenzkosten können wichtiger sein, als noch einen weiteren Bruchteil eines Prozents an Genauigkeit herauszuholen.
  • Dieselben Trends verändern sehr unterschiedliche Arbeitsabläufe. Im Einzelhandel zeigt sich dies bei Prognosen und Empfehlungen; im Bankwesen bei Betrugs- und Kreditrisiken; im Gesundheitswesen bei der Priorisierung von Patienten; in der Fertigung bei der vorausschauenden Instandhaltung und der Fehlererkennung; in der Logistik bei voraussichtlichen Ankunftszeiten und der Vorhersage von Verspätungen.
  • Einige vielversprechende Bereiche befinden sich noch in einem sehr frühen Entwicklungsstadium. Kontinuierliches Lernen, kausales maschinelles Lernen, Hybridmodelle, domänenübergreifende Anpassung und unsicherheitsbewusste Vorhersagen scheinen allesamt nützlich zu sein, doch ich würde unterscheiden zwischen dem, was bereits demonstriert wurde, und dem, was einsatzbereit ist.
Artikel mit KI zusammenfassen

ML ist mittlerweile langweilig. Das ist der Trend.

Oder zumindest finden viele der interessanten Fortschritte an Orten statt, die keine besonders guten Schlagzeilen liefern: die Inferenz um 40 Millisekunden zu verkürzen, mit weniger Labels zu trainieren, ein Modell wiederzuverwenden, anstatt ein neues zu erstellen, oder herauszufinden, warum ein System mit einer Genauigkeit von 96 % bei derselben Nutzergruppe immer wieder Fehler macht.

Und das ist wahrscheinlich eine gute Nachricht. Ich glaube, die meisten Unternehmen brauchen gar keinen großen ML-Durchbruch. Sie hätten nichts gegen ein gutes Modell einzuwenden, das auch bei Datenänderungen weiterhin funktioniert, dessen Betrieb kein Vermögen kostet und das eine Warnung ausgibt, wenn es anfängt, sich seltsam zu verhalten.

Schauen wir uns also die neuesten Trends im maschinellen Lernen an, um zu sehen, in welche Richtung sich diese Arbeit entwickelt.

Setzen Sie ML ein

Überblick und Prognose zum Markt für maschinelles Lernen

Der ML-Markt wächst rasant. Doch darüber, wie groß er tatsächlich ist, herrscht keine Einigkeit.

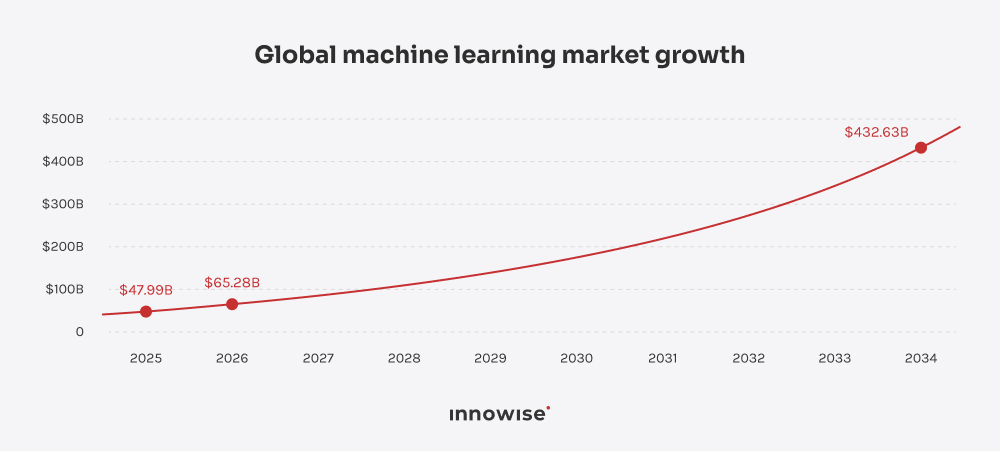
Fortune Business Insights schätzt den weltweiten Markt für maschinelles Lernen auf 65,28 Milliarden US-Dollar im Jahr 2026 und erwartet, dass er bis 2034 432,63 Milliarden US-Dollar erreichen wird. The Business Research Company gibt für dasselbe Jahr eine deutlich höhere Schätzung an: 127,94 Milliarden US-Dollar im Jahr 2026, steigend auf 445,25 Milliarden US-Dollar bis 2030.

Global machine learning market growth 2025-2034.

Das ist fast ein zweifacher Unterschied für das Jahr 2026. Vor allem zeigt uns dies, dass der “Markt für maschinelles Lernen” eine überraschend elastische Kategorie ist: Verschiedene Analysten beziehen unterschiedliche Kombinationen aus Software, Infrastruktur, Dienstleistungen und Hardware ein.

Auch die Details der Prognosen sind aufschlussreich. Fortune geht davon aus, dass Cloud-Implementierungen im Jahr 2026 53,14 % des ML-Marktes ausmachen werden, wobei Großunternehmen einen Anteil von 55,61 % und IT und Telekommunikation 17,56 % der Endnutzung ausmachen.

Unterdessen Gartner erwartet, dass die Ausgaben für KI-Plattformen für Data Science und maschinelles Lernen im Jahr 2026 26,44 Milliarden US-Dollar erreichen werden, was einem Anstieg von 36,3 % gegenüber 2025 entspricht.

Ich würde mich also nicht zu sehr auf eine einzelne riesige Marktzahl fixieren. Wichtig ist die Richtung: Die Ausgaben steigen, die Cloud hat einen großen Anteil an den Implementierungen, und die Tools rund um ML entwickeln sich zu einem eigenen, bedeutenden Markt.

Schauen wir uns nun die aktuellen Trends im Bereich des maschinellen Lernens selbst an.

Aktuelle Trends im Bereich des maschinellen Lernens

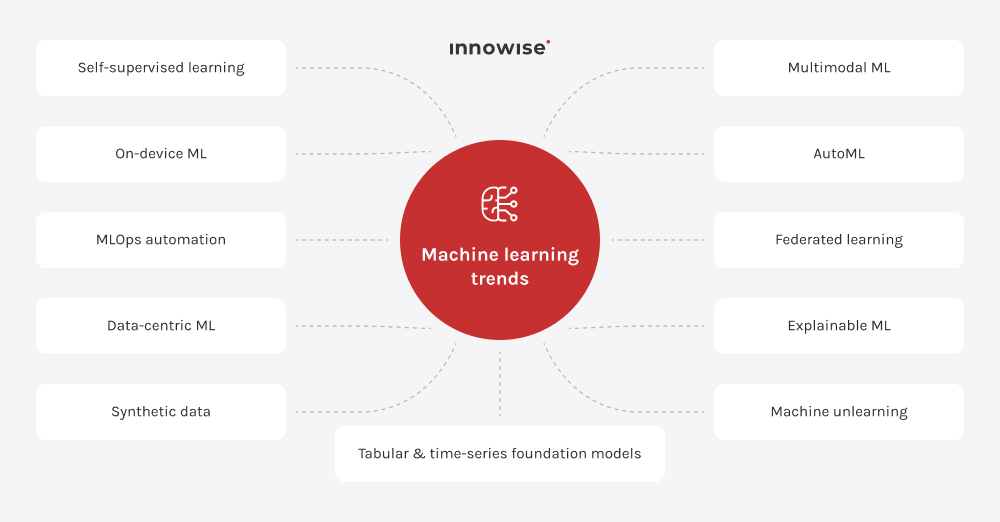
Einige der wichtigsten Trends im Bereich des maschinellen Lernens sind neu. Andere gibt es schon seit Jahren, doch erst jetzt sind sie so ausgereift, dass sie auch außerhalb von Forschungsteams Anwendung finden können. Um ehrlich zu sein, interessiert mich die zweite Gruppe mehr, aber wie dem auch sei – lassen Sie uns gleich loslegen.

Key machine learning trends this year.

Grundlegende Modelle für tabellarische Daten und Zeitreihen

Tabellen erleben gerade ihren "Foundation-Model"-Moment.

Im Juni 2026 stellte Google TabFM vor, ein Modell für die tabellarische Klassifizierung und Regression, das Vorhersagen für neue Datensätze treffen kann, ohne dass die übliche Runde aus aufgabenspezifischem Training und Hyperparameter-Tuning erforderlich ist. Google testete es anhand von 38 Klassifizierungs- und 13 Regressionsdatensätzen, darunter Tabellen mit bis zu 150.000 Beispielen.

Was ist daran besonders interessant? Die Art und Weise, wie es trainiert wurde. Da es kein riesiges öffentliches Repository mit bereinigten Unternehmenstabellen gibt, hat Google stattdessen Hunderte Millionen synthetischer Datensätze generiert.

Ich würde XGBoost noch nicht gleich löschen. Für viele Probleme mit strukturierten Daten sind herkömmliche Modelle immer noch kostengünstiger, einfacher zu debuggen und kaum zu übertreffen. Aber die Vorstellung, einen neuen Datensatz zu öffnen und ohne einen weiteren Feinabstimmungsmarathon eine anständige Baseline zu erhalten, ist ziemlich attraktiv.

Und auch bei Zeitreihen geht der Trend in dieselbe Richtung. Googles TimesFM von Google wurde auf großen Mengen von Zeitreihendaten vortrainiert und kann Zero-Shot-Prognosen für Datensätze erstellen, die es zuvor noch nicht gesehen hat. Der Reiz ist ähnlich wie bei TabFM: weniger aufgabenspezifisches Training, wenn jemand eine neue Nachfrage-, Verkehrs- oder Kapazitätsprognose benötigt.

Würde ich jede bestehende Prognose-Pipeline dadurch ersetzen? Nein. Aber es lohnt sich, es zu testen, wenn die Alternative eine weitere Runde des Modelltrainings und der Feinabstimmung von Grund auf ist.

Beim selbstüberwachten Lernen werden weniger Labels benötigt

Das Anzeichnen von Daten gehört zu den Aufgaben, deren Notwendigkeit zwar allgemein anerkannt ist, für die aber niemand gerne bezahlt.

Das selbstüberwachte Lernen umgeht einen Teil dieses Problems, indem es zunächst nützliche Darstellungen aus unbeschrifteten Daten lernt und diese dann an einen kleineren beschrifteten Datensatz anpasst.

Metas DINOv3 ist ein gutes Beispiel dafür. Es wurde auf 1,7 Milliarden Bildern ohne manuelle Beschriftung trainiert, wobei das größte Modell 7 Milliarden Parameter erreichte. Dasselbe „eingefrorene“ visuelle Backbone kann dann Aufgaben wie Klassifizierung, Objekterkennung, Segmentierung und Verfolgung unterstützen.

Für Unternehmen, die über jahrelang gesammelte, unbeschriftete Inspektionsfotos, Satellitenbilder, medizinische Bilddaten oder Videos verfügen, verändert dies die Wirtschaftlichkeit ein wenig. Möglicherweise benötigen Sie immer noch Beschriftungen. Nur vielleicht nicht mehrere Millionen davon.

Kleinere Modelle gewinnen wieder an Attraktivität

Ein schönes Modell, das ein Rechenzentrum benötigt, um eine einfache Frage zu beantworten, hat auf einem Smartphone, einem Sensor, einer Kamera oder einer industriellen Steuerung nur begrenzten Reiz.

Daher rückt die Modellkomprimierung immer mehr in den Fokus: Quantisierung verringert die numerische Genauigkeit, Pruning entfernt weniger nützliche Gewichte und Destillation überträgt Wissen in ein kleineres Modell. TensorFlow’ eigenes Optimierungstoolkit nennt Latenz, Speicherverbrauch, Stromverbrauch und Modellgröße als zentrale Einschränkungen für den Einsatz am Netzwerkrand.

Hier gibt es nichts umsonst. Komprimiert man zu aggressiv, sinkt die Genauigkeit.

Die Aufgabe besteht darin, den Punkt zu finden, an dem es niemand bemerkt – außer der Stromrechnung.

MLOps wird immer weniger eine Option

Das Trainieren des Modells war nie die gesamte Aufgabe. Wir haben nur überraschend viel Zeit damit verbracht, so zu tun, als wäre es das.

Sobald ein ML-System in Betrieb ist, muss jemand wissen, welcher Datensatz es erzeugt hat, mit welcher Code-Version es trainiert wurde, ob sich die Eingabedaten geändert haben, ob die Leistung schwankt, wann ein erneutes Training zulässig ist und wie man eine fehlerhafte Version zurückrollt.

Die Tools spiegeln dies wider. MLflow 3 hat beispielsweise hat seine Architektur zur Modellverwaltung um eine stärkere Nachverfolgbarkeit sowie den Vergleich zwischen Modellversionen und Experimenten erweitert.

Dies ist wahrscheinlich einer der am wenigsten glamourösen Machine-Learning-Trends auf der Liste – und einer derjenigen, die ich am ernstesten nehmen würde.

Synthetische Daten werden auf ihre Realitätsnähe geprüft

Synthetische Daten klingen wunderbar praktisch. Fehlen Beispiele? Dann erstellen Sie doch welche.

Das kann funktionieren. Es kann aber auch dazu führen, dass ein Modell eine künstliche Welt, die es so nicht wirklich gibt, sehr gut versteht.

Eine Apple-Studie aus dem Jahr 2026 untersuchte die Kombination von echten und synthetischen Trainingsdaten und fand etwas Nützlicheres als die Aussage “synthetische Daten helfen”. Ihre Ergebnisse deuten darauf hin, dass es ein optimales Verhältnis geben kann: Fügt man synthetische Daten hinzu, verbessert sich die Leistung bis zu einem bestimmten Punkt, verschlechtert sich dann aber, wenn die Verteilungen der synthetischen und der realen Daten zu weit auseinanderklaffen.

Multimodales maschinelles Lernen hält Einzug in die alltägliche Vorhersage

"Multimodal" muss nicht unbedingt ein Modell bedeuten, das Ihr Foto besprechen und ein Gedicht darüber schreiben kann.

Für prädiktives maschinelles Lernen kann es viel weniger aufregend und dafür umso nützlicher sein: Produktbild + Beschreibung + Preis, medizinischer Scan + Krankengeschichte, Sensorwerte + Wartungsnotizen.

Die aktuellen AutoGluon-Tools können beispielsweise Bild-, Text-, Tabellen- und Dokumentdaten für Aufgaben wie Klassifizierung und Regression kombinieren.

Der ärgerliche Teil kommt später. Was passiert, wenn das Bild fehlt? Oder der Sensor ausfällt? Oder eine Datenquelle zwei Stunden später eintrifft als die anderen?

Das muss Teil der Bewertung sein und darf keine Überraschung sein, die erst nach dem Start entdeckt wird.

AutoML nimmt einem immer wieder die langweiligen Aufgaben ab

Modellauswahl, Hyperparameter-Tuning, Ensemble-Verfahren, Teile der Merkmalsverarbeitung: Vieles davon lässt sich bereits recht gut automatisieren.

Gut.

Ich bin nicht davon überzeugt, dass ein hochbezahlter ML-Ingenieur einen Nachmittag damit verbringen muss, 47 Kombinationen aus Lernrate und Baumtiefe manuell zu testen, nur um sein Engagement für das Handwerk unter Beweis zu stellen.

Was AutoML nicht besonders gut automatisiert, ist die Entscheidung, ob das Ziel sinnvoll ist, ob die Trainingsdaten Informationen aus der Zukunft preisgeben, ob die Bewertungsmetrik die geschäftlichen Kosten widerspiegelt oder ob das Modell überhaupt existieren sollte.

Das sind nach wie vor lästige Probleme, die der Mensch lösen muss.

Föderiertes Lernen ist noch lange kein Synonym für Datenschutz

Federated Learning bietet einen sehr attraktiven Ansatz: Das Training kann über mehrere Geräte oder Organisationen hinweg erfolgen, ohne dass alle Rohdaten in eine zentrale Datenbank übertragen werden müssen.

Nützlich, ja. Von sich aus privat? Nein.

Das NIST hat Angriffe dokumentiert, mit denen Informationen aus den Modellaktualisierungen wiederhergestellt werden können, die während des föderierten Trainings ausgetauscht werden, und empfiehlt zusätzliche Schutzmaßnahmen, anstatt die Dezentralisierung selbst als Datenschutzgarantie zu betrachten.

Und reale Implementierungen sind chaotisch. Verschiedene Geräte verfügen über unterschiedliche Rechenleistung, Teilnehmer verschwinden, die Datenverteilung variiert, Sicherheitsannahmen werden widerlegt. Die NIST-Implementierungsüberprüfung von 2024 macht die Kluft zwischen der sauberen Theorie des föderierten Lernens und den Produktionssystemen ziemlich deutlich.

Ein dort zitierter Experte, Dr. Mat Weldon vom britischen Amt für nationale Statistik, hat es besser ausgedrückt, als ich es könnte:

“Es ist einfacher, eine neue Architektur für föderiertes Lernen zu entwerfen, als sie einem Red-Team-Test zu unterziehen.”

Stimmt.

Erklärbarkeit wird weniger zeremoniell

Jahrelang konnte das Hinzufügen eines SHAP-Diagramms zu einem Dashboard dazu führen, dass sich ein Modell auf befriedigende Weise “erklärbar” anfühlte.

Das ist eine niedrige Messlatte.

Das NIST unterscheidet zwischen Erklärbarkeit – also dem Verständnis, wie ein System zu einem Ergebnis gelangt ist – und Interpretierbarkeit – also der Frage, was dieses Ergebnis in seinem Kontext bedeutet. In seinen Leitlinien wird außerdem empfohlen, Erklärungsmethoden vor der Einführung zu testen, anstatt davon auszugehen, dass die Erklärung korrekt ist, nur weil das Diagramm überzeugend aussieht.

NIST-Forscher veröffentlichten 2026 eine Arbeit über erklärbare Validierung und Merkmalsreduktion veröffentlicht, was interessant ist, da dadurch die Erklärbarkeit näher an das Modelltesten herangeführt wird, anstatt sie als nachträglich hinzugefügte Ebene zu belassen.

Mir gefällt diese Richtung. Eine Erklärung sollte etwas sein, das wir testen, und keine Verzierung für die Modellkarte.

Das „Unlernen“ von Maschinen wird zu einer echten technischen Herausforderung

Angenommen, jemand bittet Sie, seine Daten zu löschen.

Sie löschen den Datensatz aus der Datenbank.

Gut.

Was ist aber mit dem Modell, das bereits darauf trainiert wurde?

Hier kommt Maschinelles Verlernen ins Spiel: das Entfernen des Einflusses bestimmter Trainingsdaten, ohne das gesamte Modell von Grund auf neu zu trainieren. Im Juni 2026 veröffentlichte veröffentlichte Google Research ein Framework, mit dem überprüft werden kann, ob sich ein “entlerntes” Modell tatsächlich eher wie ein frisch neu trainiertes Modell verhält als wie das ursprüngliche.

Und dieser zweite Teil ist entscheidend. Etwas zu vergessen ist das eine. Zu beweisen, dass das Modell es vergessen hat, ist das andere.

Das „Unlearning“ von Maschinen ist noch viel eher Gegenstand aktiver Forschung als routinemäßiger Unternehmensanwendungen, aber ich würde es im Auge behalten. In dem Moment, in dem „Lösche meine Daten“ mehr bedeuten muss als das Löschen einer Zeile, ist dies keine Theorie mehr.

Entwickeln Sie eine ML-Lösung für Ihr Unternehmen

Wie Trends im Bereich des maschinellen Lernens die Arbeitsabläufe branchenübergreifend verändern

Derselbe ML-Trend kann sich in einem realen Arbeitsablauf ganz anders auswirken. Im Einzelhandel kann eine schnellere Inferenz bedeuten, dass Empfehlungen aktualisiert werden, während ein Kunde noch stöbert. In der Fertigung kann dies bedeuten, dass ein Fehler erkannt wird, bevor das Produkt bereits weiter auf dem Fließband befördert wurde.

  • Bildungswesen
  • Einzelhandel und E-Commerce
  • Banking und Finanzwesen
  • Gesundheitswesen
  • Fertigung
  • Logistik und Transport

Bildungswesen

Lernplattformen verfügen bereits über eine Vielzahl von Daten: Antworten, Versuche, Antwortzeiten, übersprungene Aufgaben, Kursfortschritt. Die größere Herausforderung besteht darin, daraus etwas Nützliches zu machen, ohne so zu tun, als würde ein Modell einen Schüler besser verstehen als ein Lehrer.

Maschinelles Lernen war bereits das größtes Technologiesegment auf dem Markt für KI im Bildungswesen im Jahr 2025, wobei Leistungsüberwachung, Personalisierung und intelligentes Tutoring zu den wichtigsten Anwendungsbereichen zählen.

  • Anpassung des Trainingsschwierigkeitsgrades und der Übungsabfolge auf der Grundlage der bisherigen Leistungen, anstatt alle auf denselben Weg zu zwingen.
  • Das Risiko eines Schulabbruchs vorhersagen anhand von Mustern wie sinkender Teilnahme, wiederholten Misserfolgen oder langen Pausen zwischen den Sitzungen.
  • Wissenslücken früher erkennen und den Lehrplan anzupassen, bevor der Schüler völlig unvorbereitet zum nächsten Thema übergeht.
Einzelhandel und E-Commerce

Im Einzelhandel wird ML bereits seit Jahren eingesetzt, doch die interessanten Veränderungen zeigen sich in Bezug auf Geschwindigkeit und Datenvielfalt. Prognosen können häufiger aktualisiert werden, Empfehlungen können über die Kaufhistorie hinausgehen, und die visuelle Suche kann Bilder mit Produktbeschreibungen und Katalogdaten kombinieren.

  • Nachfrage prognostizieren und Nachschub automatisieren unter Berücksichtigung von Verkaufshistorien, saisonalen Schwankungen, Werbeaktionen und aktuelleren betrieblichen Daten.
  • Empfehlungen personalisieren auf der Grundlage des Surf- und Kaufverhaltens statt auf der Grundlage statischer Kundensegmente.
  • Die Produktsuche verbessern durch die Kombination von Text- und Bilddaten, was nützlich ist, wenn der Kunde nicht weiß, wie der Artikel heißt, aber ein Foto davon hat.

Banking und Finanzwesen

Gerade im Bankwesen lassen sich Modellüberwachung, Erklärbarkeit und Drift kaum ignorieren. Betrugsmuster ändern sich, das Kundenverhalten ändert sich, und ein Modell, das vor sechs Monaten noch gut aussah, kann sehr schnell sehr kostspielig werden.

Der globale setzt maschinelles Lernen im Bankwesen Der Markt hatte im Jahr 2025 einen Wert von rund 40 Milliarden Dollar und wird voraussichtlich etwa 150 Milliarden Dollar bis 2034nach Fortune Business Einblicke.

  • Verdächtige Transaktionen erkennen und die Fälle nach Risikograd zu ordnen, damit die Ermittler mit den Fällen beginnen, die am risikoreichsten erscheinen.
  • Erkläre Kreditentscheidungen indem aufgezeigt wurde, welche Faktoren den stärksten Einfluss auf eine Punktzahl hatten.
  • Modellabweichung überwachen da sich Betrugsmethoden, das Ausgabeverhalten und die Kundenprofile ändern.

Gesundheitswesen

Das Gesundheitswesen ist einer jener Bereiche, in denen ein guter Referenzwert bei weitem nicht ausreicht. Modelle können sich je nach Krankenhaus, Patientengruppe, Gerät und klinischem Umfeld unterschiedlich verhalten, weshalb Kalibrierung und Überwachung genauso wichtig sind wie die Rohdaten Vorhersageleistung.

Der weltweite Markt für prädiktive Analysen im Gesundheitswesen wird auf 19,7 Milliarden Dollar im Jahr 2026 von Grand View Research, die davon ausgeht, dass es 49,3 Milliarden Dollar bis 2033.

  • Frühe Anzeichen einer Verschlechterung erkennen, einschließlich des Sepsisrisikos, bevor die Situation klinisch offensichtlich wird.
  • Das Risiko einer erneuten Einweisung vorhersagen und die Nachsorge bei Patienten, bei denen die Wahrscheinlichkeit einer Rückkehr höher ist, vorrangig zu behandeln.
  • Fälle zur Überprüfung einstufen damit sich die Ärzte auf die Bereiche konzentrieren können, in denen das prognostizierte Risiko am höchsten ist.

Fertigung

Die Fertigungsindustrie ist wahrscheinlich das deutlichste Beispiel für maschinelles Lernen auf dem Gerät. Wenn eine Kamera Teile überprüft, die auf einem Förderband vorbeilaufen, macht es oft wenig Sinn, jedes Bild in die Cloud zu senden und auf eine Antwort zu warten.

Der breiter gefasste Markt für KI in der Fertigung wird auf 9,85 Milliarden Dollar im Jahr 2026, wobei maschinelles Lernen und Computer Vision für die vorausschauende Instandhaltung, Inspektion, Qualitätskontrolle und Produktionsplanung eingesetzt werden.

  • Geräteausfälle vorhersagen auf der Grundlage von Schwingungs-, Temperatur- und Druckdaten sowie der Wartungshistorie.
  • Fehler mit Computer Vision erkennen solange sich das Produkt noch auf dem Fließband befindet.
  • Die Produktqualität vorhersagen aus den Fertigungsparametern vor der Endkontrolle.

Logistik und Transport

Die Logistik ist voller Prognoseprobleme, was sie zu einem idealen Anwendungsgebiet für maschinelles Lernen macht: Ankunftszeiten, Verspätungen, Lagerbedarf, Verkehr, Routenänderungen, verpasste Anschlüsse.

Der Der Markt für maschinelles Lernen in der Logistikbranche wird für das Jahr 2026 auf 5,3 Milliarden US-Dollar geschätzt. und wird voraussichtlich 44,5 Milliarden Dollar bis 2035nach Global Market Insights .

Auch hier spielt Unsicherheit eine Rolle. “Ankunftszeit 14:10 Uhr” und “Ankunftszeit 14:10 Uhr, aber wir sind uns wirklich nicht sicher” sind zwei ganz unterschiedliche Informationen für jemanden, der an einer Laderampe wartet.

  • Ankunftszeiten vorhersagen unter Berücksichtigung historischer Verspätungen, der Verkehrslage und der aktuellen Fahrzeugpositionen.
  • Voraussichtliche Lieferverzögerungen früh genug, um die Lager- oder Lieferpläne anzupassen.
  • Reisezeit und Nachfrage prognostizieren zur Unterstützung der Routenplanung und des Flotteneinsatzes.

Bildungswesen

Lernplattformen verfügen bereits über eine Vielzahl von Daten: Antworten, Versuche, Antwortzeiten, übersprungene Aufgaben, Kursfortschritt. Die größere Herausforderung besteht darin, daraus etwas Nützliches zu machen, ohne so zu tun, als würde ein Modell einen Schüler besser verstehen als ein Lehrer.

Maschinelles Lernen war bereits das größtes Technologiesegment auf dem Markt für KI im Bildungswesen im Jahr 2025, wobei Leistungsüberwachung, Personalisierung und intelligentes Tutoring zu den wichtigsten Anwendungsbereichen zählen.

  • Anpassung des Trainingsschwierigkeitsgrades und der Übungsabfolge auf der Grundlage der bisherigen Leistungen, anstatt alle auf denselben Weg zu zwingen.
  • Das Risiko eines Schulabbruchs vorhersagen anhand von Mustern wie sinkender Teilnahme, wiederholten Misserfolgen oder langen Pausen zwischen den Sitzungen.
  • Wissenslücken früher erkennen und den Lehrplan anzupassen, bevor der Schüler völlig unvorbereitet zum nächsten Thema übergeht.

Einzelhandel und E-Commerce

Im Einzelhandel wird ML bereits seit Jahren eingesetzt, doch die interessanten Veränderungen zeigen sich in Bezug auf Geschwindigkeit und Datenvielfalt. Prognosen können häufiger aktualisiert werden, Empfehlungen können über die Kaufhistorie hinausgehen, und die visuelle Suche kann Bilder mit Produktbeschreibungen und Katalogdaten kombinieren.

  • Nachfrage prognostizieren und Nachschub automatisieren unter Berücksichtigung von Verkaufshistorien, saisonalen Schwankungen, Werbeaktionen und aktuelleren betrieblichen Daten.
  • Empfehlungen personalisieren auf der Grundlage des Surf- und Kaufverhaltens statt auf der Grundlage statischer Kundensegmente.
  • Die Produktsuche verbessern durch die Kombination von Text- und Bilddaten, was nützlich ist, wenn der Kunde nicht weiß, wie der Artikel heißt, aber ein Foto davon hat.

Banking und Finanzwesen

Gerade im Bankwesen lassen sich Modellüberwachung, Erklärbarkeit und Drift kaum ignorieren. Betrugsmuster ändern sich, das Kundenverhalten ändert sich, und ein Modell, das vor sechs Monaten noch gut aussah, kann sehr schnell sehr kostspielig werden.

Der globale setzt maschinelles Lernen im Bankwesen Der Markt hatte im Jahr 2025 einen Wert von rund 40 Milliarden Dollar und wird voraussichtlich etwa 150 Milliarden Dollar bis 2034nach Fortune Business Einblicke.

  • Verdächtige Transaktionen erkennen und die Fälle nach Risikograd zu ordnen, damit die Ermittler mit den Fällen beginnen, die am risikoreichsten erscheinen.
  • Erkläre Kreditentscheidungen indem aufgezeigt wurde, welche Faktoren den stärksten Einfluss auf eine Punktzahl hatten.
  • Modellabweichung überwachen da sich Betrugsmethoden, das Ausgabeverhalten und die Kundenprofile ändern.

Gesundheitswesen

Das Gesundheitswesen ist einer jener Bereiche, in denen ein guter Referenzwert bei weitem nicht ausreicht. Modelle können sich je nach Krankenhaus, Patientengruppe, Gerät und klinischem Umfeld unterschiedlich verhalten, weshalb Kalibrierung und Überwachung genauso wichtig sind wie die Rohdaten Vorhersageleistung.

Der weltweite Markt für prädiktive Analysen im Gesundheitswesen wird auf 19,7 Milliarden Dollar im Jahr 2026 von Grand View Research, die davon ausgeht, dass es 49,3 Milliarden Dollar bis 2033.

  • Frühe Anzeichen einer Verschlechterung erkennen, einschließlich des Sepsisrisikos, bevor die Situation klinisch offensichtlich wird.
  • Das Risiko einer erneuten Einweisung vorhersagen und die Nachsorge bei Patienten, bei denen die Wahrscheinlichkeit einer Rückkehr höher ist, vorrangig zu behandeln.
  • Fälle zur Überprüfung einstufen damit sich die Ärzte auf die Bereiche konzentrieren können, in denen das prognostizierte Risiko am höchsten ist.

Fertigung

Die Fertigungsindustrie ist wahrscheinlich das deutlichste Beispiel für maschinelles Lernen auf dem Gerät. Wenn eine Kamera Teile überprüft, die auf einem Förderband vorbeilaufen, macht es oft wenig Sinn, jedes Bild in die Cloud zu senden und auf eine Antwort zu warten.

Der breiter gefasste Markt für KI in der Fertigung wird auf 9,85 Milliarden Dollar im Jahr 2026, wobei maschinelles Lernen und Computer Vision für die vorausschauende Instandhaltung, Inspektion, Qualitätskontrolle und Produktionsplanung eingesetzt werden.

  • Geräteausfälle vorhersagen auf der Grundlage von Schwingungs-, Temperatur- und Druckdaten sowie der Wartungshistorie.
  • Fehler mit Computer Vision erkennen solange sich das Produkt noch auf dem Fließband befindet.
  • Die Produktqualität vorhersagen aus den Fertigungsparametern vor der Endkontrolle.

Logistik und Transport

Die Logistik ist voller Prognoseprobleme, was sie zu einem idealen Anwendungsgebiet für maschinelles Lernen macht: Ankunftszeiten, Verspätungen, Lagerbedarf, Verkehr, Routenänderungen, verpasste Anschlüsse.

Der Der Markt für maschinelles Lernen in der Logistikbranche wird für das Jahr 2026 auf 5,3 Milliarden US-Dollar geschätzt. und wird voraussichtlich 44,5 Milliarden Dollar bis 2035nach Global Market Insights .

Auch hier spielt Unsicherheit eine Rolle. “Ankunftszeit 14:10 Uhr” und “Ankunftszeit 14:10 Uhr, aber wir sind uns wirklich nicht sicher” sind zwei ganz unterschiedliche Informationen für jemanden, der an einer Laderampe wartet.

  • Ankunftszeiten vorhersagen unter Berücksichtigung historischer Verspätungen, der Verkehrslage und der aktuellen Fahrzeugpositionen.
  • Voraussichtliche Lieferverzögerungen früh genug, um die Lager- oder Lieferpläne anzupassen.
  • Reisezeit und Nachfrage prognostizieren zur Unterstützung der Routenplanung und des Flotteneinsatzes.
Das Modell, das im Benchmark-Test am besten abschneidet, ist nicht immer das, das ich in die Produktion übernehmen würde. Berücksichtigt man Latenz, Infrastrukturkosten, Drift und Wartungsaufwand, kann ein etwas weniger genaues Modell leicht die bessere technische Entscheidung sein.
Dmitry Nazarevich, CTO.
Dmitry Nazarevich
Technischer Direktor

Zukünftige Trends im Bereich des maschinellen Lernens

Einige ML-Ideen sind bereits heute nützlich. Andere benötigen noch bessere Benchmarks, kostengünstigere Rechenleistung oder ein paar unangenehme Erfahrungen in der Produktion, bevor ich sie als ausgereift bezeichnen würde.

Das sind die aufkommenden Trends im maschinellen Lernen, die ich weiterhin im Auge behalten würde.

  • Cross-domain generalization and adaptation icon.

    Domänenübergreifende Generalisierung und Anpassung

    Eines der ältesten Probleme im Bereich des maschinellen Lernens ist nach wie vor aktuell: Wenn man ein Modell in einer bestimmten Umgebung trainiert und es dann in eine etwas andere Umgebung überträgt, lässt die Leistung nach.

    Bei der Domänenverallgemeinerung wird versucht, Modelle so zu gestalten, dass sie auch bei Datenverteilungen, die sie zuvor noch nicht gesehen haben, zuverlässig funktionieren. Eine Studie aus dem Jahr 2026 zur Musterklassifizierung in unbekannten Umgebungen beschreibt genau dieses Problem: Änderungen bei Sensoren, Erfassungsbedingungen oder anderen Domänenmerkmalen können bereits ausreichen, um die Leistung eines Modells erheblich zu beeinträchtigen.

    Die praktische Anwendung lässt sich leicht vorstellen: Ein in einem Werk trainiertes Bildverarbeitungsmodell muss in einem anderen Werk mit anderen Kameras funktionieren. Ein medizinisches Modell wird in ein anderes Krankenhaus verlegt. Ein Betrugserkennungsmodell wird auf eine neue Kundengruppe angewendet.

    Ich vermute, dass dies weniger ein Forschungsschwerpunkt als vielmehr eine grundlegende Anforderung für den Einsatz werden wird.

  • Continual learning icon.

    Lebenslanges Lernen

    Die meisten Produktionsmodelle lernen nach wie vor in Etappen: neue Daten sammeln, neu trainieren, validieren, erneut bereitstellen.

    Beim kontinuierlichen Lernen wird ein reibungsloserer Ablauf angestrebt. Das Modell lernt ständig dazu, sobald neue Daten eintreffen, ohne dabei das zuvor Gelernte zu vergessen.

    Dieser letzte Teil ist der Haken.

    Eine systematische Übersicht aus dem Jahr 2026 über 189 begutachtete Fachartikel zum Thema kontinuierliches Lernen identifiziert das katastrophale Vergessen nach wie vor als eines der zentralen Probleme des Fachgebiets: Das Erlernen neuer Inhalte kann die Leistung bei älteren Aufgaben beeinträchtigen.

    Ich würde also geplante Fortbildungen nicht einfach durch kontinuierliches Lernen ersetzen, nur weil der Begriff besser klingt. Doch für die Betrugsaufdeckung, industrielle Systeme, Empfehlungssysteme und andere Umgebungen, die sich ständig verändern, liegt der Reiz auf der Hand.

  • Hybrid ML models icon.

    Hybride ML-Modelle

    Es hat schon etwas Komisches, wenn man jahrelang versucht, neuronale Netze dazu zu bringen, alles aus Daten zu lernen, nur um dann festzustellen, dass bekannte physikalische Gesetze doch noch nützlich sein können.

    Googles NeuralGCM ist ein gutes Beispiel dafür. Es kombiniert maschinelles Lernen mit einem physikalisch basierten Atmosphären-Solver, anstatt einer der beiden Methoden die gesamte Aufgabe zu übertragen. In einer einer in Nature veröffentlichten Studie lieferte das Modell wettbewerbsfähige Wetter- und Klimaprognosen und benötigte dabei drei bis fünf Größenordnungen weniger Rechenressourcen als vergleichbare konventionelle Modelle.

    Dieser Gedanke geht weit über das Wetter hinaus.

    Wenn wir physikalische Einschränkungen, technische Regeln oder andere fachliche Zusammenhänge bereits kennen, kann es sinnvoller sein, diese in das Modell einfließen zu lassen, als ein neuronales Netzwerk zu beauftragen, die Schwerkraft anhand einer Tabellenkalkulation neu zu entdecken.

  • Causal ML icon.

    Kausales maschinelles Lernen

    Die Vorhersage beantwortet Fragen wie:

    Wer wird wahrscheinlich abwandern?

    Unternehmen möchten in der Regel die nächste Frage stellen:

    Wer bleibt, wenn wir ihnen einen Rabatt gewähren?

    Das ist eine Frage nach dem Kausalzusammenhang.

    Kausales maschinelles Lernen (Causal ML) kombiniert maschinelles Lernen mit kausaler Inferenz, um abzuschätzen, was bei verschiedenen Interventionen passieren könnte. Dieses Forschungsgebiet wird bereits in der Medizin genutzt, um individualisierte Behandlungseffekte abzuschätzen, obwohl Forscher nach wie vor davor warnen, dass falsche Annahmen und Störfaktoren zu überzeugenden, aber falschen Schlussfolgerungen führen können.

    Ich halte dies für einen der interessanteren Ansätze in diesem Zusammenhang, da er den Zweck des Modells verändert. Eine Vorhersage beschreibt eine wahrscheinliche Zukunft. Kausales maschinelles Lernen versucht hingegen zu ermitteln, ob eine bestimmte Handlung diese Zukunft verändern wird.

    Ein viel schwierigeres Problem.

    Eine, die viel nützlicher ist.

  • Uncertainty-aware predictions icon.

    Unsicherheitsbewusste Vorhersagen

    Ein Modell, das von einer “92-prozentigen Sicherheit” spricht, vermittelt ein Gefühl der Zuversicht.

    Es könnte auch Unsinn sein.

    Die Unsicherheitskalibrierung zielt darauf ab, das Konfidenzintervall mit der tatsächlichen Vorhersagegenauigkeit in Einklang zu bringen. Eine im Jahr 2026 in Nature Machine Intelligence im Jahr 2026 veröffentlichte Forschungsergebnisse beschreiben die Kalibrierung als unverzichtbar für einen zuverlässigen Einsatz von maschinellem Lernen, gerade weil moderne Modelle ein hohes Maß an Konfidenz aufweisen können, obwohl sie falsch liegen.

    Die Verlagerung des Verbreitungsgebiets verschlimmert diese Situation noch. Eine 2026 in Scientific Reports veröffentlichte Studie ergab, dass Vorhersagemodelle sowohl an Leistungsfähigkeit als auch an Kalibrierung einbüßen können, wenn sie auf heterogene Datensätze aus der Praxis übertragen werden.

    Für Unternehmen ist das nützliche Ergebnis nicht unbedingt ein Modell, das immer eine Antwort liefert. Manchmal ist das bessere Modell dasjenige, das im Grunde genommen sagt: Ich bin mir hier nicht ganz sicher, gib das bitte einem Menschen weiter.

    Davon würde ich gerne viel mehr sehen.

Benötigen Sie Hilfe bei der Auswahl des richtigen ML-Ansatzes?

Nächste Schritte: Wie Unternehmen Trends im Bereich der maschinellen Lerntechnologie umsetzen können

Die schlechteste Art, diese Liste zu nutzen, besteht darin, einen Trend auszuwählen, nur weil er aktuell klingt, und dann nach einem Problem zu suchen, auf das man ihn beziehen kann.

Fangen Sie stattdessen mit dem lästigen geschäftlichen Problem an.

01
Legen Sie fest, was verbessert werden muss

Genauere Prognosen? Weniger falsche Betrugswarnungen? Geringere Kosten für die Schlussfolgerung? Schnellere Überprüfung? Legen Sie zunächst das gewünschte Ergebnis fest und behalten Sie den aktuellen Prozess als Ausgangsbasis bei.

02
Prüfen Sie, ob die Daten dies belegen können

Bevor Sie Modelle vergleichen, sollten Sie sich die Beschriftungen, fehlende Werte, Zugriffsrechte, das Ungleichgewicht zwischen den Klassen, die Abdeckung sowie die Frage ansehen, ob die Produktionsdaten den für das Training verwendeten Daten ähneln werden. An dieser Stelle verlieren viele ML-Projekte sehr schnell an Reiz.

03
Vergleiche das Neue mit dem Langweiligen

Wenn ein vortrainiertes Modell, ein AutoML-System oder eine multimodale Architektur in Betracht gezogen wird, sollte es unter denselben Bedingungen mit einer einfacheren Basisvariante verglichen werden. Gleiche Daten, gleiche Metriken, gleiche Latenzgrenzen, dasselbe Geschäftsziel.

Wenn das komplizierte Modell um 0,3 % besser abschneidet, der Betrieb aber viermal so viel kostet, bräuchte ich einen sehr guten Grund, es beizubehalten.

04
Testen Sie es in einem Umfeld, in dem ein Fehlschlag verkraftbar ist

Verwenden Sie repräsentative Daten und testen Sie die Fälle, die am ehesten zu Problemen führen können: fehlende Eingaben, seltene Klassen, ungewöhnliche Geräte, schwächere Kundensegmente, Spitzenauslastungen. Legen Sie im Voraus fest, unter welchen Umständen Sie das Pilotprojekt abbrechen würden.

05
Dem Modell nach dem Start einen Eigentümer zuweisen

Jemand muss die Drift, die Latenz, die Kosten, die Kalibrierung, die Leistung der Untergruppen sowie die geschäftliche Kennzahl im Auge behalten, die das Modell eigentlich verbessern sollte. Außerdem muss entschieden werden, wann das Modell neu trainiert, auf eine frühere Version zurückgesetzt, ersetzt oder einfach deaktiviert werden soll.

Und ja, manchmal lautet die richtige Schlussfolgerung, dass der neue ML-Trend keine ausreichenden Verbesserungen bringt, um eine Änderung zu rechtfertigen.

Auch das gilt als erfolgreiche Bewertung.

arrow-icon.arrow-icon.
01 Legen Sie fest, was verbessert werden muss

Genauere Prognosen? Weniger falsche Betrugswarnungen? Geringere Kosten für die Schlussfolgerung? Schnellere Überprüfung? Legen Sie zunächst das gewünschte Ergebnis fest und behalten Sie den aktuellen Prozess als Ausgangsbasis bei.

arrow-icon.arrow-icon.
02 Prüfen Sie, ob die Daten dies belegen können

Bevor Sie Modelle vergleichen, sollten Sie sich die Beschriftungen, fehlende Werte, Zugriffsrechte, das Ungleichgewicht zwischen den Klassen, die Abdeckung sowie die Frage ansehen, ob die Produktionsdaten den für das Training verwendeten Daten ähneln werden. An dieser Stelle verlieren viele ML-Projekte sehr schnell an Reiz.

arrow-icon.arrow-icon.
03 Vergleiche das Neue mit dem Langweiligen

Wenn ein vortrainiertes Modell, ein AutoML-System oder eine multimodale Architektur in Betracht gezogen wird, sollte es unter denselben Bedingungen mit einer einfacheren Basisvariante verglichen werden. Gleiche Daten, gleiche Metriken, gleiche Latenzgrenzen, dasselbe Geschäftsziel.

Wenn das komplizierte Modell um 0,3 % besser abschneidet, der Betrieb aber viermal so viel kostet, bräuchte ich einen sehr guten Grund, es beizubehalten.

arrow-icon.arrow-icon.
04 Testen Sie es in einem Umfeld, in dem ein Fehlschlag verkraftbar ist

Verwenden Sie repräsentative Daten und testen Sie die Fälle, die am ehesten zu Problemen führen können: fehlende Eingaben, seltene Klassen, ungewöhnliche Geräte, schwächere Kundensegmente, Spitzenauslastungen. Legen Sie im Voraus fest, unter welchen Umständen Sie das Pilotprojekt abbrechen würden.

arrow-icon.arrow-icon.
05 Dem Modell nach dem Start einen Eigentümer zuweisen

Jemand muss die Drift, die Latenz, die Kosten, die Kalibrierung, die Leistung der Untergruppen sowie die geschäftliche Kennzahl im Auge behalten, die das Modell eigentlich verbessern sollte. Außerdem muss entschieden werden, wann das Modell neu trainiert, auf eine frühere Version zurückgesetzt, ersetzt oder einfach deaktiviert werden soll.

Und ja, manchmal lautet die richtige Schlussfolgerung, dass der neue ML-Trend keine ausreichenden Verbesserungen bringt, um eine Änderung zu rechtfertigen.

Auch das gilt als erfolgreiche Bewertung.

Anwendungen und Trends des maschinellen Lernens in der Praxis: Innowise Fallstudien

Alle Fallstudien
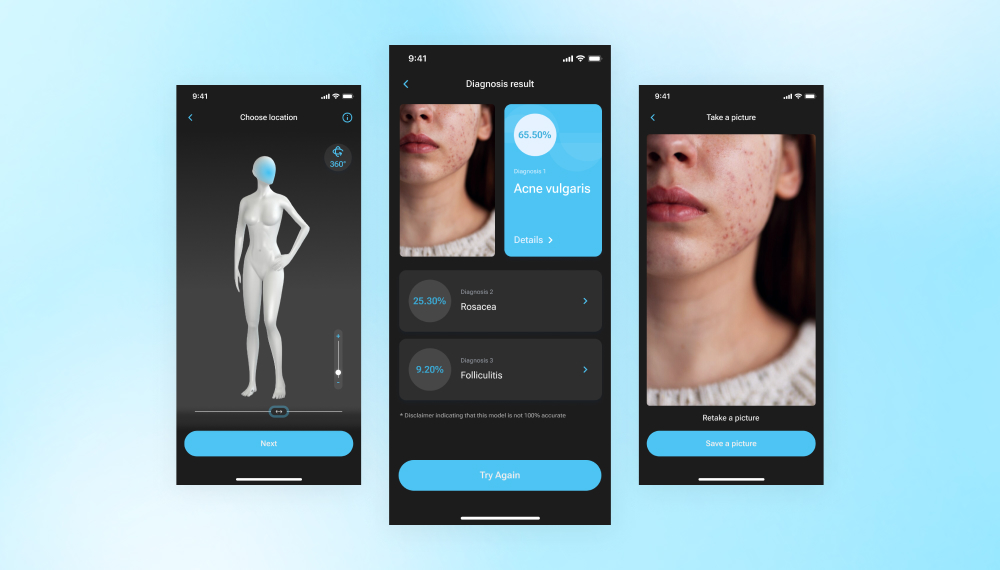
Entwicklung einer App mit KI-gestütztem Hautscanner für Dermatologen
Eine von uns entwickelte KI-App nutzt Deep Learning und Bilderkennung, um Hauterkrankungen schnell zu beurteilen und anhand von Fotos vorläufige Diagnosen zu stellen.
30 unterstützte Hauterkrankungen
Entwicklung eines KI-gestützten Systems zur Fernüberwachung von Patienten
Wir haben im Rahmen der Software zur Fernüberwachung von Patienten eine App zur Wundversorgung entwickelt und eine KI-gestützte Analyse für eine genaue Beurteilung implementiert.
2-stufig Benutzerrollensystem
100% Systemkonformität
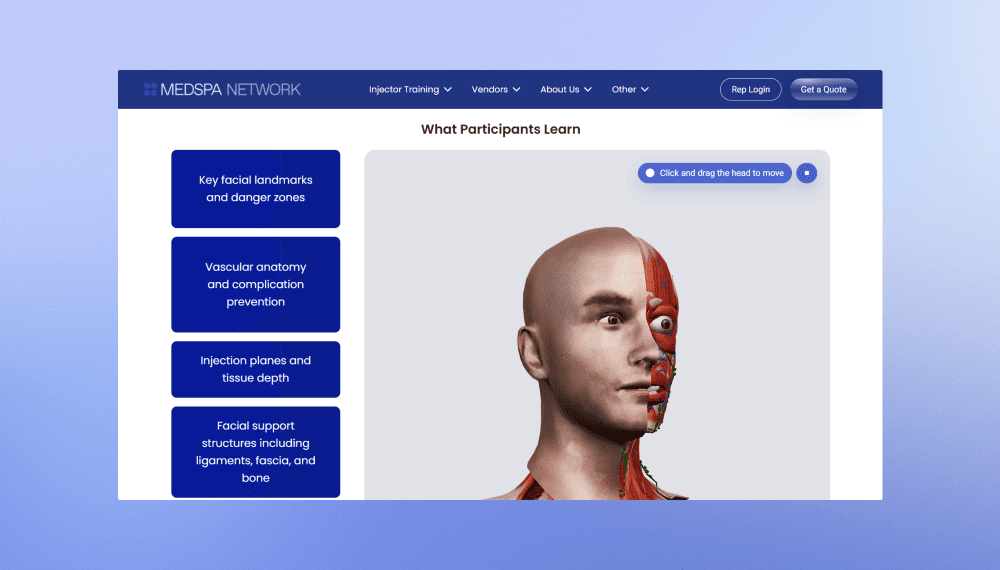
Neugestaltung und Neuaufbau der MedSpa Network-Website
Innowise hat die Website von MedSpa Network auf WordPress neu gestaltet und dem Team damit die Kontrolle über die täglichen Inhaltsaktualisierungen ermöglicht.
2 Monate vom Start bis zur Markteinführung
3-5 Leads pro Woche – ein Anstieg gegenüber 1 pro Monat
Fallstudie anzeigen
Kundenbewertung
Fallstudie anzeigen
Client review logo. Kundenbewertung
MedSpa Network website redesign and rebuild.
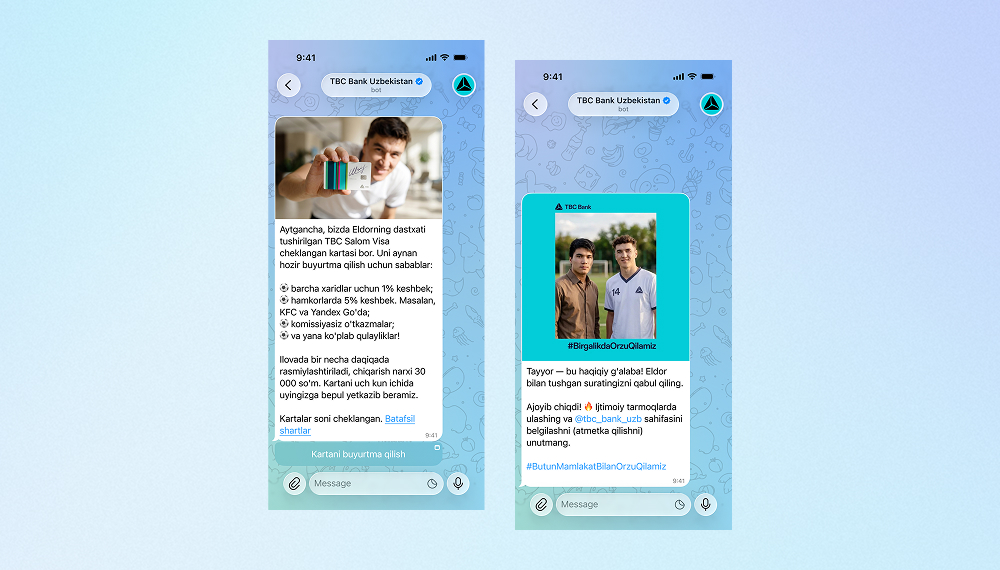
KI-Bot für die Marketingkampagne der TBC Bank
Innowise hat einen zweisprachigen Telegram-Bot entwickelt, der mithilfe von KI Selfies mit dem Fußballstar und Markenbotschafter der TBC Bank generiert.
3,000 aktive Nutzer
2 unterstützte Sprachen
Fallstudie anzeigen
Kundenbewertung
Fallstudie anzeigen
Client review logo. Kundenbewertung
AI Telegram bot..
Festlegung der Produktstrategie für die Bitcoin-Kreditplattform von Bitlendex
Innowise führte für Bitlendex eine Analysephase durch und unterstützte den Kunden dabei, ein Produktkonzept in der Frühphase in ein validiertes Geschäftsmodell und ein klar definiertes MVP umzusetzen.
1 Monat für eine umfassende Analysephase
Finanzberatung-
ssystem für Bonnfinanz
Innowise hat Bonnfinanz dabei unterstützt, ein webbasiertes Beratungs- und Verwaltungssystem aufzubauen, das mobiles Arbeiten und die direkte Interaktion mit dem Kunden ermöglicht.
Ladeplattform für Elektrofahrzeuge mit flexibler Abrechnung
Innowise trug zur Modernisierung der E-Mobilitätsplattform von SMART/LAB bei, indem es deren Funktionen in den Bereichen Abrechnung, Zahlung, Transaktionsmanagement und Berichterstellung verbesserte.
>50% schnellere Rechnungsstellung und Zahlungsabwicklung
Cloud-native DevOps-Transformation von FinXP
Innowise unterstützte FinXP bei der Modernisierung seiner Finanzdienstleistungsinfrastruktur durch die Migration veralteter PHP-basierter APIs und Anwendungen auf eine Cloud-native Architektur.
11 Apps wurden zu Azure App Service migriert
100% Infrastruktur als Code
01 / 01
Close popup icon

Abschließend

Im Jahr 2026 wird ein größerer Teil der Arbeit in wiederverwendbare Modelle, bessere Darstellungen, geringeren Speicherbedarf bei der Inferenz, Überwachung, Kalibrierung und die Klärung der Frage fließen, was passiert, wenn ein Modell auf Daten trifft, die nicht im Trainingsdatensatz enthalten waren.

Das ist wahrscheinlich die wichtige Veränderung, die man im Auge behalten sollte. Ein neuerer Ansatz ist nur dann besser, wenn er zum Problem, zu den Daten, zur Infrastruktur und zur Art und Weise passt, wie das Modell genutzt werden soll. Wenn ein älteres Modell genauso gut funktioniert und einfacher zu betreiben ist, behalte das ältere Modell bei. Wenn ein Basismodell Wochen an Trainingszeit einspart, sollte man es nutzen. Wenn keines der beiden Modelle einen ordnungsgemäßen Pilotversuch übersteht, sollte man weitermachen.

Der Trend an sich ist niemals der Grund.

Wenn Sie prüfen, welche ML-Ansätze für ein reales Produkt oder einen Arbeitsablauf sinnvoll sind, kann Ihnen unser Beratungsteam für maschinelles Lernen bei der Architektur, der Modellauswahl, der Validierung und der Bereitstellung helfen.

FAQ

Maschinelles Lernen (ML) ist ein Teilgebiet der KI, bei dem Modelle Muster aus Daten lernen und diese nutzen, um Vorhersagen zu treffen oder Entscheidungen zu treffen, ohne dass jede Regel manuell festgelegt werden muss.

In der Praxis kann dies bedeuten, die Nachfrage zu prognostizieren, Betrugsfälle aufzudecken, Risiken einzuschätzen, Produkte zu empfehlen, Fehler zu erkennen oder vorherzusagen, wann Anlagen voraussichtlich ausfallen werden.

KI ist der übergeordnete Begriff. Maschinelles Lernen ist eine Methode zum Aufbau von KI-Systemen, bei der aus Daten gelernt wird. Deep Learning ist ein Teilbereich des maschinellen Lernens, der auf neuronalen Netzen mit vielen Schichten basiert.

Die Beziehung ist also recht einfach: Deep Learning ist ein Teilbereich des maschinellen Lernens, und das maschinelle Lernen ist wiederum ein Teilbereich der KI.

Auf jeden Fall.

Gradient Boosting, Random Forests, logistische Regression und andere bewährte Methoden sind nach wie vor eine gute Wahl für viele Probleme im Bereich strukturierter Daten. Sie können schneller, kostengünstiger und leichter zu erklären sein als neuere Deep-Learning-Ansätze.

Ein Modell wird nicht dadurch überholt, dass es ein modischeres gibt.

Meistens sind es die langweiligen Probleme: schlechte Datenqualität, fehlende Bezeichnungen, schwache Infrastruktur, unklare Zuständigkeiten, Datenschutzbeschränkungen, Integrationsprobleme und zu wenige Mitarbeiter, die sowohl das Modell als auch die damit verbundenen Geschäftsprozesse verstehen.

Und noch etwas: Manchmal verbessert das vorgeschlagene ML-System den bestehenden Prozess nicht genug, um den Aufwand zu rechtfertigen.

Das sollte man frühzeitig herausfinden.

AutoML kann Teile der Modellauswahl, der Hyperparameter-Optimierung, der Merkmalsverarbeitung, des Ensemble-Ansatzes und der Experimentierung übernehmen.

Der Mensch muss nach wie vor entscheiden, was das Modell vorhersagen soll, ob die Daten sinnvoll sind, welche Fehler am wichtigsten sind, wie der Erfolg gemessen werden soll und ob das endgültige System sicher und nützlich genug ist, um es einzusetzen.

AutoML kann Experimente durchführen. Es kann jedoch nicht entscheiden, ob die Durchführung des Experiments sinnvoll war.

ML auf dem Gerät ist sinnvoll, wenn die Latenz eine Rolle spielt, die Verbindung unzuverlässig ist, die Bandbreite begrenzt ist oder sensible Daten lokal verbleiben sollen.

Der Kompromiss liegt bei der Hardware. Kleinere Geräte unterliegen strengeren Beschränkungen hinsichtlich Speicher, Rechenleistung und Energieverbrauch, sodass Modelle in der Regel komprimiert oder anderweitig optimiert werden müssen, bevor sie dort reibungslos ausgeführt werden können.

Für die meisten Unternehmen gilt: Nein.

Quanten-Machine-Learning ist nach wie vor weitgehend ein Forschungsthema. Es gibt Experimente zu Optimierung, Quantenkernen und hybriden Quanten-Klassik-Modellen, doch herkömmliches Machine Learning ist für normale Produktionssysteme in 2026.

Wenn heute jemand vorschlägt, für ein routinemäßiges Prognoseproblem quantenbasiertes maschinelles Lernen einzusetzen, würde ich zunächst fragen, was genau das herkömmliche Modell nicht leisten konnte.

Alles anzeigen

Inhaltsübersicht

Setzen Sie ML ein

    Kontakt aufnehmen

    Vereinbaren Sie ein Gespräch oder füllen Sie das Formular aus. Wir kontaktieren Sie, sobald wir Ihre Anfrage bearbeitet haben.

    Sprachnachricht senden
    Datei beifügen
    Datei hochladen

    Sie können 1 Datei mit bis zu 2 MB anhängen. Gültige Dateiformate: pdf, jpg, jpeg, png.

    Indem Sie auf „Senden“ klicken, stimmen Sie zu, dass Innowise Ihre personenbezogenen Daten gemäß unserer Datenschutzerklärung verarbeitet, um Ihnen relevante Informationen bereitzustellen. Mit Angabe Ihrer Telefonnummer stimmen Sie zu, dass wir Sie per Sprachanruf, SMS oder Messaging-Apps kontaktieren. Es können Gebühren für Anrufe, Nachrichten und Datenübertragung anfallen.

    Sie können Ihre Anfrage auch an folgende E-Mail-Adresse
    an contact@innowise.com
    Wie geht es weiter?
    1

    Sobald wir Ihre Anfrage erhalten und geprüft haben, melden wir uns bei Ihnen, klären erste Fragen und unterzeichnen ein NDA, um die Vertraulichkeit zu gewährleisten.

    2

    Nach genauer Prüfung Ihrer Anforderungen, Bedürfnisse und Erwartungen wird unser Team einen Projektvorschlag mit Angaben zu Arbeitsumfang, Teamgröße, Zeitaufwand und Kosten erstellen.

    3

    Wir vereinbaren einen Termin, um das Angebot gemeinsam zu besprechen und alle Details festzulegen.

    4

    Abschließend unterzeichnen wir den Vertrag und starten umgehend mit der Umsetzung Ihres Projekts.

    Weitere von uns abgedeckte Dienstleistungen

    arrow