Tendenze nel campo dell'apprendimento automatico 2026: i cambiamenti tecnologici e il loro impatto sul mondo degli affari

12 novembre 2026 17 minuti di lettura
Responsabile dei dipartimenti Big Data, IA/ML/DS
Esperto verificato
Ogni articolo pubblicato su Innowise è redatto da autori con esperienza sul campo. Questi autori conoscono l'argomento non solo a livello teorico, ma apportano anche approfondimenti tratti da progetti reali.
11+ anni di esperienza
Esperto verificato
11+ anni di esperienza
Philip progetta infrastrutture dati che aiutano a comprendere meglio le informazioni. Si concentra sul significato dei dati e sul loro valore per il business, progettando sistemi in grado di trasformare enormi volumi di dati in informazioni utili, mantenendo una visione tecnica chiara e orientata agli obiettivi.
Competenze specialistiche
Big data IA & ML Python
Parliamo del tuo progetto

Punti chiave

  • Il ML nel 2026 sta diventando sempre più pratico. Gran parte dei progressi riguarda il riutilizzo, l'efficienza, il monitoraggio, la calibrazione e la semplificazione dell'esecuzione dei modelli in produzione.
  • I modelli preaddestrati e auto-supervisionati stanno cambiando la quantità di lavoro che occorre svolgere partendo da zero. I modelli di base tabulari, le rappresentazioni visive riutilizzabili e i dati di addestramento sintetici possono ridurre parte del lavoro abituale di addestramento e etichettatura.
  • I vincoli di implementazione contano più dei risultati ottenuti nei benchmark. La latenza, la memoria, il consumo energetico, la deriva, le prestazioni dei sottogruppi e il costo dell'inferenza possono essere più importanti che guadagnare un'altra frazione di punto percentuale in termini di accuratezza.
  • Queste stesse tendenze stanno trasformando flussi di lavoro molto diversi tra loro. Nel settore della vendita al dettaglio si manifestano nelle previsioni e nei consigli; nel settore bancario, nella gestione delle frodi e del rischio di credito; nel settore sanitario, nella definizione delle priorità dei pazienti; nel settore manifatturiero, nella manutenzione predittiva e nell’individuazione dei difetti; nel settore della logistica, nella stima dei tempi di arrivo e nella previsione dei ritardi.
  • Alcuni ambiti promettenti sono ancora in fase di sviluppo. L’apprendimento continuo, il machine learning causale, i modelli ibridi, l’adattamento tra domini e le previsioni che tengono conto dell’incertezza sembrano tutti utili, ma distinguerei ciò che è stato dimostrato da ciò che è pronto per essere implementato.
Genera un riassunto con l'IA

Il machine learning ormai è noioso. È questa la tendenza.

O, almeno, molti dei progressi interessanti si stanno verificando in ambiti che non fanno notizia: ridurre di 40 millisecondi i tempi di inferenza, addestrare i modelli con meno etichette, riutilizzare un modello invece di crearne uno nuovo, capire perché un sistema con un’accuratezza del 96% continui a commettere errori con lo stesso gruppo di utenti.

E questa è probabilmente una buona notizia. Credo che la maggior parte delle aziende non abbia davvero bisogno di una grande svolta nel ML. Non disdegnerebbero un buon modello che continui a funzionare quando i dati cambiano, che non costi una fortuna da gestire e che dia qualche segnale di allarme quando inizia a comportarsi in modo strano.

Diamo quindi un’occhiata alle ultime tendenze nel machine learning per capire in che direzione si sta muovendo questo settore.

Metti in pratica l'apprendimento automatico

Panoramica e previsioni sul mercato dell'apprendimento automatico

Il mercato del machine learning sta crescendo rapidamente. Tuttavia, non c'è ancora un consenso unanime sulle sue dimensioni.

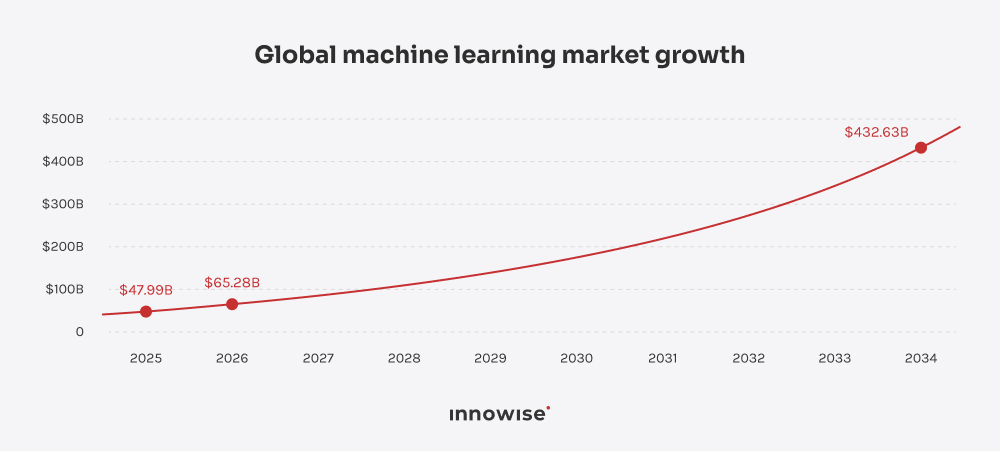
Fortune Business Insights stima che il mercato globale del machine learning raggiungerà 65,28 miliardi di dollari nel 2026 e prevede che arriverà a 432,63 miliardi di dollari entro il 2034. The Business Research Company fornisce una stima molto più elevata per lo stesso anno: 127,94 miliardi di dollari nel 2026, con un aumento fino a 445,25 miliardi di dollari entro il 2030.

Global machine learning market growth 2025-2034.

Si tratta di una differenza quasi doppia per il 2026. Ciò ci indica soprattutto che il “mercato del machine learning” è una categoria sorprendentemente elastica: analisti diversi includono combinazioni diverse di software, infrastrutture, servizi e hardware.

Anche i dettagli contenuti nelle previsioni sono utili. Fortune prevede che l’implementazione nel cloud rappresenterà il 53,14% del mercato del machine learning nel 2026, con le grandi imprese al 55,61% e IT e telecomunicazioni al 17,56% dell’utilizzo finale.

Nel frattempo, Gartner prevede che la spesa per le piattaforme di IA per la scienza dei dati e l’apprendimento automatico raggiunga i 26,44 miliardi di dollari nel 2026, con un aumento del 36,3% rispetto al 2025.

Quindi non mi fisserei troppo su un unico dato di mercato così imponente. La parte utile è la direzione: la spesa è in aumento, il cloud occupa una quota consistente delle implementazioni e gli strumenti legati al machine learning stanno diventando un mercato a sé stante di notevoli dimensioni.

Ora, diamo un’occhiata alle recenti tendenze relative al machine learning stesso.

Tendenze attuali nel campo dell'apprendimento automatico

Alcune delle principali tendenze nel campo dell’apprendimento automatico sono recenti. Altre esistono già da anni e solo ora stanno diventando abbastanza praticabili da uscire dai confini dei gruppi di ricerca. A dire il vero, mi interessa di più il secondo gruppo, ma comunque, entriamo nel vivo dell’argomento.

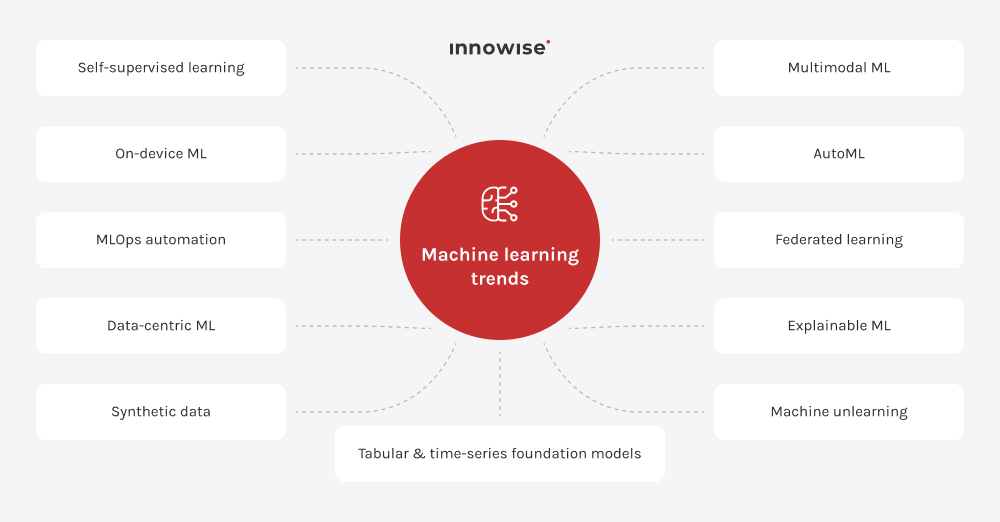
Key machine learning trends this year.

Modelli di base per dati tabulari e serie temporali

Le tabelle stanno vivendo il loro momento di gloria grazie al Foundation Model.

Nel giugno 2026, Google ha introdotto TabFM, un modello per la classificazione e la regressione tabulare in grado di effettuare previsioni su nuovi set di dati senza il consueto ciclo di addestramento specifico per il compito e di ottimizzazione degli iperparametri. Google lo ha testato su 38 set di dati di classificazione e 13 di regressione, incluse tabelle con fino a 150.000 campioni.

Cosa c’è di curioso in tutto questo? Il modo in cui è stato addestrato. Non esiste un gigantesco archivio pubblico di tabelle aziendali pulite, quindi Google ha generato centinaia di milioni di set di dati sintetici al posto di questi.

Non eliminerei XGBoost proprio ora. Per molti problemi legati ai dati strutturati, i modelli convenzionali sono ancora più economici, più facili da debuggare e molto difficili da superare. Ma l’idea di aprire un nuovo set di dati e ottenere una baseline decente senza dover affrontare un’altra maratona di ottimizzazione è piuttosto allettante.

E le serie temporali stanno andando nella stessa direzione. Il modello di Google TimesFM di Google è preaddestrato su ampie raccolte di dati di serie temporali ed è in grado di produrre previsioni zero-shot per set di dati che non ha mai visto prima. Il vantaggio è simile a quello di TabFM: meno addestramento specifico per ogni nuova previsione di domanda, traffico o capacità richiesta.

Sostituirei con questo ogni pipeline di previsione esistente? No. Ma vale la pena provarlo quando l’alternativa è un altro ciclo di addestramento e messa a punto del modello partendo da zero.

L'apprendimento auto-supervisionato richiede un numero minore di etichette

L'etichettatura dei dati è uno di quei compiti che tutti riconoscono come essenziali, ma per cui nessuno è disposto a pagare.

L’apprendimento auto-supervisionato aggira in parte questo problema imparando prima rappresentazioni utili da dati non etichettati, per poi adattarle a un set di dati etichettato più piccolo.

Il DINOv3 di Meta ne è un buon esempio. È stato addestrato su 1,7 miliardi di immagini senza etichette umane, con il modello più grande che raggiunge 7 miliardi di parametri. Lo stesso backbone visivo congelato può quindi supportare attività quali la classificazione, il rilevamento di oggetti, la segmentazione e il tracciamento.

Per le aziende che dispongono di anni di foto di ispezione, immagini satellitari, immagini mediche o video non etichettati, ciò cambia leggermente l’aspetto economico. Potrebbero comunque servire delle etichette. Solo che forse non ne serviranno diversi milioni.

I modelli più piccoli stanno tornando ad attirare l'attenzione

Un modello così bello che ha bisogno di un data center per rispondere a una semplice domanda ha un fascino limitato su un telefono, un sensore, una fotocamera o un controller industriale.

Pertanto, la compressione dei modelli sta ricevendo sempre più attenzione: la quantizzazione riduce la precisione numerica, il pruning rimuove i pesi meno utili e la distillazione trasferisce la conoscenza in un modello più piccolo. Il kit di strumenti di ottimizzazione di TensorFlowelenca la latenza, l’utilizzo della memoria, il consumo energetico e le dimensioni del modello come vincoli fondamentali per l’implementazione edge.

Non ci sono soluzioni miracolose. Una compressione troppo aggressiva comporta un calo di precisione.

Il compito è trovare il punto di equilibrio in cui nessuno se ne accorga, tranne la bolletta dell’infrastruttura.

I dati sintetici vengono messi alla prova

I dati sintetici sembrano davvero molto pratici. Mancano degli esempi? Creane alcuni.

Potrebbe funzionare. Ma potrebbe anche rendere un modello molto bravo a comprendere un mondo artificiale che in realtà non esiste.

Un documento di ricerca Apple del 2026 ha esaminato la combinazione di dati di addestramento reali e sintetici e ha scoperto qualcosa di più utile del semplice “i dati sintetici aiutano”. I loro risultati suggeriscono che possa esistere un rapporto ottimale: aggiungendo dati sintetici, le prestazioni migliorano fino a un certo punto, per poi iniziare a peggiorare man mano che le distribuzioni dei dati sintetici e reali si allontanano troppo l’una dall’altra.

L'apprendimento automatico multimodale si applica alle previsioni di routine

Il termine "multimodale" non deve necessariamente riferirsi a un modello in grado di commentare una foto e scrivere una poesia al riguardo.

Per il machine learning predittivo, può essere molto meno entusiasmante e molto più utile: immagine del prodotto + descrizione + prezzo, scansione medica + anamnesi del paziente, letture dei sensori + note di manutenzione.

Gli attuali strumenti di AutoGluon, ad esempio, possono combinare dati di immagini, testo, tabelle e documenti per attività quali la classificazione e la regressione.

La parte fastidiosa arriva dopo. Cosa succede quando manca l’immagine? O il sensore smette di funzionare? O una fonte di dati arriva con due ore di ritardo rispetto alle altre?

Questo deve far parte della valutazione, non essere una sorpresa scoperta dopo il lancio.

AutoML continua a eliminare le parti noiose

Selezione dei modelli, ottimizzazione degli iperparametri, tecniche di ensemble, alcune fasi dell’elaborazione delle caratteristiche: gran parte di queste operazioni può già essere automatizzata in modo ragionevolmente efficace.

Bene.

Non sono convinto che un ingegnere di ML altamente retribuito debba passare un pomeriggio a testare manualmente 47 combinazioni di tasso di apprendimento e profondità dell’albero solo per dimostrare la propria dedizione al mestiere.

Ciò che l’AutoML non automatizza molto bene è decidere se l’obiettivo abbia senso, se i dati di addestramento rivelino informazioni sul futuro, se la metrica di valutazione rifletta i costi aziendali o se il modello debba esistere tout court.

Questi rimangono, purtroppo, problemi di competenza umana.

L’apprendimento federato non è ancora sinonimo di privacy

L'apprendimento federato presenta una configurazione molto interessante: consente di addestrare i modelli su più dispositivi o organizzazioni senza trasferire tutti i dati grezzi in un unico database centrale.

Utile, sì. Automaticamente privato, no.

Il NIST ha documentato attacchi in grado di recuperare informazioni dagli aggiornamenti del modello scambiati durante l’addestramento federato, e raccomanda misure di protezione aggiuntive piuttosto che considerare il decentramento di per sé come una garanzia di privacy.

E le implementazioni reali sono complesse. Dispositivi diversi hanno capacità di calcolo diverse, i partecipanti scompaiono, le distribuzioni dei dati differiscono, le ipotesi di sicurezza vengono meno. La revisione dell’implementazione del 2024 del NIST mette in luce piuttosto chiaramente il divario tra la teoria ordinata dell’apprendimento federato e i sistemi di produzione.

Un esperto citato in tale documento, il dott. Mat Weldon dell’Ufficio Nazionale di Statistica del Regno Unito, l’ha spiegato meglio di quanto possa fare io:

“È più facile progettare una nuova architettura di apprendimento federato che testarla con un red team.”

Giusto.

La spiegabilità diventa meno formale

Per anni, l’aggiunta di un grafico SHAP a una dashboard poteva far sembrare un modello soddisfacentemente “spiegabile”.

Si tratta di un obiettivo piuttosto modesto.

Il NIST distingue tra spiegabilità, ovvero la comprensione di come un sistema abbia prodotto un risultato, e interpretabilità, ovvero il significato di quel risultato nel suo contesto. Le sue linee guida raccomandano inoltre di testare i metodi di spiegazione prima dell’implementazione, piuttosto che dare per scontato che la spiegazione sia corretta solo perché il grafico sembra convincente.

I ricercatori del NIST hanno pubblicato nel 2026 sulla validazione spiegabile e sulla riduzione delle caratteristiche, il che è interessante perché avvicina la spiegabilità al test del modello, anziché lasciarla come un livello aggiunto in un secondo momento.

Mi piace questa direzione. Una spiegazione dovrebbe essere qualcosa che testiamo, non una decorazione per la scheda del modello.

Il "disimparare" delle macchine diventa una vera e propria sfida ingegneristica

Supponiamo che qualcuno ti chieda di cancellare i propri dati.

Tu elimini il record dal database.

Va bene.

E il modello che è già stato addestrato su quei dati?

È qui che entra in gioco il "machine unlearning": rimuovere l’influenza di particolari dati di addestramento senza dover riaddestrare l’intero modello da zero. Nel giugno 2026, Google Research ha pubblicato un framework per verificare se un modello sottoposto a "unlearning" si comporti davvero più come un modello appena addestrato che come quello originale.

E questa seconda parte è fondamentale. Dimenticare qualcosa è un problema. Dimostrare che il modello l’ha dimenticato è un altro.

Il disapprendimento automatico è ancora molto più vicino alla ricerca attiva che agli strumenti aziendali di routine, ma lo terrei d’occhio. Nel momento in cui «cancella i miei dati» dovrà significare qualcosa di più che cancellare una riga, questo smetterà di essere teorico.

Crea una soluzione di machine learning per la tua azienda

In che modo le tendenze nel campo del machine learning stanno trasformando i flussi di lavoro in tutti i settori

Lo stesso trend nel campo del machine learning può comportarsi in modo molto diverso una volta integrato in un flusso di lavoro reale. Nel settore della vendita al dettaglio, un’inferenza più rapida può significare l’aggiornamento dei consigli mentre il cliente sta ancora navigando sul sito. Nel settore manifatturiero, può significare individuare un difetto prima che il prodotto abbia già proseguito lungo la linea di produzione.

  • Istruzione
  • Commercio al dettaglio e e-commerce
  • Banche e finanza
  • Sanità
  • Industria manifatturiera
  • Logistica e trasporti

Istruzione

Le piattaforme didattiche dispongono già di una grande quantità di dati: risposte, tentativi, tempi di risposta, esercizi saltati, progressi nel corso. La parte più difficile è trasformare tutto ciò in qualcosa di utile senza fingere che un modello comprenda uno studente meglio di quanto non faccia un insegnante.

L'apprendimento automatico era già il il segmento tecnologico più importante nel mercato dell'intelligenza artificiale nel settore dell'istruzione nel 2025, con il monitoraggio delle prestazioni, la personalizzazione e il tutoraggio intelligente tra le principali applicazioni.

  • Adattare il livello di difficoltà e la sequenza degli esercizi basandosi sui risultati ottenuti in precedenza, anziché costringere tutti a seguire lo stesso percorso.
  • Prevedere il rischio di abbandono scolastico da fenomeni quali il calo della partecipazione, i ripetuti insuccessi o i lunghi intervalli tra una sessione e l’altra.
  • Individuare tempestivamente le lacune nelle conoscenze e rivedere il programma prima che lo studente passi all'argomento successivo senza essere affatto preparato.
Commercio al dettaglio e e-commerce

Il settore della vendita al dettaglio utilizza il machine learning ormai da anni, ma i cambiamenti più interessanti riguardano la velocità e la varietà dei dati. Le previsioni possono essere aggiornate con maggiore frequenza, i consigli possono basarsi su dati che vanno oltre la cronologia degli acquisti e la ricerca visiva può combinare immagini, descrizioni dei prodotti e dati di catalogo.

  • Prevedere la domanda e automatizzare il rifornimento utilizzando i dati storici sulle vendite, la stagionalità, le promozioni e dati operativi più recenti.
  • Personalizza i suggerimenti basandosi sul comportamento di navigazione e di acquisto piuttosto che su segmenti di clientela statici.
  • Migliorare la ricerca dei prodotti combinando dati testuali e immagini, il che risulta utile quando il cliente non conosce il nome dell'articolo ma ne possiede una foto.

Banche e finanza

Nel settore bancario, il monitoraggio dei modelli, la spiegabilità e la deriva diventano aspetti difficili da ignorare. I modelli di frode cambiano, il comportamento dei clienti cambia e un modello che sembrava valido sei mesi fa può diventare molto costoso in pochissimo tempo.

Il mercato globale della L'apprendimento automatico nel settore bancario nel 2025 il mercato aveva un valore di circa 40 miliardi di dollari e si prevede che raggiunga circa 150 miliardi di dollari entro il 2034, secondo Approfondimenti aziendali Fortune.

  • Individuare le transazioni sospette e classificare i casi in modo che gli investigatori inizino da quelli che sembrano più rischiosi.
  • Spiega decisioni di credito mostrando quali fattori avessero l'influenza maggiore sul punteggio.
  • Monitorare la deriva del modello man mano che cambiano le tecniche di frode, i comportamenti di spesa e i profili dei clienti.

Sanità

Il settore sanitario è uno di quei campi in cui un buon valore di riferimento non è affatto sufficiente. I modelli possono comportarsi in modo diverso a seconda degli ospedali, dei gruppi di pazienti, dei dispositivi e dei contesti clinici; pertanto, la calibrazione e il monitoraggio sono importanti tanto quanto i dati grezzi prestazioni predittive.

Il mercato globale dell'analisi predittiva nel settore sanitario è stimato a 19,7 miliardi di dollari nel 2026 di Ricerca Grand View, che prevede che raggiunga 49,3 miliardi di dollari entro il 2033.

  • Individuare i primi segni di deterioramento, compreso il rischio di sepsi, prima che la situazione diventi clinicamente evidente.
  • Prevedere il rischio di riammissione e dare priorità al follow-up dei pazienti che hanno maggiori probabilità di tornare.
  • Classificare i casi da esaminare in modo che i medici possano concentrare la propria attenzione sui casi in cui il rischio previsto è più elevato.

Industria manifatturiera

Il settore manifatturiero è probabilmente l'esempio più evidente per l'apprendimento automatico (ML) sul dispositivo. Se una telecamera controlla i componenti che si muovono lungo una linea di produzione, spesso non ha molto senso inviare ogni immagine al cloud e attendere una risposta.

Il mercato più ampio dell'intelligenza artificiale nel settore manifatturiero è stimato a 9,85 miliardi di dollari nel 2026, con l'impiego dell'apprendimento automatico e della visione artificiale per la manutenzione predittiva, l'ispezione, il controllo qualità e la pianificazione della produzione.

  • Prevedere i guasti delle apparecchiature in base alle vibrazioni, alla temperatura, alla pressione e alla cronologia degli interventi di manutenzione.
  • Individuare i difetti tramite la visione artificiale mentre il prodotto si trova ancora sulla linea di produzione.
  • Prevedere la qualità del prodotto dai parametri di produzione prima del controllo finale.

Logistica e trasporti

Il settore della logistica è pieno di problemi di previsione, il che lo rende un terreno di prova naturale per l'apprendimento automatico: tempi di arrivo, ritardi, domanda nei magazzini, traffico, modifiche ai percorsi, collegamenti persi.

Il Il mercato dell'apprendimento automatico nel settore della logistica è stimato a 5,3 miliardi di dollari nel 2026 e si prevede che raggiunga 44,5 miliardi di dollari entro il 2035, secondo Approfondimenti sul mercato globale.

Anche in questo caso l’incertezza ha la sua importanza. “Arrivo previsto alle 14:10” e “Arrivo previsto alle 14:10, ma non ne siamo proprio sicuri” sono due informazioni molto diverse per chi sta aspettando alla banchina di carico.

  • Prevedere gli orari di arrivo utilizzando i dati storici sui ritardi, le condizioni del traffico e le posizioni in tempo reale dei veicoli.
  • Previsti ritardi nelle spedizioni con sufficiente anticipo per adeguare i piani relativi al magazzino o alle consegne.
  • Prevedere i tempi di percorrenza e la domanda per facilitare la pianificazione dei percorsi e l'assegnazione della flotta.

Istruzione

Le piattaforme didattiche dispongono già di una grande quantità di dati: risposte, tentativi, tempi di risposta, esercizi saltati, progressi nel corso. La parte più difficile è trasformare tutto ciò in qualcosa di utile senza fingere che un modello comprenda uno studente meglio di quanto non faccia un insegnante.

L'apprendimento automatico era già il il segmento tecnologico più importante nel mercato dell'intelligenza artificiale nel settore dell'istruzione nel 2025, con il monitoraggio delle prestazioni, la personalizzazione e il tutoraggio intelligente tra le principali applicazioni.

  • Adattare il livello di difficoltà e la sequenza degli esercizi basandosi sui risultati ottenuti in precedenza, anziché costringere tutti a seguire lo stesso percorso.
  • Prevedere il rischio di abbandono scolastico da fenomeni quali il calo della partecipazione, i ripetuti insuccessi o i lunghi intervalli tra una sessione e l’altra.
  • Individuare tempestivamente le lacune nelle conoscenze e rivedere il programma prima che lo studente passi all'argomento successivo senza essere affatto preparato.

Commercio al dettaglio e e-commerce

Il settore della vendita al dettaglio utilizza il machine learning ormai da anni, ma i cambiamenti più interessanti riguardano la velocità e la varietà dei dati. Le previsioni possono essere aggiornate con maggiore frequenza, i consigli possono basarsi su dati che vanno oltre la cronologia degli acquisti e la ricerca visiva può combinare immagini, descrizioni dei prodotti e dati di catalogo.

  • Prevedere la domanda e automatizzare il rifornimento utilizzando i dati storici sulle vendite, la stagionalità, le promozioni e dati operativi più recenti.
  • Personalizza i suggerimenti basandosi sul comportamento di navigazione e di acquisto piuttosto che su segmenti di clientela statici.
  • Migliorare la ricerca dei prodotti combinando dati testuali e immagini, il che risulta utile quando il cliente non conosce il nome dell'articolo ma ne possiede una foto.

Banche e finanza

Nel settore bancario, il monitoraggio dei modelli, la spiegabilità e la deriva diventano aspetti difficili da ignorare. I modelli di frode cambiano, il comportamento dei clienti cambia e un modello che sembrava valido sei mesi fa può diventare molto costoso in pochissimo tempo.

Il mercato globale della L'apprendimento automatico nel settore bancario nel 2025 il mercato aveva un valore di circa 40 miliardi di dollari e si prevede che raggiunga circa 150 miliardi di dollari entro il 2034, secondo Approfondimenti aziendali Fortune.

  • Individuare le transazioni sospette e classificare i casi in modo che gli investigatori inizino da quelli che sembrano più rischiosi.
  • Spiega decisioni di credito mostrando quali fattori avessero l'influenza maggiore sul punteggio.
  • Monitorare la deriva del modello man mano che cambiano le tecniche di frode, i comportamenti di spesa e i profili dei clienti.

Sanità

Il settore sanitario è uno di quei campi in cui un buon valore di riferimento non è affatto sufficiente. I modelli possono comportarsi in modo diverso a seconda degli ospedali, dei gruppi di pazienti, dei dispositivi e dei contesti clinici; pertanto, la calibrazione e il monitoraggio sono importanti tanto quanto i dati grezzi prestazioni predittive.

Il mercato globale dell'analisi predittiva nel settore sanitario è stimato a 19,7 miliardi di dollari nel 2026 di Ricerca Grand View, che prevede che raggiunga 49,3 miliardi di dollari entro il 2033.

  • Individuare i primi segni di deterioramento, compreso il rischio di sepsi, prima che la situazione diventi clinicamente evidente.
  • Prevedere il rischio di riammissione e dare priorità al follow-up dei pazienti che hanno maggiori probabilità di tornare.
  • Classificare i casi da esaminare in modo che i medici possano concentrare la propria attenzione sui casi in cui il rischio previsto è più elevato.

Industria manifatturiera

Il settore manifatturiero è probabilmente l'esempio più evidente per l'apprendimento automatico (ML) sul dispositivo. Se una telecamera controlla i componenti che si muovono lungo una linea di produzione, spesso non ha molto senso inviare ogni immagine al cloud e attendere una risposta.

Il mercato più ampio dell'intelligenza artificiale nel settore manifatturiero è stimato a 9,85 miliardi di dollari nel 2026, con l'impiego dell'apprendimento automatico e della visione artificiale per la manutenzione predittiva, l'ispezione, il controllo qualità e la pianificazione della produzione.

  • Prevedere i guasti delle apparecchiature in base alle vibrazioni, alla temperatura, alla pressione e alla cronologia degli interventi di manutenzione.
  • Individuare i difetti tramite la visione artificiale mentre il prodotto si trova ancora sulla linea di produzione.
  • Prevedere la qualità del prodotto dai parametri di produzione prima del controllo finale.

Logistica e trasporti

Il settore della logistica è pieno di problemi di previsione, il che lo rende un terreno di prova naturale per l'apprendimento automatico: tempi di arrivo, ritardi, domanda nei magazzini, traffico, modifiche ai percorsi, collegamenti persi.

Il Il mercato dell'apprendimento automatico nel settore della logistica è stimato a 5,3 miliardi di dollari nel 2026 e si prevede che raggiunga 44,5 miliardi di dollari entro il 2035, secondo Approfondimenti sul mercato globale.

Anche in questo caso l’incertezza ha la sua importanza. “Arrivo previsto alle 14:10” e “Arrivo previsto alle 14:10, ma non ne siamo proprio sicuri” sono due informazioni molto diverse per chi sta aspettando alla banchina di carico.

  • Prevedere gli orari di arrivo utilizzando i dati storici sui ritardi, le condizioni del traffico e le posizioni in tempo reale dei veicoli.
  • Previsti ritardi nelle spedizioni con sufficiente anticipo per adeguare i piani relativi al magazzino o alle consegne.
  • Prevedere i tempi di percorrenza e la domanda per facilitare la pianificazione dei percorsi e l'assegnazione della flotta.
Il modello che risulta vincitore nel benchmark non è sempre quello che sceglierei di implementare in produzione. Se si considerano la latenza, i costi dell’infrastruttura, la deriva e la manutenzione, un modello leggermente meno accurato può facilmente rivelarsi la scelta ingegneristica migliore.
Dmitry Nazarevich, CTO.
Dmitry Nazarevich
Direttore tecnologico

Tendenze future nell'apprendimento automatico

Alcune idee relative al machine learning sono già utili oggi. Altre necessitano ancora di benchmark più accurati, risorse di calcolo più economiche o qualche esperienza spiacevole in ambiente di produzione prima che io possa considerarle pronte.

Queste sono le tendenze emergenti nel machine learning che continuerei a tenere d’occhio.

  • Cross-domain generalization and adaptation icon.

    Generalizzazione e adattamento tra domini

    Uno dei problemi più annosi del machine learning è ancora molto attuale: si addestra un modello in un determinato ambiente, lo si trasferisce in un contesto leggermente diverso e si assiste a un calo delle prestazioni.

    La generalizzazione di dominio mira a garantire che i modelli mantengano la loro validità su distribuzioni di dati che non hanno mai visto prima. Uno studio del 2026 sulla classificazione dei modelli in ambienti non osservati descrive esattamente questo problema: cambiamenti nei sensori, nelle condizioni di acquisizione o in altre caratteristiche del dominio possono essere sufficienti a compromettere gravemente un modello.

    È facile immaginare come ciò avvenga nella pratica. Un modello di visione artificiale addestrato in uno stabilimento deve funzionare in un altro stabilimento dotato di telecamere diverse. Un modello medico viene trasferito in un altro ospedale. Un modello antifrode si trova a gestire una nuova popolazione di clienti.

    Ho il sospetto che questo diventerà meno una specializzazione di ricerca e più un requisito fondamentale per l'implementazione.

  • Continual learning icon.

    Formazione continua

    La maggior parte dei modelli di produzione continua ad apprendere a fasi: raccolta di nuovi dati, riaddestramento, convalida, nuova implementazione.

    L'apprendimento continuo punta a un processo più fluido. Il modello continua ad apprendere man mano che arrivano nuovi dati, senza dimenticare ciò che sapeva in precedenza.

    È proprio quest'ultima parte il problema.

    Una revisione sistematica del 2026 su 189 articoli sottoposti a revisione paritaria sull’apprendimento continuo identifica ancora l’oblio catastrofico come uno dei problemi centrali del settore: imparare qualcosa di nuovo può compromettere le prestazioni in compiti precedenti.

    Quindi non sostituirei la formazione periodica con l’apprendimento continuo solo perché il nome suona meglio. Ma per quanto riguarda l’individuazione delle frodi, i sistemi industriali, i sistemi di raccomandazione e altri contesti in continua evoluzione, il vantaggio è evidente.

  • Hybrid ML models icon.

    Modelli di apprendimento automatico ibridi

    C'è qualcosa di un po' buffo nel passare anni a cercare di far apprendere alle reti neurali ogni cosa dai dati, solo per scoprire che la fisica che conosciamo può ancora tornare utile.

    Il NeuralGCM di Google ne è un ottimo esempio. Questo modello combina l’apprendimento automatico con un risolutore atmosferico basato sulla fisica, anziché affidare l’intero compito a uno solo dei due. In studi pubblicati su Nature, il modello ha prodotto previsioni meteorologiche e climatiche competitive utilizzando da tre a cinque ordini di grandezza in meno di risorse computazionali rispetto a modelli convenzionali comparabili.

    Quell'idea va ben oltre il semplice tempo atmosferico.

    Se conosciamo già i vincoli fisici, le regole ingegneristiche o altre relazioni specifiche del settore, inserirli nel modello può avere più senso che chiedere a una rete neurale di riscoprire la gravità partendo da un foglio di calcolo.

  • Causal ML icon.

    Apprendimento automatico causale

    La previsione risponde a domande quali:

    Chi è più a rischio di abbandono?

    Le aziende di solito vogliono sapere qual è la domanda successiva:

    Chi resterà se offriamo loro uno sconto?

    Si tratta di una domanda di natura causale.

    Il machine learning causale combina l'apprendimento automatico con l'inferenza causale per stimare cosa potrebbe accadere in presenza di diversi interventi. Questo approccio viene già utilizzato in medicina per stimare gli effetti dei trattamenti personalizzati, sebbene i ricercatori avvertano ancora che ipotesi errate e fattori di confondimento possano portare a conclusioni convincenti ma sbagliate.

    Credo che questa sia una delle direzioni più interessanti in questo contesto, perché cambia lo scopo stesso del modello. La previsione descrive un futuro probabile. L'apprendimento automatico causale cerca invece di dirti se compiere una determinata azione lo modificherà.

    Un problema molto più difficile.

    Uno molto più utile.

  • Uncertainty-aware predictions icon.

    Previsioni che tengono conto dell'incertezza

    Un modello che indica una “fiducia del 92%” infonde sicurezza.

    Potrebbe anche essere una sciocchezza.

    La calibrazione dell’incertezza mira ad allineare il livello di confidenza con l’effettiva accuratezza predittiva. Una ricerca pubblicata su Nature Machine Intelligence nel 2026 descrive la calibrazione come essenziale per un'implementazione affidabile del ML proprio perché i modelli moderni possono mostrare un alto livello di confidenza pur essendo errati.

    Il cambiamento nelle modalità di distribuzione aggrava ulteriormente la situazione. Uno studio del 2026 Scientific Reports ha rilevato che i modelli predittivi possono perdere sia in termini di prestazioni che di calibrazione quando vengono applicati a set di dati eterogenei del mondo reale.

    Per le aziende, il risultato utile non è un modello che fornisca sempre una risposta. A volte il modello migliore è quello che dice, in sostanza: Non ne sono molto sicuro, passalo a un essere umano.

    Mi piacerebbe vederne molto di più.

Hai bisogno di aiuto per scegliere l'approccio di ML più adatto?

Prossimi passi: come le aziende possono adottare le tendenze tecnologiche nel campo del machine learning

Il modo peggiore di utilizzare questa lista è scegliere una tendenza solo perché sembra attuale e poi andare alla ricerca di un problema a cui collegarla.

Inizia invece da quel fastidioso problema aziendale.

01
Indicare quali aspetti devono essere migliorati

Previsioni più accurate? Meno falsi allarmi di frode? Costi di inferenza inferiori? Ispezioni più rapide? Scegliete prima il risultato desiderato e utilizzate il processo attuale come punto di riferimento.

02
Verifica se i dati lo confermano

Prima di confrontare i modelli, occorre esaminare le etichette, i valori mancanti, i diritti di accesso, lo squilibrio tra le classi, la copertura e verificare se i dati di produzione saranno simili a quelli utilizzati per l’addestramento. È proprio qui che molti progetti di ML perdono rapidamente il loro fascino.

03
Confronta la novità con la routine

Se si sta valutando l'utilizzo di un modello preaddestrato, di un sistema AutoML o di un'architettura multimodale, è opportuno testarlo confrontandolo con un modello di riferimento più semplice nelle stesse condizioni: stessi dati, stesse metriche, stessi limiti di latenza, stesso obiettivo aziendale.

Se il modello più complesso dovesse dare un vantaggio dello 0,3% ma costasse quattro volte di più da gestire, vorrei una ragione davvero valida per mantenerlo.

04
Provalo in contesti in cui un eventuale fallimento non sia fatale

Utilizzate dati rappresentativi e testate i casi che potrebbero causare maggiori problemi: dati di input mancanti, classi rare, dispositivi insoliti, segmenti di clientela più deboli, picchi di carico. Stabilite in anticipo quali sarebbero i motivi che vi indurrebbero a interrompere il progetto pilota.

05
Assegnare un proprietario al modello dopo il lancio

Qualcuno deve monitorare la deriva, la latenza, i costi, la calibrazione, le prestazioni dei sottogruppi e la metrica aziendale che il modello avrebbe dovuto migliorare. Deve inoltre decidere quando rieducarlo, ripristinare una versione precedente, sostituirlo o semplicemente disattivarlo.

E sì, a volte la conclusione giusta è che la nuova tendenza nel campo del machine learning non apporta miglioramenti sufficienti da giustificare un cambiamento.

Anche questa può essere considerata una valutazione positiva.

arrow-icon.arrow-icon.
01 Indicare quali aspetti devono essere migliorati

Previsioni più accurate? Meno falsi allarmi di frode? Costi di inferenza inferiori? Ispezioni più rapide? Scegliete prima il risultato desiderato e utilizzate il processo attuale come punto di riferimento.

arrow-icon.arrow-icon.
02 Verifica se i dati lo confermano

Prima di confrontare i modelli, occorre esaminare le etichette, i valori mancanti, i diritti di accesso, lo squilibrio tra le classi, la copertura e verificare se i dati di produzione saranno simili a quelli utilizzati per l’addestramento. È proprio qui che molti progetti di ML perdono rapidamente il loro fascino.

arrow-icon.arrow-icon.
03 Confronta la novità con la routine

Se si sta valutando l'utilizzo di un modello preaddestrato, di un sistema AutoML o di un'architettura multimodale, è opportuno testarlo confrontandolo con un modello di riferimento più semplice nelle stesse condizioni: stessi dati, stesse metriche, stessi limiti di latenza, stesso obiettivo aziendale.

Se il modello più complesso dovesse dare un vantaggio dello 0,3% ma costasse quattro volte di più da gestire, vorrei una ragione davvero valida per mantenerlo.

arrow-icon.arrow-icon.
04 Provalo in contesti in cui un eventuale fallimento non sia fatale

Utilizzate dati rappresentativi e testate i casi che potrebbero causare maggiori problemi: dati di input mancanti, classi rare, dispositivi insoliti, segmenti di clientela più deboli, picchi di carico. Stabilite in anticipo quali sarebbero i motivi che vi indurrebbero a interrompere il progetto pilota.

arrow-icon.arrow-icon.
05 Assegnare un proprietario al modello dopo il lancio

Qualcuno deve monitorare la deriva, la latenza, i costi, la calibrazione, le prestazioni dei sottogruppi e la metrica aziendale che il modello avrebbe dovuto migliorare. Deve inoltre decidere quando rieducarlo, ripristinare una versione precedente, sostituirlo o semplicemente disattivarlo.

E sì, a volte la conclusione giusta è che la nuova tendenza nel campo del machine learning non apporta miglioramenti sufficienti da giustificare un cambiamento.

Anche questa può essere considerata una valutazione positiva.

Applicazioni e tendenze del machine learning nella pratica: Innowise casi di studio

Tutti i case study
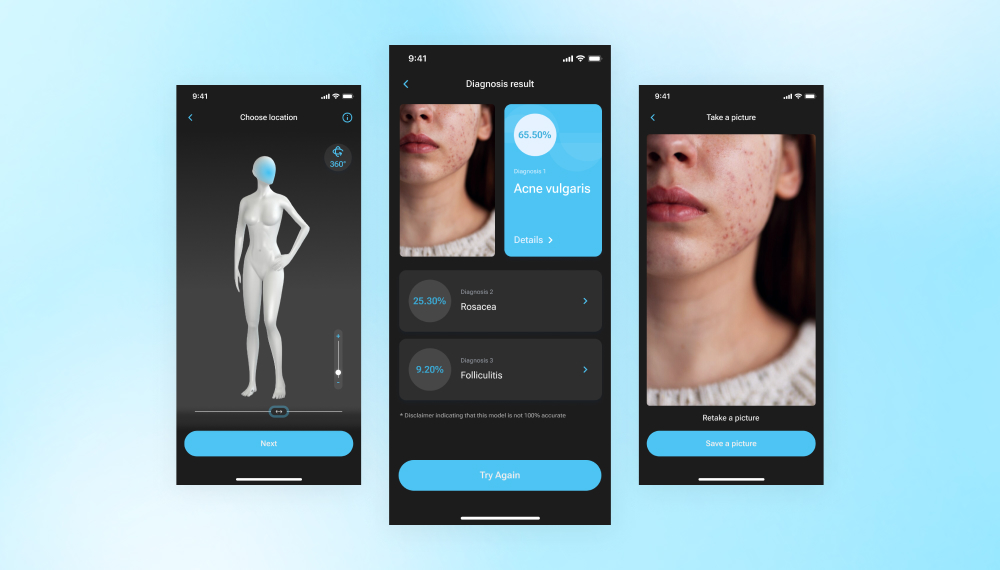
Sviluppo di un'app con scanner cutaneo basato sull'intelligenza artificiale per dermatologi
Un'app basata sull'intelligenza artificiale che abbiamo sviluppato utilizza il deep learning e il riconoscimento delle immagini per valutare rapidamente le condizioni della pelle, fornendo diagnosi preliminari sulla base delle foto.
30 patologie dermatologiche trattate
Realizzazione di un sistema di monitoraggio remoto dei pazienti basato sull'intelligenza artificiale
Abbiamo sviluppato un'app per la cura delle ferite nell'ambito del software di monitoraggio remoto dei pazienti e abbiamo implementato un sistema di analisi basato sull'intelligenza artificiale per garantire una valutazione accurata.
a due livelli sistema dei ruoli utente
100% conformità del sistema
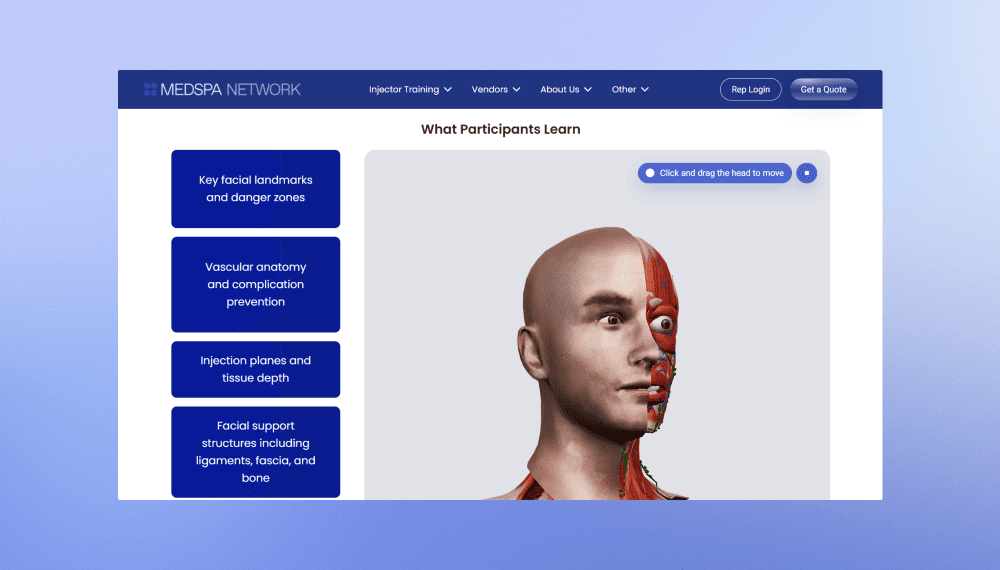
Riprogettazione e ricostruzione del sito web di MedSpa Network
Innowise ha ricostruito il sito web di MedSpa Network con WordPress dando al team la possibilità di gestire in autonomia gli aggiornamenti quotidiani dei contenuti.
2 mesi dall'avvio al lancio
3-5 lead a settimana, rispetto a 1 al mese
Scopri il progetto
Recensione del cliente
Scopri il progetto
Client review logo. Recensione del cliente
MedSpa Network website redesign and rebuild.
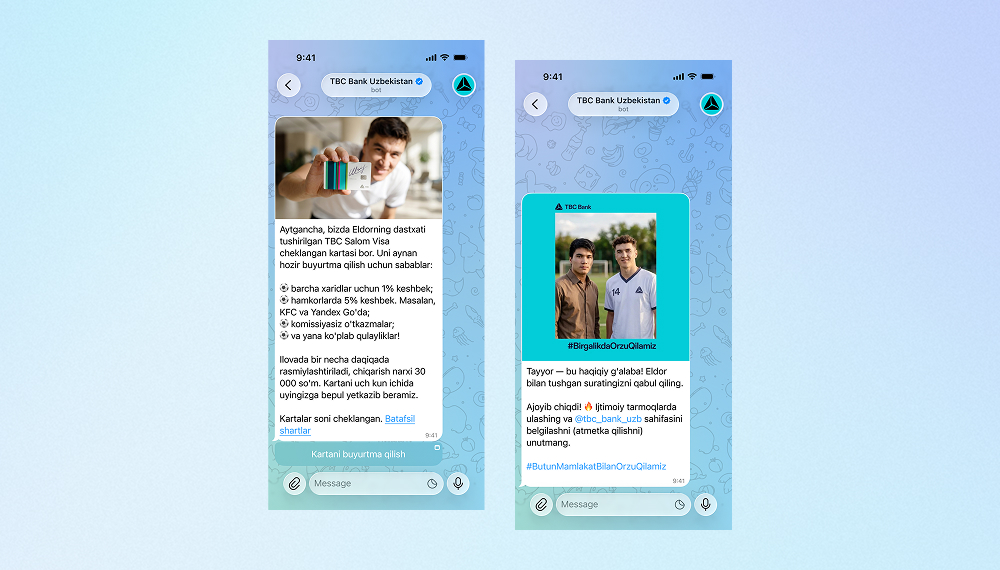
Bot IA per la campagna marketing di TBC Bank
Innowise ha sviluppato un bot Telegram bilingue che genera selfie con il testimonial di TBC Bank, una star del calcio, grazie all'IA.
3,000 utenti coinvolti
2 lingue supportate
Scopri il progetto
Recensione del cliente
Scopri il progetto
Client review logo. Recensione del cliente
AI Telegram bot..
Definizione della strategia di prodotto per la piattaforma di prestiti in bitcoin di Bitlendex
Innowise ha gestito la fase di discovery per Bitlendex aiutando il cliente a trasformare un'idea iniziale in un modello di business validato e in un MVP con requisiti definiti.
1 mese per completare la fase di discovery
Sistema di consulenza finanziaria per Bonnfinanz
Innowise ha aiutato Bonnfinanz a sviluppare un sistema web per la consulenza e la gestione amministrativa, che permette ai consulenti di lavorare da dispositivi mobili e interagire direttamente con i clienti.
Piattaforma di ricarica per veicoli elettrici con fatturazione flessibile
Innowise ha modernizzato la piattaforma di mobilità elettrica di SMART/LAB, migliorando le funzioni di fatturazione, pagamento, gestione delle transazioni e reportistica.
>50% di velocità in più nell'elaborazione di fatture e pagamenti
Trasformazione cloud-native DevOps di FinXP
Innowise ha aiutato FinXP a modernizzare l'infrastruttura per i servizi finanziari migrando API e applicazioni legacy basate su PHP verso un'architettura cloud-native.
11 app migrate ad Azure App Service
100% Infrastructure as Code
01 / 01
Close popup icon

Conclusione

Nel 2026, gran parte del lavoro è dedicato a modelli riutilizzabili, rappresentazioni migliori, impronte di inferenza più ridotte, monitoraggio, calibrazione e alla comprensione di cosa succede quando un modello incontra dati che non erano presenti nel set di addestramento.

Questo è probabilmente il cambiamento utile da tenere a mente. Un approccio più recente è migliore solo se si adatta al problema, ai dati, all’infrastruttura e al modo in cui il modello verrà utilizzato. Se un modello più vecchio offre prestazioni altrettanto buone ed è più facile da eseguire, mantenete il modello più vecchio. Se un modello di base consente di risparmiare settimane di addestramento, utilizzatelo. Se nessuno dei due supera una fase pilota adeguata, passate oltre.

La tendenza in sé non è mai la ragione.

Se state valutando quali approcci di ML abbiano senso per un prodotto o un flusso di lavoro reale, il nostro team di consulenza sul machine learning può aiutarvi con l’architettura, la selezione del modello, la validazione e l’implementazione.

FAQ

L'apprendimento automatico (ML) è una branca dell'intelligenza artificiale in cui i modelli apprendono schemi dai dati e li utilizzano per formulare previsioni o prendere decisioni senza che ogni singola regola debba essere scritta manualmente.

In pratica, ciò può significare prevedere la domanda, individuare le frodi, stimare il rischio, consigliare prodotti, individuare difetti o prevedere quando le apparecchiature potrebbero guastarsi.

L'intelligenza artificiale (IA) è la categoria più ampia. L'apprendimento automatico è un modo per sviluppare sistemi di IA attraverso l'apprendimento dai dati. L'apprendimento profondo è un sottoinsieme dell'apprendimento automatico basato su reti neurali a più livelli.

Quindi il rapporto è piuttosto semplice: il deep learning rientra nel machine learning, e il machine learning rientra nell'intelligenza artificiale.

Assolutamente sì.

Il gradient boosting, le foreste casuali, la regressione logistica e altri metodi consolidati rappresentano ancora ottime scelte per molti problemi relativi ai dati strutturati. Possono risultare più veloci, meno costosi e più facili da spiegare rispetto ai più recenti approcci basati sul deep learning.

Un modello non diventa obsoleto solo perché ne esiste uno più alla moda.

Di solito sono quelli noiosi: scarsa qualità dei dati, etichette mancanti, infrastrutture carenti, titolarità poco chiara, restrizioni sulla privacy, problemi di integrazione e mancanza di personale in grado di comprendere sia il modello che il processo aziendale ad esso correlato.

Ce n'è anche un altro: a volte il sistema di apprendimento automatico proposto non migliora il processo esistente in misura tale da giustificare il lavoro richiesto.

È bene scoprirlo fin da subito.

AutoML è in grado di gestire alcune fasi della selezione dei modelli, dell'ottimizzazione degli iperparametri, dell'elaborazione delle caratteristiche, dell'ensembling e della sperimentazione.

Gli esseri umani devono ancora decidere cosa il modello debba prevedere, se i dati abbiano senso, quali errori siano più rilevanti, come debba essere misurato il successo e se il sistema finale sia sufficientemente sicuro e utile da poter essere implementato.

AutoML è in grado di eseguire esperimenti. Non è però in grado di stabilire se valga la pena eseguire un determinato esperimento.

L'apprendimento automatico sul dispositivo è indicato quando la latenza è un fattore critico, la connettività è inaffidabile, la larghezza di banda è limitata o i dati sensibili devono rimanere in locale.

Il compromesso riguarda l'hardware. I dispositivi più piccoli presentano limiti più restrittivi in termini di memoria, potenza di calcolo ed energia, quindi i modelli richiedono solitamente una compressione o altre ottimizzazioni prima di poter funzionare correttamente su tali dispositivi.

Per la maggior parte delle aziende, no.

L'apprendimento automatico quantistico è ancora in gran parte un argomento di ricerca. Esistono esperimenti incentrati sull'ottimizzazione, sui kernel quantistici e sui modelli ibridi quantistici-classici, ma l'apprendimento automatico convenzionale rimane di gran lunga più pratico per i normali sistemi di produzione in 2026.

Se oggi qualcuno proponesse di utilizzare l'apprendimento automatico quantistico per un problema di previsione di routine, chiederei innanzitutto in cosa esattamente il modello tradizionale abbia fallito.

Mostra tutto

Indice dei contenuti

Metti in pratica l'apprendimento automatico

    Contattaci

    Prenota una chiamata oppure compila il modulo qui sotto. Ti contatteremo non appena avremo elaborato la richiesta.

    Inviaci un messaggio vocale
    Allega i documenti
    Carica file

    È possibile allegare 1 file di dimensioni massime di 2 MB. Formati di file validi: pdf, jpg, jpeg, png.

    Cliccando su «Invia», acconsenti al trattamento dei tuoi dati personali da parte di Innowise, in conformità con la nostra Informativa sulla privacy, per fornirti informazioni pertinenti. Inserendo il tuo numero di telefono, accetti che possiamo contattarti tramite chiamate vocali, SMS e app di messaggistica. Potrebbero essere applicati costi per chiamate, messaggi e traffico dati.

    Puoi anche inviarci la tua richiesta
    a contact@innowise.com
    Cosa succede dopo?
    1

    Una volta ricevuta e presa in carico la richiesta, ti ricontatteremo per approfondire le esigenze del progetto e firmare un accordo di riservatezza.

    2

    Dopo aver chiarito le esigenze, obiettivi e aspettative, il nostro team elabora una proposta che definisce le attività previste, la composizione del team, le tempistiche e i costi stimati.

    3

    Fisseremo un incontro per discutere la proposta e definire tutti i dettagli.

    4

    Infine, firmeremo il contratto e inizieremo subito a lavorare sul tuo progetto.

    Altri servizi che copriamo

    arrow