Tendências na área do aprendizado automático 2026: mudanças tecnológicas e impacto nos negócios

12 de novembro de 2026 17 min leitura
Responsável pelos Departamentos de Big Data, IA/ML/DS
Especialista verificado
Todos os artigos da Innowise são escritos por autores com experiência prática. Estes compreendem o tema para além da teoria e partilham perspetivas baseadas em projetos reais.
Mais de 11 anos de experiência
Especialista verificado
Mais de 11 anos de experiência
Philip cria infraestruturas de dados que proporcionam clareza. Concentra-se no "porquê" por detrás dos dados, arquitetando sistemas que processam volumes maciços e os transformam em informações acionáveis, garantindo simultaneamente que a visão técnica permanece clara e orientada.
Especialização
Big Data IA & ML Python
Contacto

Principais conclusões

  • O ML em 2026 está a tornar-se mais prático. Grande parte dos avanços prende-se com a reutilização, a eficiência, a monitorização, a calibração e com tornar a execução dos modelos em produção menos complicada.
  • Os modelos pré-treinados e auto-supervisionados estão a alterar a quantidade de trabalho que é necessário realizar a partir do zero. Os modelos de base tabulares, as representações visuais reutilizáveis e os dados de treino sintéticos podem reduzir parte do trabalho habitual de treino e rotulagem.
  • As restrições de implementação são mais importantes do que os resultados positivos nos testes de desempenho. A latência, a memória, o consumo de energia, o desvio, o desempenho dos subgrupos e o custo da inferência podem ser mais importantes do que conseguir melhorar a precisão em mais uma fração de um por cento.
  • Estas mesmas tendências estão a transformar fluxos de trabalho muito diferentes. No retalho, isso reflete-se nas previsões e recomendações; na banca, na deteção de fraudes e no risco de crédito; nos cuidados de saúde, na priorização de doentes; na indústria transformadora, na manutenção preditiva e na deteção de defeitos; na logística, nas estimativas de chegada e na previsão de atrasos.
  • Algumas áreas promissoras ainda se encontram numa fase muito inicial de desenvolvimento. A aprendizagem contínua, o ML causal, os modelos híbridos, a adaptação entre domínios e a previsão sensível à incerteza parecem todos úteis, mas eu separaria o que já foi demonstrado do que está pronto para ser implementado.
Resumo por IA

O ML já é aborrecido. É essa a tendência.

Ou, pelo menos, grande parte dos avanços interessantes está a ocorrer em áreas que não dão muito nas manchetes: reduzir o tempo de inferência em 40 milissegundos, treinar com menos rótulos, reutilizar um modelo em vez de construir outro, descobrir por que razão um sistema com 96% de precisão continua a falhar com o mesmo grupo de utilizadores.

E isto é provavelmente uma boa notícia. Acredito que a maioria das empresas não precisa realmente de um grande avanço no ML. Não se importariam de ter um bom modelo que continue a funcionar quando os dados mudam, que não custe uma fortuna a operar e que dê algum aviso quando começa a comportar-se de forma estranha.

Por isso, vamos analisar as últimas tendências no aprendizado automático para ver para onde este trabalho se dirige.

Coloque o ML em prática

Panorâmica e previsões do mercado de aprendizagem automática

O mercado do ML está a crescer rapidamente. Mas ninguém chega a um consenso quanto à sua dimensão.

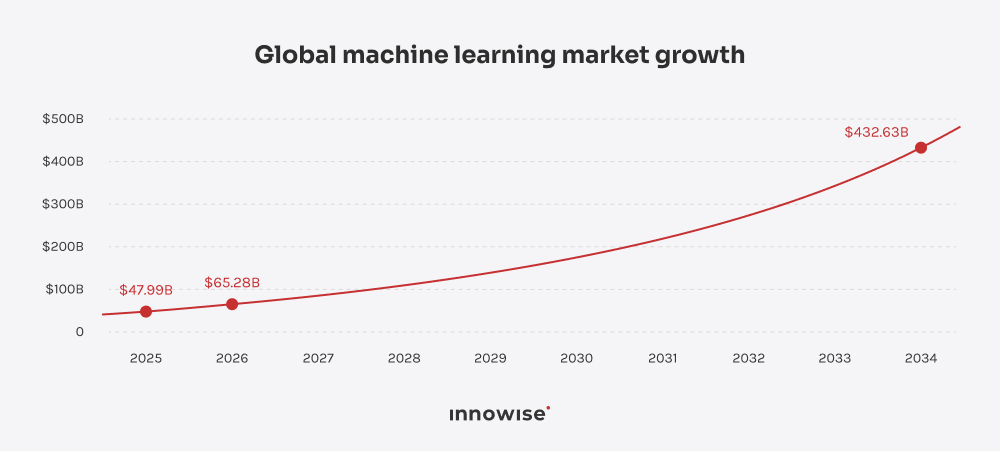
A Fortune Business Insights estima que o mercado global de aprendizagem automática atinja 65,28 mil milhões de dólares em 2026 e prevê que atinja 432,63 mil milhões de dólares até 2034. A Business Research Company apresenta uma estimativa muito superior para o mesmo ano: 127,94 mil milhões de dólares em 2026, aumentando para 445,25 mil milhões de dólares até 2030.

Global machine learning market growth 2025-2034.

Isso representa quase o dobro para 2026. Acima de tudo, isto indica-nos que o “mercado da aprendizagem automática” é uma categoria surpreendentemente elástica: diferentes analistas incluem combinações diferentes de software, infraestrutura, serviços e hardware.

Os detalhes contidos nas previsões também são úteis. A Fortune prevê que a implementação na nuvem represente 53,14% do mercado de ML em 2026, com as grandes empresas a representarem 55,61% e IT e telecomunicações a 17,56% da utilização final.

Entretanto, a Gartner prevê que a despesa em plataformas de IA para ciência de dados e aprendizagem automática atinja 26,44 mil milhões de dólares em 2026, um aumento de 36,3% em relação a 2025.

Por isso, não me fixaria demasiado num único número gigantesco do mercado. O que é útil é a tendência: os gastos estão a aumentar, a nuvem detém uma grande quota da implementação e as ferramentas relacionadas com o ML estão a tornar-se um mercado considerável por si só.

Agora, vamos ver as tendências recentes no próprio aprendizado automático.

Tendências atuais na aprendizagem automática

Algumas das principais tendências em aprendizagem automática são recentes. Outras já existem há anos e só agora estão a tornar-se suficientemente práticas para sair do âmbito das equipas de investigação. Para ser sincero, estou mais interessado no segundo grupo, mas, de qualquer forma, vamos ao que interessa.

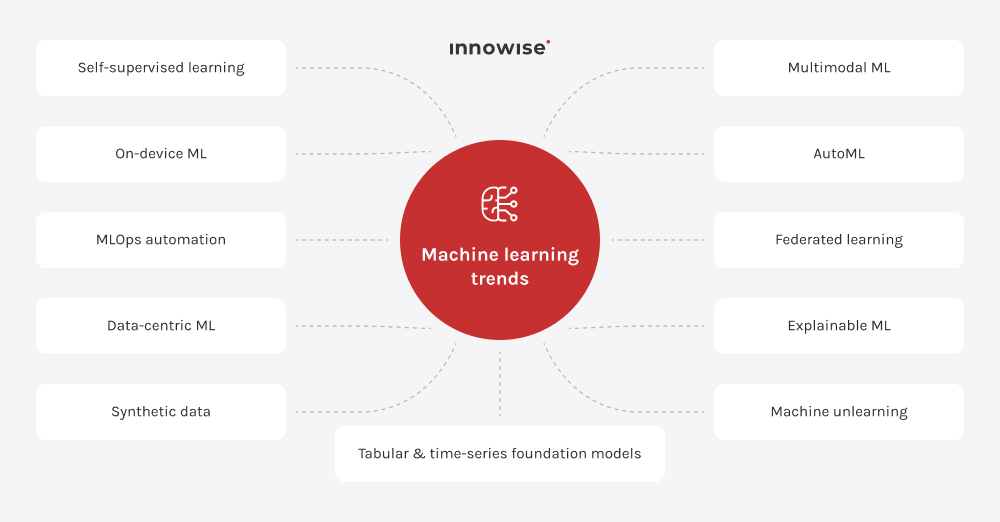
Key machine learning trends this year.

Modelos de base para dados tabulares e séries temporais

As tabelas estão a viver o seu momento "foundation-model".

Em junho de 2026, o Google apresentou o TabFM, um modelo para classificação e regressão tabular que consegue fazer previsões em novos conjuntos de dados sem a habitual ronda de treino específico para a tarefa e ajuste de hiperparâmetros. O Google testou-o em 38 conjuntos de dados de classificação e 13 de regressão, incluindo tabelas com até 150 000 amostras.

O que há de curioso nisto? É a forma como foi treinado. Não existe um gigantesco repositório público de tabelas empresariais limpas, pelo que o Google gerou, em vez disso, centenas de milhões de conjuntos de dados sintéticos.

Eu não eliminaria o XGBoost por enquanto. Para muitos problemas de dados estruturados, os modelos convencionais continuam a ser mais baratos, mais fáceis de depurar e muito difíceis de superar. Mas a ideia de abrir um novo conjunto de dados e obter uma linha de base decente sem ter de passar por mais uma maratona de afinação é bastante aliciante.

E as séries temporais estão a seguir a mesma direção. O TimesFM do Google é pré-treinado em grandes coleções de dados de séries temporais e consegue produzir previsões «zero-shot» para conjuntos de dados que nunca viu antes. A vantagem é semelhante à do TabFM: menos treino específico para cada tarefa sempre que alguém precisar de uma nova previsão de procura, tráfego ou capacidade.

Substituiria todos os pipelines de previsão existentes por este? Não. Mas vale a pena testá-lo quando a alternativa é mais uma ronda de treino e ajuste do modelo a partir do zero.

A aprendizagem auto-supervisionada requer menos rótulos

A rotulagem de dados é uma daquelas tarefas que todos concordam ser essencial, mas pela qual ninguém está disposto a pagar.

A aprendizagem auto-supervisionada contorna parte desse problema, aprendendo primeiro representações úteis a partir de dados não rotulados e, em seguida, adaptando-as a um conjunto de dados rotulados mais pequeno.

O DINOv3 da Meta é um bom exemplo. Foi treinado com 1,7 mil milhões de imagens sem rótulos humanos, sendo que o maior modelo atingiu 7 mil milhões de parâmetros. A mesma estrutura visual «congelada» pode, então, suportar tarefas como classificação, deteção de objetos, segmentação e rastreamento.

Para empresas que dispõem de anos de fotografias de inspeção, imagens de satélite, imagens médicas ou vídeos não rotulados, isso altera um pouco a economia. Pode ainda ser necessário recorrer a rótulos. Apenas talvez não sejam necessários vários milhões deles.

Os modelos mais pequenos estão a voltar a despertar interesse

Um modelo bonito que precisa de um centro de dados para responder a uma pergunta simples tem um encanto limitado num telemóvel, sensor, câmara ou controlador industrial.

Por isso, a compressão de modelos continua a receber cada vez mais atenção: a quantização reduz a precisão numérica, a poda remove pesos menos úteis e a destilação transfere conhecimento para um modelo mais pequeno. O próprio conjunto de ferramentas de otimização do TensorFlow’s próprio conjunto de ferramentas de otimização enumera a latência, o uso de memória, o consumo de energia e o tamanho do modelo como restrições centrais para a implementação na periferia.

Aqui não há almoço grátis. Se a compressão for demasiado agressiva, a precisão diminui.

O desafio é encontrar o ponto em que ninguém repara, exceto na conta da infraestrutura.

O MLOps está a tornar-se cada vez menos opcional

Treinar o modelo nunca foi o trabalho todo. Simplesmente passámos uma quantidade surpreendente de tempo a fingir que era.

Assim que um sistema de ML está em funcionamento, alguém tem de saber qual o conjunto de dados que o gerou, qual a versão do código que o treinou, se os dados de entrada sofreram alterações, se o desempenho está a desviar-se, quando é permitido o retreinamento e como reverter uma versão com erros.

As ferramentas estão a refletir isto. O MLflow 3, por exemplo, expandiu a sua arquitetura de gestão de modelos com vista a uma linhagem mais sólida e a uma melhor comparação entre versões de modelos e experiências.

Esta é provavelmente uma das tendências de aprendizagem automática menos glamorosas da lista, e uma das que eu levaria mais a sério.

Os dados sintéticos são submetidos a um teste de realidade

Os dados sintéticos parecem ser extremamente práticos. Faltam exemplos? Crie alguns.

Isso pode funcionar. Também pode tornar um modelo muito bom a compreender um mundo artificial que, na verdade, não existe.

Um artigo de investigação da Apple de 2026 analisou a combinação de dados de treino reais e sintéticos e descobriu algo mais útil do que “os dados sintéticos ajudam”. Os seus resultados sugerem que pode existir uma proporção ideal: ao adicionar dados sintéticos, o desempenho melhora até certo ponto, mas depois começa a piorar à medida que as distribuições sintéticas e reais se afastam demasiado uma da outra.

A aprendizagem automática multimodal passa a ser utilizada na previsão comum

"Multimodal" não tem de significar necessariamente um modelo capaz de analisar a sua fotografia e escrever um poema sobre ela.

No caso do ML preditivo, pode ser muito menos emocionante e muito mais útil: imagem do produto + descrição + preço, exame médico + historial do doente, leituras de sensores + notas de manutenção.

As ferramentas atuais do AutoGluon, por exemplo, podem combinar dados de imagem, texto, tabulares e de documentos para tarefas que incluem classificação e regressão.

A parte chata vem depois. O que acontece quando falta a imagem? Ou o sensor avaria? Ou uma fonte de dados chega duas horas mais tarde do que as outras?

Isso tem de fazer parte da avaliação, não ser uma surpresa descoberta após o lançamento.

O AutoML continua a eliminar as partes mais enfadonhas

Seleção de modelos, ajuste de hiperparâmetros, ensembling, partes do processamento de características: grande parte disto já pode ser automatizada de forma razoavelmente boa.

Ótimo.

Não estou convencido de que um engenheiro de ML bem remunerado precise de passar uma tarde a testar manualmente 47 combinações de taxa de aprendizagem e profundidade da árvore apenas para provar a sua dedicação à profissão.

O que o AutoML não automatiza muito bem é decidir se o alvo faz sentido, se os dados de treino revelam informação do futuro, se a métrica de avaliação reflete o custo para a empresa ou se o modelo deve, de todo, existir.

Esses continuam a ser problemas inconvenientemente humanos.

A aprendizagem federada ainda não é sinónimo de privacidade

A aprendizagem federada apresenta uma configuração muito apelativa: permite treinar em vários dispositivos ou organizações sem ter de transferir todos os dados brutos para uma base de dados central.

Útil, sim. Automaticamente privada, não.

O NIST documentou ataques capazes de recuperar informações a partir das atualizações do modelo trocadas durante o treino federado, e recomenda proteções adicionais em vez de considerar a descentralização, por si só, como uma garantia de privacidade.

E as implementações reais são complicadas. Dispositivos diferentes têm capacidade de computação diferente, os participantes desaparecem, as distribuições de dados variam e os pressupostos de segurança são quebrados. A análise de implementação de 2024 do NIST expõe de forma bastante clara a discrepância entre a teoria bem organizada da aprendizagem federada e os sistemas de produção.

Um especialista citado nesse documento, o Dr. Mat Weldon, do Gabinete Nacional de Estatística do Reino Unido, expressou-o melhor do que eu:

“É mais fácil conceber uma nova arquitetura de aprendizagem federada do que testá-la com uma equipa de ataque.”

É justo.

A explicabilidade torna-se menos formal

Durante anos, adicionar um gráfico SHAP a um painel de controlo podia fazer com que um modelo parecesse satisfatoriamente “explicável”.

Isso é um padrão muito baixo.

O NIST distingue entre explicabilidade, ou seja, compreender como um sistema produziu um resultado, e interpretabilidade, ou seja, o que esse resultado significa no seu contexto. As suas orientações também recomendam testar os métodos de explicação antes da implementação, em vez de assumir que a explicação está correta apenas porque o gráfico parece convincente.

Os investigadores do NIST publicaram um trabalho em 2026 sobre validação explicável e redução de características, o que é interessante porque aproxima a explicabilidade dos testes do modelo, em vez de a deixar como uma camada adicionada posteriormente.

Gosto dessa direção. Uma explicação deve ser algo que testamos, não um adorno para o cartão do modelo.

O «desaprendizado» das máquinas torna-se uma verdadeira questão de engenharia

Suponha que alguém lhe peça para apagar os seus dados.

Apaga o registo da base de dados.

Tudo bem.

E quanto ao modelo que já foi treinado com esses dados?

É aí que entra o desaprendizado de máquinas: remover a influência de dados de treino específicos sem ter de treinar novamente todo o modelo a partir do zero. Em junho de 2026, a Google Research publicou uma estrutura para verificar se um modelo que passou pelo “desaprendizado” se comporta realmente mais como um modelo recém-treinado do que como o original.

E essa segunda parte é importante. Esquecer-se de algo é um problema. Provar que o modelo se esqueceu disso é outro.

O «desaprendizado» de máquinas ainda está muito mais próximo da investigação ativa do que das ferramentas empresariais de rotina, mas eu ficaria atento a este tema. No momento em que «apagar os meus dados» tiver de significar mais do que apagar uma linha, isto deixa de ser teórico.

Crie uma solução de aprendizagem automática para a sua empresa

Como as tendências da aprendizagem automática estão a alterar os fluxos de trabalho em todos os setores

A mesma tendência de aprendizagem automática pode comportar-se de forma muito diferente quando é aplicada num fluxo de trabalho real. No retalho, uma inferência mais rápida pode significar a atualização de recomendações enquanto o cliente ainda está a navegar. Na indústria transformadora, pode significar a deteção de um defeito antes de o produto ter avançado na linha de produção.

  • Educação
  • Retalho e comércio eletrónico
  • Banca e finanças
  • Saúde
  • Indústria transformadora
  • Logística e transportes

Educação

As plataformas educativas já dispõem de uma grande quantidade de dados: respostas, tentativas, tempos de resposta, tarefas ignoradas, progresso no curso. O mais difícil é transformar isso em algo útil sem fingir que um modelo compreende um aluno melhor do que um professor.

A aprendizagem automática já era a o maior segmento tecnológico no mercado da IA na educação em 2025, sendo que o acompanhamento do desempenho, a personalização e o acompanhamento inteligente estão entre as principais aplicações.

  • Ajustar a dificuldade e a sequência dos exercícios com base no desempenho anterior, em vez de obrigar toda a gente a seguir o mesmo caminho.
  • Prever o risco de abandono escolar a partir de padrões como a diminuição da participação, falhas repetidas ou longos intervalos entre sessões.
  • Detetar lacunas de conhecimento mais cedo e rever o plano de estudos antes de o aluno chegar ao próximo tópico sem estar de todo preparado.
Retalho e comércio eletrónico

O setor do retalho tem vindo a utilizar o ML há anos, mas as mudanças interessantes estão a ocorrer na velocidade e na variedade de dados. As previsões podem ser atualizadas com maior frequência, as recomendações podem basear-se em mais do que apenas o histórico de compras e a pesquisa visual pode combinar imagens com descrições de produtos e dados do catálogo.

  • Prever a procura e automatizar o reabastecimento com base no histórico de vendas, na sazonalidade, nas promoções e em dados operacionais mais recentes.
  • Personalizar recomendações com base no comportamento de navegação e de compra, em vez de segmentos de clientes estáticos.
  • Melhorar a pesquisa de produtos através da combinação de dados de texto e imagem, o que é útil quando o cliente não sabe como se chama o artigo, mas tem uma fotografia.

Banca e finanças

É no setor bancário que a monitorização de modelos, a explicabilidade e a deriva se tornam difíceis de ignorar. Os padrões de fraude mudam, o comportamento dos clientes muda e um modelo que parecia bom há seis meses pode tornar-se muito dispendioso num instante.

O mercado global de aprendizagem automática no sector bancário O mercado valia cerca de 40 mil milhões de dólares em 2025 e prevê-se que atinja cerca de 150 mil milhões de dólares até 2034de acordo com Informações comerciais da Fortune.

  • Detetar transações suspeitas e classificar os casos para que os investigadores comecem pelos que parecem apresentar maior risco.
  • Explique decisões de crédito mostrando quais os fatores que tiveram maior influência numa pontuação.
  • Monitorizar a deriva do modelo à medida que as técnicas de fraude, os hábitos de consumo e os perfis dos clientes vão mudando.

Saúde

Os cuidados de saúde são uma daquelas áreas em que um bom valor de referência está longe de ser suficiente. Os modelos podem comportar-se de forma diferente consoante os hospitais, os grupos de doentes, os dispositivos e os contextos clínicos; por isso, a calibração e a monitorização são tão importantes quanto os dados brutos desempenho preditivo.

Estima-se que o mercado global de análise preditiva na área da saúde ascenda a 19,7 mil milhões de dólares em 2026 por Pesquisa Grand View, que prevê que atinja 49,3 mil milhões de dólares até 2033.

  • Identificar os primeiros sinais de deterioração, incluindo o risco de sépsis, antes de a situação se tornar clinicamente evidente.
  • Prever o risco de readmissão e dar prioridade ao acompanhamento dos doentes com maior probabilidade de regressarem.
  • Classificar os processos para revisão para que os profissionais de saúde possam concentrar a sua atenção nos casos em que o risco previsto é mais elevado.

Indústria transformadora

A indústria transformadora é provavelmente o exemplo mais claro para o ML no próprio dispositivo. Se uma câmara estiver a inspecionar peças que se deslocam ao longo de uma linha de produção, muitas vezes não faz muito sentido enviar todas as imagens para a nuvem e aguardar uma resposta.

O mercado mais vasto da IA na indústria transformadora está estimado em 9,85 mil milhões de dólares em 2026, recorrendo à aprendizagem automática e à visão computacional para a manutenção preditiva, a inspeção, o controlo de qualidade e o planeamento da produção.

  • Prever falhas no equipamento com base na vibração, na temperatura, na pressão e no histórico de manutenção.
  • Detetar defeitos com visão computacional enquanto o produto ainda se encontra na linha de produção.
  • Prever a qualidade do produto a partir dos parâmetros de fabrico, antes da inspeção final.

Logística e transportes

A logística está repleta de problemas de previsão, o que a torna um campo de aplicação natural para a aprendizagem automática: horários de chegada, atrasos, procura nos armazéns, tráfego, alterações de percurso, ligações perdidas.

O Estima-se que o mercado da aprendizagem automática na logística atinja os 5,3 mil milhões de dólares em 2026 e prevê-se que atinja 44,5 mil milhões de dólares até 2035de acordo com Perspectivas do mercado global.

Neste caso, a incerteza também é importante. “Chegada prevista às 14h10” e “Chegada prevista às 14h10, mas não temos a certeza” são duas informações muito diferentes para alguém que está à espera numa zona de carga e descarga.

  • Prever horários de chegada com base em atrasos históricos, condições de trânsito e localizações em tempo real dos veículos.
  • Previsão de atrasos nas entregas com antecedência suficiente para ajustar os planos relativos ao armazém ou às entregas.
  • Prever o tempo de viagem e a procura para apoiar o planeamento de percursos e a afetação da frota.

Educação

As plataformas educativas já dispõem de uma grande quantidade de dados: respostas, tentativas, tempos de resposta, tarefas ignoradas, progresso no curso. O mais difícil é transformar isso em algo útil sem fingir que um modelo compreende um aluno melhor do que um professor.

A aprendizagem automática já era a o maior segmento tecnológico no mercado da IA na educação em 2025, sendo que o acompanhamento do desempenho, a personalização e o acompanhamento inteligente estão entre as principais aplicações.

  • Ajustar a dificuldade e a sequência dos exercícios com base no desempenho anterior, em vez de obrigar toda a gente a seguir o mesmo caminho.
  • Prever o risco de abandono escolar a partir de padrões como a diminuição da participação, falhas repetidas ou longos intervalos entre sessões.
  • Detetar lacunas de conhecimento mais cedo e rever o plano de estudos antes de o aluno chegar ao próximo tópico sem estar de todo preparado.

Retalho e comércio eletrónico

O setor do retalho tem vindo a utilizar o ML há anos, mas as mudanças interessantes estão a ocorrer na velocidade e na variedade de dados. As previsões podem ser atualizadas com maior frequência, as recomendações podem basear-se em mais do que apenas o histórico de compras e a pesquisa visual pode combinar imagens com descrições de produtos e dados do catálogo.

  • Prever a procura e automatizar o reabastecimento com base no histórico de vendas, na sazonalidade, nas promoções e em dados operacionais mais recentes.
  • Personalizar recomendações com base no comportamento de navegação e de compra, em vez de segmentos de clientes estáticos.
  • Melhorar a pesquisa de produtos através da combinação de dados de texto e imagem, o que é útil quando o cliente não sabe como se chama o artigo, mas tem uma fotografia.

Banca e finanças

É no setor bancário que a monitorização de modelos, a explicabilidade e a deriva se tornam difíceis de ignorar. Os padrões de fraude mudam, o comportamento dos clientes muda e um modelo que parecia bom há seis meses pode tornar-se muito dispendioso num instante.

O mercado global de aprendizagem automática no sector bancário O mercado valia cerca de 40 mil milhões de dólares em 2025 e prevê-se que atinja cerca de 150 mil milhões de dólares até 2034de acordo com Informações comerciais da Fortune.

  • Detetar transações suspeitas e classificar os casos para que os investigadores comecem pelos que parecem apresentar maior risco.
  • Explique decisões de crédito mostrando quais os fatores que tiveram maior influência numa pontuação.
  • Monitorizar a deriva do modelo à medida que as técnicas de fraude, os hábitos de consumo e os perfis dos clientes vão mudando.

Saúde

Os cuidados de saúde são uma daquelas áreas em que um bom valor de referência está longe de ser suficiente. Os modelos podem comportar-se de forma diferente consoante os hospitais, os grupos de doentes, os dispositivos e os contextos clínicos; por isso, a calibração e a monitorização são tão importantes quanto os dados brutos desempenho preditivo.

Estima-se que o mercado global de análise preditiva na área da saúde ascenda a 19,7 mil milhões de dólares em 2026 por Pesquisa Grand View, que prevê que atinja 49,3 mil milhões de dólares até 2033.

  • Identificar os primeiros sinais de deterioração, incluindo o risco de sépsis, antes de a situação se tornar clinicamente evidente.
  • Prever o risco de readmissão e dar prioridade ao acompanhamento dos doentes com maior probabilidade de regressarem.
  • Classificar os processos para revisão para que os profissionais de saúde possam concentrar a sua atenção nos casos em que o risco previsto é mais elevado.

Indústria transformadora

A indústria transformadora é provavelmente o exemplo mais claro para o ML no próprio dispositivo. Se uma câmara estiver a inspecionar peças que se deslocam ao longo de uma linha de produção, muitas vezes não faz muito sentido enviar todas as imagens para a nuvem e aguardar uma resposta.

O mercado mais vasto da IA na indústria transformadora está estimado em 9,85 mil milhões de dólares em 2026, recorrendo à aprendizagem automática e à visão computacional para a manutenção preditiva, a inspeção, o controlo de qualidade e o planeamento da produção.

  • Prever falhas no equipamento com base na vibração, na temperatura, na pressão e no histórico de manutenção.
  • Detetar defeitos com visão computacional enquanto o produto ainda se encontra na linha de produção.
  • Prever a qualidade do produto a partir dos parâmetros de fabrico, antes da inspeção final.

Logística e transportes

A logística está repleta de problemas de previsão, o que a torna um campo de aplicação natural para a aprendizagem automática: horários de chegada, atrasos, procura nos armazéns, tráfego, alterações de percurso, ligações perdidas.

O Estima-se que o mercado da aprendizagem automática na logística atinja os 5,3 mil milhões de dólares em 2026 e prevê-se que atinja 44,5 mil milhões de dólares até 2035de acordo com Perspectivas do mercado global.

Neste caso, a incerteza também é importante. “Chegada prevista às 14h10” e “Chegada prevista às 14h10, mas não temos a certeza” são duas informações muito diferentes para alguém que está à espera numa zona de carga e descarga.

  • Prever horários de chegada com base em atrasos históricos, condições de trânsito e localizações em tempo real dos veículos.
  • Previsão de atrasos nas entregas com antecedência suficiente para ajustar os planos relativos ao armazém ou às entregas.
  • Prever o tempo de viagem e a procura para apoiar o planeamento de percursos e a afetação da frota.
O modelo que obtém melhores resultados no teste de desempenho nem sempre é aquele que eu escolheria para colocar em produção. Quando se têm em conta a latência, os custos de infraestrutura, o desvio e a manutenção, um modelo ligeiramente menos preciso pode facilmente tornar-se a melhor decisão do ponto de vista da engenharia.
Dmitry Nazarevich, CTO.
Dmitry Nazarevich
Diretor de Tecnologia

Tendências futuras da aprendizagem automática

Algumas ideias de ML já são úteis hoje em dia. Outras ainda precisam de melhores testes de desempenho, recursos computacionais mais baratos ou algumas experiências desagradáveis em ambiente de produção antes de eu as considerar prontas.

Estas são as tendências emergentes no aprendizado de máquina que eu continuaria a acompanhar.

  • Cross-domain generalization and adaptation icon.

    Generalização e adaptação entre domínios

    Um dos problemas mais antigos do aprendizado de máquinas continua bem presente: treine um modelo num ambiente, transfira-o para um ambiente ligeiramente diferente e veja o desempenho a diminuir.

    A generalização de domínio procura fazer com que os modelos se mantenham válidos em distribuições de dados que nunca tenham visto antes. Um estudo de 2026 sobre a classificação de padrões em ambientes desconhecidos descreve exatamente este problema: alterações nos sensores, nas condições de aquisição ou noutras características do domínio podem ser suficientes para prejudicar gravemente um modelo.

    É fácil imaginar a aplicação prática. Um modelo de visão artificial treinado numa fábrica tem de funcionar noutra fábrica com câmaras diferentes. Um modelo médico é transferido para outro hospital. Um modelo de deteção de fraudes passa a analisar um novo conjunto de clientes.

    Suspeito que isto venha a deixar de ser uma especialidade de investigação para se tornar, antes, um requisito básico de implementação.

  • Continual learning icon.

    Aprendizagem contínua

    A maioria dos modelos de produção ainda aprende por etapas: recolher novos dados, retreinar, validar e implementar novamente.

    A aprendizagem contínua visa um processo mais fluido. O modelo continua a aprender à medida que surgem novos dados, sem esquecer o que já sabia anteriormente.

    Essa última parte é o senão.

    Uma revisão sistemática de 2026 de 189 artigos sobre aprendizagem contínua submetidos a revisão por pares continua a identificar o esquecimento catastrófico como um dos principais problemas da área: aprender algo novo pode prejudicar o desempenho em tarefas anteriores.

    Por isso, não substituiria a reciclagem profissional programada pela aprendizagem contínua só porque o nome soa melhor. Mas no que diz respeito à deteção de fraudes, aos sistemas industriais, às recomendações e a outros ambientes em constante mudança, o seu interesse é óbvio.

  • Hybrid ML models icon.

    Modelos híbridos de aprendizagem automática

    Há algo de um pouco engraçado em passar anos a tentar fazer com que as redes neurais aprendam tudo a partir dos dados, para depois descobrir que a física conhecida ainda pode ser útil.

    O NeuralGCM da Google é um bom exemplo. Combina a aprendizagem automática com um solucionador atmosférico baseado na física, em vez de atribuir a qualquer um deles a tarefa completa. Numa estudo publicado na Nature, o modelo produziu previsões meteorológicas e climáticas competitivas, utilizando três a cinco ordens de magnitude menos recursos computacionais do que modelos convencionais comparáveis.

    Essa ideia vai muito além do tempo.

    Se já conhecemos as restrições físicas, as regras de engenharia ou outras relações próprias do domínio, introduzi-las no modelo pode fazer mais sentido do que pedir a uma rede neural que redescubra a gravidade a partir de uma folha de cálculo.

  • Causal ML icon.

    Aprendizagem de máquinas causal

    A previsão responde a perguntas como:

    Quem tem mais probabilidades de cancelar a assinatura?

    As empresas costumam querer saber o que se segue:

    Quem ficará se lhes dermos um desconto?

    Essa é uma questão de causalidade.

    A ML causal combina a aprendizagem automática com a inferência causal para estimar o que pode acontecer sob diferentes intervenções. Esta área já está a ser utilizada para estimar os efeitos de tratamentos individualizados na medicina, embora os investigadores continuem a alertar que pressupostos incorretos e fatores de confusão podem levar a conclusões convincentes, mas erradas.

    Acho que esta é uma das abordagens mais interessantes neste contexto, porque altera o objetivo do modelo. A previsão descreve um futuro provável. O ML causal tenta indicar se o facto de se fazer algo irá alterá-lo.

    Um problema muito mais difícil.

    É muito mais útil.

  • Uncertainty-aware predictions icon.

    Previsões que têm em conta a incerteza

    Um modelo que indica “92 % de confiança” transmite uma sensação de segurança.

    Também pode ser um disparate.

    A calibração da incerteza procura alinhar o nível de confiança com a precisão preditiva real. Um estudo publicado em Nature Machine Intelligence em 2026 descreve a calibração como essencial para uma implementação fiável do ML, precisamente porque os modelos modernos podem apresentar um elevado nível de confiança mesmo estando errados.

    A mudança nos padrões de distribuição agrava ainda mais a situação. Um estudo de 2026 publicado na revista Scientific Reports revelou que os modelos preditivos podem perder tanto desempenho como calibração quando aplicados a conjuntos de dados heterogéneos do mundo real.

    Para as empresas, o resultado útil não é um modelo que dê sempre uma resposta. Por vezes, o melhor modelo é aquele que diz, na prática: Não tenho muita certeza quanto a isto, passa isto a um ser humano.

    Gostava de ver muito mais disso.

Precisa de ajuda para escolher a abordagem de ML mais adequada?

Próximos passos: como as empresas podem implementar as tendências tecnológicas de aprendizagem automática

A pior forma de utilizar esta lista é escolher uma tendência só porque parece estar na moda e, depois, procurar um problema ao qual a associar.

Começa, em vez disso, pelo problema empresarial mais incómodo.

01
Definir o que é necessário melhorar

Previsões mais precisas? Menos alertas falsos de fraude? Custos de inferência mais baixos? Inspeção mais rápida? Escolha primeiro o resultado pretendido e utilize o processo atual como referência.

02
Verifique se os dados corroboram essa afirmação

Antes de comparar modelos, analise as etiquetas, os valores em falta, os direitos de acesso, o desequilíbrio entre classes, a cobertura e se os dados de produção serão semelhantes aos dados utilizados para o treino. É também nesta fase que muitos projetos de aprendizagem automática perdem rapidamente o seu encanto.

03
Compara a novidade com o que é aborrecido

Se estiver a ser considerado um modelo pré-treinado, um sistema AutoML ou uma arquitetura multimodal, teste-o em comparação com uma referência mais simples, nas mesmas condições. Os mesmos dados, as mesmas métricas, os mesmos limites de latência e o mesmo objetivo empresarial.

Se o modelo complexo tiver um desempenho 0,3% superior e custar quatro vezes mais para funcionar, eu precisaria de uma razão muito boa para o manter.

04
Teste-o em situações em que o falhanço não seja fatal

Utilize dados representativos e teste os cenários mais suscetíveis de causar problemas: dados de entrada em falta, classes raras, dispositivos invulgares, segmentos de clientes mais vulneráveis, picos de carga. Decida antecipadamente quais seriam os motivos que o levariam a interromper o projeto-piloto.

05
Atribuir um proprietário ao modelo após o lançamento

É necessário monitorizar o desvio, a latência, os custos, a calibração, o desempenho dos subgrupos e a métrica empresarial que o modelo deveria melhorar. É também necessário decidir quando o retreinar, reverter, substituir ou simplesmente desativar.

E sim, por vezes a conclusão correta é que a nova tendência em ML não traz melhorias suficientes para justificar qualquer mudança.

Isso também conta como uma avaliação bem-sucedida.

arrow-icon.arrow-icon.
01 Definir o que é necessário melhorar

Previsões mais precisas? Menos alertas falsos de fraude? Custos de inferência mais baixos? Inspeção mais rápida? Escolha primeiro o resultado pretendido e utilize o processo atual como referência.

arrow-icon.arrow-icon.
02 Verifique se os dados corroboram essa afirmação

Antes de comparar modelos, analise as etiquetas, os valores em falta, os direitos de acesso, o desequilíbrio entre classes, a cobertura e se os dados de produção serão semelhantes aos dados utilizados para o treino. É também nesta fase que muitos projetos de aprendizagem automática perdem rapidamente o seu encanto.

arrow-icon.arrow-icon.
03 Compara a novidade com o que é aborrecido

Se estiver a ser considerado um modelo pré-treinado, um sistema AutoML ou uma arquitetura multimodal, teste-o em comparação com uma referência mais simples, nas mesmas condições. Os mesmos dados, as mesmas métricas, os mesmos limites de latência e o mesmo objetivo empresarial.

Se o modelo complexo tiver um desempenho 0,3% superior e custar quatro vezes mais para funcionar, eu precisaria de uma razão muito boa para o manter.

arrow-icon.arrow-icon.
04 Teste-o em situações em que o falhanço não seja fatal

Utilize dados representativos e teste os cenários mais suscetíveis de causar problemas: dados de entrada em falta, classes raras, dispositivos invulgares, segmentos de clientes mais vulneráveis, picos de carga. Decida antecipadamente quais seriam os motivos que o levariam a interromper o projeto-piloto.

arrow-icon.arrow-icon.
05 Atribuir um proprietário ao modelo após o lançamento

É necessário monitorizar o desvio, a latência, os custos, a calibração, o desempenho dos subgrupos e a métrica empresarial que o modelo deveria melhorar. É também necessário decidir quando o retreinar, reverter, substituir ou simplesmente desativar.

E sim, por vezes a conclusão correta é que a nova tendência em ML não traz melhorias suficientes para justificar qualquer mudança.

Isso também conta como uma avaliação bem-sucedida.

Aplicações e tendências da aprendizagem automática na prática: Estudos de caso da Innowise

Todos os estudos de caso
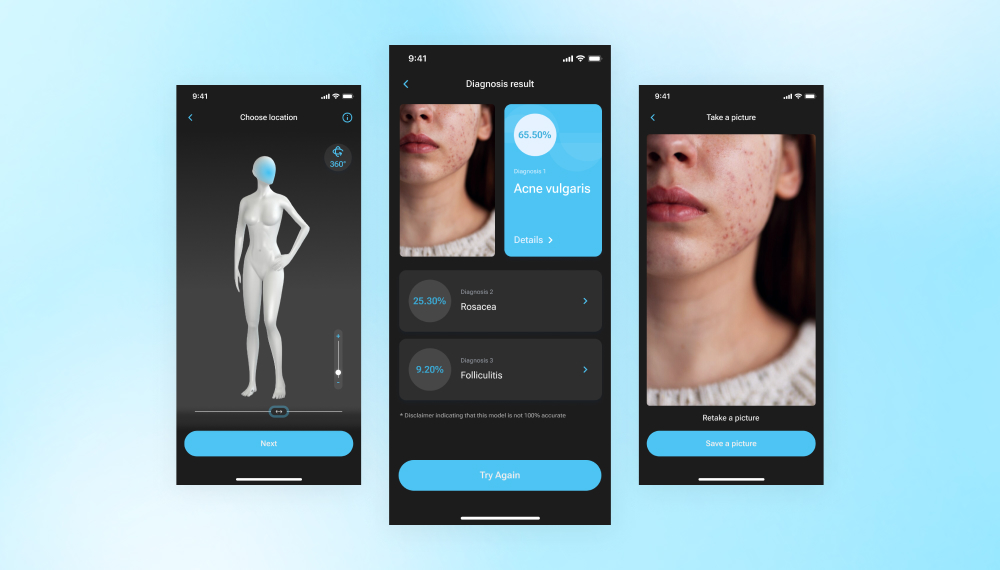
Desenvolvimento de uma aplicação de análise da pele com dermatologista de IA
Uma aplicação de IA que desenvolvemos utiliza aprendizagem profunda e reconhecimento de imagens para avaliar rapidamente as condições da pele, fornecendo diagnósticos preliminares com base em fotografias.
30 condições dermatológicas reconhecidas
Criação de um sistema de monitorização remota de doentes com IA
Criámos uma aplicação para o tratamento de feridas no âmbito do software de monitorização remota de doentes e implementámos uma análise baseada em IA para uma avaliação precisa.
de dois níveis sistema de funções de utilizador
100% conformidade do sistema
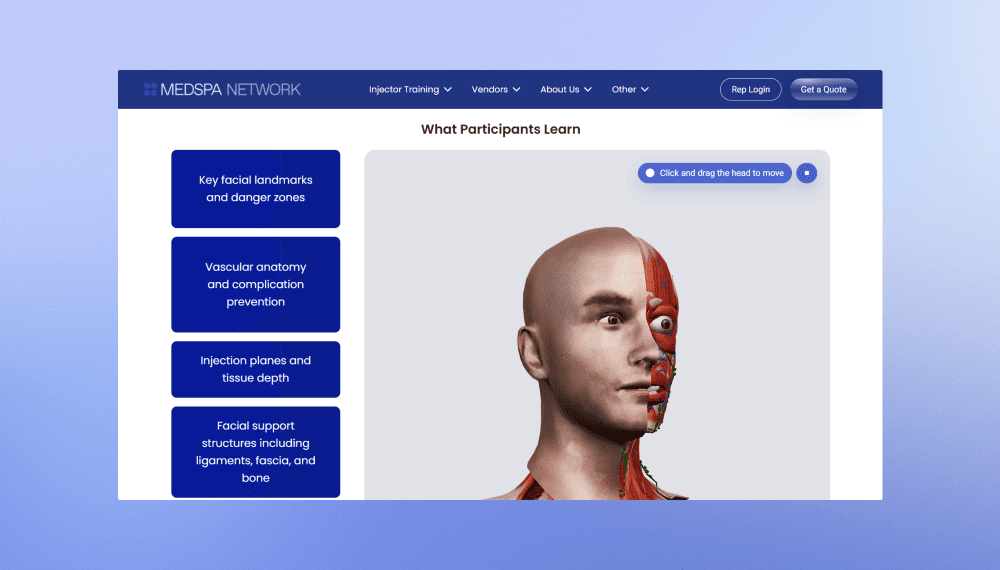
Redesenho e reconstrução do site da MedSpa Network
A Innowise reformulou o site da MedSpa Network no WordPress, permitindo à sua equipa controlar as atualizações diárias de conteúdo.
2 meses desde o início até ao lançamento
3-5 leads por semana, em comparação com 1 por mês
Ver estudo de caso
Avaliação do cliente
Ver estudo de caso
Client review logo. Avaliação do cliente
MedSpa Network website redesign and rebuild.
Bot de IA para a campanha de marketing do TBC Bank
A Innowise criou um bot bilingue no Telegram que gera selfies geradas por IA com o embaixador da marca do TBC Bank, uma estrela do futebol.
3,000 utilizadores envolvidos
2 idiomas suportados
Ver estudo de caso
Avaliação do cliente
Ver estudo de caso
Client review logo. Avaliação do cliente
AI Telegram bot..
Definição da estratégia de produto para a plataforma de empréstimos em bitcoin da Bitlendex
A Innowise conduziu uma fase de descoberta para a Bitlendex, ajudando o cliente a transformar um conceito de produto em fase inicial num modelo de negócio validado e num MVP claramente definido.
1 mês para uma fase de investigação completa
Sistema de consultoria financeira para Bonnfinanz
A Innowise ajudou a Bonnfinanz a criar um sistema de aconselhamento e gestão baseado na Web que permite o trabalho móvel e a interação direta com o cliente.
Plataforma de carregamento de veículos elétricos com faturação flexível
A Innowise contribuiu para a modernização da plataforma de mobilidade elétrica da SMART/LAB, melhorando as suas capacidades de faturação, pagamento, gestão de transações e elaboração de relatórios.
>50% processamento mais rápido da faturação e dos pagamentos
Transformação DevOps cloud-native da FinXP
A Innowise ajudou a FinXP a modernizar a sua infraestrutura de serviços financeiros, através da migração de APIs e aplicações legadas baseadas em PHP para uma arquitetura nativa da nuvem.
11 aplicações transferidas para o Azure App Service
100% Infraestrutura como código
01 / 01
Close popup icon

Conclusão

Em 2026, grande parte do trabalho está a ser dedicado a modelos reutilizáveis, melhores representações, pegadas de inferência mais pequenas, monitorização, calibração e a compreender o que acontece quando um modelo se depara com dados que não constavam do conjunto de treino.

Essa é provavelmente a mudança útil a ter em conta. Uma abordagem mais recente só é melhor se se adequar ao problema, aos dados, à infraestrutura e à forma como o modelo será utilizado. Se um modelo mais antigo tiver um desempenho igualmente bom e for mais fácil de executar, mantenha o modelo mais antigo. Se um modelo de base poupar semanas de treino, utilize-o. Se nenhum dos dois passar num teste-piloto adequado, siga em frente.

A tendência, por si só, nunca é a razão.

Se estiver a avaliar quais as abordagens de ML que fazem sentido para um produto ou fluxo de trabalho real, a nossa equipa de consultoria em aprendizagem automática pode ajudar com a arquitetura, a seleção de modelos, a validação e a implementação.

FAQ

A aprendizagem automática (ML) é um ramo da IA em que os modelos aprendem padrões a partir de dados e utilizam-nos para fazer previsões ou tomar decisões sem que seja necessário definir manualmente todas as regras.

Na prática, isso pode significar prever a procura, detetar fraudes, estimar riscos, recomendar produtos, identificar defeitos ou prever quando é provável que um equipamento avarie.

A IA é a categoria geral. A aprendizagem automática é uma forma de criar sistemas de IA através da aprendizagem a partir de dados. A aprendizagem profunda é um subconjunto da aprendizagem automática baseado em redes neurais com várias camadas.

Portanto, a relação é bastante simples: o deep learning faz parte do aprendizado de máquinas, e o aprendizado de máquinas faz parte da IA.

Sem dúvida.

O Gradient Boosting, as florestas aleatórias, a regressão logística e outros métodos consagrados continuam a ser opções sólidas para muitos problemas relacionados com dados estruturados. Podem ser mais rápidos, mais económicos e mais fáceis de explicar do que as abordagens mais recentes de aprendizagem profunda.

Um modelo não se torna obsoleto só porque existe outro mais na moda.

Normalmente, são os aspetos mais enfadonhos: má qualidade dos dados, falta de etiquetas, infraestruturas deficientes, responsabilidades pouco claras, restrições de privacidade, problemas de integração e falta de pessoal que compreenda tanto o modelo como o processo empresarial que o envolve.

Há ainda outra questão: por vezes, o sistema de aprendizagem automática proposto não melhora o processo existente o suficiente para justificar o trabalho.

Vale a pena descobrir isso logo no início.

O AutoML pode tratar de aspetos relacionados com a seleção de modelos, o ajuste de hiperparâmetros, o processamento de características, a combinação de modelos e a experimentação.

Os seres humanos ainda precisam de decidir o que o modelo deve prever, se os dados fazem sentido, quais os erros mais importantes, como se deve medir o sucesso e se o sistema final é suficientemente seguro e útil para ser implementado.

O AutoML pode realizar experiências. No entanto, não consegue determinar se valeu a pena realizar a experiência.

O ML no dispositivo faz sentido quando a latência é importante, a conectividade não é fiável, a largura de banda é limitada ou os dados sensíveis devem permanecer no dispositivo.

A desvantagem reside no hardware. Os dispositivos mais pequenos têm limites mais restritos em termos de memória, capacidade de processamento e energia, pelo que os modelos necessitam, normalmente, de compressão ou de outras otimizações antes de poderem funcionar adequadamente nesses dispositivos.

Para a maioria das empresas, não.

A aprendizagem automática quântica continua a ser, em grande parte, um tema de investigação. Existem experiências relacionadas com a otimização, os kernels quânticos e os modelos híbridos quânticos-clássicos, mas a aprendizagem automática convencional continua a ser muito mais prática para os sistemas de produção normais em 2026.

Se alguém propuser hoje a aplicação da aprendizagem automática quântica a um problema de previsão rotineiro, perguntaria primeiro o que é que, exatamente, o modelo convencional não conseguiu fazer.

Mostrar tudo

Índice

Coloque o ML em prática

    Contacte-nos

    Agende uma chamada ou preencha o formulário abaixo e entraremos em contacto consigo assim que analisarmos o seu pedido.

    Envie-nos uma mensagem de voz
    Anexar documentos
    Enviar ficheiro

    Pode anexar um ficheiro com um máximo de 2MB. Formatos de ficheiro válidos: pdf, jpg, jpeg, png.

    Ao clicar em «Enviar», autoriza a Innowise a tratar os seus dados pessoais de acordo com a nossa Política de Privacidade , para lhe fornecer informações relevantes. Ao enviar o seu número de telefone, aceita que possamos contactá-lo através de chamadas de voz, SMS e aplicações de mensagens. Poderão aplicar-se tarifas de chamadas, mensagens e dados.

    Pode também enviar-nos o seu pedido
    para contact@innowise.com
    O que é que acontece a seguir?
    1

    Assim que recebermos e analisarmos o seu pedido, entraremos em contacto consigo para detalhar as necessidades do seu projeto e assinar um NDA para garantir a confidencialidade.

    2

    Depois de analisarmos os seus desejos, necessidades e expectativas, a nossa equipa elaborará uma proposta de projeto com o âmbito do trabalho, dimensão da equipa, tempo e estimativas de custos.

    3

    Marcaremos uma reunião consigo para discutir a oferta e acertar os pormenores.

    4

    Por fim, assinaremos um contrato e começaremos a trabalhar no seu projeto imediatamente.

    Mais serviços abrangidos

    arrow