Magazyn danych dotyczących opieki zdrowotnej: korzyści, architektura i przykłady zastosowań

21 września 2026 r. Czas czytania: 12 minut
Aleh Yafimau, Healthcare and MedTech Delivery Manager..
Konsultant ds. opieki zdrowotnej IT
Zweryfikowany ekspert
Każdy artykuł na stronie Innowise jest tworzony przez autorów posiadających praktyczne doświadczenie. Rozumieją oni dany temat nie tylko z teoretycznego punktu widzenia, ale także dzielą się spostrzeżeniami wynikającymi z rzeczywistych projektów.
Ponad 19 lat doświadczenia
Zweryfikowany ekspert
Ponad 19 lat doświadczenia
Aleh wypełnia lukę między potrzebami klinicznymi a realizacją inżynieryjną. Stosuje głęboką wiedzę dziedzinową, aby zapewnić, że systemy MedTech są nie tylko zgodne, ale także wystarczająco niezawodne, aby wywrzeć wymierny wpływ na rzeczywistą opiekę zdrowotną.
Wiedza
Opieka zdrowotna w IT Medtech Algorytmy
Poznajmy się

Kluczowe punkty

  • Gdy dane dotyczące pacjentów, roszczeń, badań laboratoryjnych, finansów i działalności operacyjnej są przechowywane w różnych systemach, sporządzanie raportów zazwyczaj wymaga ręcznego uzgadniania informacji pochodzących z różnych źródeł. A hmagazyn danych dotyczących opieki zdrowotnej łączy dane z tych systemów, dzięki czemu zespoły mogą je wykorzystywać do tworzenia raportów i analiz.
  • Nawet najlepiej zaprojektowany system magazynowy nie jest w stanie zrekompensować niskiej jakości danych. Problemy takie jak zduplikowane rekordy pacjentów, niespójne formaty i sprzeczne definicje mogą sprawić, że raporty będą niewiarygodne.
  • Model magazynu danych określa, w jakim zakresie wspólne dane i definicje są udostępniane. Korporacyjna hurtownia danych (DWH) służy do generowania raportów w całej organizacji, natomiast magazyny danych (data marts) są tworzone z myślą o konkretnych działach lub konkretnych zastosowaniach. Architektury hybrydowe wykorzystują oba te elementy. 
  • Analiza biznesowa powinna rozpocząć się od określenia decyzji, które magazyn musi wspierać – od oceny stanu zdrowia populacji i oceny ryzyka pacjentów po badania kliniczne, analizę roszczeń lub planowanie zatrudnienia i zdolności produkcyjnych.
Podsumuj artykuł za pomocą AI

Jeśli dokumentacja pacjentów, wyniki badań laboratoryjnych, rozliczenia i dane operacyjne są przechowywane w różnych systemach, uzyskanie wiarygodnej odpowiedzi może wymagać więcej pracy niż sama analiza. Zespoły mogą być zmuszone do uzgodnienia danych i sprawdzenia, co faktycznie oznaczają te liczby, zanim będą mogły z nich skorzystać. A magazyn danych dotyczących opieki zdrowotnej (DWH) konsoliduje dane z tych systemów i porządkuje je na potrzeby raportowania i analizy.

W tym artykule wyjaśnię, jak powstaje hurtownia danych (DWH) dla sektora opieki zdrowotnej oraz które funkcje mają znaczenie w praktyce. Przyjrzymy się również głównym modelom hurtowni danych, typowym przypadkom użycia w opiece zdrowotnej, korzyściom biznesowym, wyzwaniom związanym z wdrożeniem oraz decyzjom, które należy podjąć przed rozpoczęciem projektu.

Czym jest hurtownia danych dotyczących opieki zdrowotnej?

​ magazyn danych dotyczących opieki zdrowotnej stanowi centralne środowisko, w którym dane pochodzące z różnych systemów opieki zdrowotnej są oczyszczane, ujednolicanie i przygotowywane do celów sprawozdawczych i analitycznych. Umożliwia ono łączenie danych z elektronicznej dokumentacji medycznej (EHR) i elektronicznej kartoteki medycznej (EMR) z danymi dotyczącymi rozliczeń, wynikami badań laboratoryjnych, danymi z portalu pacjenta, zapisami z systemów ERP lub CRM oraz danymi z podłączonych urządzeń.

Operacyjna baza danych zazwyczaj obsługuje jedną aplikację i jej bieżącą działalność. Magazyn danych (DWH) jest przeznaczony do analiz wymagających danych z kilku systemów jednocześnie. Jeśli na przykład szpital chce ustalić, dlaczego rośnie liczba ponownych hospitalizacji, analitycy mogą porównać diagnozy i historię leczenia z danymi rozliczeniowymi, wynikami badań laboratoryjnych oraz danymi kadrowymi, zamiast pobierać każdy zbiór danych osobno.

W przeciwieństwie do hurtowni danych (DWH), jezioro danych zazwyczaj przechowuje dane, zanim zostaną one ustrukturyzowane pod kątem konkretnego zastosowania analitycznego. Może ono pomieścić duże ilości danych surowych lub w niewielkim stopniu przetworzonych, w różnych formatach. Natomiast hurtownia danych zawiera dane przygotowane do wykorzystania przez zespoły w ramach BI, w cyklicznych raportach oraz w bieżącej analizie.

Baza danych operacyjnaData warehouseJezioro danych
Główny celPrzeprowadzanie codziennych transakcji w aplikacjiZgromadź dane z kilku systemów w formie umożliwiającej zespołom sporządzanie raportów i przeprowadzanie analizPrzechowuj duże ilości różnego rodzaju danych do wykorzystania w przyszłości
Źródła danychDane tworzone i wykorzystywane przez aplikacje operacyjneDane pochodzące z elektronicznej dokumentacji medycznej (EHR), systemów rozliczeniowych, systemów ERP, CRM oraz innych systemów biznesowych lub klinicznychDane pochodzące z wielu źródeł, w tym dane ustrukturyzowane, częściowo ustrukturyzowane i nieustrukturyzowane
W jaki sposób przechowywane są daneZorganizowane z uwzględnieniem potrzeb aplikacjiOczyszczone i uporządkowane pod kątem potrzeb w zakresie sprawozdawczości i analizCzęsto zachowuje się jego pierwotną formę i dostosowuje się strukturę, gdy wymaga tego konkretny przypadek zastosowania
Typowe zastosowania w służbie zdrowiaTransakcje związane z elektroniczną dokumentacją medyczną (EHR), wizyty lub działania w ramach systemu CRMRaportowanie między systemami, BI i analityka w służbie zdrowiaZbiory danych o dużej skali, analizy eksploracyjne lub zadania związane z uczeniem masowym

Architektura hurtowni danych w służbie zdrowia

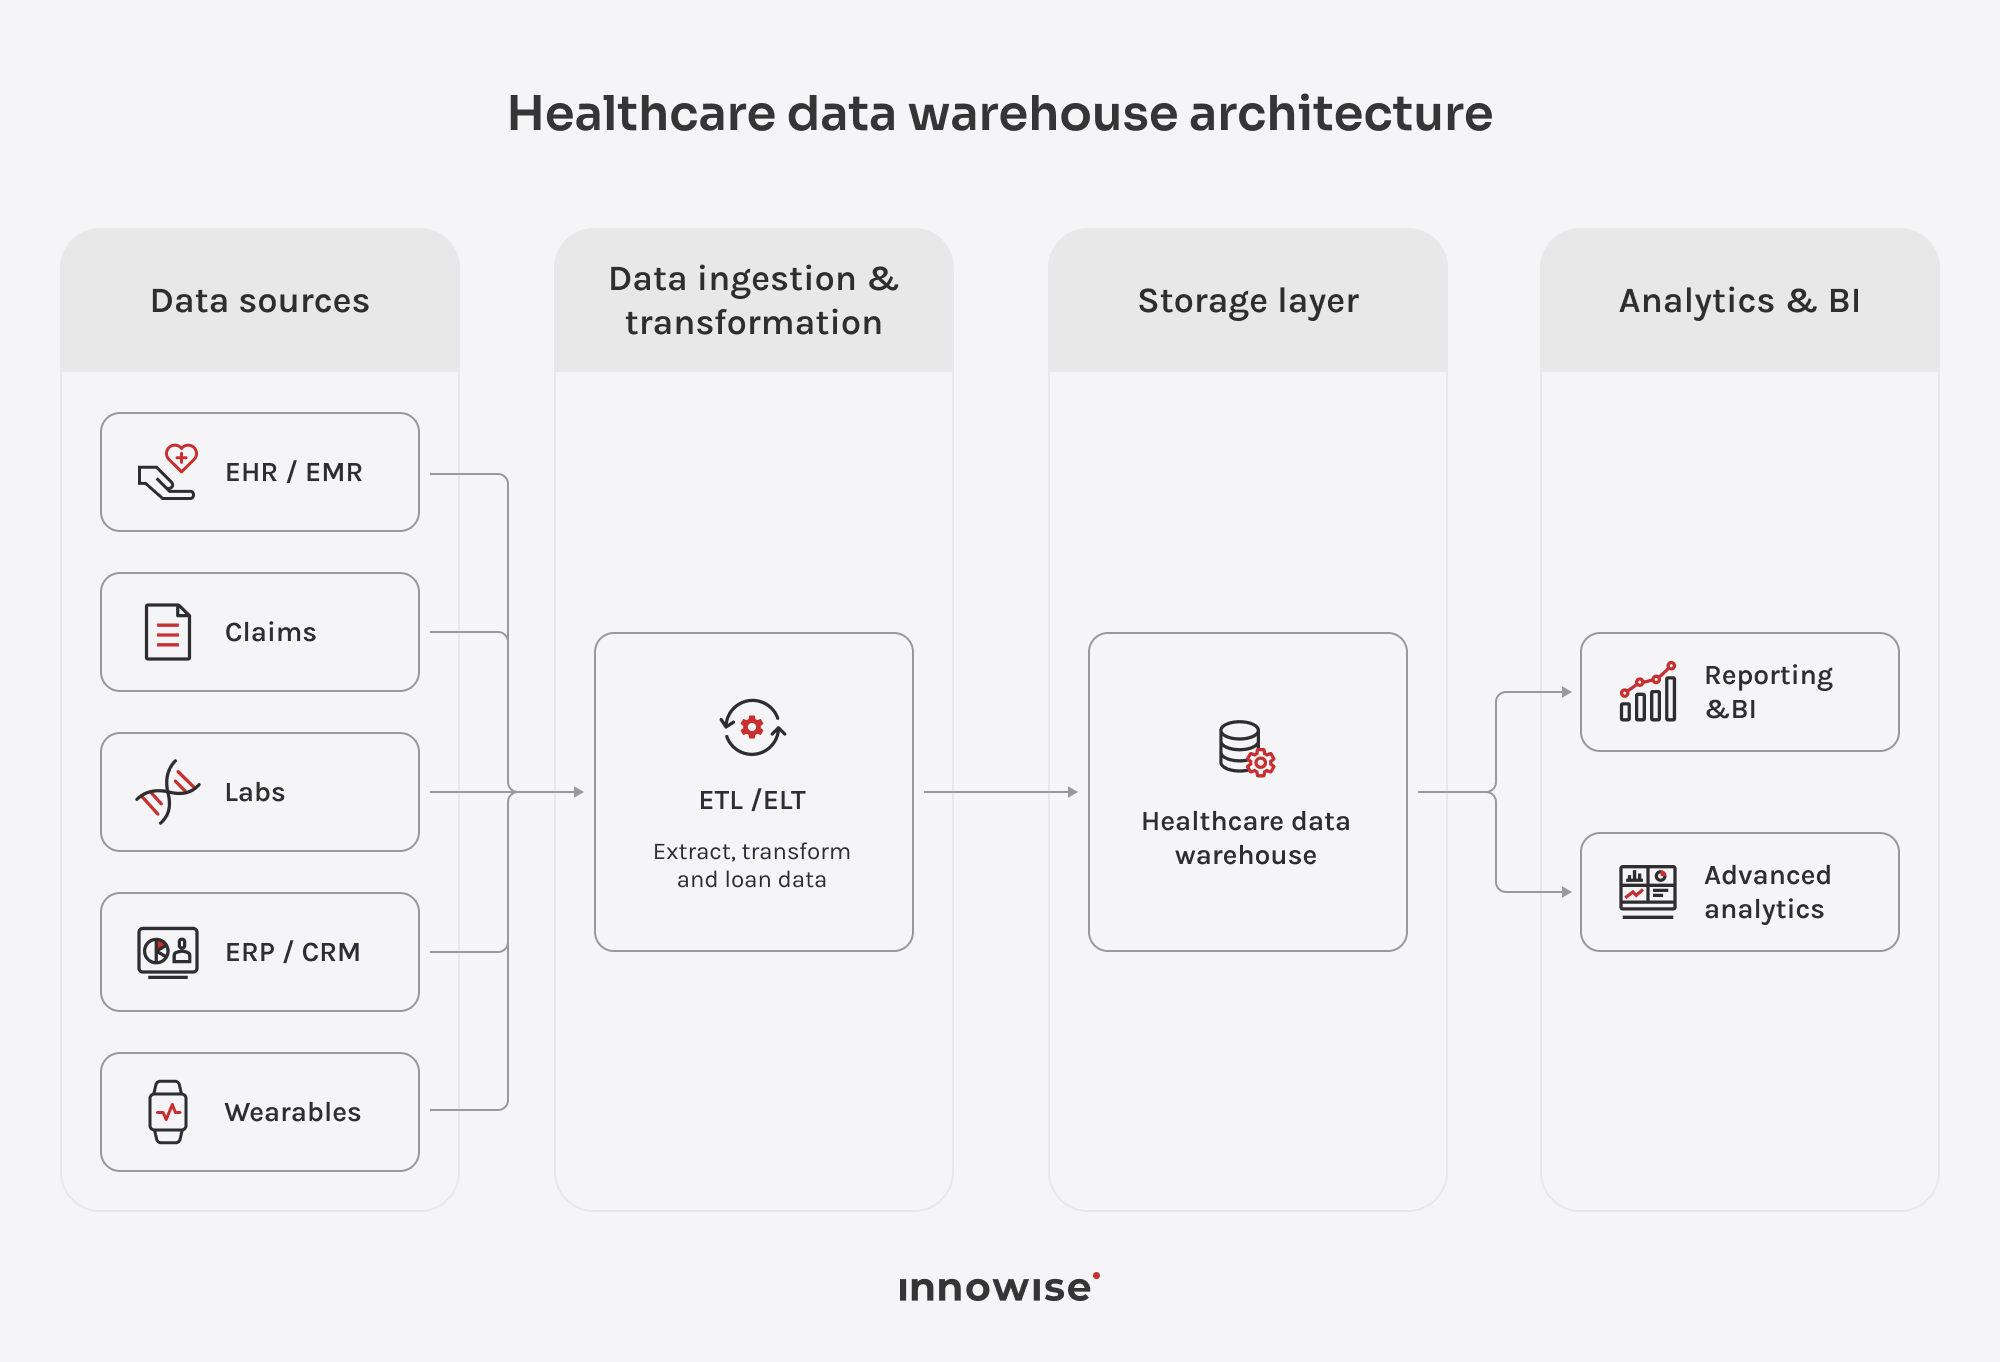
Aby lepiej zrozumieć, jak działa hurtownia danych medycznych, przyjrzyjmy się jej głównym warstwom. Każda z nich pełni określoną rolę w przenoszeniu danych z systemów źródłowych do magazynu, a następnie udostępnianiu ich na potrzeby raportowania, analiz i aplikacji.

Źródła danych

Warstwa źródłowa obejmuje systemy wykorzystywane już w pracy klinicznej i biznesowej, takie jak systemy EHR i EMR, platformy rozliczeniowe, systemy LIS i RIS/PACS oraz oprogramowanie ERP lub CRM. Ten sam pacjent lub zdarzenie mogą być rejestrowane w różny sposób w poszczególnych systemach, dlatego przed wspólnym wykorzystaniem danych konieczne jest ujednolicenie formatów i dopasowanie identyfikatorów.

Pobieranie danych i ETL/ELT

Warstwa ta gromadzi dane źródłowe i przygotowuje je do analizy. W modelu ETL dane są przekształcane przed załadowaniem do hurtowni danych; w modelu ELT przekształcanie odbywa się po załadowaniu. Proces ten może również obejmować standaryzację formatu, usuwanie duplikatów oraz tymczasowe przechowywanie danych.

Przechowywanie

Warstwa przechowywania danych przechowuje dane historyczne w strukturze przeznaczonej do tworzenia raportów i analiz. W zależności od architektury może ona również udostępniać magazyny danych przeznaczone dla konkretnego działu lub konkretnego zastosowania.

Analityka i BI

Narzędzia BI wykorzystują dane z hurtowni do tworzenia pulpitów nawigacyjnych i raportów cyklicznych, podczas gdy analitycy mogą przeprowadzać zapytania ad hoc na tym samym zbiorze danych. Dzięki temu zespoły mają do dyspozycji wspólne źródło danych do analizy, co pozwala uniknąć konieczności odtwarzania logiki dla każdego raportu.

Zastosowania

Dane z hurtowni mogą również stanowić podstawę dla dalszych zastosowań klinicznych lub biznesowych. Na przykład narzędzia badawcze lub systemy planowania mogą wykorzystywać przygotowane dane z hurtowni zamiast łączyć się osobno z każdym systemem źródłowym.

Potrzebujesz jednego, wiarygodnego źródła informacji obejmującego dane kliniczne i biznesowe?

Najważniejsze cechy i funkcje

Skoro omówiliśmy już architekturę, przyjrzę się teraz funkcjom, które najprawdopodobniej spotkasz w hurtowni danych dla służby zdrowia. Każda organizacja jest nieco inna, ale pojawia się wiele wspólnych potrzeb, gdy konieczne jest połączenie danych z różnych systemów tak, by pozostały one przydatne do tworzenia raportów i analiz.

Integracja danych oraz ETL/ELT

Systemy opieki zdrowotnej często przechowują te same informacje w różny sposób. Elektroniczna dokumentacja medyczna (EHR), platforma rozliczeniowa lub system laboratoryjny mogą wykorzystywać różne pola i formaty dla porównywalnych rekordów. Potoki ETL i ELT gromadzą te dane i ujednolicają je w hurtowni danych na potrzeby analizy. W zależności od częstotliwości zmian danych potoki mogą działać zgodnie z harmonogramem, ładować wyłącznie nowe rekordy lub przetwarzać aktualizacje na bieżąco.

Dane dotyczące opieki zdrowotnej ulegają również zmianom z mocą wsteczną: wyniki badań laboratoryjnych są korygowane, wizyty aktualizowane lub anulowane, a rozliczenia korygowane lub unieważniane. Systemy przetwarzania danych muszą zastosować te poprawki do już załadowanych rekordów; w przeciwnym razie ponowne wygenerowanie raportu z poprzedniego miesiąca może nie być już zgodne z danymi źródłowymi.

Jakość danych i deduplikacja

Zduplikowane rekordy pacjentów i sprzeczne wartości mogą zafałszować raporty po trafieniu danych do hurtowni danych. Kontrole jakości wykrywają brakujące lub nieprawidłowe dane, natomiast reguły dopasowywania pomagają powiązać rekordy należące do tego samego pacjenta w różnych systemach. Zespoły muszą przeprowadzić takie oczyszczenie danych przed porównaniem wyników lub opracowaniem analiz.

Zarządzanie metadanymi

Metadane wyjaśniają, co oznacza każde pole i skąd pochodzi. Rejestrują również zmiany wprowadzone przed trafieniem danych do hurtowni. Analitycy mogą prześledzić pochodzenie danej wartości na pulpicie nawigacyjnym aż do jej źródła i sprawdzić, jaka definicja została zastosowana.

Ład danych

Zarządzanie danymi określa, kto jest właścicielem danych oraz jakie definicje powinni stosować wszyscy użytkownicy. Bez jasnych zasad może się zdarzyć, że dwa działy będą korzystać z tej samej bazy danych, a mimo to podawać różne wyniki dla tego samego wskaźnika. Właściciele danych i administratorzy sprawdzają wprowadzane zmiany i dbają o spójność tych definicji w czasie.

Bezpieczeństwo i kontrola dostępu

Magazyn danych w sektorze opieki zdrowotnej może zawierać dane medyczne o charakterze poufnym (PHI) oraz wrażliwe dane operacyjne lub finansowe, dlatego dostęp do nich nie może być jednakowy dla wszystkich użytkowników. Uprawnienia pozwalają ograniczyć zakres widocznych danych użytkownika w zależności od pełnionej roli, a w razie potrzeby nawet do konkretnych wierszy lub kolumn. Szyfrowanie chroni dane zarówno podczas przechowywania, jak i przesyłania, natomiast dzienniki audytowe pokazują, kto uzyskał do nich dostęp.

Obsługa danych ustrukturyzowanych i częściowo ustrukturyzowanych

Większość generowanych cyklicznie raportów wykorzystuje tabele o ustalonej strukturze, jednak systemy opieki zdrowotnej generują również dane w innych formatach. Na przykład interfejsy API i podłączone urządzenia mogą przesyłać dane w formacie JSON. Magazyn danych może przetwarzać te dane bez konieczności uprzedniego przekształcania każdego pola w tabelę o ustalonej strukturze. Pliki nieustrukturyzowane, takie jak obrazy medyczne, zazwyczaj pozostają w jeziorze danych lub magazynie obiektowym i w razie potrzeby są powiązane z danymi w magazynie danych.

Skalowalność i wydajność

Wraz ze wzrostem ilości przechowywanych danych i liczby zapytań hurtownia danych musi zapewnić szybką reakcję na zapytania. Platformy mogą wykorzystywać partycjonowanie, indeksowanie, buforowanie lub oddzielne zasoby obliczeniowe, aby obsłużyć większe obciążenia bez konieczności przebudowywania architektury hurtowni danych.

Interoperacyjność

Magazyn danych dotyczących opieki zdrowotnej musi wymieniać dane z systemami elektronicznej dokumentacji medycznej (EHR), systemami laboratoryjnymi i innymi platformami klinicznymi. Standardy HL7, takie jak FHIR i HL7 v2, zapewniają zespołom wspólne formaty tej wymiany, co ogranicza konieczność tworzenia niestandardowych mapowań. Systemy starszego typu lub zastrzeżone mogą nadal wymagać niestandardowych łączników, zanim magazyn danych będzie mógł wykorzystać ich dane.

W przypadku projektów z branży opieki zdrowotnej nie analizowałbym wyników ani kosztów w oderwaniu od siebie. Magazyn danych (DWH) pozwala porównać takie wskaźniki, jak długość pobytu w szpitalu i ponowne przyjęcia, z wykorzystaniem zasobów i czasem pracy personelu. Ma to znaczenie w opiece opartej na wartości, gdzie trzeba zrozumieć zarówno wynik, jak i to, co było potrzebne, aby go osiągnąć.
Philip Tikhanovich, Head of Big Data.
Philip Tikhanovich
Kierownik Działu Big Data

Integracja hurtowni danych dotyczących opieki zdrowotnej

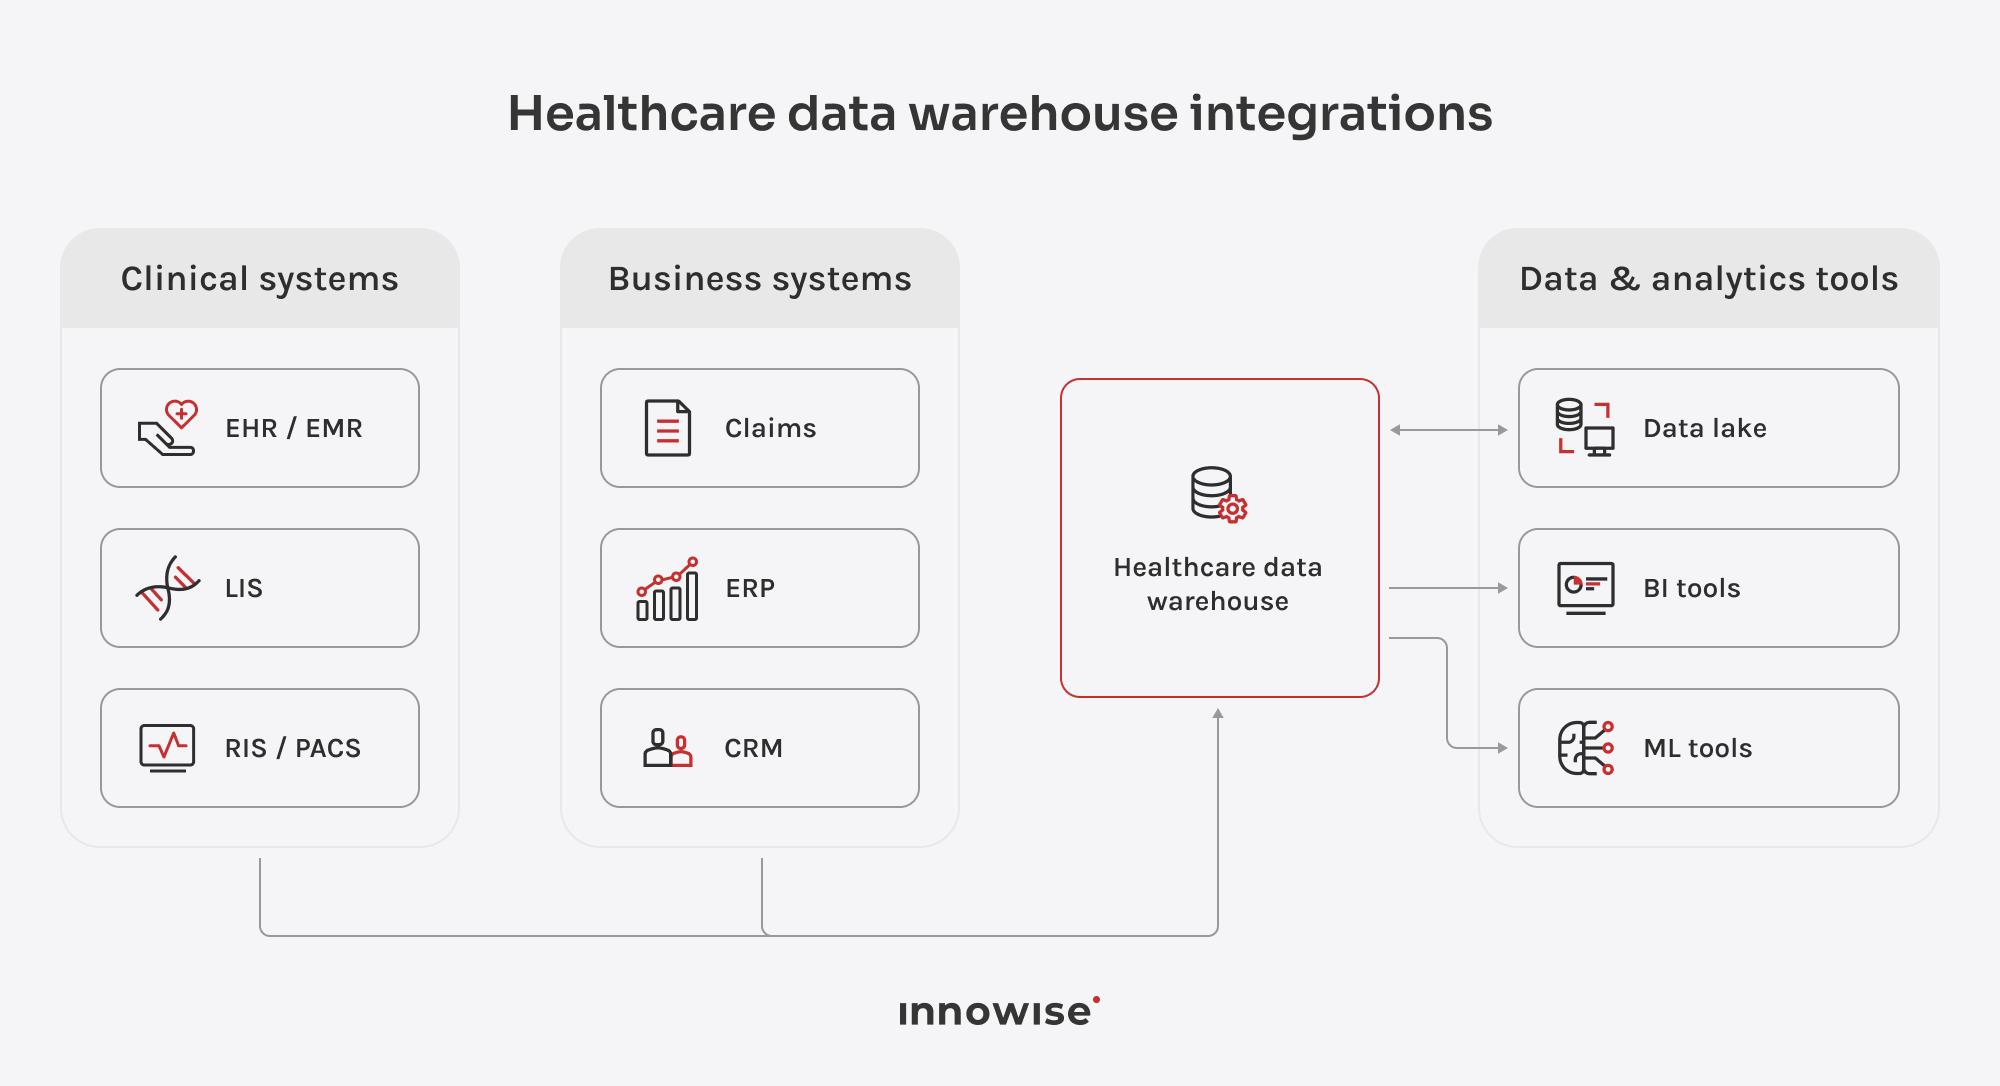
Jeśli tworzysz hurtownię danych klinicznych w sektorze opieki zdrowotnej, zazwyczaj łączysz systemy, z których Twoje zespoły korzystają na co dzień. Najczęściej spotykane integracje polegają na pobieraniu danych z systemów klinicznych i biznesowych oraz udostępnianiu ich narzędziom BI i ML.

Systemy kliniczne

Systemy EHR i EMR zazwyczaj przesyłają ustrukturyzowane dane kliniczne za pośrednictwem interfejsów API FHIR lub kanałów HL7 v2. FHIR sprawdza się dobrze w przypadku zasobów takich jak „Pacjent” i „Wizyta”, natomiast HL7 v2 pozostaje powszechnie stosowanym standardem w odniesieniu do zdarzeń szpitalnych i wyników badań laboratoryjnych. Systemy LIS często wykorzystują komunikaty HL7 v2 ORU do przesyłania wyników badań do magazynu danych.

Radiologia działa inaczej, ponieważ dane obrazowe są zazwyczaj przechowywane poza samym magazynem. Obrazy są przechowywane w systemie PACS lub w magazynie obiektowym, natomiast w magazynie przechowywane są metadane dotyczące raportów i badań wraz z odnośnikami do odpowiednich plików DICOM.

Systemy biznesowe

Systemy rozliczeń pokazują, jakie kwoty wystawili usługodawcy i jakie kwoty zwrócili płatnicy. W Stanach Zjednoczonych dane te są często wymieniane za pośrednictwem transakcji X12, w tym plików rozliczeniowych 837 i plików przelewowych 835. Przechowywanie danych zarówno na poziomie rozliczeń, jak i na poziomie poszczególnych pozycji pozwala analitykom porównać całkowite koszty z poszczególnymi usługami, które się na nie składają.

Systemy ERP dostarczają dane dotyczące kosztów i personelu, natomiast systemy CRM rejestrują kontakty z pacjentami wykraczające poza zakres dokumentacji medycznej. Gdy zespoły łączą te informacje z danymi klinicznymi, mogą badać takie kwestie, jak to, czy przypomnienia o wizytach zwiększają frekwencję lub czy poziom zatrudnienia jest dostosowany do aktywności klinicznej.

Dane i analityka

W jeziorze danych przechowywane są dane surowe lub mniej ustrukturyzowane, zanim zespoły przygotują je do umieszczenia w hurtowni. Wybrane zbiory danych można oczyścić w jeziorze, a następnie załadować do hurtowni. W niektórych konfiguracjach hurtownia pobiera dane bezpośrednio z jeziora, zamiast najpierw je kopiować.

Narzędzia BI, takie jak Power BI czy Tableau, łączą się z hurtownią danych za pomocą natywnych łączników lub protokołów ODBC/JDBC i odczytują przygotowane dane. Platformy uczenia maszynowego wykorzystują historyczne dane z hurtowni do szkolenia modeli lub oceny, a następnie wysyłają wyniki modeli, takie jak oceny ryzyka, z powrotem do hurtowni w celu wykorzystania w raportach lub innych aplikacjach.

Korzyści biznesowe

Jeśli rozważasz opłacalność wdrożenia hurtowni danych w służbie zdrowia, warto przyjrzeć się, jakie zmiany przyniesie to zespołom korzystającym z tych danych. Wymienione poniżej korzyści płynące z wdrożenia korporacyjnej hurtowni danych w służbie zdrowia to obszary, w których wpływ ten zazwyczaj ujawnia się najwyraźniej.

Szybsze raportowanie

Zamiast pobierać dane z wielu systemów i ręcznie je uzgadniać, zespoły mogą pracować z danymi już przygotowanymi w hurtowni danych. Tworzenie cyklicznych raportów wymaga mniejszego nakładu pracy, a analitycy mogą poświęcić więcej czasu na analizę danych, a nie na ich gromadzenie.

Ujednolicony widok pacjenta

Dane kliniczne, dotyczące roszczeń oraz inne dane związane z pacjentem można powiązać między różnymi systemami źródłowymi, co zapewnia zespołom szerszy wgląd w historię pacjenta. Ułatwia to śledzenie przebiegu opieki podczas kolejnych wizyt bez konieczności przełączania się między oddzielnymi dokumentacjami.

Lepsze decyzje kliniczne

Lekarze i analitycy mogą korzystać z danych historycznych pochodzących z całej organizacji, odpowiadając na pytania, które wymagają uwzględnienia więcej niż jednego systemu. Ten szerszy kontekst stanowi podstawę decyzji dotyczących schematów leczenia, ryzyka dla pacjentów oraz jakości opieki.

Optymalizacja kosztów i zasobów

Powiązanie działalności klinicznej z danymi finansowymi lub operacyjnymi pomaga szpitalom zorientować się, na co przeznaczane są zasoby. Zespoły mogą porównać wielkość świadczonych usług z poziomem zatrudnienia lub kosztami, a uzyskane wyniki wykorzystać przy planowaniu zdolności operacyjnych.

Lepsza analiza roszczeń

Gdy dane dotyczące roszczeń i dane kliniczne znajdą się w tej samej bazie danych, analitycy mogą porównać usługi rozliczone z opieką medyczną udokumentowaną przez lekarzy. Mogą zbadać, dlaczego ubezpieczyciele odrzucili roszczenia lub wypłacili zbyt niskie kwoty, a także wykryć powtarzające się problemy związane z rozliczeniami.

Analityka predykcyjna

Ponieważ baza danych przechowuje dane historyczne w jednym miejscu, zespoły mogą je wykorzystać do oszacowania prawdopodobnego dalszego rozwoju sytuacji. Model może wskazać pacjentów o podwyższonym ryzyku ponownej hospitalizacji lub przewidzieć okresy zwiększonego zapotrzebowania. Dzięki temu zespoły medyczne i operacyjne mogą wcześniej zaplanować dalszą opiekę lub obsadę personelu.

Wsparcie badawcze

Naukowcy często potrzebują danych dotyczących wielu pacjentów z długich okresów. Magazyn danych zapewnia im dane gotowe do analizy kohortowej lub badań retrospektywnych bez konieczności każdorazowego ponownego tworzenia zbioru danych z oddzielnych systemów.

Analiza opieki opartej na wartościach

W opiece opartej na wartościach zespoły muszą wiedzieć, czy wykorzystywane przez nie zasoby faktycznie przekładają się na lepsze wyniki. Gdy system magazynowy łączy wyniki z danymi dotyczącymi wykorzystania zasobów, analitycy mogą porównywać grupy pacjentów i sprawdzać, czy wyższe wydatki lub intensywniejsze korzystanie z usług prowadzą do lepszych wyników opieki.

Typowe wyzwania związane z hurtownią danych w służbie zdrowia

Korzyści, o których wspomniałem powyżej, wiążą się z kilkoma wyzwaniami wdrożeniowymi, ale znacznie łatwiej sobie z nimi poradzić, jeśli zaplanuje się je z wyprzedzeniem. Doświadczony zespół potrafi dostrzec wiele zagrożeń, zanim przerodzą się one w konieczność ponownej pracy lub problemy z raportowaniem. Oto te kwestie, na które zwracałbym uwagę od samego początku.

Rozdrobnione dane i interoperacyjność

Jeden system może identyfikować pacjenta na podstawie numeru karty medycznej, podczas gdy inny wykorzystuje inny identyfikator. Różnić się mogą również formaty danych. Zespoły muszą prawidłowo przyporządkować te różnice i aktualizować te przyporządkowania za każdym razem, gdy zmienia się system źródłowy.

Niska jakość danych

Magazyn przejmuje problemy od systemów, z których czerpie dane. Brakujące wartości lub niespójne kody mogą powodować, że raporty będą niewiarygodne, a także wpłynąć na późniejsze analizy. Zespoły muszą wykryć te problemy, zanim inne raporty lub modele zaczną opierać się na tych samych danych.

Zduplikowane dane pacjentów

Ten sam pacjent może pojawić się więcej niż raz, jeśli systemy wykorzystują różne identyfikatory lub zawierają nieznacznie różniące się dane osobowe. Reguły dopasowywania muszą wykrywać takie duplikaty, nie łącząc przy tym przypadkowo rekordów dotyczących różnych osób.

Bezpieczeństwo i prywatność

Magazyn danych służby zdrowia może zawierać dokumentację pacjentów oraz dane finansowe i operacyjne, ale nie każdy użytkownik powinien mieć wgląd we wszystkie informacje. Pracownicy medyczni mogą potrzebować szczegółowych danych dotyczących poszczególnych pacjentów, podczas gdy zespoły finansowe mogą potrzebować jedynie danych rozliczeniowych. Należy ustalać uprawnienia dostępu w zależności od roli i weryfikować je przy każdym dodaniu nowego źródła danych.

Zarządzanie

Zespoły potrzebują jasnych zasad określających, kto jest właścicielem wspólnych danych i kto podejmuje decyzje dotyczące tych danych. Na przykład, jeśli dwa działy obliczają ten sam wskaźnik na różne sposoby, ktoś musi wybrać definicję, z której będą korzystać wszyscy. To samo dotyczy zatwierdzania dostępu do danych wrażliwych.

Skalowanie objętości danych

W miarę jak w magazynie danych gromadzi się coraz więcej danych z kolejnych lat i dodawane są nowe źródła, zapytania mogą działać wolniej, a koszty przechowywania mogą wzrosnąć. Zespoły muszą zaplanować, w jaki sposób będą porządkować starsze dane i jak długo będą je przechowywać, aby wzrost ilości danych nie utrudniał codziennego sporządzania raportów.

Brak wewnętrznej wiedzy specjalistycznej w zakresie inżynierii danych

Być może Państwa zespół dobrze zna systemy opieki zdrowotnej, ale ma ograniczone doświadczenie w tworzeniu hurtowni danych w oparciu o te systemy. W takim przypadku zewnętrzni inżynierowie danych mogą pomóc w zaprojektowaniu potoków danych i modelu danych, podczas gdy Państwa wewnętrzny zespół określi, jakie potrzeby muszą zaspokajać te dane.

Modele hurtowni danych dotyczących opieki zdrowotnej

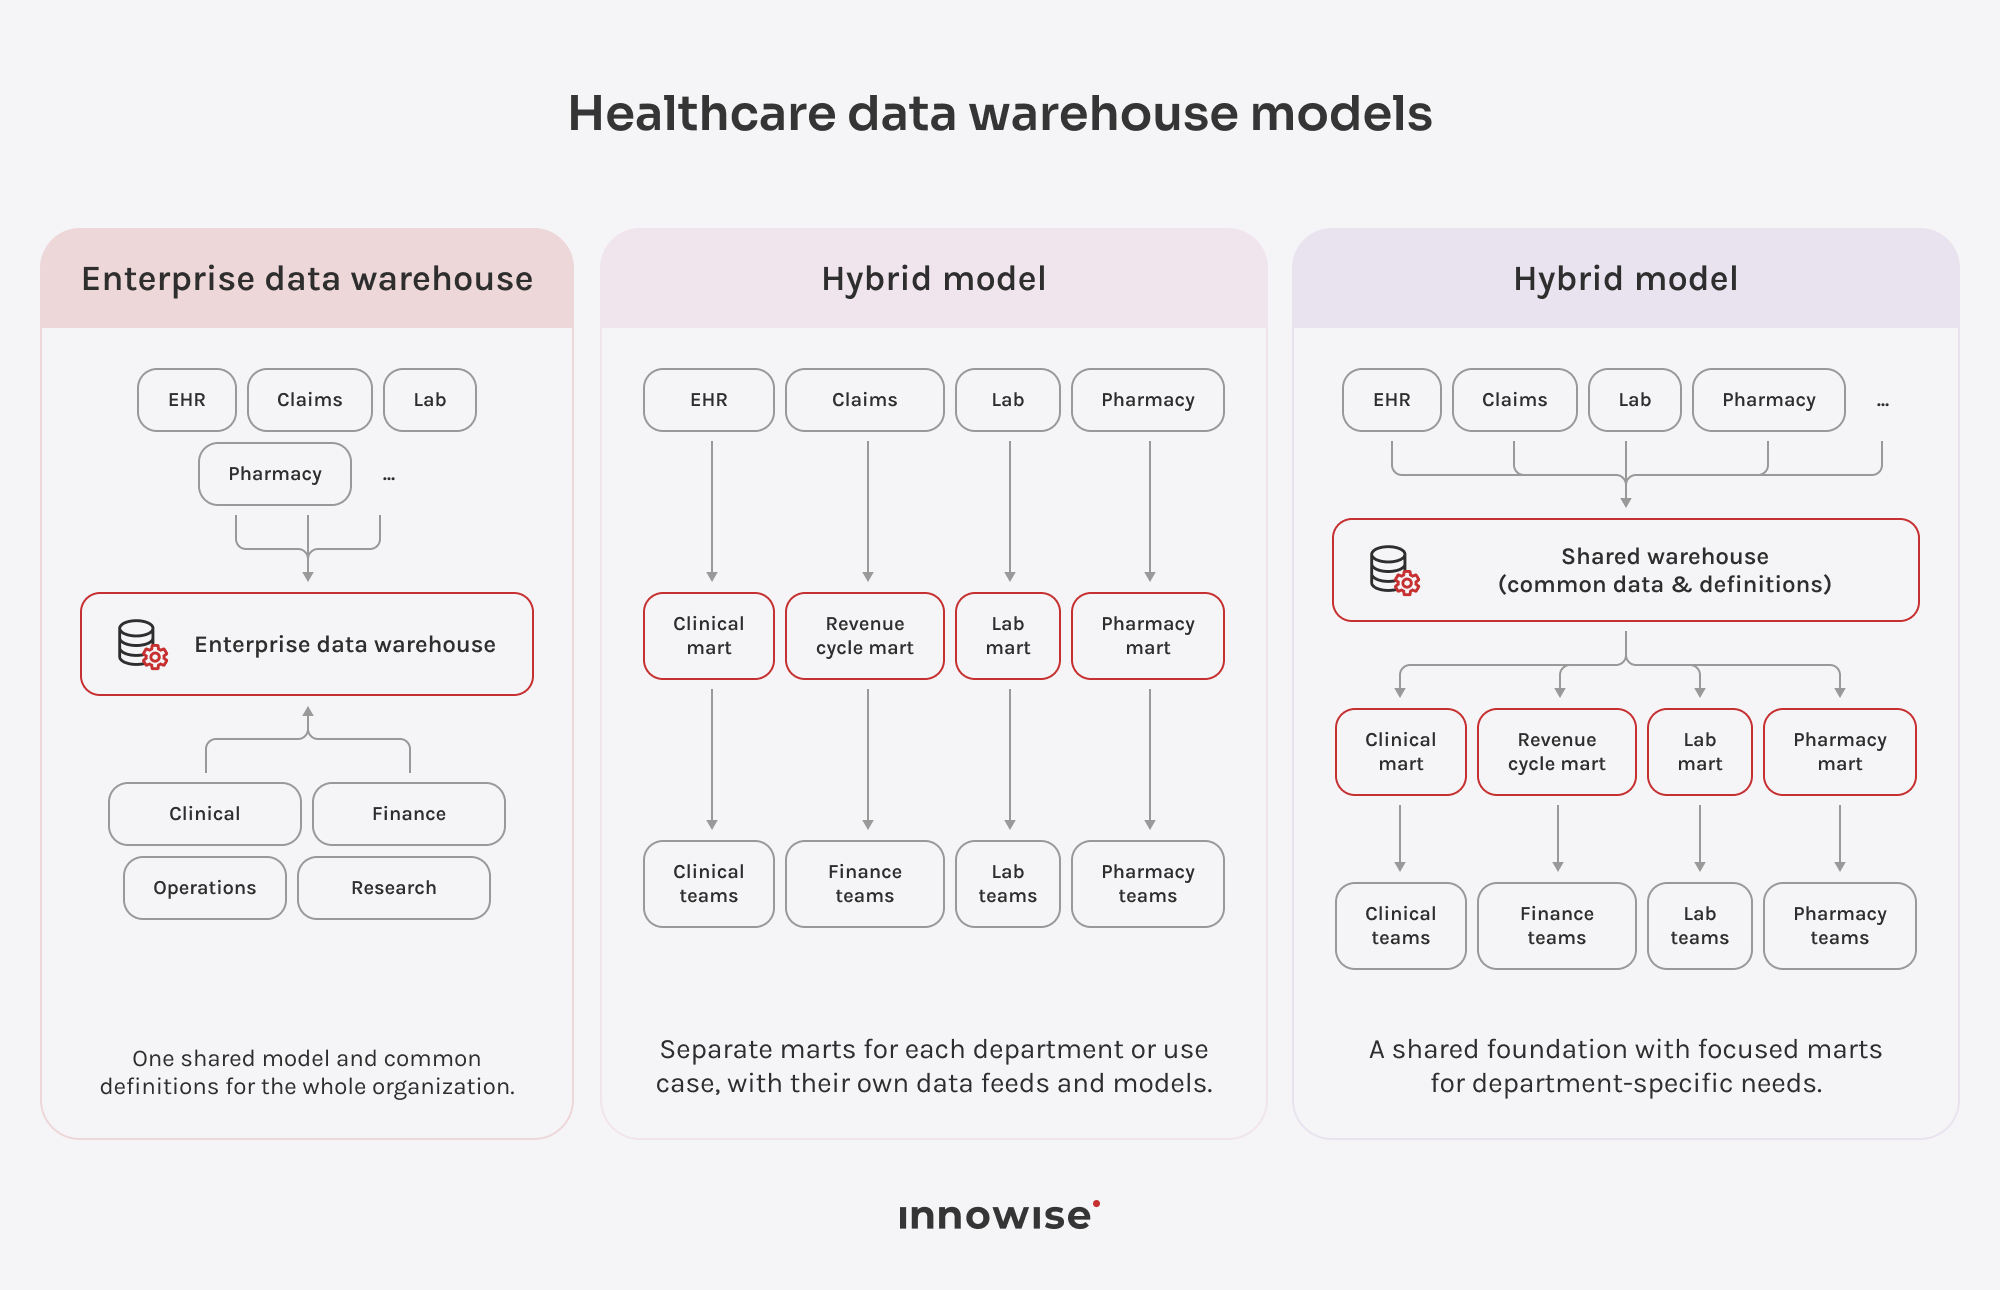
Wybór odpowiedniego modelu hurtowni danych dotyczących opieki zdrowotnej zależy od tego, w jakim stopniu chcesz scentralizować zarządzanie danymi oraz jak dużą niezależność potrzebują poszczególne działy. W praktyce organizacje zazwyczaj wybierają jeden z trzech modeli:

Korporytacyjna hurtownia danych

Korporacyjna hurtownia danych w sektorze opieki zdrowotnej wykorzystuje wspólny model danych obowiązujący w całej organizacji, dzięki czemu różne działy pracują w oparciu o spójne definicje i zasady sporządzania raportów. Na przykład zespoły kliniczne i finansowe mogą obliczać średnią długość pobytu w ten sam sposób, zamiast definiować ten wskaźnik osobno w swoich własnych raportach.

Na poziomie danych zespoły mogą ujednolicić podstawowe jednostki, takie jak pacjenci, wizyty, świadczeniodawcy i placówki, oraz przyporządkować rekordy z systemów źródłowych do tych wspólnych struktur. Wymaga to jednak wczesnego uzgodnienia tych definicji i utrzymywania ich spójności w miarę rozbudowy hurtowni danych. Wiąże się to z większym nakładem pracy na początku, zwłaszcza w dużych organizacjach, gdzie terminologia i wymagania sprawozdawcze ulegają ciągłym zmianom. Gdy wiele raportów opiera się na wspólnym modelu, nawet niewielka zmiana w jednej z podstawowych definicji może wpłynąć jednocześnie na kilka zespołów.

Niezależne magazyny danych

Niezależny magazyn danych skupia się na jednym dziale lub konkretnym przypadku analitycznym, a nie na modelowaniu danych dla całej organizacji. Na przykład zespół onkologiczny może stworzyć magazyn danych w oparciu o potrzebne mu systemy kliniczne, podczas gdy analitycy zajmujący się cyklem przychodów tworzą inny magazyn danych, skupiający się na danych dotyczących roszczeń i rozliczeń.

Ponieważ każdy magazyn danych ma węższy zakres, zespoły często mogą szybciej uruchomić pierwsze raporty. W miarę dodawania kolejnych magazynów danych ten sam system źródłowy może wymagać oddzielnych potoków danych i mapowań dla każdego z nich. Definicje mogą się również różnić w poszczególnych działach. A ponieważ magazyny danych często przechowują dane już przygotowane lub zagregowane pod kątem konkretnego zastosowania, mogą nie zawierać szczegółów niezbędnych do przeprowadzenia innej analizy w późniejszym terminie.

Model hybrydowy

Model hybrydowy łączy wspólną hurtownię danych przedsiębiorstwa z magazynami danych stworzonymi dla poszczególnych działów lub na potrzeby analiz. Dane podstawowe i wspólne definicje pozostają w warstwie centralnej, podczas gdy każdy magazyn danych dostosowuje te dane do własnych potrzeb sprawozdawczych. Ponieważ magazyny danych czerpią dane z hurtowni, zespoły nie muszą tworzyć oddzielnych integracji z każdym systemem źródłowym.

Takie rozwiązanie pozwala organizacjom dodawać nowe hurtownie danych w miarę zmian potrzeb w zakresie raportowania, bez konieczności modelowania na samym początku wszystkich przyszłych przypadków użycia. Trudniejsze jest podjęcie decyzji, co należy ujednolicić na poziomie centralnym, a co może pozostać specyficzne dla danej hurtowni danych. Jeśli zbyt wiele logiki zostanie przeniesione do poszczególnych hurtowni danych, definicje mogą z czasem ulegać rozbieżnościom.

Planujesz stworzyć hurtownię danych dla służby zdrowia i rozważasz różne opcje?

Przykłady zastosowań hurtowni danych w służbie zdrowia

Organizacje opieki zdrowotnej wykorzystują hurtownie danych do bardzo różnych zadań, w zależności od gromadzonych danych i decyzji, które muszą podejmować. Poniższe przykłady hurtowni danych w służbie zdrowia pokazują, jak wygląda to w praktyce w pracy klinicznej i operacyjnej.

Zarządzanie zdrowiem populacji

Zespoły ds. zdrowia populacji wykorzystują dane z bazy danych do wyszukiwania grup pacjentów o podobnych potrzebach w zakresie opieki. Mogą na przykład zidentyfikować osoby, które mają zaległe badania przesiewowe lub wizyty kontrolne, a następnie przekazać te listy zespołom terenowym.

Zarządzanie chorobami przewlekłymi

W przypadku chorób przewlekłych zespoły opieki muszą mieć wgląd w zmiany zachodzące między wizytami. Baza danych może gromadzić wyniki badań laboratoryjnych i historię przyjmowanych leków z poszczególnych wizyt, a także odczyty z podłączonych urządzeń, o ile są dostępne. Ta zbiorcza historia pomaga zespołom dostrzec zmiany w stanie pacjenta i zdecydować, kiedy może być konieczna wcześniejsza wizyta kontrolna.

Analiza predykcyjna ryzyka u pacjentów

Zespoły wykorzystują historyczne dane z hurtowni danych do oszacowania, którzy pacjenci są bardziej narażeni na ponowną hospitalizację lub niepojawienie się na wizycie. Wyniki te są zazwyczaj przekazywane lekarzom za pośrednictwem systemu zarządzania opieką lub systemu kontaktów z pacjentami. Zapisanie ich z powrotem w samej elektronicznej dokumentacji medycznej (EHR) wymaga zazwyczaj osobnej integracji: dostawcy systemów EHR zazwyczaj ściśle kontrolują uprawnienia do zapisu.

Badania i ścieżki kliniczne

Poszukiwanie odpowiednich uczestników badania często rozpoczyna się od sporządzenia długiej listy kryteriów włączenia i wyłączenia. Badacze mogą najpierw zastosować te kryteria do zanonimizowanych danych z bazy, aby zawęzić grupę potencjalnych uczestników przed przejrzeniem poszczególnych kart pacjentów. W przypadku badań prowadzonych w wielu ośrodkach zespoły mogą również przed analizą uporządkować dane z różnych placówek w ramach wspólnej struktury.

Cykl rozliczeniowy i analiza roszczeń

Problemy z płatnościami mogą pojawić się w dowolnym momencie między pierwotnym obciążeniem a ostatecznym zwrotem kosztów. Dzięki połączeniu danych klinicznych, rozliczeniowych i dotyczących wniosków o zwrot kosztów zespoły ds. przychodów mogą sprawdzić, na którym etapie wniosek utknął oraz czy ta sama przyczyna odmowy powtarza się w przypadku konkretnego płatnika lub zabiegu.

Planowanie kadrowe i planowanie zdolności produkcyjnych

Kierownicy porównują liczbę pacjentów w poszczególnych oddziałach i na poszczególnych zmianach z liczbą pracowników zaplanowanych do pracy w tym samym czasie. Jeśli w danym oddziale w niektórych dniach lub w okresach szczytowego obciążenia wielokrotnie brakuje personelu, mogą dostosować przyszłe harmonogramy pracy, uwzględniając tę tendencję.

Optymalizacja kosztów operacyjnych

Gdy dane finansowe są powiązane z działalnością kliniczną, zespoły mogą sprawdzić, skąd faktycznie pochodzą koszty operacyjne. Mogą porównać wydatki w podziale na zabiegi, placówki lub rodzaje opieki oraz zbadać, dlaczego w niektórych obszarach koszty są wyższe niż w innych.

Proces wdrażania

Każdy projekt dotyczący hurtowni danych w służbie zdrowia rozpoczyna się inaczej. Poszczególne etapy zależą od istniejących systemów, jakości danych oraz tego, jakie funkcje ma pełnić hurtownia. Oto, jak zazwyczaj podchodzimy do tego zadania.

01
Discovery

Nasz zespół określa wstępne scenariusze zastosowań związanych z raportowaniem lub analizą dla pierwszej wersji oraz identyfikuje osoby, które będą z nich korzystać. Przed podjęciem decyzji dotyczących architektury ustalamy również, które systemy źródłowe wchodzą w zakres projektu, oraz wskazujemy ograniczenia regulacyjne.

02
Ocena danych

Zanim stworzymy potoki danych, sprawdzamy każde źródło pod kątem brakujących danych i niespójnych formatów, a następnie szukamy duplikatów. Wyniki tej analizy wskazują, które dane można pozostawić bez zmian, a gdzie konieczne jest zastosowanie reguł oczyszczania, zanim problemy te wpłyną na raportowanie produkcyjne.

03
Architektura

Nasi architekci danych dobierają model hurtowni danych w oparciu o to, w jakim zakresie zespoły muszą udostępniać sobie dane i definicje. Następnie projektują warstwy pozyskiwania i przechowywania danych w oparciu o systemy organizacji oraz ustalają, w jaki sposób narzędzia analityczne będą uzyskiwać dostęp do hurtowni danych.

04
Wybór technologii

Po ustaleniu architektury zespół wybiera platformę, podejście ETL/ELT oraz narzędzia BI lub ML w oparciu o objętość danych i istniejący stos technologiczny. Kwestie budżetowe i związane z zgodnością z przepisami zawężają listę opcji, zwłaszcza w przypadkach, gdy wymagane są mechanizmy kontroli dostępu lub rejestrowanie audytowe.

05
Integracja

Inżynierowie danych łączą hurtownię danych z systemami źródłowymi. W zależności od środowiska mogą korzystać z FHIR lub HL7 v2 w przypadku danych klinicznych, X12 w przypadku roszczeń ubezpieczeniowych w USA oraz interfejsów API lub natywnych łączników w przypadku aplikacji biznesowych. Testowanie każdego strumienia danych przy użyciu rzeczywistych danych pomaga wcześnie wykrywać błędy mapowania.

06
Tworzenie

Inżynierowie Innowise tworzą potoki danych, które standaryzują formaty i eliminują zduplikowane rekordy przed zastosowaniem uzgodnionych definicji biznesowych. Jeśli projekt obejmuje hurtownie danych, tworzą je na warstwie współdzielonej, zamiast ponownie łączyć się z każdym źródłem.

07
Migracja i testowanie

Zespół wczytuje dane historyczne i porównuje je z oryginalnymi źródłami, aby wykryć brakujące lub zmienione wartości. Następnie analitycy testują raporty pod kątem przypadków użycia zdefiniowanych na etapie analizy, a użytkownicy biznesowi sprawdzają wyniki przed uruchomieniem systemu.

08
Uruchomienie

W momencie uruchomienia nasz zespół często generuje równolegle stare i nowe raporty, aby użytkownicy mogli porównać wyniki przed przejściem na nową wersję. Uważnie obserwujemy również wczesne etapy wdrożenia w środowisku produkcyjnym, ponieważ właśnie tam często ujawniają się problemy związane z danymi lub wydajnością, które umknęły podczas testów.

09
Wsparcie

Po uruchomieniu systemu monitorujemy jego wydajność, dodajemy nowe źródła danych oraz dbamy o procesy zarządzania, które zapewniają spójność wspólnych definicji. Zazwyczaj jest to jeden z najdłuższych etapów projektu i jeden z tych, które najłatwiej jest nie docenić na etapie planowania.

arrow-icon. arrow-icon.
01 Discovery

Nasz zespół określa wstępne scenariusze zastosowań związanych z raportowaniem lub analizą dla pierwszej wersji oraz identyfikuje osoby, które będą z nich korzystać. Przed podjęciem decyzji dotyczących architektury ustalamy również, które systemy źródłowe wchodzą w zakres projektu, oraz wskazujemy ograniczenia regulacyjne.

arrow-icon. arrow-icon.
02 Ocena danych

Zanim stworzymy potoki danych, sprawdzamy każde źródło pod kątem brakujących danych i niespójnych formatów, a następnie szukamy duplikatów. Wyniki tej analizy wskazują, które dane można pozostawić bez zmian, a gdzie konieczne jest zastosowanie reguł oczyszczania, zanim problemy te wpłyną na raportowanie produkcyjne.

arrow-icon. arrow-icon.
03 Architektura

Nasi architekci danych dobierają model hurtowni danych w oparciu o to, w jakim zakresie zespoły muszą udostępniać sobie dane i definicje. Następnie projektują warstwy pozyskiwania i przechowywania danych w oparciu o systemy organizacji oraz ustalają, w jaki sposób narzędzia analityczne będą uzyskiwać dostęp do hurtowni danych.

arrow-icon. arrow-icon.
04 Wybór technologii

Po ustaleniu architektury zespół wybiera platformę, podejście ETL/ELT oraz narzędzia BI lub ML w oparciu o objętość danych i istniejący stos technologiczny. Kwestie budżetowe i związane z zgodnością z przepisami zawężają listę opcji, zwłaszcza w przypadkach, gdy wymagane są mechanizmy kontroli dostępu lub rejestrowanie audytowe.

arrow-icon. arrow-icon.
05 Integracja

Inżynierowie danych łączą hurtownię danych z systemami źródłowymi. W zależności od środowiska mogą korzystać z FHIR lub HL7 v2 w przypadku danych klinicznych, X12 w przypadku roszczeń ubezpieczeniowych w USA oraz interfejsów API lub natywnych łączników w przypadku aplikacji biznesowych. Testowanie każdego strumienia danych przy użyciu rzeczywistych danych pomaga wcześnie wykrywać błędy mapowania.

arrow-icon. arrow-icon.
06 Tworzenie

Inżynierowie Innowise tworzą potoki danych, które standaryzują formaty i eliminują zduplikowane rekordy przed zastosowaniem uzgodnionych definicji biznesowych. Jeśli projekt obejmuje hurtownie danych, tworzą je na warstwie współdzielonej, zamiast ponownie łączyć się z każdym źródłem.

arrow-icon. arrow-icon.
07 Migracja i testowanie

Zespół wczytuje dane historyczne i porównuje je z oryginalnymi źródłami, aby wykryć brakujące lub zmienione wartości. Następnie analitycy testują raporty pod kątem przypadków użycia zdefiniowanych na etapie analizy, a użytkownicy biznesowi sprawdzają wyniki przed uruchomieniem systemu.

arrow-icon. arrow-icon.
08 Uruchomienie

W momencie uruchomienia nasz zespół często generuje równolegle stare i nowe raporty, aby użytkownicy mogli porównać wyniki przed przejściem na nową wersję. Uważnie obserwujemy również wczesne etapy wdrożenia w środowisku produkcyjnym, ponieważ właśnie tam często ujawniają się problemy związane z danymi lub wydajnością, które umknęły podczas testów.

arrow-icon. arrow-icon.
09 Wsparcie

Po uruchomieniu systemu monitorujemy jego wydajność, dodajemy nowe źródła danych oraz dbamy o procesy zarządzania, które zapewniają spójność wspólnych definicji. Zazwyczaj jest to jeden z najdłuższych etapów projektu i jeden z tych, które najłatwiej jest nie docenić na etapie planowania.

Usługi w zakresie hurtowni danych dotyczących opieki zdrowotnej

Jeśli tworzysz hurtownię danych dla sektora opieki zdrowotnej od podstaw, będziesz potrzebować innego wsparcia niż w przypadku modernizacji lub rozbudowy istniejącej hurtowni. Firma Innowise może dołączyć do projektu na każdym z tych etapów i podjąć się zadań wymaganych przy wdrażaniu Twojego rozwiązania.

  • Doradztwo w zakresie hurtowni danych dotyczących opieki zdrowotnej
  • Architektura i projektowanie
  • Tworzenie hurtowni danych
  • Integracja i migracja danych
  • Modernizacja istniejącej hurtowni danych (DWH)
  • Integracja systemów BI i analityki
  • Wsparcie i optymalizacja

Doradztwo w zakresie hurtowni danych dotyczących opieki zdrowotnej

Jeśli masz już problemy z raportowaniem lub dysponujesz magazynem, który nie spełnia już swoich zadań, ustalamy, co należy zmienić. Nasz zespół analizuje obecną konfigurację i porównuje dostępne opcje. Na tej podstawie pomagamy Ci zdecydować, które scenariusze zastosowań powinny być traktowane priorytetowo.

Nurse reviews lab results and medication history in EHR system before patient rounds.

Architektura i projektowanie

Po uzgodnieniu wymagań nasi architekci projektują strukturę magazynu danych dostosowaną do Państwa systemów i przewidywanych obciążeń. Określają oni, w jaki sposób główne komponenty są ze sobą połączone oraz gdzie przechowywane są dane wspólne. Struktura ta może następnie dostosowywać się do nowych źródeł danych lub pojawiających się potrzeb w zakresie raportowania.

Building layouts and style guides for a new web application project.

Tworzenie hurtowni danych

Po zatwierdzeniu projektu nasi inżynierowie tworzą hurtownię danych (DWH), w tym logikę transformacji oraz wszelkie niezbędne magazyny danych (data marts). Na etapie tworzenia wprowadzają mechanizmy kontroli jakości i zabezpieczenia, dzięki czemu hurtownia danych będzie w stanie obsługiwać raporty i analizy wymagane w ramach projektu.

IT specialist analyzing software code during an evening sprint session.

Integracja i migracja danych

Łączymy magazyn danych z systemami EHR/EMR, rozliczeniami, laboratorium, ERP/CRM oraz innymi systemami źródłowymi. Dane historyczne są następnie przenoszone do modelu docelowego wraz z niezbędnymi mapowaniami i przekształceniami. Przed przełączeniem systemów przeprowadzane są kontrole uzgodnienia, w ramach których migrowane dane są porównywane z danymi źródłowymi.

Data engineer interacts with a visual dashboard to orchestrate real-time data synchronization across systems.

Modernizacja istniejącej hurtowni danych (DWH)

W miarę jak zmieniają się źródła danych i wymagania dotyczące raportowania, istniejąca hurtownia danych może wymagać czegoś więcej niż tylko rutynowej konserwacji. Aktualizujemy przestarzałe modele danych i potoki danych, przenosimy obciążenia, gdy obecna platforma staje się ograniczeniem, oraz automatyzujemy powtarzalne zadania związane z zarządzaniem danymi tam, gdzie ma to sens.

IT operations team tracks software patch rollout in real time via a mobile device interface.

Integracja systemów BI i analityki

Nasi eksperci integrują hurtownię danych z narzędziami BI i analitycznymi, z których już korzystają Państwa zespoły. W zależności od konfiguracji mogą oni importować dane lub bezpośrednio wysyłać zapytania do hurtowni. Wspólne wskaźniki i reguły raportowania są przechowywane w jednym miejscu, dzięki czemu nie trzeba ich odtwarzać na każdym pulpicie nawigacyjnym.

Accessing a centralized analytics portal to evaluate company operations and outcomes.

Wsparcie i optymalizacja

Po uruchomieniu system magazynowania danych na bieżąco dostosowuje się do zmian w danych i potrzebach w zakresie raportowania. Nasz zespół może rozwiązywać problemy związane z potokami danych lub samymi danymi, dodawać nowe źródła, optymalizować powolne zapytania oraz aktualizować modele w miarę zmian wymagań biznesowych.

The consulting team reviews analytics on screen, focusing on data-driven IT strategy and solutions.
Doradztwo w zakresie hurtowni danych dotyczących opieki zdrowotnej

Jeśli masz już problemy z raportowaniem lub dysponujesz magazynem, który nie spełnia już swoich zadań, ustalamy, co należy zmienić. Nasz zespół analizuje obecną konfigurację i porównuje dostępne opcje. Na tej podstawie pomagamy Ci zdecydować, które scenariusze zastosowań powinny być traktowane priorytetowo.

Nurse reviews lab results and medication history in EHR system before patient rounds.
Architektura i projektowanie

Po uzgodnieniu wymagań nasi architekci projektują strukturę magazynu danych dostosowaną do Państwa systemów i przewidywanych obciążeń. Określają oni, w jaki sposób główne komponenty są ze sobą połączone oraz gdzie przechowywane są dane wspólne. Struktura ta może następnie dostosowywać się do nowych źródeł danych lub pojawiających się potrzeb w zakresie raportowania.

Building layouts and style guides for a new web application project.
Tworzenie hurtowni danych

Po zatwierdzeniu projektu nasi inżynierowie tworzą hurtownię danych (DWH), w tym logikę transformacji oraz wszelkie niezbędne magazyny danych (data marts). Na etapie tworzenia wprowadzają mechanizmy kontroli jakości i zabezpieczenia, dzięki czemu hurtownia danych będzie w stanie obsługiwać raporty i analizy wymagane w ramach projektu.

IT specialist analyzing software code during an evening sprint session.
Integracja i migracja danych

Łączymy magazyn danych z systemami EHR/EMR, rozliczeniami, laboratorium, ERP/CRM oraz innymi systemami źródłowymi. Dane historyczne są następnie przenoszone do modelu docelowego wraz z niezbędnymi mapowaniami i przekształceniami. Przed przełączeniem systemów przeprowadzane są kontrole uzgodnienia, w ramach których migrowane dane są porównywane z danymi źródłowymi.

Data engineer interacts with a visual dashboard to orchestrate real-time data synchronization across systems.
Modernizacja istniejącej hurtowni danych (DWH)

W miarę jak zmieniają się źródła danych i wymagania dotyczące raportowania, istniejąca hurtownia danych może wymagać czegoś więcej niż tylko rutynowej konserwacji. Aktualizujemy przestarzałe modele danych i potoki danych, przenosimy obciążenia, gdy obecna platforma staje się ograniczeniem, oraz automatyzujemy powtarzalne zadania związane z zarządzaniem danymi tam, gdzie ma to sens.

IT operations team tracks software patch rollout in real time via a mobile device interface.
Integracja systemów BI i analityki

Nasi eksperci integrują hurtownię danych z narzędziami BI i analitycznymi, z których już korzystają Państwa zespoły. W zależności od konfiguracji mogą oni importować dane lub bezpośrednio wysyłać zapytania do hurtowni. Wspólne wskaźniki i reguły raportowania są przechowywane w jednym miejscu, dzięki czemu nie trzeba ich odtwarzać na każdym pulpicie nawigacyjnym.

Accessing a centralized analytics portal to evaluate company operations and outcomes.
Wsparcie i optymalizacja

Po uruchomieniu system magazynowania danych na bieżąco dostosowuje się do zmian w danych i potrzebach w zakresie raportowania. Nasz zespół może rozwiązywać problemy związane z potokami danych lub samymi danymi, dodawać nowe źródła, optymalizować powolne zapytania oraz aktualizować modele w miarę zmian wymagań biznesowych.

The consulting team reviews analytics on screen, focusing on data-driven IT strategy and solutions.

Chcesz zmodernizować swoją infrastrukturę danych w służbie zdrowia?

Dostawcy hurtowni danych dotyczących opieki zdrowotnej

Jeśli rozważasz różne platformy dla magazynu branży medycznej, dobrym punktem wyjścia jest Twoje obecne środowisko chmurowe. Przedstawione poniżej opcje różnią się pod względem sposobu przetwarzania danych medycznych, a także modeli obliczeniowych i cenowych.

Amazon-Redshift-Logo (1)

Amazon Redshift

Redshift idealnie wpisuje się w sytuację, w której większość danych znajduje się już w AWS. Współpracuje z usługami S3 i AWS Glue, natomiast HealthLake może eksportować dane FHIR do S3 w celu dalszej analizy za pomocą Redshift lub innych usług analitycznych AWS.

Kluczowe funkcje

  • SQL dla danych ustrukturyzowanych i częściowo ustrukturyzowanych
  • Dostęp do S3 za pośrednictwem Redshift Spectrum
  • Zapytania federacyjne do obsługiwanych baz danych AWS
  • Kontrola dostępu na poziomie wierszy i kolumn
  • Oddzielne zasoby obliczeniowe i zarządzana pamięć masowa
  • Usługa AWS zgodna z HIPAA 

Cena

  • Ceny na żądanie dla przydzielonych klastrów
  • Usługi obliczeniowe bezserwerowe rozliczane według rzeczywistego zużycia
  • Oddzielne opłaty za zarządzaną przestrzeń dyskową
  • Ceny zastrzeżone dla stałych obciążeń roboczych
Azure Synapse Analytics

Azure Synapse Analytics

Synapse sprawdza się dobrze, gdy dane i raportowanie są już obsługiwane w Azure, a zespoły korzystają z Power BI. Rozwiązanie to łączy hurtownię danych SQL i platformę Spark w jednym środowisku roboczym, oferując potoki do przesyłania danych między usługami Azure. Dane FHIR z usług Azure Health Data Services można również skopiować do Synapse w celu analizy.

Kluczowe funkcje

  • SQL dedykowany i bezserwerowy
  • Pule Apache Spark
  • Zapytania dotyczące zbioru danych Azure
  • Wbudowane potoki ETL/ELT
  • Integracje ML modeli Power BI i Azure
  • Analiza danych FHIR z wykorzystaniem usług Azure Health Data Services

Cena

  • SQL bezserwerowy rozliczany na podstawie ilości przetworzonych danych
  • Specjalna usługa SQL rozliczana na podstawie zużycia jednostek DWU
  • Opłata za usługę Spark naliczana na podstawie wykorzystania vCore
  • Opcje przedzakupowe dla obciążeń o stałym obciążeniu

Dla zespołów, które pragną większej swobody w wyborze dostawców usług w chmurze, Snowflake sprawia, że warstwa hurtowni danych jest mniej uzależniona od jednego ekosystemu. Działa na platformach AWS, Azure i Google Cloud, a oddzielne wirtualne hurtownie danych pozwalają zespołom przydzielać poszczególnym obciążeniom własne zasoby obliczeniowe.

Kluczowe funkcje

  • Opcje wdrażania w środowisku wielochmurowym
  • Niezależne zasoby obliczeniowe dla różnych obciążeń
  • Magazyny wieloklasterowe w wersji Enterprise Edition+
  • Wbudowana obsługa danych półustrukturyzowanych
  • Bezpieczna wymiana danych
  • Wsparcie PHI w ramach usługi Business Critical+

Cena

  • Kredyty obliczeniowe oparte na zużyciu
  • Oddzielne opłaty za przechowywanie
  • Pojemność na żądanie lub opłacona z góry 
  • Ceny różnią się w zależności od chmury, regionu i wersji
GCP BigQuery

Google BigQuery

BigQuery jest rozwiązaniem odpowiednim dla organizacji, które już korzystają z modelu Google Cloud lub poszukują magazynu danych bezserwerowego, bez konieczności zarządzania klastrami obliczeniowymi. Interfejs API Cloud Healthcare umożliwia eksportowanie zasobów FHIR i metadanych DICOM do BigQuery, zapewniając zespołom analitycznym dostęp do danych medycznych za pośrednictwem języka SQL.

Kluczowe funkcje

  • Bezserwerowa hurtownia danych SQL
  • Oddzielne zasoby pamięci masowej i mocy obliczeniowej
  • Wbudowane funkcje uczenia maszynowego
  • Zapytania zewnętrzne i federacyjne
  • Cloud – Integracja z interfejsem API dla sektora opieki zdrowotnej
  • Usługa BigQuery objęta umową BAA zgodną z HIPAA zawartą przez firmę Google Cloud

Cena

  • Usługi obliczeniowe na żądanie rozliczane na podstawie ilości przetworzonych danych
  • Ceny za przepustowość oparte na przedziałach czasowych
  • Koszt przechowywania rozliczany osobno
  • Dostępne zobowiązania dotyczące zarezerwowanej zdolności przesyłowej

Koszt i harmonogram

Budżety na hurtownie danych w sektorze opieki zdrowotnej mogą się różnić nawet o ponad rząd wielkości. Ograniczona produkcyjna hurtownia danych z kilkoma czystymi źródłami danych może kosztować około $60 000–$100 000 i zająć 2–4 miesiące. Wielosystemowa hurtownia danych przedsiębiorstwa, obejmująca migrację danych historycznych i kilka hurtowni danych, może kosztować od $400 000 do $1 mln lub więcej, a jej wdrożenie może trwać od 9 do 18 miesięcy lub dłużej.

Skala projektuTypowy zakresOś czasuBudżet na realizacjęBieżące koszty związane z chmurą i oprogramowaniem
Magazyn danych działu1–2 systemy źródłowe, jeden dział, ograniczona historia danych, podstawowe raporty BI2–4 miesiące$60k–$100k$1k–$5k/miesiąc
Średniej wielkości hurtownia danych dla sektora opieki zdrowotnej3–6 źródeł, wspólny model danych, migracja danych historycznych, 2–4 hurtownie danych, integracja z systemami BI5–9 miesięcy$150k–$350k$5k–$20k/miesiąc
Korporacyjna hurtownia danych (DWH) / „lakehouse”Ponad 7 źródeł, obszerne dane historyczne, wiele platform handlowych, niestandardowe integracje kliniczne, zaawansowana analityka9–18+ miesięcy$400k–$1m+$20k–$80k+ miesięcznie

Rozwiązania dla służby zdrowia dostarczane przez Innowise

Dlaczego warto nas wybrać
Projekt dotyczący hurtowni danych (DWH) w sektorze opieki zdrowotnej stanowi połączenie inżynierii danych i rozwiązań IT dla opieki zdrowotnej. Firma Innowise posiada doświadczenie w obu tych obszarach, poparte odpowiednimi certyfikatami ISO oraz współpracą z dostawcami usług chmurowych i danych wykorzystywanych w projektach związanych z hurtowniami danych.

Doświadczenie w służbie zdrowia

Mamy ponad 19 lat doświadczenia w branży opieki zdrowotnej IT, w tym w pracy z elektronicznymi kartami pacjentów (EHR), systemami laboratoryjnymi, obrazowaniem medycznym oraz platformami opieki zdrowotnej opartymi na technologii internetowej. Doświadczenie to ma kluczowe znaczenie, gdy procesy kliniczne lub standardy danych medycznych determinują projekt hurtowni danych.

Wiedza specjalistyczna w zakresie inżynierii danych

Nasze zespoły ds. danych korzystają z rozwiązań Snowflake, BigQuery, Amazon Redshift oraz Azure Synapse, a także z narzędzi ETL/ELT i narzędzi do koordynacji, które je obsługują. Oznacza to, że możemy zaprojektować hurtownię danych w oparciu o istniejącą infrastrukturę klienta, a nie o jedną preferowaną platformę.

Odpowiednie certyfikaty

Firma Innowise posiada certyfikaty ISO 9001, ISO 27001 oraz ISO 13485, obejmujące normy dotyczące jakości, bezpieczeństwa informacji oraz wyrobów medycznych.

Historia dostaw

Nasze osiągnięcia obejmują ponad 1 600 projektów w różnych branżach oraz ponad 60 rozwiązań z zakresu opieki zdrowotnej IT. Dla firmy zajmującej się medycyną precyzyjną: ulepszone potoki danych i infrastruktura AWS służy do przetwarzania danych diagnostycznych pochodzących z wielu źródeł.

Doświadczenie w zakresie bezpieczeństwa i zgodności z przepisami

Nasze zespoły ds. opieki zdrowotnej działają zgodnie z wymogami HIPAA i RODO oraz standardami wymiany danych medycznych, takimi jak HL7 v2 i FHIR. Doświadczenie to ma znaczenie w przypadku przepływu wrażliwych danych medycznych między magazynem danych a systemami klinicznymi podlegającymi regulacjom.

Partnerstwa technologiczne

Jako partner firm AWS, Microsoft, Google Cloud i Databricks, firma Innowise wnosi do projektów DWH certyfikowaną wiedzę specjalistyczną dotyczącą platform i może skorzystać ze wsparcia dostawców w przypadku pojawienia się problemów związanych z konkretną platformą.

ISO 13485 certification.
ISO 9001 certification.
ISO/IEC 27001 certification.
RODO
Select partner AWS
Google_Cloud_Partner

Podsumowując

Nie rozpoczynałbym projektu stworzenia hurtowni danych dla służby zdrowia od próby przeniesienia wszystkich zbiorów danych w jedno miejsce. Zamiast tego należy wybrać problem związany z raportowaniem lub analizą, który warto rozwiązać, i połączyć tylko te systemy, które są niezbędne do realizacji tego zadania. Na przykład można zacząć od raportowania cyklu przychodów lub analizy ponownych hospitalizacji. Gdy to już zacznie działać, można zdecydować, czego hurtownia będzie potrzebować w następnej kolejności, w oparciu o rzeczywiste zapotrzebowanie. 

Takie podejście powinno być kontynuowane w miarę rozwoju projektu. Nowe źródła lub magazyny danych należy dodawać wyłącznie wtedy, gdy istnieje ku temu wyraźny powód, zamiast próbować przygotować się na każdą możliwą przyszłą potrzebę. Ważne jest, aby w miarę rozbudowy hurtowni danych zachować spójność definicji i zasad dostępu oraz zapewnić stałą zgodność z wymogami regulacyjnymi. 

Jeśli potrzebujesz pomocy z zewnątrz, specjaliści z Centrum Innowise ds. opieki zdrowotnej i farmacji IT możemy przeprowadzić analizę Państwa istniejącej hurtowni danych lub pomóc w jej stworzeniu w oparciu o Państwa systemy opieki zdrowotnej i potrzeby w zakresie raportowania, z uwzględnieniem wymogów dotyczących zgodności danych w sektorze opieki zdrowotnej.

FAQ

Magazyn danych medycznych przechowuje dane przygotowane do celów sprawozdawczych i analitycznych. Jezioro danych zazwyczaj zawiera większe ilości danych surowych lub w niewielkim stopniu przetworzonych. W wielu architekturach jezioro danych przechowuje szersze zbiory danych, podczas gdy magazyn danych zawiera dane potrzebne zespołom do przeprowadzania cyklicznych analiz klinicznych, finansowych lub operacyjnych.
Czas realizacji zależy od zakresu projektu, systemów źródłowych oraz jakości danych. Utworzenie ukierunkowanego magazynu danych z kilkoma integracjami może zająć 2–4 miesiące. Wdrożenie większej korporacyjnej hurtowni danych dla sektora opieki zdrowotnej może potrwać 9–18 miesięcy lub dłużej, jeśli projekt obejmuje migrację danych historycznych, liczne integracje oraz kilka magazynów danych.
Wybór odpowiedniego modelu hurtowni danych dla sektora opieki zdrowotnej zależy od liczby zespołów, które potrzebują tych danych, oraz od tego, czy powinny one korzystać z tych samych definicji raportów. Model korporacyjny umożliwia tworzenie raportów w skali całej organizacji, natomiast niezależne hurtownie danych skupiają się na konkretnych działach lub przypadkach użycia. Model hybrydowy łączy wspólny rdzeń z bardziej wyspecjalizowanymi hurtowniami danych. Projekt hurtowni danych dla sektora opieki zdrowotnej powinien odzwierciedlać te przypadki użycia, które należy obsłużyć w pierwszej kolejności.

Tak. Możemy zmodernizować Państwa istniejącą hurtownię danych medycznych bez konieczności jej całkowitej wymiany. Nasz zespół przebudowuje przestarzałe potoki danych, aktualizuje modele danych, przenosi wybrane obciążenia oraz stopniowo wdraża nowsze narzędzia analityczne. Automatyzacja hurtowni danych medycznych pozwala również ograniczyć ręczne czynności związane z pozyskiwaniem danych oraz cyklicznymi kontrolami jakości danych.

Firma Innowise od samego początku projektuje hurtownię danych zgodnie z wymogami HIPAA, ograniczając dostęp do danych medycznych (PHI) w zależności od pełnionej funkcji oraz wprowadzając mechanizmy zabezpieczające w przepływie danych. Sprawdzamy również dane w trakcie ich przepływu przez hurtownię, wykrywając nieprawidłowe mapowania, zduplikowane rekordy pacjentów lub zmienione wartości, zanim wpłyną one na raportowanie.

Pokaż wszystko

Spis treści

    Skontaktuj się z nami

    Umów się na rozmowę lub wypełnij poniższy formularz, a my odezwiemy się do Ciebie po przetworzeniu Twojego zgłoszenia.

    Wyślij nam wiadomość głosową
    Załącz dokumenty
    Prześlij plik

    Można załączyć 1 plik o rozmiarze do 2 MB. Prawidłowe formaty plików: pdf, jpg, jpeg, png.

    Klikając "Wyślij", wyrażasz zgodę na przetwarzanie Twoich danych osobowych przez Innowise zgodnie z naszą Polityką prywatności w celu przekazania Ci odpowiednich informacji. Podając numer telefonu, zgadzasz się na kontakt za pośrednictwem połączeń głosowych, SMS-ów lub komunikatorów. Mogą obowiązywać opłaty za połączenia, wiadomości i transmisję danych.

    Możesz także wysłać swoje zapytanie
    na contact@innowise.com
    Co dalej?
    1

    Po otrzymaniu i przetworzeniu zgłoszenia skontaktujemy się z Tobą, aby szczegółowo opisać projekt i podpisać umowę NDA w celu zapewnienia poufności.

    2

    Po zapoznaniu się z Twoimi potrzebami i oczekiwaniami, nasz zespół opracuje projekt wraz z zakresem prac, wielkością zespołu, wymaganym czasem i szacunkowymi kosztami.

    3

    Zorganizujemy spotkanie w celu omówienia oferty i ustalenia szczegółów.

    4

    Na koniec podpiszemy umowę, błyskawicznie rozpoczynając pracę nad projektem.

    Interesują Cię inne usługi?

    arrow