Almacén de datos sanitarios: ventajas, arquitectura y casos de uso

21 de septiembre de 2026 12 min leer
Aleh Yafimau, Healthcare and MedTech Delivery Manager..
Consultor de atención sanitaria IT
Experto verificado
Todos los artículos de Innowise están escritos por autores con experiencia práctica. Entienden el tema más allá de la teoría y aportan conocimientos basados en proyectos reales.
Más de 19 años de experiencia
Experto verificado
Más de 19 años de experiencia
Aleh tiende puentes entre las necesidades clínicas y la ejecución de ingeniería. Aplica un profundo conocimiento del sector para garantizar que los sistemas MedTech no solo cumplan las normas, sino que sean lo suficientemente fiables como para tener un impacto medible en la atención sanitaria real.
Experiencia
Informática sanitaria Medtech Algoritmos
Hablemos

Principales conclusiones

  • Cuando los datos de pacientes, reclamaciones, análisis de laboratorio, finanzas y operaciones se almacenan en diferentes sistemas, la elaboración de informes suele requerir una conciliación manual de la información procedente de distintas fuentes. A halmacén de datos sanitarios combina los datos de estos sistemas para que los equipos puedan utilizarlos en la elaboración de informes y análisis.
  • Ni siquiera el almacén mejor diseñado puede compensar una mala calidad de los datos. Problemas como los registros duplicados de pacientes, los formatos inconsistentes y las definiciones contradictorias pueden hacer que los informes no sean fiables.
  • El modelo de almacén de datos define el alcance con el que se comparten los datos y las definiciones comunes. Un almacén de datos empresarial (DWH) da servicio a la elaboración de informes en toda la organización, mientras que los data marts se crean en torno a departamentos específicos o casos de uso concretos. Las arquitecturas híbridas utilizan ambos. 
  • El análisis de viabilidad debería partir de las decisiones que el almacén debe respaldar, desde la salud de la población y la evaluación de riesgos de los pacientes hasta la investigación clínica, el análisis de reclamaciones o la planificación de personal y capacidad.
Resumir artículo con IA

Si los historiales de tus pacientes, los resultados de laboratorio, las reclamaciones y los datos operativos se encuentran en distintos sistemas, obtener una respuesta fiable puede suponer más trabajo que el propio análisis. Es posible que los equipos tengan que cotejar los registros y comprobar qué significan realmente las cifras antes de poder utilizarlas. A almacén de datos sanitarios (DWH) consolida los datos de estos sistemas y los estructura para la elaboración de informes y el análisis.

En este artículo, explicaré cómo se construye un almacén de datos (DWH) para el sector sanitario y qué características son importantes en la práctica. También analizaremos los principales modelos de almacén de datos, los casos de uso habituales en el sector sanitario, las ventajas empresariales, los retos de implementación y las decisiones que hay que tomar antes de iniciar el proyecto.

¿Qué es un almacén de datos sanitarios?

Un almacén de datos sanitarios Es un entorno centralizado en el que los datos procedentes de diferentes sistemas sanitarios se depuran, armonizan y preparan para la elaboración de informes y el análisis. Permite combinar datos de historias clínicas electrónicas (EHR) y registros médicos electrónicos (EMR) con datos de reclamaciones, resultados de análisis, datos del portal del paciente, registros de sistemas ERP o CRM y datos de dispositivos conectados.

Una base de datos operativa suele dar soporte a una sola aplicación y a sus operaciones diarias. Un almacén de datos (DWH) está diseñado para responder a preguntas que requieren datos de varios sistemas a la vez. Si un hospital quiere comprender por qué están aumentando las readmisiones, por ejemplo, los analistas pueden comparar los diagnósticos y el historial de tratamientos con las reclamaciones, los resultados de laboratorio y los datos de personal, en lugar de extraer cada conjunto de datos por separado.

A diferencia de un DWH, un lago de datos suele almacenar datos antes de que se hayan estructurado para un uso analítico específico. Puede albergar grandes volúmenes de datos sin procesar o ligeramente procesados en diferentes formatos. Un DWH, en cambio, contiene datos preparados que los equipos pueden utilizar para la inteligencia empresarial (BI), informes periódicos y análisis continuos.

Base de datos operativaAlmacén de datosLago de datos
Objetivo principalEjecutar las transacciones diarias de las aplicacionesReunir datos de varios sistemas en un formato que permita a los equipos elaborar informes y analizarlosAlmacenar grandes volúmenes de datos de distintos tipos para su uso posterior
Fuentes de datosDatos creados y utilizados por aplicaciones operativasDatos procedentes de historias clínicas electrónicas (EHR), sistemas de gestión de reclamaciones, sistemas de planificación de recursos empresariales (ERP), sistemas de gestión de relaciones con los clientes (CRM) y otros sistemas empresariales o clínicosDatos procedentes de numerosas fuentes, incluidos datos estructurados, semiestructurados y no estructurados
Cómo se almacenan los datosOrganizado en función de las necesidades de la aplicaciónLimpiada y estructurada en función de las necesidades de elaboración de informes y análisisA menudo se mantiene fiel a su forma original y se estructura cuando el caso de uso así lo requiere
Uso habitual en el ámbito sanitarioTransacciones del historial clínico electrónico (EHR), citas o actividades de CRMInformes multisistema, inteligencia empresarial y análisis de datos sanitariosConjuntos de datos a gran escala, análisis exploratorios o cargas de trabajo de aprendizaje automático

Arquitectura del almacén de datos sanitarios

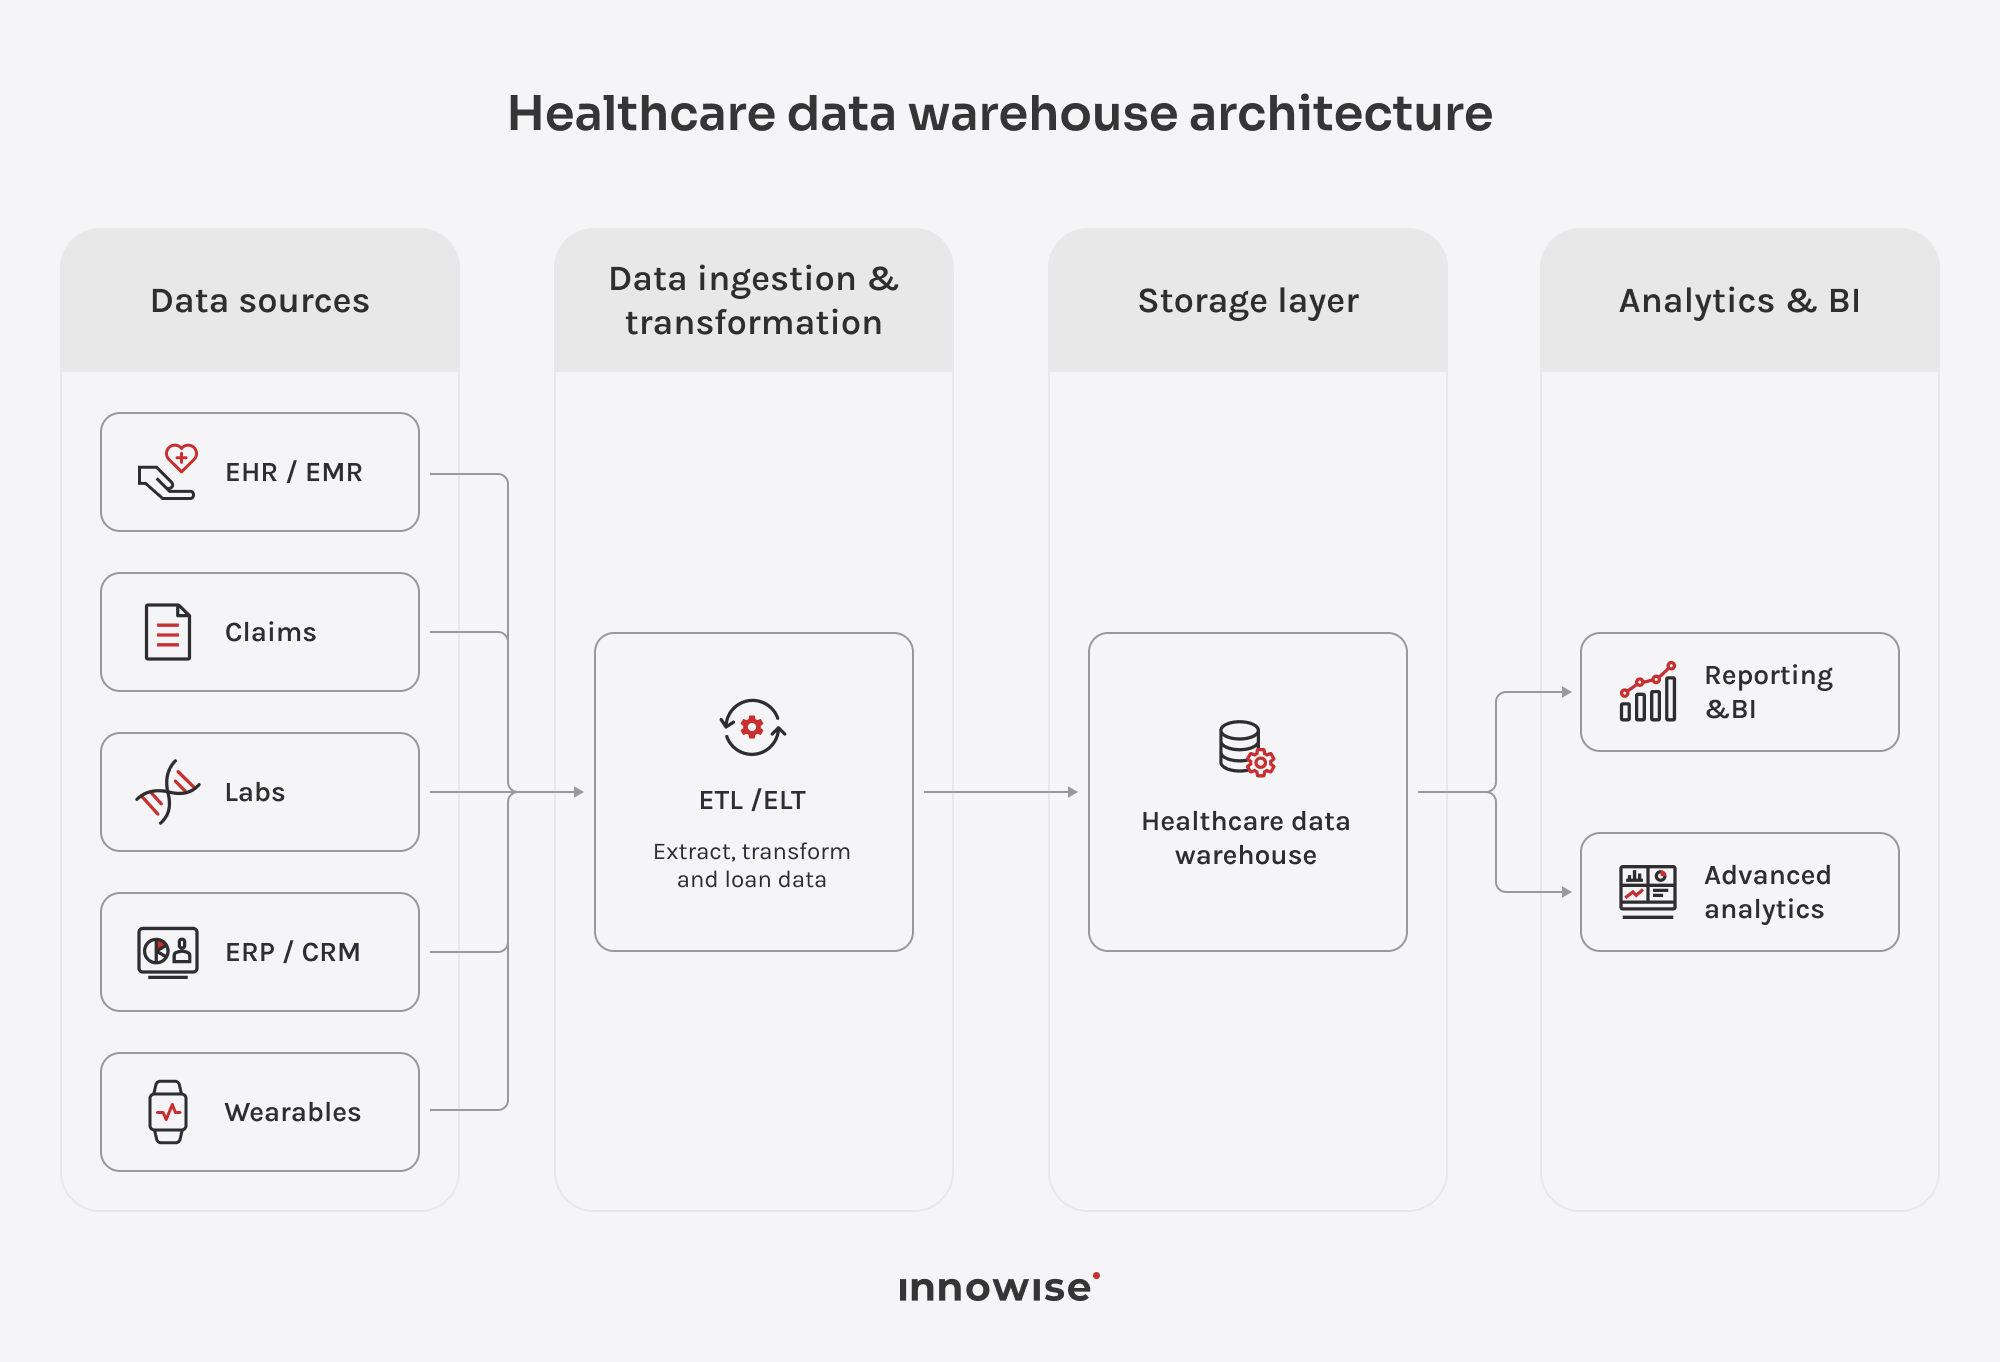
Para comprender mejor cómo funciona un almacén de datos sanitarios, veamos las principales capas que lo componen. Cada una de ellas desempeña una función específica a la hora de trasladar los datos desde los sistemas de origen al almacenamiento y, posteriormente, ponerlos a disposición para la elaboración de informes, el análisis y las aplicaciones.

Fuentes de datos

La capa de origen incluye los sistemas que ya se utilizan para las tareas clínicas y administrativas, como los historiales clínicos electrónicos (EHR y EMR), las plataformas de gestión de reclamaciones, los sistemas LIS y RIS/PACS, y el software ERP o CRM. Es posible que un mismo paciente o evento se registre de forma diferente en cada uno de estos sistemas, por lo que es necesario armonizar los formatos y hacer coincidir los identificadores antes de utilizar los datos de forma conjunta.

Ingestión y ETL/ELT

Esta capa recopila los datos de origen y los prepara para su análisis. Con el método ETL, los datos se transforman antes de cargarlos en el almacén; con el método ELT, la transformación se lleva a cabo tras la carga. El proceso también puede incluir la estandarización del formato, la eliminación de duplicados y el almacenamiento temporal.

Almacenamiento

La capa de almacenamiento conserva los datos históricos en una estructura diseñada para la elaboración de informes y el análisis. Dependiendo de la arquitectura, también puede proporcionar «data marts» para un departamento concreto o un caso de uso específico.

Análisis y BI

Las herramientas de BI utilizan los datos del almacén de datos para crear paneles de control e informes periódicos, mientras que los analistas pueden realizar consultas ad hoc sobre el mismo conjunto de datos. Esto proporciona a los equipos una fuente común para el análisis, en lugar de tener que volver a crear la lógica para cada informe.

Aplicaciones

Los datos del almacén de datos también pueden servir de base para aplicaciones clínicas o empresariales posteriores. Las herramientas de investigación o los sistemas de planificación, por ejemplo, pueden utilizar datos preparados procedentes del almacén de datos en lugar de conectarse por separado a cada sistema de origen.

¿Necesitas una visión única y fiable de los datos clínicos y empresariales?

Características y funciones principales

Ahora que ya hemos hablado de la arquitectura, voy a repasar las características que probablemente encontrarás en un almacén de datos sanitarios. Cada organización es un poco diferente, pero surgen muchas necesidades comunes cuando hay que combinar datos de distintos sistemas y garantizar que sigan siendo utilizables para la elaboración de informes y el análisis.

Integración de datos y ETL/ELT

Los sistemas sanitarios suelen almacenar la misma información de formas diferentes. Un historial clínico electrónico (EHR), una plataforma de reclamaciones o un sistema de análisis clínicos pueden utilizar campos y formatos distintos para registros comparables. Los flujos de trabajo ETL y ELT recopilan esos datos y los armonizan en el almacén de datos para su análisis. Dependiendo de la frecuencia con la que cambien los datos, los flujos de trabajo pueden ejecutarse según una programación, cargar solo los registros nuevos o procesar las actualizaciones a medida que se reciben.

Los datos sanitarios también cambian con carácter retroactivo: se corrigen los resultados de laboratorio, se actualizan o cancelan las visitas y se ajustan o anulan las reclamaciones. Los procesos automatizados deben aplicar esas modificaciones a los registros ya cargados; de lo contrario, si se vuelve a generar el informe del mes pasado, es posible que ya no coincida con la fuente.

Calidad de los datos y deduplicación

Los registros duplicados de pacientes y los valores contradictorios pueden distorsionar los informes una vez que los datos llegan al almacén de datos. Los controles de calidad detectan los datos que faltan o que son inválidos, mientras que las reglas de correspondencia ayudan a vincular los registros que pertenecen al mismo paciente en los distintos sistemas. Los equipos necesitan esta limpieza antes de comparar resultados o elaborar análisis.

Gestión de metadatos

Los metadatos explican qué significa cada campo y cuál es su origen. Además, registran los cambios realizados antes de que los datos llegaran al almacén. Los analistas pueden rastrear el origen de una cifra que aparece en un panel de control y comprobar qué definición se utilizó.

Gobernanza de datos

La gobernanza de datos define quién es el propietario de los datos y qué definiciones deben utilizar todos. Sin unas normas claras, dos departamentos pueden utilizar el mismo almacén de datos y, aun así, presentar cifras diferentes para una misma métrica. Los propietarios y los gestores de datos revisan los cambios y garantizan la coherencia de esas definiciones a lo largo del tiempo.

Seguridad y control de acceso

Un almacén de datos sanitarios puede contener información médica protegida (PHI) junto con datos operativos o financieros confidenciales, por lo que el acceso no puede ser el mismo para todos. Los permisos pueden limitar lo que ve un usuario en función de su rol y, cuando sea necesario, hasta el nivel de filas o columnas concretas. El cifrado protege los datos tanto en el almacenamiento como durante la transferencia, mientras que los registros de auditoría muestran quién ha accedido a ellos.

Compatibilidad con datos estructurados y semiestructurados

La mayoría de los informes recurrentes utilizan tablas estructuradas, pero los sistemas sanitarios también generan datos en otros formatos. Las API y los dispositivos conectados, por ejemplo, pueden enviar datos en formato JSON. Un almacén de datos puede trabajar con estos datos sin necesidad de convertir primero cada campo en una tabla fija. Los archivos no estructurados, como las imágenes médicas, suelen almacenarse en un lago de datos o en un almacenamiento de objetos y se vinculan a los datos del almacén cuando es necesario.

Escalabilidad y rendimiento

A medida que aumentan la cantidad de datos almacenados y el número de consultas, el almacén de datos debe seguir ofreciendo una respuesta ágil en la generación de informes. Las plataformas pueden utilizar la partición, la indexación, el almacenamiento en caché o recursos informáticos independientes para gestionar cargas de trabajo más grandes sin necesidad de reconstruir la arquitectura del almacén de datos.

Interoperabilidad

Un almacén de datos sanitarios debe intercambiar datos con historias clínicas electrónicas (HCE), sistemas de laboratorio y otras plataformas clínicas. Los estándares HL7, como FHIR y HL7 v2, proporcionan a los equipos formatos comunes para ese intercambio, lo que reduce la necesidad de realizar mapeos personalizados. Es posible que los sistemas heredados o propietarios sigan necesitando conectores personalizados para que el almacén pueda utilizar sus datos.

En los proyectos del sector sanitario, yo no analizaría los resultados ni los costes de forma aislada. Un almacén de datos (DWH) permite comparar aspectos como la duración de la estancia y las readmisiones con el uso de recursos y el tiempo dedicado por el personal. Esto es importante en la atención sanitaria basada en el valor, en la que es necesario comprender tanto el resultado como lo que se ha necesitado para alcanzarlo.
Philip Tikhanovich, Head of Big Data.
Philip Tikhanovich
Responsable de Big Data

Integraciones de almacenes de datos sanitarios

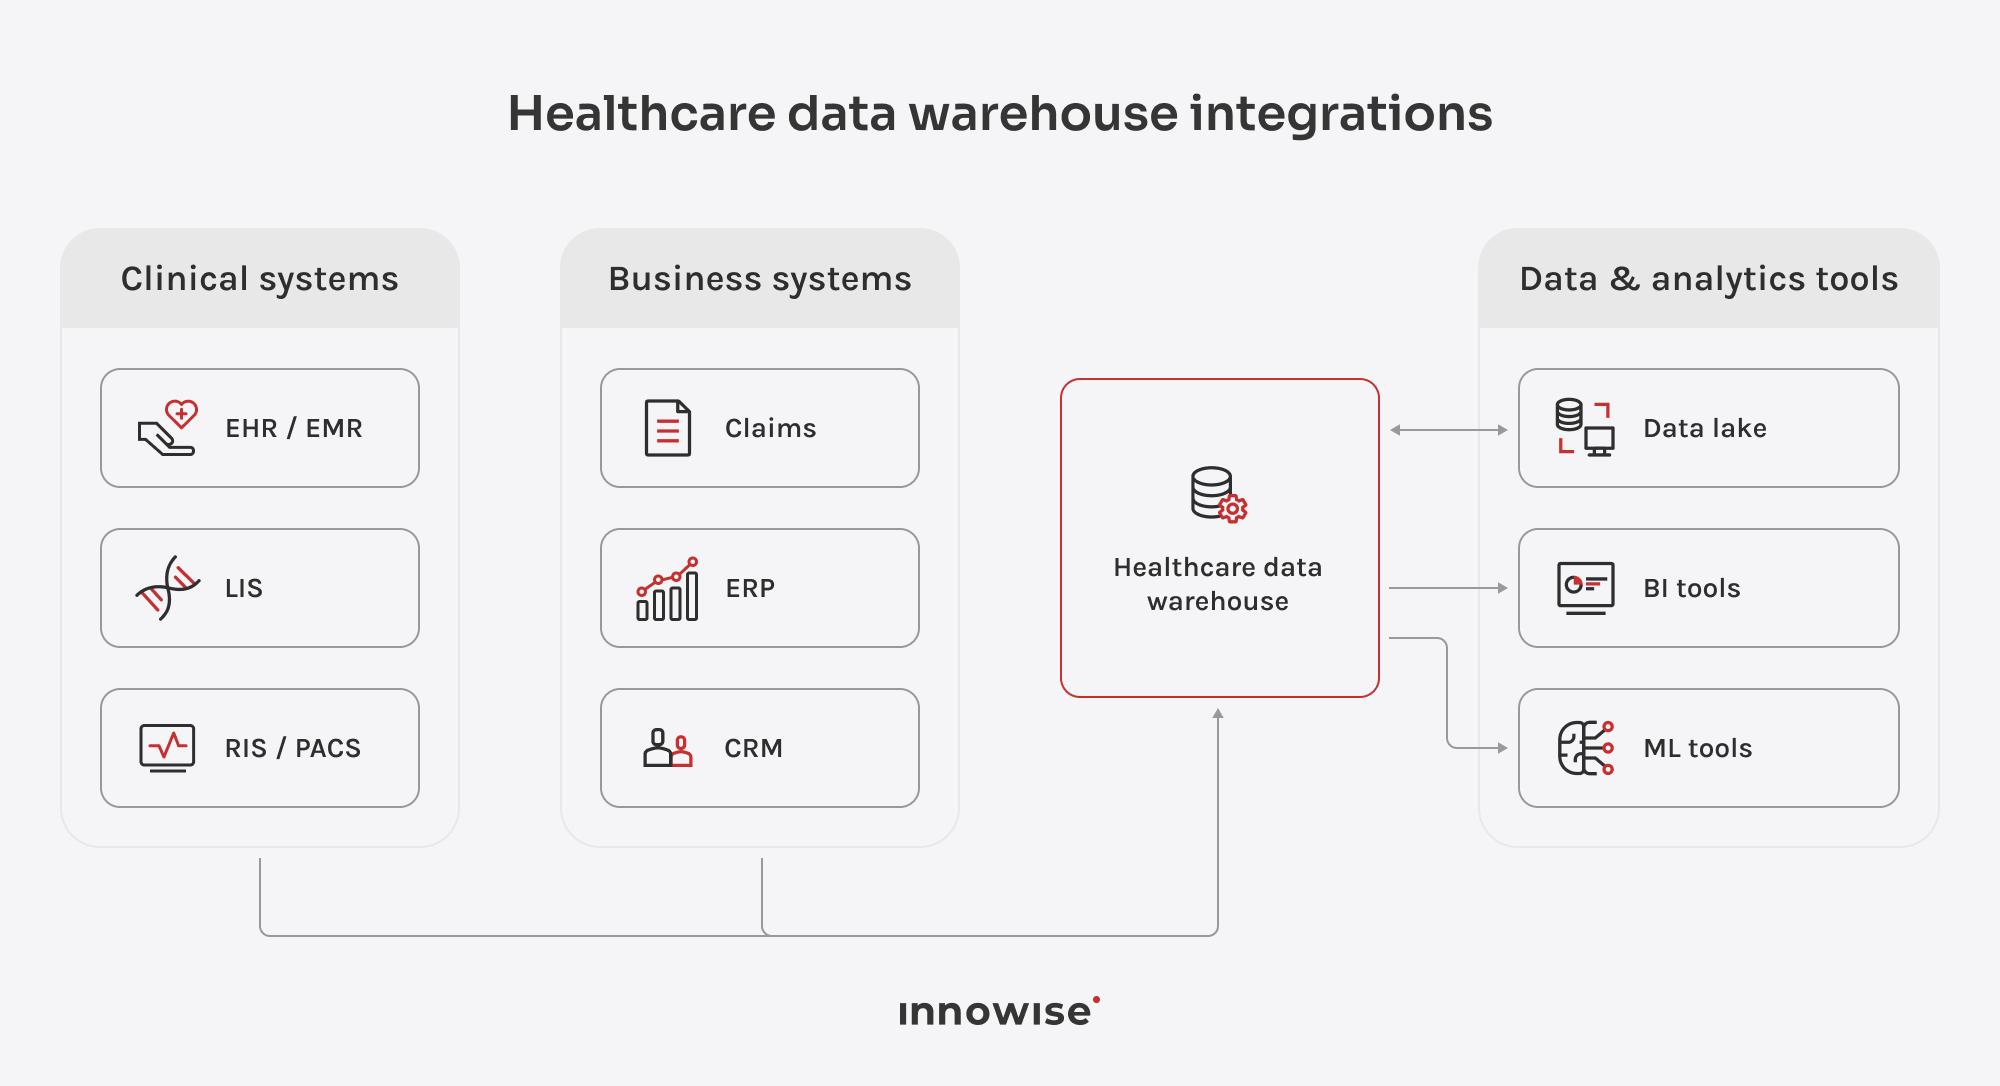
Si estás creando un almacén de datos clínicos en el sector sanitario, lo habitual es conectar los sistemas que tus equipos ya utilizan a diario. Las integraciones más habituales recogen datos de sistemas clínicos y empresariales y los ponen a disposición de las herramientas de BI y ML.

Sistemas clínicos

Los sistemas de historias clínicas electrónicas (EHR) y registros médicos electrónicos (EMR) suelen enviar datos clínicos estructurados a través de las API de FHIR o de fuentes de datos HL7 v2. FHIR funciona bien para recursos como «Paciente» y «Consulta», mientras que HL7 v2 sigue siendo habitual para eventos hospitalarios y resultados de laboratorio. Los sistemas LIS suelen utilizar mensajes ORU de HL7 v2 para enviar los resultados de las pruebas al almacén de datos.

La radiología funciona de forma diferente, ya que los datos de imágenes suelen almacenarse fuera del propio almacén. El PACS o el almacenamiento de objetos se encarga de guardar las imágenes, mientras que el almacén guarda el informe y los metadatos del estudio con enlaces a los archivos DICOM correspondientes.

Sistemas empresariales

Los sistemas de reclamaciones muestran lo que han facturado los proveedores y lo que han reembolsado las entidades pagadoras. En EE. UU., suelen intercambiar datos a través de transacciones X12, entre las que se incluyen los archivos de reclamaciones 837 y los de liquidación 835. El hecho de conservar tanto los datos a nivel de reclamación como a nivel de línea permite a los analistas comparar los costes totales con los servicios concretos que los componen.

Los sistemas ERP proporcionan datos sobre costes y personal, mientras que los sistemas CRM recogen información sobre la interacción con los pacientes fuera de la historia clínica. Cuando los equipos combinan esa información con los datos clínicos, pueden analizar cuestiones como si los recordatorios de citas mejoran la asistencia o si la dotación de personal se ajusta a la actividad clínica.

Datos y análisis

Un lago de datos almacena datos sin procesar o menos estructurados antes de que los equipos los preparen para el almacén de datos. Los conjuntos de datos seleccionados pueden depurarse en el lago y, a continuación, cargarse en el almacén de datos. En algunas configuraciones, el almacén de datos consulta los datos del lago directamente, en lugar de copiarlos primero.

Las herramientas de BI, como Power BI o Tableau, se conectan al almacén de datos mediante conectores nativos o ODBC/JDBC y leen los datos preparados. Las plataformas de aprendizaje automático utilizan los datos históricos del almacén de datos para el entrenamiento o la puntuación y, a continuación, envían los resultados de los modelos —como las puntuaciones de riesgo— de vuelta al almacén de datos para su uso en informes u otras aplicaciones.

Ventajas para la empresa

Si estás valorando la viabilidad empresarial de un almacén de datos sanitarios, yo me fijaría en cómo afecta a los equipos que utilizan esos datos. Las ventajas de un almacén de datos empresarial en el sector sanitario que se enumeran a continuación son los ámbitos en los que ese impacto suele manifestarse con mayor claridad.

Informes más rápidos

En lugar de extraer datos de varios sistemas y conciliarlos manualmente, los equipos pueden trabajar con los datos ya preparados en el almacén de datos. Los informes periódicos requieren menos esfuerzo, y los analistas pueden dedicar más tiempo a analizar los datos en lugar de recopilarlos.

Visión unificada del paciente

Los datos clínicos, de reclamaciones y otros datos relacionados con los pacientes pueden vincularse entre los distintos sistemas de origen para ofrecer a los equipos una visión más amplia del historial de un paciente. Esto facilita el seguimiento de la atención a lo largo de las distintas consultas sin tener que saltar de un registro a otro.

Mejores decisiones clínicas

Los profesionales clínicos y los analistas pueden utilizar datos históricos de toda la organización a la hora de responder a preguntas que dependen de más de un sistema. Ese contexto más amplio sirve de base para la toma de decisiones sobre los patrones de tratamiento, el riesgo de los pacientes y la calidad de la atención.

Optimización de costes y recursos

Vincular la actividad clínica con los datos financieros u operativos ayuda a los hospitales a saber en qué se invierten los recursos. Los equipos pueden comparar los volúmenes de servicios con los niveles de dotación de personal o los costes, y utilizar los resultados a la hora de planificar la capacidad.

Mejor análisis de las reclamaciones

Una vez que las reclamaciones y los datos clínicos se encuentran en el mismo almacén de datos, los analistas pueden comparar los servicios facturados con la atención sanitaria documentada por los profesionales clínicos. Pueden investigar por qué las aseguradoras han denegado o pagado de menos las reclamaciones e identificar problemas recurrentes en la facturación.

Análisis predictivo

Dado que el almacén de datos centraliza la información histórica en un único lugar, los equipos pueden utilizarla para estimar lo que es probable que suceda a continuación. Un modelo podría señalar a los pacientes con mayor riesgo de reingreso o predecir períodos de mayor demanda. De este modo, los equipos de atención y de operaciones pueden planificar con mayor antelación la atención de seguimiento o la dotación de personal.

Apoyo a la investigación

Los investigadores suelen necesitar registros que abarquen a muchos pacientes durante largos periodos de tiempo. Un almacén de datos les proporciona información lista para realizar análisis de cohortes o estudios retrospectivos sin tener que volver a crear el conjunto de datos a partir de sistemas independientes cada vez.

Análisis de la atención sanitaria basada en el valor

En la atención sanitaria basada en el valor, los equipos necesitan saber si los recursos que utilizan se traducen realmente en mejores resultados. Cuando la base de datos vincula los resultados con los datos sobre el uso de recursos, los analistas pueden comparar grupos de pacientes y comprobar si un mayor gasto o un uso más intensivo de los servicios se traduce en mejores resultados asistenciales.

Retos habituales de los almacenes de datos (DWH) en el sector sanitario

Las ventajas que he mencionado anteriormente conllevan algunos retos de implementación, pero son mucho más fáciles de abordar si se planifican con antelación. Un equipo con experiencia puede detectar muchos de los riesgos antes de que se conviertan en trabajo adicional o en problemas de presentación de informes. Estos son los aspectos a los que prestaría atención desde el principio.

Datos fragmentados e interoperabilidad

Un sistema puede identificar a un paciente mediante el número de expediente médico, mientras que otro utiliza un identificador diferente. Los formatos de los datos también pueden variar. Los equipos deben asignar correctamente esas diferencias y actualizar las correspondencias cada vez que se produzca un cambio en el sistema de origen.

Mala calidad de los datos

Un almacén de datos hereda los problemas de los sistemas que lo alimentan. Los valores que faltan o los códigos incoherentes pueden dar lugar a informes poco fiables y afectar a los análisis posteriores. Los equipos deben detectar estos problemas antes de que otros informes o modelos empiecen a basarse en los mismos datos.

Expedientes de pacientes duplicados

Un mismo paciente puede aparecer más de una vez cuando los sistemas utilizan identificadores diferentes o contienen datos personales ligeramente distintos. Las reglas de coincidencia deben detectar esos duplicados sin combinar accidentalmente registros de personas diferentes.

Seguridad y privacidad

Un almacén de datos sanitarios puede contener historiales de pacientes, además de datos financieros y operativos, pero no todos los usuarios deben tener acceso a toda la información. Es posible que los profesionales clínicos necesiten datos específicos de cada paciente, mientras que los equipos financieros quizá solo necesiten datos de facturación. Configura el acceso según el rol y revisa los permisos cada vez que añadas una nueva fuente de datos.

Gobernanza

Los equipos necesitan normas claras sobre quién es el titular de los datos compartidos y quién toma las decisiones al respecto. Por ejemplo, si dos departamentos calculan la misma métrica de forma diferente, alguien tiene que elegir la definición que utilizarán todos. Lo mismo ocurre con la autorización del acceso a datos confidenciales.

Adaptación de los volúmenes de datos

A medida que el almacén acumula más años de datos e incorpora nuevas fuentes, las consultas pueden ralentizarse y los costes de almacenamiento pueden aumentar. Los equipos deben planificar cómo organizar los datos más antiguos y durante cuánto tiempo conservarlos, para que el crecimiento no dificulte la elaboración de informes diarios.

Falta de experiencia interna en ingeniería de datos

Es posible que tu equipo conozca bien los sistemas sanitarios, pero que tenga poca experiencia en la creación de un almacén de datos en torno a ellos. En ese caso, los ingenieros de datos externos pueden ayudar a diseñar los flujos de datos y el modelo de datos, mientras que tu equipo interno se encarga de definir qué es lo que deben respaldar los datos.

Modelos de almacenes de datos sanitarios

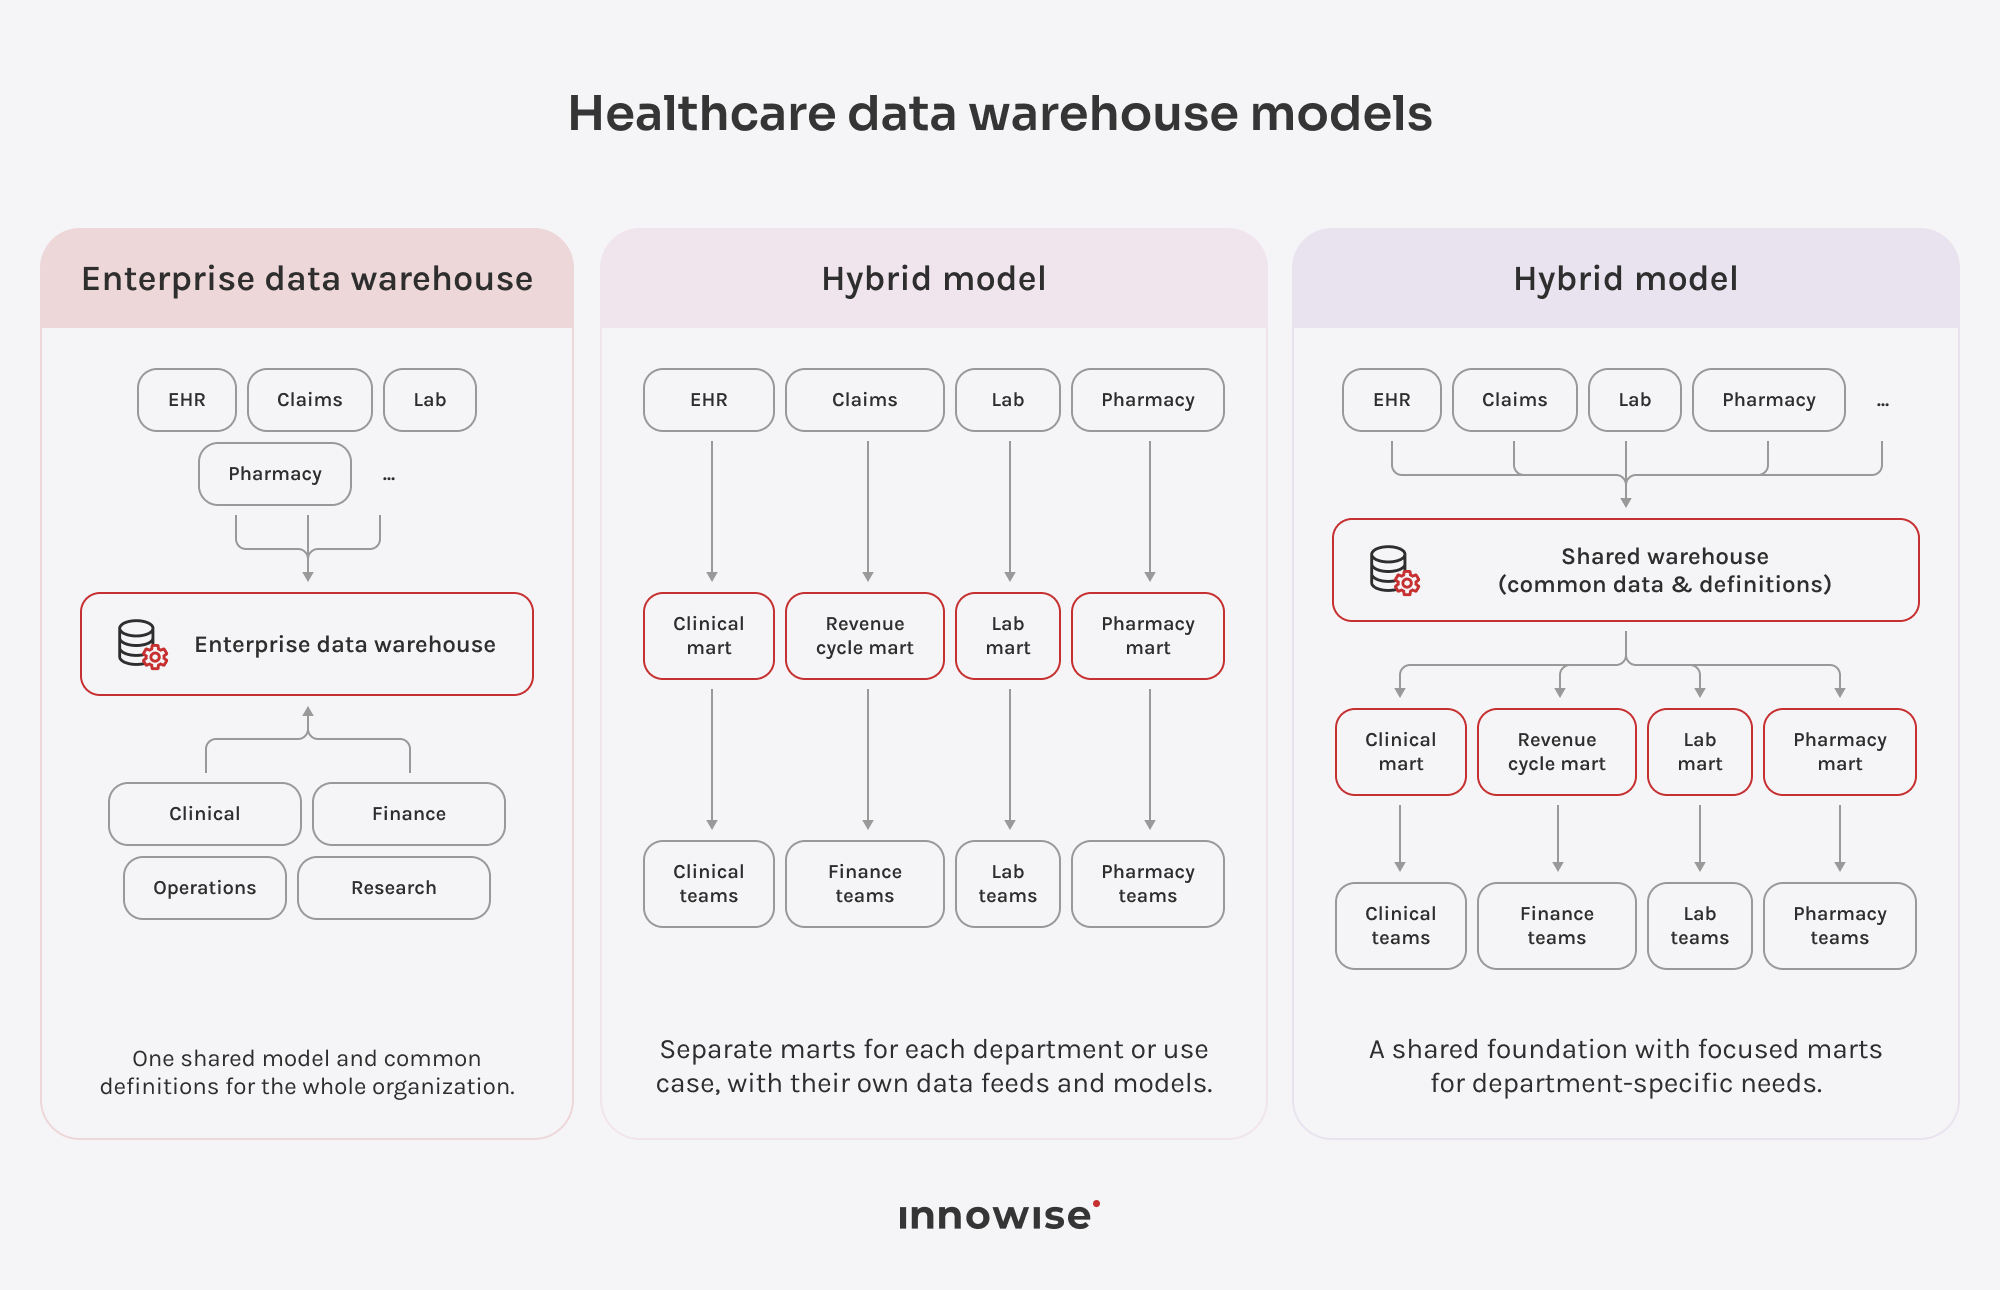
El modelo adecuado de almacén de datos sanitarios depende del grado de centralización que se desee para la gestión de datos y del nivel de independencia que necesiten los distintos departamentos. En la práctica, las organizaciones suelen elegir entre tres modelos:

Almacén de datos corporativo

Un almacén de datos empresarial en el sector sanitario utiliza un modelo de datos compartido en toda la organización, de modo que los distintos departamentos trabajan con definiciones y normas de elaboración de informes coherentes. Los equipos clínicos y financieros, por ejemplo, pueden calcular la duración media de la estancia de la misma manera, en lugar de definir la métrica por separado en sus propios informes.

A nivel de datos, los equipos pueden estandarizar entidades básicas como pacientes, consultas, profesionales sanitarios y centros, y asignar los registros del sistema de origen a esas estructuras compartidas. La contrapartida es que deben ponerse de acuerdo sobre esas definiciones desde el principio y mantenerlas alineadas a medida que crece el almacén de datos. Eso requiere más trabajo inicial, especialmente en una organización grande donde la terminología y las necesidades de generación de informes cambian constantemente. Una vez que muchos informes dependen del modelo compartido, incluso un pequeño cambio en una definición básica puede afectar a varios equipos a la vez.

Almacenes de datos independientes

Un data mart independiente se centra en un departamento concreto o en un caso de uso analítico específico, en lugar de modelar los datos de toda la organización. Por ejemplo, un equipo de oncología podría crear un data mart en torno a los sistemas clínicos que necesita, mientras que los analistas del ciclo de ingresos crearían otro centrado en los datos de reclamaciones y facturación.

Dado que cada «mart» tiene un alcance más reducido, los equipos suelen poder poner en marcha los primeros informes antes. A medida que se añaden más marts, es posible que un mismo sistema fuente necesite flujos de datos y asignaciones independientes para cada uno de ellos. Las definiciones también pueden variar de un departamento a otro. Y, dado que los marts suelen almacenar datos ya procesados o resumidos para un caso de uso concreto, es posible que carezcan del nivel de detalle necesario para un análisis diferente que se realice posteriormente.

Modelo híbrido

Un modelo híbrido combina un almacén de datos empresarial compartido con data marts creados para departamentos concretos o necesidades analíticas específicas. Los datos básicos y las definiciones compartidas permanecen en la capa central, mientras que cada data mart adapta esos datos a sus propias necesidades de generación de informes. Dado que los data marts se alimentan del almacén de datos, los equipos no tienen que crear una integración independiente con cada sistema de origen.

Esta configuración permite a las organizaciones añadir nuevos «marts» a medida que cambian las necesidades de generación de informes, sin tener que modelar desde el principio todos los casos de uso futuros. Lo más complicado es decidir qué debe estandarizarse de forma centralizada y qué puede seguir siendo específico de un «mart» concreto. Si se traslada demasiada lógica a los «marts» individuales, las definiciones pueden ir variando con el tiempo.

¿Estás planificando un almacén de datos (DWH) para el sector sanitario y valorando tus opciones?

Casos de uso del DWH en el sector sanitario

Las organizaciones sanitarias utilizan los almacenes de datos para tareas muy diversas, en función de los datos que recopilan y de las decisiones que deben tomar. Los ejemplos de almacenes de datos sanitarios que se muestran a continuación ilustran cómo se aplica esto en el ámbito clínico y operativo.

Gestión de la salud de la población

Los equipos de salud pública utilizan los datos del almacén para identificar grupos de pacientes con necesidades asistenciales similares. Por ejemplo, pueden identificar a las personas que tienen pendiente una prueba de cribado o una visita de seguimiento y facilitar esas listas a los equipos de atención comunitaria.

Gestión de enfermedades crónicas

En el caso de las enfermedades crónicas, los equipos sanitarios necesitan saber qué cambios se producen entre una cita y otra. Una base de datos puede recopilar los resultados de análisis y el historial de medicación de todas las visitas, a los que se añaden las lecturas de los dispositivos conectados cuando estén disponibles. Este historial combinado ayuda a los equipos a detectar cambios en el estado del paciente y a decidir cuándo puede ser necesario un seguimiento más temprano.

Análisis predictivo del riesgo de los pacientes

Los equipos utilizan datos históricos almacenados para estimar qué pacientes presentan un mayor riesgo de reingreso o de no acudir a una cita. Por lo general, esas puntuaciones llegan a los profesionales sanitarios a través de un sistema de gestión de la atención o de seguimiento. Introducirlas de nuevo en la propia historia clínica electrónica suele requerir una integración independiente: los proveedores de historias clínicas electrónicas suelen mantener un estricto control sobre el acceso de escritura.

Investigación y ensayos clínicos

La búsqueda de participantes aptos para un estudio suele comenzar con una larga lista de criterios de inclusión y exclusión. Los investigadores pueden aplicar primero esos criterios a los datos anonimizados almacenados en el repositorio y reducir así el grupo de candidatos antes de revisar las historias clínicas individuales. En el caso de los estudios que se llevan a cabo en varios centros, los equipos también pueden organizar los historiales de los distintos centros en una estructura común antes de proceder al análisis.

Análisis del ciclo de ingresos y de las reclamaciones

Pueden surgir problemas de pago en cualquier momento entre el cobro inicial y el reembolso final. Al vincular los datos clínicos, de facturación y de reclamaciones, los equipos de ingresos pueden identificar en qué punto se ha estancado una reclamación y si se repite el mismo motivo de denegación con un pagador o procedimiento concretos.

Planificación de personal y capacidad

Los responsables comparan el volumen de pacientes por unidad y turno con el personal asignado a ese mismo horario. Si en una misma unidad se produce repetidamente una falta de personal en determinados días o durante los periodos de mayor afluencia, pueden ajustar los horarios futuros para tener en cuenta ese patrón.

Optimización de los costes operativos

Cuando se relacionan los datos financieros con la actividad clínica, los equipos pueden ver de dónde proceden realmente los gastos de funcionamiento. Pueden comparar el gasto por procedimiento, centro o tipo de atención e investigar por qué los costes son más elevados en algunas áreas que en otras.

Proceso de implementación

Cada proyecto de almacén de datos sanitarios comienza de forma diferente. Los pasos a seguir dependen de tus sistemas actuales, de la calidad de tus datos y de lo que quieras que haga el almacén. A continuación te explicamos cómo solemos abordarlo.

01
Descubrimiento

Nuestro equipo define los casos de uso iniciales relacionados con la generación de informes o el análisis para la primera versión e identifica a las personas que los necesitan. Asimismo, confirmamos qué sistemas fuente entran dentro del ámbito del proyecto y señalamos las restricciones normativas antes de tomar decisiones sobre la arquitectura.

02
Evaluación de datos

Antes de crear los flujos de datos, revisamos cada fuente en busca de datos que falten y formatos incoherentes, y luego comprobamos si hay duplicados. Los resultados nos indican qué datos pueden mantenerse tal cual y en qué casos necesitamos aplicar reglas de limpieza antes de que esos problemas afecten a los informes de producción.

03
Arquitectura

Nuestros arquitectos de datos eligen el modelo de almacén de datos en función del alcance con el que los equipos necesiten compartir datos y definiciones. A continuación, diseñan las capas de ingesta y almacenamiento en función de los sistemas de la organización y deciden cómo accederán las herramientas de análisis al almacén de datos.

04
Selección de tecnología

Una vez definida la arquitectura, el equipo elige la plataforma, el enfoque ETL/ELT y las herramientas de BI o ML en función del volumen de datos y la pila tecnológica existente. Las consideraciones presupuestarias y de cumplimiento normativo reducen la lista de opciones, especialmente cuando se requieren controles de acceso o registros de auditoría.

05
Integración

Los ingenieros de datos conectan el almacén de datos con los sistemas de origen. Dependiendo del entorno, pueden utilizar FHIR o HL7 v2 para los datos clínicos, X12 para las reclamaciones de EE. UU. y API o conectores nativos para las aplicaciones empresariales. Comprobar cada fuente de datos con datos reales ayuda a detectar a tiempo los errores de mapeo.

06
Desarrollo

Los ingenieros de Innowise crean procesos que estandarizan los formatos y resuelven los registros duplicados antes de aplicar las definiciones de negocio acordadas. Si el diseño incluye data marts, los crean en la capa compartida en lugar de volver a conectarse a cada fuente.

07
Migración y pruebas

El equipo carga los datos históricos y los compara con las fuentes originales para detectar valores que falten o que hayan sido modificados. A continuación, los analistas comprueban los informes con los casos de uso definidos en la fase de análisis, mientras que los usuarios de la empresa revisan los resultados antes de la puesta en marcha.

08
Lanzamiento

En el momento del lanzamiento, nuestro equipo suele ejecutar informes antiguos y nuevos en paralelo para que los usuarios puedan comparar las cifras antes de realizar la transición. Además, seguimos de cerca el uso inicial en producción, ya que es aquí donde suelen surgir los problemas de datos o de rendimiento que se han pasado por alto durante las pruebas.

09
Soporte

Tras la puesta en marcha, supervisamos el rendimiento, añadimos nuevas fuentes y mantenemos los procesos de gobernanza que garantizan la coherencia de las definiciones compartidas. Por lo general, es una de las fases más largas del proyecto y una de las que más se tiende a subestimar durante la planificación.

arrow-icon. arrow-icon.
01 Descubrimiento

Nuestro equipo define los casos de uso iniciales relacionados con la generación de informes o el análisis para la primera versión e identifica a las personas que los necesitan. Asimismo, confirmamos qué sistemas fuente entran dentro del ámbito del proyecto y señalamos las restricciones normativas antes de tomar decisiones sobre la arquitectura.

arrow-icon. arrow-icon.
02 Evaluación de datos

Antes de crear los flujos de datos, revisamos cada fuente en busca de datos que falten y formatos incoherentes, y luego comprobamos si hay duplicados. Los resultados nos indican qué datos pueden mantenerse tal cual y en qué casos necesitamos aplicar reglas de limpieza antes de que esos problemas afecten a los informes de producción.

arrow-icon. arrow-icon.
03 Arquitectura

Nuestros arquitectos de datos eligen el modelo de almacén de datos en función del alcance con el que los equipos necesiten compartir datos y definiciones. A continuación, diseñan las capas de ingesta y almacenamiento en función de los sistemas de la organización y deciden cómo accederán las herramientas de análisis al almacén de datos.

arrow-icon. arrow-icon.
04 Selección de tecnología

Una vez definida la arquitectura, el equipo elige la plataforma, el enfoque ETL/ELT y las herramientas de BI o ML en función del volumen de datos y la pila tecnológica existente. Las consideraciones presupuestarias y de cumplimiento normativo reducen la lista de opciones, especialmente cuando se requieren controles de acceso o registros de auditoría.

arrow-icon. arrow-icon.
05 Integración

Los ingenieros de datos conectan el almacén de datos con los sistemas de origen. Dependiendo del entorno, pueden utilizar FHIR o HL7 v2 para los datos clínicos, X12 para las reclamaciones de EE. UU. y API o conectores nativos para las aplicaciones empresariales. Comprobar cada fuente de datos con datos reales ayuda a detectar a tiempo los errores de mapeo.

arrow-icon. arrow-icon.
06 Desarrollo

Los ingenieros de Innowise crean procesos que estandarizan los formatos y resuelven los registros duplicados antes de aplicar las definiciones de negocio acordadas. Si el diseño incluye data marts, los crean en la capa compartida en lugar de volver a conectarse a cada fuente.

arrow-icon. arrow-icon.
07 Migración y pruebas

El equipo carga los datos históricos y los compara con las fuentes originales para detectar valores que falten o que hayan sido modificados. A continuación, los analistas comprueban los informes con los casos de uso definidos en la fase de análisis, mientras que los usuarios de la empresa revisan los resultados antes de la puesta en marcha.

arrow-icon. arrow-icon.
08 Lanzamiento

En el momento del lanzamiento, nuestro equipo suele ejecutar informes antiguos y nuevos en paralelo para que los usuarios puedan comparar las cifras antes de realizar la transición. Además, seguimos de cerca el uso inicial en producción, ya que es aquí donde suelen surgir los problemas de datos o de rendimiento que se han pasado por alto durante las pruebas.

arrow-icon. arrow-icon.
09 Soporte

Tras la puesta en marcha, supervisamos el rendimiento, añadimos nuevas fuentes y mantenemos los procesos de gobernanza que garantizan la coherencia de las definiciones compartidas. Por lo general, es una de las fases más largas del proyecto y una de las que más se tiende a subestimar durante la planificación.

Servicios de almacenamiento de datos sanitarios

Si estás creando un DWH para el sector sanitario desde cero, necesitarás un tipo de asistencia diferente al que necesitarías si estuvieras reparando o ampliando uno ya existente. Innowise puede incorporarse en cualquiera de las dos fases y encargarse del trabajo que requiera tu configuración.

  • Asesoramiento sobre almacenes de datos sanitarios
  • Arquitectura y diseño
  • Desarrollo de un almacén de datos (DWH)
  • Integración y migración de datos
  • Modernización del DWH heredado
  • Integración de BI y análisis de datos
  • Asistencia y optimización

Asesoramiento sobre almacenes de datos sanitarios

Si ya tienes problemas con la generación de informes o un almacén que ya no se adapta a tus necesidades, analizamos qué hay que cambiar. Nuestro equipo revisa la configuración actual y compara las opciones disponibles. A partir de ahí, te ayudamos a decidir qué casos de uso deben tener prioridad.

Nurse reviews lab results and medication history in EHR system before patient rounds.

Arquitectura y diseño

Una vez acordados los requisitos, nuestros arquitectos diseñan una estructura de almacenamiento adaptada a sus sistemas y a las cargas de trabajo previstas. Definen cómo se conectan los componentes principales y dónde se almacenan los datos compartidos. De este modo, la estructura podrá adaptarse a nuevas fuentes o necesidades de generación de informes a medida que surjan.

Building layouts and style guides for a new web application project.

Desarrollo de un almacén de datos (DWH)

Una vez aprobado el diseño, nuestros ingenieros desarrollan el almacén de datos (DWH), incluyendo la lógica de transformación y los data marts necesarios. Incorporan controles de calidad y de seguridad durante el desarrollo, para que el almacén de datos pueda dar soporte a los informes y análisis que requiere el proyecto.

IT specialist analyzing software code during an evening sprint session.

Integración y migración de datos

Conectamos el almacén de datos con los sistemas de historias clínicas electrónicas (EHR/EMR), reclamaciones, laboratorio, ERP/CRM y otros sistemas de origen. A continuación, los datos históricos se transfieren al modelo de destino con las correspondencias y transformaciones necesarias. Antes de la migración, se realizan comprobaciones de conciliación para comparar los datos migrados con su origen.

Data engineer interacts with a visual dashboard to orchestrate real-time data synchronization across systems.

Modernización del DWH heredado

A medida que cambian las fuentes de datos y las necesidades de generación de informes, es posible que un almacén de datos ya existente requiera algo más que un mantenimiento rutinario. Actualizamos los modelos de datos y los flujos de datos obsoletos, trasladamos las cargas de trabajo cuando la plataforma actual se convierte en un obstáculo y automatizamos las tareas repetitivas de gestión de datos cuando resulta conveniente.

IT operations team tracks software patch rollout in real time via a mobile device interface.

Integración de BI y análisis de datos

Nuestros expertos conectan el almacén de datos con las herramientas de BI y análisis que ya utilizan tus equipos. Dependiendo de la configuración, pueden importar datos o consultar el almacén directamente. Las métricas compartidas y las reglas de generación de informes se centralizan en un único lugar, en lugar de tener que volver a crearlas en cada panel de control.

Accessing a centralized analytics portal to evaluate company operations and outcomes.

Asistencia y optimización

Tras la puesta en marcha, el almacén de datos va evolucionando en función de tus datos y tus necesidades de generación de informes. Nuestro equipo puede resolver problemas relacionados con los flujos de datos o con los datos en sí, añadir nuevas fuentes, optimizar las consultas lentas y actualizar los modelos cuando cambien los requisitos del negocio.

The consulting team reviews analytics on screen, focusing on data-driven IT strategy and solutions.
Asesoramiento sobre almacenes de datos sanitarios

Si ya tienes problemas con la generación de informes o un almacén que ya no se adapta a tus necesidades, analizamos qué hay que cambiar. Nuestro equipo revisa la configuración actual y compara las opciones disponibles. A partir de ahí, te ayudamos a decidir qué casos de uso deben tener prioridad.

Nurse reviews lab results and medication history in EHR system before patient rounds.
Arquitectura y diseño

Una vez acordados los requisitos, nuestros arquitectos diseñan una estructura de almacenamiento adaptada a sus sistemas y a las cargas de trabajo previstas. Definen cómo se conectan los componentes principales y dónde se almacenan los datos compartidos. De este modo, la estructura podrá adaptarse a nuevas fuentes o necesidades de generación de informes a medida que surjan.

Building layouts and style guides for a new web application project.
Desarrollo de un almacén de datos (DWH)

Una vez aprobado el diseño, nuestros ingenieros desarrollan el almacén de datos (DWH), incluyendo la lógica de transformación y los data marts necesarios. Incorporan controles de calidad y de seguridad durante el desarrollo, para que el almacén de datos pueda dar soporte a los informes y análisis que requiere el proyecto.

IT specialist analyzing software code during an evening sprint session.
Integración y migración de datos

Conectamos el almacén de datos con los sistemas de historias clínicas electrónicas (EHR/EMR), reclamaciones, laboratorio, ERP/CRM y otros sistemas de origen. A continuación, los datos históricos se transfieren al modelo de destino con las correspondencias y transformaciones necesarias. Antes de la migración, se realizan comprobaciones de conciliación para comparar los datos migrados con su origen.

Data engineer interacts with a visual dashboard to orchestrate real-time data synchronization across systems.
Modernización del DWH heredado

A medida que cambian las fuentes de datos y las necesidades de generación de informes, es posible que un almacén de datos ya existente requiera algo más que un mantenimiento rutinario. Actualizamos los modelos de datos y los flujos de datos obsoletos, trasladamos las cargas de trabajo cuando la plataforma actual se convierte en un obstáculo y automatizamos las tareas repetitivas de gestión de datos cuando resulta conveniente.

IT operations team tracks software patch rollout in real time via a mobile device interface.
Integración de BI y análisis de datos

Nuestros expertos conectan el almacén de datos con las herramientas de BI y análisis que ya utilizan tus equipos. Dependiendo de la configuración, pueden importar datos o consultar el almacén directamente. Las métricas compartidas y las reglas de generación de informes se centralizan en un único lugar, en lugar de tener que volver a crearlas en cada panel de control.

Accessing a centralized analytics portal to evaluate company operations and outcomes.
Asistencia y optimización

Tras la puesta en marcha, el almacén de datos va evolucionando en función de tus datos y tus necesidades de generación de informes. Nuestro equipo puede resolver problemas relacionados con los flujos de datos o con los datos en sí, añadir nuevas fuentes, optimizar las consultas lentas y actualizar los modelos cuando cambien los requisitos del negocio.

The consulting team reviews analytics on screen, focusing on data-driven IT strategy and solutions.

¿Necesitas modernizar tu sistema de gestión de datos sanitarios?

Proveedores de almacenes de datos sanitarios

Si estás comparando plataformas para un almacén de datos sanitarios, tu entorno en la nube actual es un buen punto de partida. Las opciones que se indican a continuación gestionan los datos sanitarios de forma diferente, y sus modelos de computación y de precios también varían.

Amazon-Redshift-Logo (1)

Amazon Redshift

Redshift encaja a la perfección cuando la mayor parte de tus datos ya se encuentran en AWS. Es compatible con S3 y AWS Glue, mientras que HealthLake puede exportar datos FHIR a S3 para su análisis posterior mediante Redshift u otros servicios de análisis de AWS.

Características principales

  • SQL para datos estructurados y semiestructurados
  • Acceso a S3 a través de Redshift Spectrum
  • Consultas federadas a bases de datos de AWS compatibles
  • Controles de acceso a nivel de fila y de columna
  • Separar la capacidad de cálculo y el almacenamiento gestionado
  • Servicio de AWS que cumple con los requisitos de la HIPAA 

Precios

  • Precios bajo demanda para clústeres aprovisionados
  • Recursos informáticos sin servidor facturados según el consumo
  • Gastos de almacenamiento gestionado por separado
  • Precios reservados para cargas de trabajo constantes
Azure Synapse Analytics

Azure Synapse Analytics

Synapse funciona bien cuando tus datos y tus informes ya se gestionan en Azure y tus equipos utilizan Power BI. Reúne el almacenamiento de datos SQL y Spark en un único espacio de trabajo, con flujos de trabajo para transferir datos entre los servicios de Azure. Los datos FHIR de los servicios de datos sanitarios de Azure también se pueden copiar en Synapse para su análisis.

Características principales

  • SQL dedicado y sin servidor
  • Grupos de Apache Spark
  • Consultas sobre el lago de datos Azure
  • Canales ETL/ELT integrados
  • Integraciones de ML de Power BI y Azure
  • Análisis de datos FHIR con los servicios de datos sanitarios Azure

Precios

  • SQL sin servidor con facturación en función de los datos procesados
  • SQL dedicado facturado según el consumo de DWU
  • Spark facturado según el uso de vCore
  • Opciones de compra anticipada para cargas de trabajo comprometidas

Para los equipos que desean mayor libertad a la hora de elegir proveedores de servicios en la nube, Snowflake hace que la capa del almacén de datos dependa menos de un único ecosistema. Funciona en AWS, Azure y Google Cloud, mientras que los almacenes virtuales independientes permiten a los equipos asignar recursos de computación específicos a cada carga de trabajo.
Características principales

  • Opciones de implementación multinube
  • Capacidad de cálculo independiente para diferentes cargas de trabajo
  • Almacenes multiclúster en la Enterprise Edition+
  • Compatibilidad nativa con datos semiestructurados
  • Intercambio seguro de datos
  • Asistencia para PHI con Business Critical+

Precios

  • Créditos de computación basados en el consumo
  • Gastos de almacenamiento por separado
  • Capacidad bajo demanda o prepagada 
  • Las tarifas varían según el servicio en la nube, la región y la edición
GCP BigQuery

Google BigQuery

BigQuery es ideal para organizaciones que ya utilizan Google Cloud o que desean disponer de un almacén de datos sin servidores sin tener que gestionar clústeres de computación. La API Cloud Healthcare permite exportar recursos FHIR y metadatos DICOM a BigQuery, lo que proporciona a los equipos de análisis acceso a los datos sanitarios a través de SQL.

Características principales

  • Almacén de datos SQL sin servidor
  • Almacenamiento y recursos de cálculo independientes
  • Funcionalidades integradas de aprendizaje automático
  • Consultas externas y federadas
  • Integración de la API de Cloud para el sector sanitario
  • BigQuery está incluido en el acuerdo de negocio de la HIPAA (BAA) de Google Cloud

Precios

  • Recursos informáticos bajo demanda facturados en función de los datos procesados
  • Tarificación de la capacidad basada en franjas horarias
  • El almacenamiento se factura por separado
  • Compromisos disponibles para la capacidad reservada

Coste y plazos

Los presupuestos para los almacenes de datos sanitarios pueden variar en más de un orden de magnitud. Un data mart de producción limitado con un par de fuentes depuradas puede costar entre $60 000 y $100 000 y llevar entre 2 y 4 meses. Un almacén empresarial multisistema con migración de datos históricos y varios data marts puede alcanzar un coste de entre $400 000 y $1 millón o más, y requerir entre 9 y 18 meses o más.

Escala del proyectoÁmbito de aplicación habitualCronologíaPresupuesto de ejecuciónCostes recurrentes de la nube y del software
Data mart del departamento1-2 sistemas fuente, un departamento, historial limitado, informes básicos de inteligencia empresarial2 a 4 meses$60k–$100k$1k–$5k al mes
Almacén de datos (DWH) de tamaño medio para el sector sanitario3-6 fuentes, modelo de datos compartido, migración de datos históricos, 2-4 almacenes de datos, integración con BI5 a 9 meses$150k–$350k$5k–$20k al mes
DWH empresarial / «lakehouse»Más de 7 fuentes, amplios datos históricos, múltiples mercados, integraciones clínicas personalizadas, análisis avanzadosDe 9 a 18 meses o más$400k–$1m+$20k–$80k+ al mes

Soluciones sanitarias ofrecidas por Innowise

Por qué elegirnos
Un proyecto de almacén de datos (DWH) para el sector sanitario se sitúa a caballo entre la ingeniería de datos y el sector sanitario IT. Innowise cuenta con experiencia en ambos ámbitos, respaldada por las certificaciones ISO pertinentes y por colaboraciones con los proveedores de servicios en la nube y de datos que se utilizan en los proyectos de almacenes de datos.
Experiencia en el sector sanitario

Contamos con más de 19 años de experiencia en el sector sanitario IT, lo que incluye nuestro trabajo con historias clínicas electrónicas, sistemas de laboratorio, imágenes médicas y plataformas sanitarias conectadas. Esa experiencia resulta fundamental cuando los flujos de trabajo clínicos o los estándares de datos sanitarios determinan el diseño del almacén de datos.

Experiencia en ingeniería de datos

Nuestros equipos de datos trabajan con Snowflake, BigQuery, Amazon Redshift y Azure Synapse, junto con las herramientas de ETL/ELT y de orquestación que los respaldan. Esto significa que podemos diseñar el almacén de datos en función de la pila tecnológica existente del cliente, en lugar de basarnos en una plataforma concreta.

Certificaciones pertinentes

Innowise cuenta con las certificaciones ISO 9001, ISO 27001 e ISO 13485, que abarcan las normas de calidad, seguridad de la información y dispositivos médicos.

Registro de entregas

Nuestra trayectoria incluye más de 1.600 proyectos en diversos sectores y más de 60 soluciones IT para el sector sanitario. Para una empresa de medicina de precisión, nosotros mejora de los flujos de datos y de la infraestructura de AWS que se utiliza para procesar datos de diagnóstico procedentes de múltiples fuentes.

Experiencia en seguridad y cumplimiento normativo

Nuestros equipos sanitarios trabajan de acuerdo con los requisitos de la HIPAA y el RGPD, así como con estándares de intercambio de datos sanitarios como HL7 v2 y FHIR. Esa experiencia resulta fundamental cuando se transfieren datos sanitarios sensibles entre el almacén de datos y los sistemas clínicos regulados.

Alianzas tecnológicas

Como socio de AWS, Microsoft, Google Cloud y Databricks, Innowise aporta conocimientos especializados y certificados sobre plataformas a los proyectos de DWH y puede recurrir al soporte técnico de los proveedores cuando surgen problemas específicos de las plataformas.

ISO 13485 certification.
ISO 9001 certification.
ISO/IEC 27001 certification.
GDPR
Select partner AWS
Google_Cloud_Partner

Conclusión

Yo no empezaría un proyecto de almacén de datos sanitarios intentando trasladar todos los conjuntos de datos a un único lugar. En su lugar, elegiría un problema de generación de informes o de análisis que merezca la pena resolver y conectaría únicamente los sistemas necesarios para esa tarea. Por ejemplo, podrías empezar con la generación de informes sobre el ciclo de ingresos o con el análisis de readmisiones. Una vez que eso funcione, podrás decidir qué necesita el almacén a continuación basándote en la demanda real. 

Este enfoque debe mantenerse a medida que el proyecto vaya creciendo. Añade nuevas fuentes o data marts solo cuando haya una razón clara para ello, en lugar de intentar prepararte para todas las posibles necesidades futuras. Lo importante es mantener la coherencia en las definiciones y las normas de acceso a medida que se amplía el almacén de datos, y asegurarse de que siempre se cumplan los requisitos de cumplimiento normativo. 

Si necesitas ayuda externa, los especialistas de Centro de Salud y Farmacia Innowise de IT Podemos analizar su almacén de datos actual o ayudarle a crear uno adaptado a sus sistemas sanitarios y a sus necesidades de generación de informes, teniendo en cuenta los requisitos de cumplimiento normativo en materia de datos sanitarios.

FAQ

Un almacén de datos sanitarios contiene datos preparados para la elaboración de informes y el análisis. Un lago de datos suele albergar mayores volúmenes de datos sin procesar o ligeramente procesados. En muchas arquitecturas, el lago almacena conjuntos de datos más amplios, mientras que el almacén contiene los datos que los equipos necesitan para los análisis clínicos, financieros u operativos recurrentes.

Los plazos varían en función del alcance, los sistemas de origen y la calidad de los datos. Un data mart específico con pocas integraciones puede tardar entre 2 y 4 meses. La implantación de un almacén de datos empresarial de mayor envergadura en el sector sanitario puede llevar entre 9 y 18 meses, o incluso más, cuando el proyecto incluye la migración de datos heredados, múltiples integraciones y varios data marts.

El modelo adecuado de almacén de datos sanitarios depende del número de equipos que necesiten los datos y de si deben utilizar las mismas definiciones de informes. Un modelo empresarial permite generar informes para toda la organización, mientras que los «marts» independientes se centran en departamentos o casos de uso específicos. Un modelo híbrido combina un núcleo compartido con «marts» más específicos. El diseño del almacén de datos sanitarios debe reflejar los casos de uso que debas dar prioridad.

Sí. Podemos modernizar su almacén de datos sanitarios actual sin tener que sustituirlo por completo de una sola vez. Nuestro equipo renueva los flujos de datos obsoletos, revisa los modelos de datos, traslada determinadas cargas de trabajo y integra nuevas herramientas de análisis por fases. La automatización del almacén de datos sanitarios también reduce el trabajo manual en la ingesta de datos y en las comprobaciones periódicas de la calidad de los datos.

Innowise diseña el almacén de datos teniendo en cuenta desde el principio los requisitos de la HIPAA, con un acceso a la información médica protegida (PHI) restringido según el rol y controles de seguridad integrados en los flujos de datos. Además, validamos los datos a medida que se transfieren al almacén, comprobando si hay asignaciones incorrectas, registros de pacientes duplicados o valores alterados antes de que afecten a la generación de informes.

Mostrar todo

Índice

    Contáctenos

    Reserve usted una llamada o rellene usted el siguiente formulario y nos pondremos en contacto con usted cuando hayamos procesado su solicitud.

    Envíenos un mensaje de voz
    Adjuntar documentos
    Cargar archivo

    Puede adjuntar 1 archivo de hasta 2 MB. Formatos de archivo válidos: pdf, jpg, jpeg, png.

    Al hacer clic en «Enviar», usted consiente el tratamiento de sus datos personales por parte de Innowise de conformidad con nuestra Política de privacidad para proporcionarle información relevante. Al enviar su número de teléfono, acepta que nos pongamos en contacto con usted a través de llamadas de voz, SMS y aplicaciones de mensajería. Pueden aplicarse tarifas de llamadas, mensajes y datos.

    También puede enviarnos su solicitud
    a contact@innowise.com
    ¿Qué pasa después?
    1

    Una vez recibida y procesada su solicitud, nos pondremos en contacto con usted para detallarle las necesidades de su proyecto y firmar un acuerdo de confidencialidad. Proyecto y firmaremos un acuerdo de confidencialidad.

    2

    Tras examinar sus deseos, necesidades y expectativas, nuestro equipo elaborará una propuesta de proyecto con el alcance del trabajo, el tamaño del equipo, el plazo y los costes estimados con el alcance del trabajo, el tamaño del equipo, el tiempo y las estimaciones de costes.

    3

    Concertaremos una reunión con usted para hablar de la oferta y concretar los detalles.

    4

    Por último, firmaremos un contrato y empezaremos a trabajar en su proyecto de inmediato.

    Más servicios que cubrimos

    arrow