Armazém de dados na área da saúde: vantagens, arquitetura e casos de utilização

21 de setembro de 2026 12 min ler
Aleh Yafimau, Healthcare and MedTech Delivery Manager..
Consultor na área da saúde IT
Perito certificado
Todos os artigos do Innowise são escritos por autores com experiência prática. Estes compreendem o tema para além da teoria e partilham perspetivas baseadas em projetos reais.
Mais de 19 anos de experiência
Perito certificado
Mais de 19 anos de experiência
Aleh faz a ponte entre as necessidades clínicas e a execução da engenharia. Aplica um profundo conhecimento do domínio para garantir que os sistemas MedTech não estão apenas em conformidade, mas são suficientemente fiáveis para terem um impacto mensurável nos cuidados de saúde do mundo real.
Especialização
TI no sector da saúde Tecnologia médica Algoritmos
Contacto

Principais conclusões

  • Quando os dados relativos a doentes, pedidos de reembolso, análises laboratoriais, financeiros e operacionais estão armazenados em sistemas diferentes, a elaboração de relatórios exige, normalmente, a reconciliação manual das informações entre as várias fontes. A harmazenamento de dados na área da saúde combina os dados destes sistemas para que as equipas possam utilizá-los na elaboração de relatórios e análises.
  • Mesmo o armazém mais bem concebido não consegue compensar a má qualidade dos dados. Problemas como registos duplicados de doentes, formatos inconsistentes e definições contraditórias podem tornar os relatórios pouco fiáveis.
  • O modelo de armazém de dados define em que medida os dados e as definições comuns são partilhados. Um armazém de dados empresarial (DWH) serve a elaboração de relatórios a nível de toda a organização, enquanto os data marts são criados em torno de departamentos específicos ou casos de utilização específicos. As arquiteturas híbridas utilizam ambos. 
  • A análise de viabilidade deve começar pelas decisões que o armazém precisa de apoiar, desde a saúde da população e a avaliação de risco dos doentes até à investigação clínica, à análise de pedidos de reembolso ou ao planeamento de pessoal e capacidade.
Resumo por IA

Se os registos dos seus doentes, resultados laboratoriais, pedidos de reembolso e dados operacionais estiverem dispersos por diferentes sistemas, obter uma resposta fiável pode exigir mais trabalho do que a própria análise. As equipas podem ter de conciliar registos e verificar o que os números realmente significam antes de os poderem utilizar. A armazenamento de dados na área da saúde (DWH) consolida os dados destes sistemas e estrutura-os para a elaboração de relatórios e análises.

Neste artigo, vou explicar como se constrói um DWH na área da saúde e quais são as funcionalidades que se revelam importantes na prática. Vamos também analisar os principais modelos de armazém de dados, os casos de utilização mais comuns na área da saúde, os benefícios empresariais, os desafios de implementação e as decisões a tomar antes do início do projeto.

O que é um armazém de dados na área da saúde?

​ armazenamento de dados na área da saúde é um ambiente central onde os dados provenientes de diferentes sistemas de saúde são limpos, harmonizados e preparados para a elaboração de relatórios e análises. Pode combinar dados de registos de saúde eletrónicos (EHR) e registos médicos eletrónicos (EMR) com dados de pedidos de reembolso, resultados laboratoriais, dados do portal do doente, registos de ERP ou CRM e dados de dispositivos conectados.

Uma base de dados operacional normalmente dá suporte a uma aplicação e às suas operações quotidianas. Um DWH é concebido para responder a questões que exigem dados de vários sistemas em simultâneo. Se um hospital quiser compreender por que razão as readmissões estão a aumentar, por exemplo, os analistas podem comparar diagnósticos e o historial de tratamentos com registos de reclamações, resultados laboratoriais e dados relativos ao pessoal, em vez de extraírem cada conjunto de dados separadamente.

Ao contrário de um DWH, um data lake armazena normalmente os dados antes de estes terem sido estruturados para uma utilização analítica específica. Pode conter grandes volumes de dados em bruto ou ligeiramente processados, em diferentes formatos. Um DWH, em comparação, contém dados preparados que as equipas podem utilizar para BI, relatórios recorrentes e análises contínuas.

Base de dados operacionalArmazém de dadosLago de dados
Objetivo principalExecutar transações diárias das aplicaçõesReunir dados de vários sistemas num formato que permita às equipas elaborar relatórios e analisá-losArmazenar grandes volumes de diferentes tipos de dados para utilização posterior
Fontes de dadosDados criados e utilizados por aplicações operacionaisDados provenientes de registos de saúde eletrónicos (EHR), sistemas de reclamações, ERP, CRM e outros sistemas empresariais ou clínicosDados provenientes de diversas fontes, incluindo dados estruturados, semiestruturados e não estruturados
Como os dados são armazenadosOrganizado em função das necessidades da aplicaçãoLimpo e organizado em função das necessidades de relatórios e análisesFrequentemente mantida próxima da sua forma original e estruturada quando um caso de utilização assim o exige
Utilização típica no setor da saúdeTransações do EHR, consultas ou atividades de CRMRelatórios inter-sistemas, BI e análise de dados na área da saúdeConjuntos de dados de grande dimensão, análises exploratórias ou cargas de trabalho de aprendizagem automática

Arquitetura do armazém de dados na área da saúde

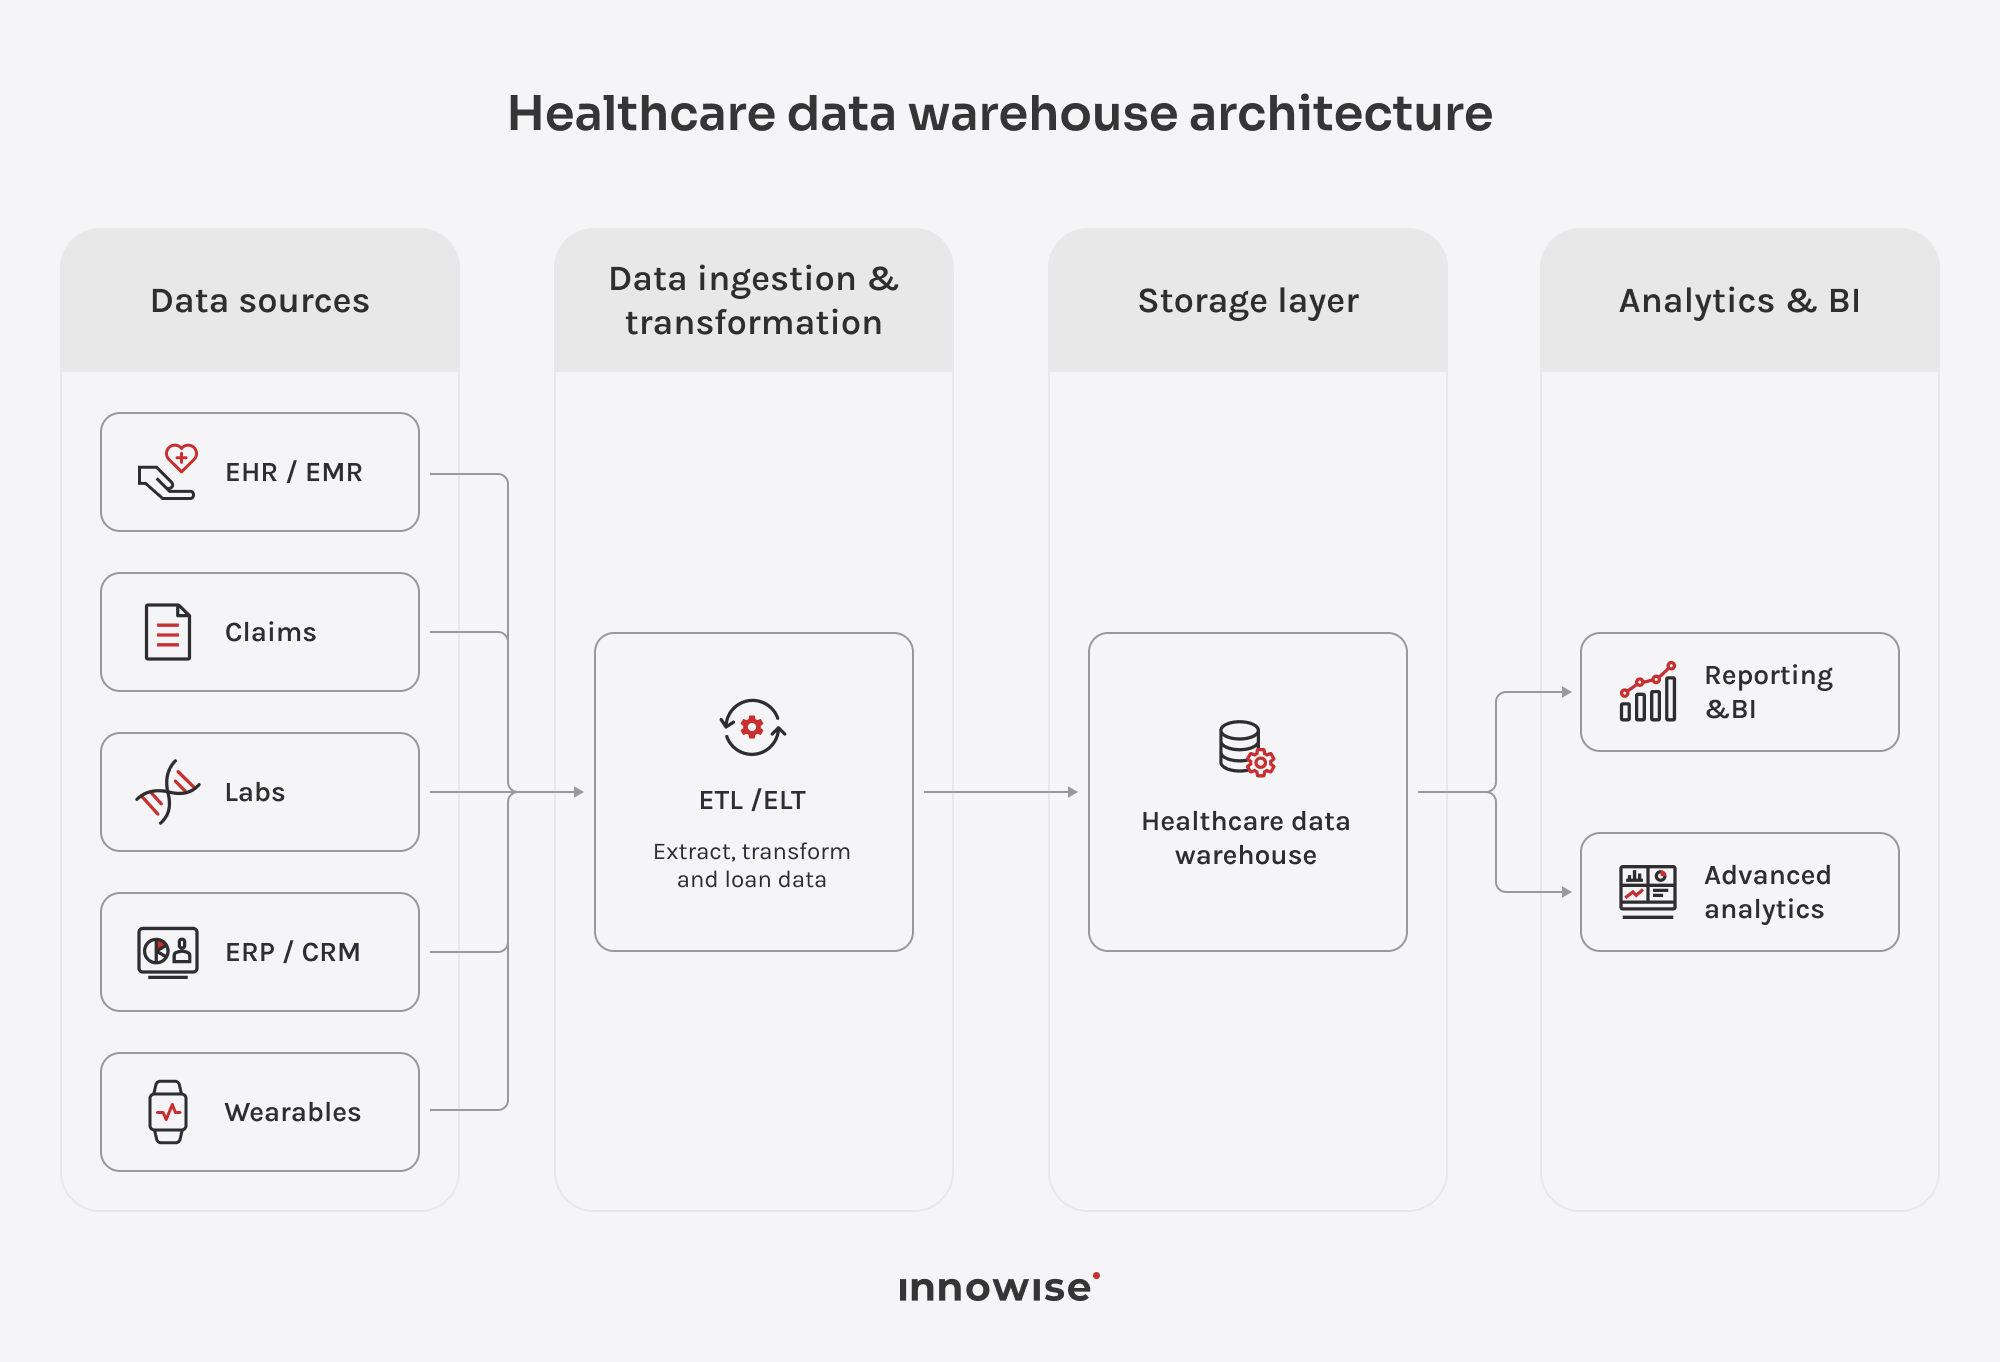
Para compreender melhor como funciona um armazém de dados na área da saúde, vamos analisar as principais camadas que o compõem. Cada uma delas desempenha um papel específico na transferência de dados dos sistemas de origem para o armazenamento e, posteriormente, na disponibilização desses dados para a elaboração de relatórios, análises e aplicações.

Fontes de dados

A camada de origem inclui os sistemas já utilizados para atividades clínicas e administrativas, tais como registos de saúde eletrónicos (EHR) e registos médicos eletrónicos (EMR), plataformas de reclamações, LIS e RIS/PACS, bem como software ERP ou CRM. O mesmo doente ou evento pode ser registado de forma diferente nestes sistemas, pelo que é necessário harmonizar os formatos e fazer corresponder os identificadores antes de utilizar os dados em conjunto.

Ingestão e ETL/ELT

Esta camada recolhe os dados de origem e prepara-os para análise. Com o ETL, os dados são transformados antes de serem carregados no armazém de dados; com o ELT, a transformação ocorre após o carregamento. O processo pode também incluir a normalização do formato, a remoção de duplicados e o armazenamento temporário.

Armazenamento

A camada de armazenamento mantém os dados históricos numa estrutura concebida para a elaboração de relatórios e análises. Dependendo da arquitetura, pode também disponibilizar data marts para um departamento específico ou para um caso de utilização específico.

Análise de dados e BI

As ferramentas de BI utilizam os dados do armazém de dados para painéis e relatórios recorrentes, enquanto os analistas podem executar consultas ad hoc sobre o mesmo conjunto de dados. Isto proporciona às equipas uma fonte partilhada para análise, em vez de terem de recriar a lógica para cada relatório.

Aplicações

Os dados do armazém de dados também podem servir de base para aplicações clínicas ou empresariais a jusante. As ferramentas de investigação ou os sistemas de planeamento, por exemplo, podem utilizar dados preparados a partir do armazém de dados, em vez de se ligarem separadamente a cada sistema de origem.

Precisa de uma visão única e fiável dos dados clínicos e empresariais?

Principais características e funcionalidades

Agora que já falámos sobre a arquitetura, vou abordar as funcionalidades que é provável que encontre num armazém de dados da área da saúde. Cada organização é um pouco diferente, mas surgem muitas necessidades comuns quando é necessário combinar dados de diferentes sistemas e garantir que estes continuem a ser utilizáveis para a elaboração de relatórios e análises.

Integração de dados e ETL/ELT

Os sistemas de saúde costumam armazenar a mesma informação de formas diferentes. Um registo de saúde eletrónico (EHR), uma plataforma de reclamações ou um sistema laboratorial podem utilizar campos e formatos diferentes para registos comparáveis. Os pipelines ETL e ELT recolhem esses dados e harmonizam-nos no armazém de dados para análise. Dependendo da frequência com que os dados se alteram, os pipelines podem ser executados de acordo com um horário definido, carregar apenas novos registos ou processar as atualizações à medida que estas chegam.

Os dados de saúde também sofrem alterações retroativas: os resultados laboratoriais são corrigidos, as consultas são atualizadas ou canceladas e os pedidos de reembolso são ajustados ou anulados. Os processos de tratamento de dados têm de aplicar essas alterações aos registos já carregados; caso contrário, uma nova execução do relatório do mês passado poderá já não corresponder à fonte.

Qualidade dos dados e deduplicação

Os registos duplicados de doentes e os valores contraditórios podem distorcer os relatórios assim que os dados chegam ao armazém de dados. As verificações de qualidade detetam dados em falta ou inválidos, enquanto as regras de correspondência ajudam a associar registos que pertencem ao mesmo doente em diferentes sistemas. As equipas precisam desta limpeza antes de compararem resultados ou criarem análises.

Gestão de metadados

Os metadados explicam o significado de cada campo e a sua origem. Registam também as alterações efetuadas antes de os dados chegarem ao armazém de dados. Os analistas podem rastrear um valor num painel de controlo até à sua fonte e verificar qual a definição que foi utilizada.

Governança de dados

A governação de dados define quem é o proprietário dos dados e quais as definições que todos devem utilizar. Sem regras claras, dois departamentos podem utilizar o mesmo armazém de dados e, mesmo assim, apresentar números diferentes para a mesma métrica. Os proprietários e os gestores dos dados analisam as alterações e garantem a consistência dessas definições ao longo do tempo.

Segurança e controlo de acesso

Um armazém de dados na área da saúde pode conter Informações de Saúde Pessoais (PHI), juntamente com dados operacionais ou financeiros sensíveis, pelo que o acesso não pode ser o mesmo para todos. As autorizações podem limitar o que um utilizador vê com base na sua função e, quando necessário, até ao nível de linhas ou colunas específicas. A encriptação protege os dados armazenados e durante a transferência, enquanto os registos de auditoria indicam quem acedeu aos mesmos.

Suporte a dados estruturados e semiestruturados

A maioria dos relatórios recorrentes utiliza tabelas estruturadas, mas os sistemas de saúde também produzem dados noutros formatos. As APIs e os dispositivos conectados, por exemplo, podem enviar JSON. Um armazém de dados pode trabalhar com estes dados sem ter de converter primeiro todos os campos numa tabela fixa. Os ficheiros não estruturados, como as imagens médicas, permanecem normalmente num data lake ou num armazenamento de objetos e são associados aos dados do armazém de dados sempre que necessário.

Escalabilidade e desempenho

À medida que a quantidade de dados armazenados e o número de consultas aumentam, o armazém de dados precisa de manter a capacidade de resposta dos relatórios. As plataformas podem recorrer ao particionamento, à indexação, ao armazenamento em cache ou a recursos de computação separados para lidar com cargas de trabalho maiores sem ter de reconstruir a arquitetura do armazém de dados.

Interoperabilidade

Um armazém de dados de saúde precisa de trocar dados com registos de saúde eletrónicos (EHR), sistemas laboratoriais e outras plataformas clínicas. As normas HL7, como o FHIR e o HL7 v2, proporcionam às equipas formatos comuns para essa troca, o que reduz a necessidade de mapeamentos personalizados. Os sistemas antigos ou proprietários podem ainda necessitar de conectores personalizados para que o armazém possa utilizar os seus dados.

Em projetos na área da saúde, não analisaria os resultados nem os custos isoladamente. Um DWH permite comparar aspetos como a duração da internação e as readmissões com a utilização de recursos e o tempo dedicado pelo pessoal. Isso é importante nos cuidados de saúde baseados no valor, em que é necessário compreender tanto o resultado como o que foi necessário para o alcançar.
Philip Tikhanovich, Head of Big Data.
Philip Tikhanovich
Diretor de Grandes Dados

Integrações de armazéns de dados na área da saúde

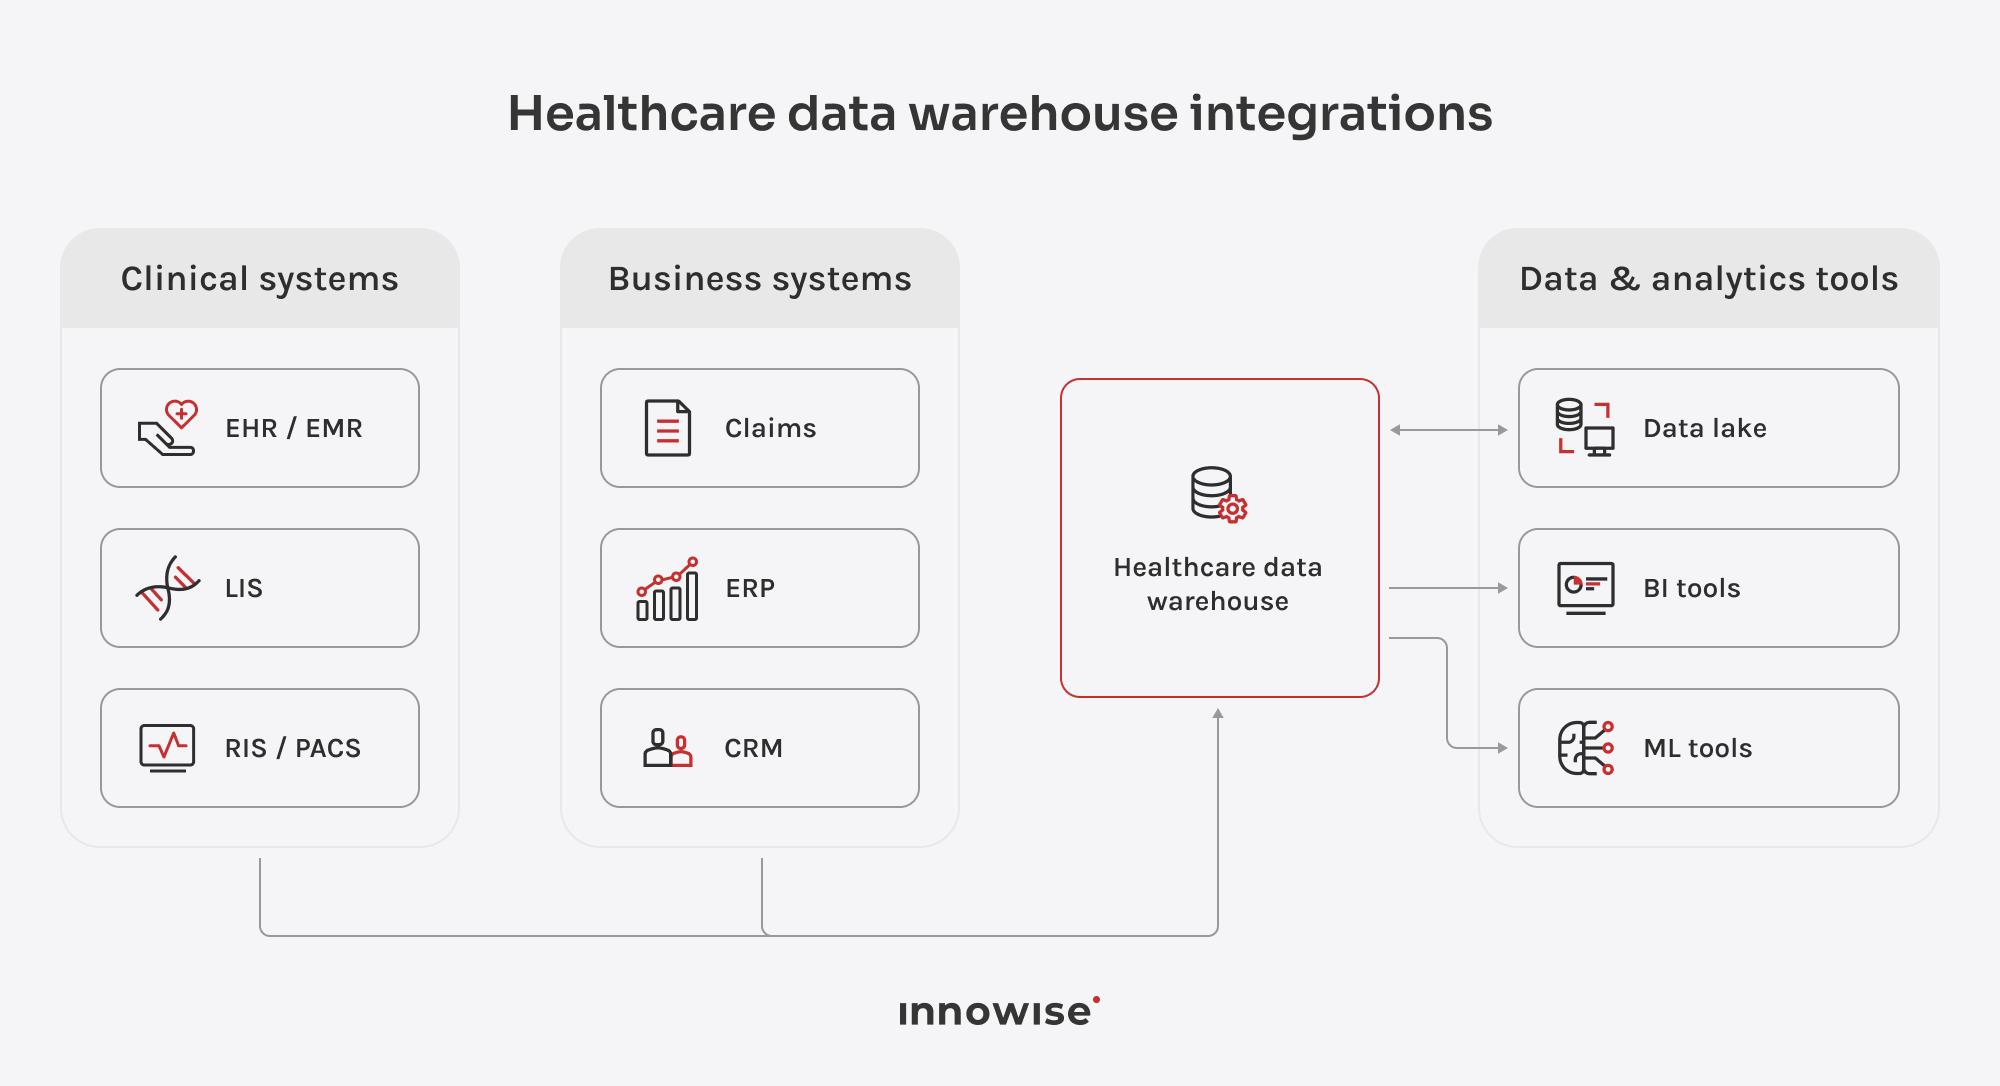
Se estiver a criar um armazém de dados clínicos no setor da saúde, normalmente irá ligar os sistemas que as suas equipas já utilizam no dia a dia. As integrações mais comuns importam dados de sistemas clínicos e empresariais e disponibilizam-nos às ferramentas de BI e ML.

Sistemas clínicos

Os sistemas de EHR e EMR enviam normalmente dados clínicos estruturados através de APIs FHIR ou feeds HL7 v2. O FHIR funciona bem para recursos como «Paciente» e «Consulta», enquanto o HL7 v2 continua a ser comum para eventos hospitalares e resultados laboratoriais. Os sistemas LIS utilizam frequentemente mensagens ORU HL7 v2 para enviar resultados de análises para o armazém de dados.

A radiologia funciona de forma diferente, uma vez que os dados de imagiologia são normalmente mantidos fora do próprio armazém. O PACS ou o armazenamento de objetos guardam as imagens, enquanto o armazém armazena o relatório e os metadados do estudo, com ligações para o ficheiro DICOM correspondente.

Sistemas empresariais

Os sistemas de reclamações mostram o que os prestadores faturaram e o que as entidades pagadoras reembolsaram. Nos EUA, estes sistemas trocam frequentemente dados através de transações X12, incluindo ficheiros de reclamações 837 e de remessas 835. A conservação de dados tanto ao nível da reclamação como ao nível da linha permite aos analistas comparar os custos totais com os serviços individuais subjacentes.

Os sistemas ERP fornecem dados sobre custos e recursos humanos, enquanto os sistemas CRM registam os contactos com os doentes fora do registo médico. Quando as equipas combinam essa informação com os dados clínicos, podem analisar questões como, por exemplo, se os lembretes de consultas melhoram a assiduidade ou se os níveis de pessoal correspondem à atividade clínica.

Dados e análises

Um data lake armazena dados brutos ou menos estruturados antes de as equipas os prepararem para o armazém de dados. Os conjuntos de dados selecionados podem ser limpos no data lake e, em seguida, carregados no armazém de dados. Em algumas configurações, o armazém de dados consulta os dados do data lake diretamente, em vez de os copiar primeiro.

As ferramentas de BI, como o Power BI ou o Tableau, ligam-se ao armazém de dados através de conectores nativos ou ODBC/JDBC e leem dados já preparados. As plataformas de ML utilizam dados históricos do armazém de dados para treino ou avaliação e, em seguida, enviam os resultados dos modelos, tais como pontuações de risco, de volta para o armazém de dados para a elaboração de relatórios ou outras aplicações.

Vantagens para as empresas

Se estiver a avaliar a viabilidade económica de um armazém de dados na área da saúde, eu analisaria o que isso implica para as equipas que utilizam os dados. Os benefícios de um armazém de dados empresarial na área da saúde, enumerados abaixo, são os aspetos em que esse impacto tende a manifestar-se de forma mais clara.

Relatórios mais rápidos

Em vez de extrair dados de vários sistemas e reconciliá-los manualmente, as equipas podem trabalhar com dados já preparados no armazém de dados. Os relatórios recorrentes exigem menos esforço e os analistas podem dedicar mais tempo a analisar os dados, em vez de os reunir.

Visão unificada do doente

Os dados clínicos, relativos a pedidos de reembolso e outros dados relacionados com os doentes podem ser interligados entre os diferentes sistemas de origem, proporcionando às equipas uma visão mais abrangente do historial de um doente. Isso facilita o acompanhamento dos cuidados prestados ao longo das consultas, sem necessidade de alternar entre registos distintos.

Melhores decisões clínicas

Os profissionais clínicos e os analistas podem recorrer a dados históricos de toda a organização para responder a questões que envolvem mais do que um sistema. Esse contexto mais alargado apoia as decisões relativas aos padrões de tratamento, ao risco dos doentes e à qualidade dos cuidados.

Otimização de custos e recursos

A associação da atividade clínica aos dados financeiros ou operacionais ajuda os hospitais a perceber para onde vão os recursos. As equipas podem comparar os volumes de serviços com os níveis de pessoal ou os custos e utilizar os resultados no planeamento da capacidade.

Melhor análise dos sinistros

Assim que os pedidos de reembolso e os dados clínicos estiverem no mesmo repositório, os analistas podem comparar os serviços faturados com os cuidados de saúde documentados pelos profissionais de saúde. Podem investigar as razões pelas quais as seguradoras recusaram ou pagaram menos do que o devido pelos pedidos de reembolso e identificar problemas recorrentes de faturação.

Análise preditiva

Como a base de dados mantém os dados históricos num único local, as equipas podem utilizá-los para estimar o que é provável que aconteça a seguir. Um modelo pode identificar doentes com maior risco de readmissão ou prever períodos de maior procura. As equipas clínicas e operacionais podem, assim, planear antecipadamente os cuidados de acompanhamento ou a afetação de pessoal.

Apoio à investigação

Os investigadores precisam frequentemente de registos que abranjam muitos doentes ao longo de longos períodos. Um repositório de dados proporciona-lhes dados prontos para análises de coorte ou estudos retrospetivos, sem que seja necessário reconstruir o conjunto de dados a partir de sistemas distintos de cada vez.

Análise de cuidados de saúde baseada no valor

Nos cuidados de saúde baseados no valor, as equipas precisam de saber se os recursos que utilizam conduzem efetivamente a melhores resultados. Quando a base de dados associa os resultados aos dados sobre a utilização de recursos, os analistas podem comparar grupos de doentes e verificar se um maior gasto ou uma utilização mais intensa dos serviços conduz a melhores resultados nos cuidados de saúde.

Desafios comuns no DWH do setor da saúde

Os benefícios que abordei acima apresentam alguns desafios de implementação, mas são muito mais fáceis de resolver quando se planeiam com antecedência. Uma equipa experiente consegue identificar muitos dos riscos antes que estes se transformem em trabalho adicional ou em problemas de reporte. São estes os aspetos a que eu prestaria atenção desde o início.

Dados fragmentados e interoperabilidade

Um sistema pode identificar um doente através do número do registo médico, enquanto outro utiliza um identificador diferente. Os formatos dos dados também podem variar. As equipas têm de mapear essas diferenças corretamente e atualizar os mapeamentos sempre que um sistema de origem sofrer alterações.

Má qualidade dos dados

Um armazém herda os problemas dos sistemas que o alimentam. Valores em falta ou códigos inconsistentes podem gerar relatórios pouco fiáveis e afetar análises posteriores. As equipas têm de detetar estes problemas antes que outros relatórios ou modelos comecem a basear-se nos mesmos dados.

Registos duplicados de doentes

O mesmo doente pode aparecer mais do que uma vez quando os sistemas utilizam identificadores diferentes ou contêm dados pessoais ligeiramente diferentes. As regras de correspondência têm de identificar essas duplicatas sem combinar acidentalmente registos de pessoas diferentes.

Segurança e privacidade

Um armazém de dados na área da saúde pode conter registos de doentes, a par de dados financeiros e operacionais, mas nem todos os utilizadores devem ter acesso a toda a informação. Os profissionais de saúde podem necessitar de detalhes específicos sobre cada doente, enquanto as equipas financeiras podem precisar apenas de dados de faturação. Defina o acesso de acordo com a função e reveja as permissões sempre que adicionar uma nova fonte de dados.

Governação

As equipas precisam de regras claras sobre quem é o responsável pelos dados partilhados e quem toma as decisões a esse respeito. Por exemplo, se dois departamentos calcularem a mesma métrica de forma diferente, alguém tem de escolher a definição que todos irão utilizar. O mesmo se aplica à aprovação do acesso a dados sensíveis.

Adaptação dos volumes de dados

À medida que o armazém acumula mais anos de dados e incorpora novas fontes, as consultas podem tornar-se mais lentas e os custos de armazenamento podem aumentar. As equipas precisam de planear a forma como organizam os dados mais antigos e durante quanto tempo os mantêm, para que o crescimento não torne a elaboração de relatórios diários mais difícil.

Falta de competências internas em engenharia de dados

A vossa equipa pode conhecer bem os sistemas de saúde, mas ter pouca experiência na criação de um armazém de dados em torno deles. Nesse caso, os engenheiros de dados externos podem ajudar a conceber os fluxos de dados e o modelo de dados, enquanto a vossa equipa interna define o que os dados têm de suportar.

Modelos de armazenamento de dados na área da saúde

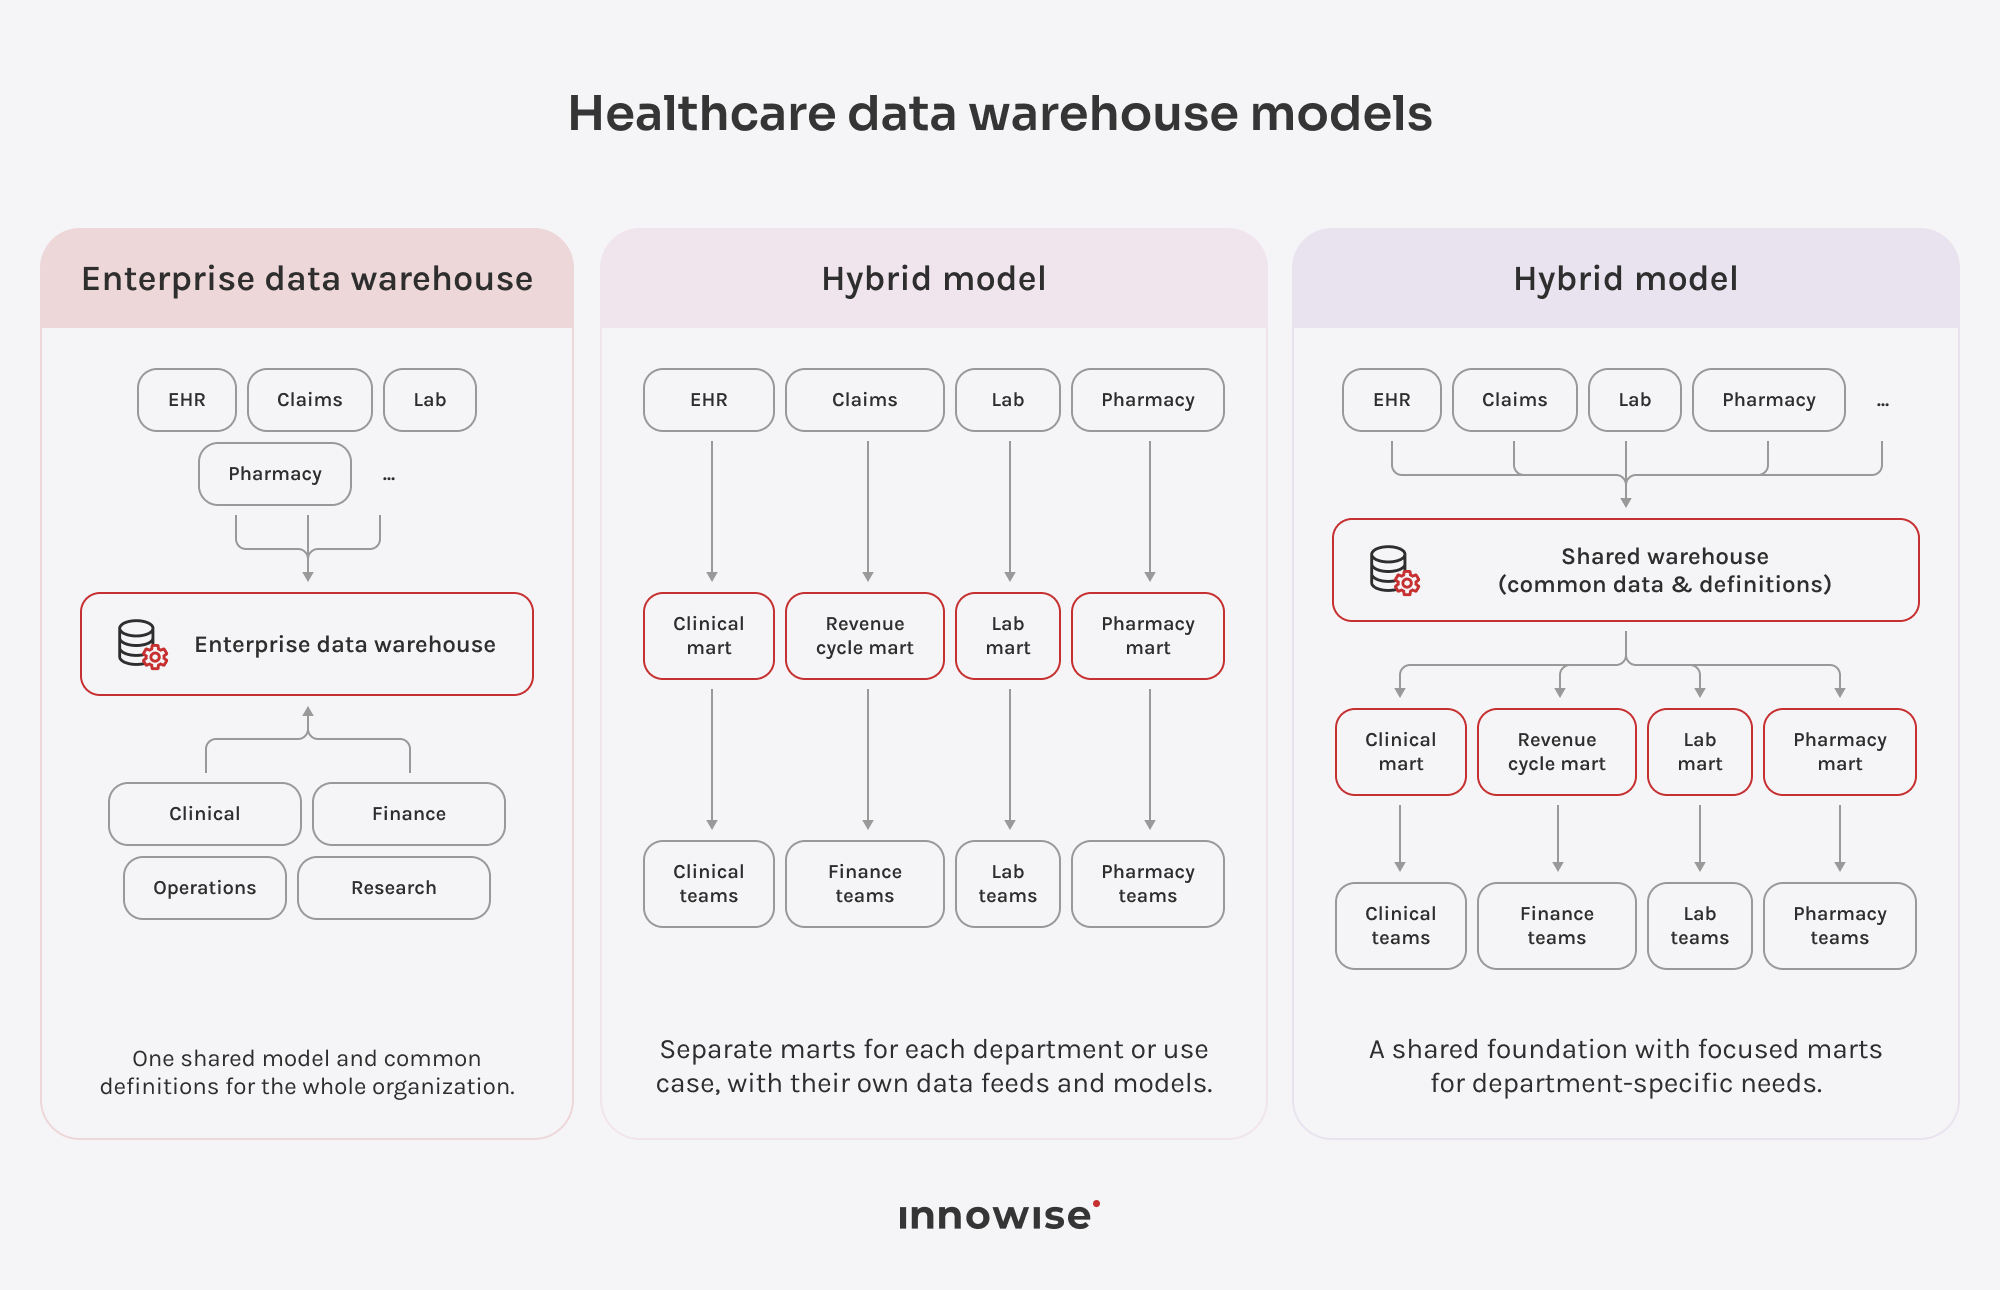
O modelo adequado de armazém de dados na área da saúde depende do grau de centralização que se pretende para a gestão de dados e do nível de independência de que os departamentos individuais necessitam. Na prática, as organizações costumam escolher entre três modelos:

Armazém de dados empresarial

Um armazém de dados empresarial no setor da saúde utiliza um modelo de dados partilhado por toda a organização, para que os diferentes departamentos trabalhem com definições e regras de elaboração de relatórios coerentes. As equipas clínicas e financeiras, por exemplo, podem calcular a duração média da estadia da mesma forma, em vez de definirem essa métrica separadamente nos seus próprios relatórios.

Ao nível dos dados, as equipas podem padronizar entidades centrais, tais como doentes, consultas, prestadores de cuidados de saúde e unidades de saúde, e mapear os registos do sistema de origem para essas estruturas partilhadas. A contrapartida é que têm de chegar a acordo sobre essas definições numa fase inicial e mantê-las alinhadas à medida que o armazém de dados cresce. Isso exige mais trabalho inicial, especialmente numa organização de grande dimensão, onde a terminologia e as necessidades de relatórios estão em constante mudança. Quando muitos relatórios dependem do modelo partilhado, mesmo uma pequena alteração numa definição fundamental pode afetar várias equipas ao mesmo tempo.

Data marts independentes

Um data mart independente centra-se num único departamento ou num caso de utilização analítica, em vez de modelar dados para toda a organização. Uma equipa de oncologia, por exemplo, pode criar um data mart em torno dos sistemas clínicos de que necessita, enquanto os analistas do ciclo de receitas criam outro centrado em dados relativos a pedidos de reembolso e faturação.

Como cada mart tem um âmbito mais restrito, as equipas conseguem, muitas vezes, colocar os primeiros relatórios a funcionar mais cedo. À medida que são adicionados mais marts, o mesmo sistema de origem pode necessitar de pipelines e mapeamentos separados para cada um deles. As definições também podem variar entre departamentos. E, como os marts armazenam frequentemente dados já formatados ou resumidos para um caso de utilização específico, podem carecer dos detalhes necessários para uma análise diferente mais tarde.

Modelo híbrido

Um modelo híbrido combina um armazém de dados empresarial partilhado com data marts criados para departamentos específicos ou necessidades analíticas. Os dados principais e as definições partilhadas permanecem na camada central, enquanto cada data mart adapta esses dados às suas próprias necessidades de relatórios. Como os data marts se alimentam do armazém de dados, as equipas não precisam de criar uma integração separada com cada sistema de origem.

Esta configuração permite que as organizações adicionem novos marts à medida que as necessidades de relatórios mudam, sem terem de modelar todos os casos de utilização futuros logo no início. A parte mais difícil é decidir o que deve ser padronizado a nível central e o que pode permanecer específico de um determinado mart. Se for transferida demasiada lógica para os marts individuais, as definições podem sofrer alterações ao longo do tempo.

Está a planear um DWH para o setor da saúde e a ponderar as suas opções?

Casos de utilização do DWH na área da saúde

As organizações do setor da saúde utilizam armazéns de dados para tarefas muito diferentes, dependendo dos dados que recolhem e das decisões que precisam de tomar. Os exemplos de armazéns de dados na área da saúde apresentados abaixo mostram como isso se traduz no trabalho clínico e operacional.

Gestão da saúde da população

As equipas de saúde pública utilizam dados do banco de dados para identificar grupos de doentes com necessidades de cuidados semelhantes. Por exemplo, podem identificar pessoas cujos exames de rastreio ou acompanhamento estão em atraso e transmitir essas listas às equipas de intervenção no terreno.

Gestão de doenças crónicas

No caso de doenças crónicas, as equipas de cuidados de saúde precisam de verificar quais as alterações que ocorrem entre as consultas. Uma base de dados pode reunir os resultados laboratoriais e o historial de medicação ao longo das consultas, com a inclusão de leituras de dispositivos conectados, sempre que disponíveis. Este historial combinado ajuda as equipas a identificar alterações no estado do doente e a decidir quando poderá ser necessário um acompanhamento mais precoce.

Análise preditiva do risco dos doentes

As equipas utilizam dados históricos do armazém de dados para estimar quais os doentes que apresentam um risco mais elevado de readmissão ou de faltar a uma consulta. Essas pontuações são normalmente comunicadas aos profissionais de saúde através de um sistema de gestão de cuidados ou de acompanhamento. A sua reinserção no próprio Prémio de Saúde Eletrónico (EHR) constitui, geralmente, uma integração separada: os fornecedores de EHR tendem a manter um controlo rigoroso sobre o acesso de gravação.

Investigação clínica e ensaios

A identificação de participantes elegíveis para um estudo começa, muitas vezes, com uma longa lista de critérios de inclusão e exclusão. Os investigadores podem, em primeiro lugar, aplicar esses critérios a dados anonimizados armazenados numa base de dados e reduzir o leque de candidatos antes de analisarem os registos médicos individuais. No caso de investigações realizadas em vários centros, as equipas também podem organizar os registos de diferentes instituições numa estrutura comum antes da análise.

Análise do ciclo de receitas e dos pedidos de reembolso

Podem surgir problemas de pagamento em qualquer momento entre a cobrança inicial e o reembolso final. Ao interligar os dados clínicos, de faturação e de pedidos de reembolso, as equipas de receitas podem identificar em que ponto um pedido de reembolso ficou parado e se o mesmo motivo de recusa se repete frequentemente para um determinado pagador ou procedimento.

Planeamento de pessoal e de capacidade

Os gestores comparam o número de doentes por unidade e por turno com o pessoal escalado para esse mesmo período. Se uma determinada unidade apresentar repetidamente falta de pessoal em certos dias ou durante os períodos de maior afluência, podem ajustar os horários futuros para ter em conta esse padrão.

Otimização dos custos operacionais

Quando os dados financeiros são associados à atividade clínica, as equipas conseguem perceber de onde provêm, na realidade, as despesas operacionais. Podem comparar as despesas por procedimento, unidade ou tipo de cuidados e investigar por que razão os custos são mais elevados em algumas áreas do que noutras.

Processo de implementação

Cada projeto de armazém de dados na área da saúde tem um início diferente. Os passos a seguir dependem dos seus sistemas atuais, da qualidade dos seus dados e do que pretende que o armazém de dados faça. Eis como costumamos abordar esta questão.

01
Descoberta

A nossa equipa define os casos de utilização iniciais, quer sejam de relatórios quer sejam analíticos, para a primeira versão e identifica as pessoas que deles necessitam. Confirmamos também quais os sistemas de origem que se enquadram no âmbito do projeto e assinalamos as restrições regulamentares antes de tomarmos decisões relativas à arquitetura.

02
Avaliação dos dados

Antes de criarmos pipelines, verificamos cada fonte para detetar dados em falta e formatos inconsistentes e, em seguida, verificamos se existem duplicados. Os resultados mostram o que pode permanecer tal como está e onde são necessárias regras de limpeza, antes que esses problemas afetem os relatórios de produção.

03
Arquitectura

Os nossos arquitetos de dados escolhem o modelo do armazém de dados com base na amplitude com que as equipas precisam de partilhar dados e definições. Em seguida, concebem as camadas de ingestão e armazenamento em função dos sistemas da organização e decidem como é que as ferramentas de análise irão aceder ao armazém de dados.

04
Seleção de tecnologias

Depois de definida a arquitetura, a equipa escolhe a plataforma, a abordagem ETL/ELT e as ferramentas de BI ou ML com base no volume de dados e na pilha tecnológica existente. As considerações orçamentais e de conformidade reduzem a lista de opções, especialmente nos casos em que são necessários controlos de acesso ou registos de auditoria.

05
Integração

Os engenheiros de dados ligam o armazém de dados aos sistemas de origem. Dependendo do ambiente, podem utilizar FHIR ou HL7 v2 para dados clínicos, X12 para pedidos de reembolso nos EUA e APIs ou conectores nativos para aplicações empresariais. Testar cada fluxo de dados com dados reais ajuda a detetar erros de mapeamento numa fase precoce.

06
Desenvolvimento

Os engenheiros do Innowise criam pipelines que padronizam formatos e resolvem registos duplicados antes de aplicarem as definições de negócio acordadas. Se o projeto incluir data marts, estes são criados na camada partilhada, em vez de se estabelecerem novas ligações a cada fonte.

07
Migração e testes

A equipa carrega os dados históricos e compara-os com as fontes originais para detetar valores em falta ou alterados. Em seguida, os analistas testam os relatórios em função dos casos de utilização definidos na fase de análise, enquanto os utilizadores da empresa analisam os resultados antes da entrada em funcionamento.

08
Lançamento

No lançamento, a nossa equipa costuma executar relatórios antigos e novos em paralelo, para que os utilizadores possam comparar os números antes de fazerem a transição. Também acompanhamos de perto a utilização inicial em produção, porque é aqui que tendem a surgir problemas relacionados com dados ou desempenho que não foram detetados durante os testes.

09
Suporte

Após a entrada em funcionamento, monitorizamos o desempenho, adicionamos novas fontes e mantemos os processos de governação que garantem a consistência das definições partilhadas. Normalmente, esta é uma das fases mais longas do projeto e uma das mais fáceis de subestimar durante o planeamento.

arrow-icon. arrow-icon.
01 Descoberta

A nossa equipa define os casos de utilização iniciais, quer sejam de relatórios quer sejam analíticos, para a primeira versão e identifica as pessoas que deles necessitam. Confirmamos também quais os sistemas de origem que se enquadram no âmbito do projeto e assinalamos as restrições regulamentares antes de tomarmos decisões relativas à arquitetura.

arrow-icon. arrow-icon.
02 Avaliação dos dados

Antes de criarmos pipelines, verificamos cada fonte para detetar dados em falta e formatos inconsistentes e, em seguida, verificamos se existem duplicados. Os resultados mostram o que pode permanecer tal como está e onde são necessárias regras de limpeza, antes que esses problemas afetem os relatórios de produção.

arrow-icon. arrow-icon.
03 Arquitectura

Os nossos arquitetos de dados escolhem o modelo do armazém de dados com base na amplitude com que as equipas precisam de partilhar dados e definições. Em seguida, concebem as camadas de ingestão e armazenamento em função dos sistemas da organização e decidem como é que as ferramentas de análise irão aceder ao armazém de dados.

arrow-icon. arrow-icon.
04 Seleção de tecnologias

Depois de definida a arquitetura, a equipa escolhe a plataforma, a abordagem ETL/ELT e as ferramentas de BI ou ML com base no volume de dados e na pilha tecnológica existente. As considerações orçamentais e de conformidade reduzem a lista de opções, especialmente nos casos em que são necessários controlos de acesso ou registos de auditoria.

arrow-icon. arrow-icon.
05 Integração

Os engenheiros de dados ligam o armazém de dados aos sistemas de origem. Dependendo do ambiente, podem utilizar FHIR ou HL7 v2 para dados clínicos, X12 para pedidos de reembolso nos EUA e APIs ou conectores nativos para aplicações empresariais. Testar cada fluxo de dados com dados reais ajuda a detetar erros de mapeamento numa fase precoce.

arrow-icon. arrow-icon.
06 Desenvolvimento

Os engenheiros do Innowise criam pipelines que padronizam formatos e resolvem registos duplicados antes de aplicarem as definições de negócio acordadas. Se o projeto incluir data marts, estes são criados na camada partilhada, em vez de se estabelecerem novas ligações a cada fonte.

arrow-icon. arrow-icon.
07 Migração e testes

A equipa carrega os dados históricos e compara-os com as fontes originais para detetar valores em falta ou alterados. Em seguida, os analistas testam os relatórios em função dos casos de utilização definidos na fase de análise, enquanto os utilizadores da empresa analisam os resultados antes da entrada em funcionamento.

arrow-icon. arrow-icon.
08 Lançamento

No lançamento, a nossa equipa costuma executar relatórios antigos e novos em paralelo, para que os utilizadores possam comparar os números antes de fazerem a transição. Também acompanhamos de perto a utilização inicial em produção, porque é aqui que tendem a surgir problemas relacionados com dados ou desempenho que não foram detetados durante os testes.

arrow-icon. arrow-icon.
09 Suporte

Após a entrada em funcionamento, monitorizamos o desempenho, adicionamos novas fontes e mantemos os processos de governação que garantem a consistência das definições partilhadas. Normalmente, esta é uma das fases mais longas do projeto e uma das mais fáceis de subestimar durante o planeamento.

Serviços de armazenamento de dados na área da saúde

Se estiver a criar um DWH na área da saúde a partir do zero, irá precisar de um apoio diferente daquele necessário caso esteja a corrigir ou a expandir um já existente. A Innowise pode intervir em qualquer uma dessas fases e assumir o trabalho que a sua configuração exigir.

  • Consultoria em armazéns de dados na área da saúde
  • Arquitetura e design
  • Desenvolvimento de um DWH
  • Integração e migração de dados
  • Modernização do DWH legado
  • Integração de BI e análise de dados
  • Suporte e otimização

Consultoria em armazéns de dados na área da saúde

Se já tem problemas com a elaboração de relatórios ou se dispõe de um armazém que já não se adequa às necessidades, analisamos o que é necessário alterar. A nossa equipa analisa a configuração atual e compara as opções disponíveis. A partir daí, ajudamo-lo a decidir quais os casos de utilização que devem ter prioridade.

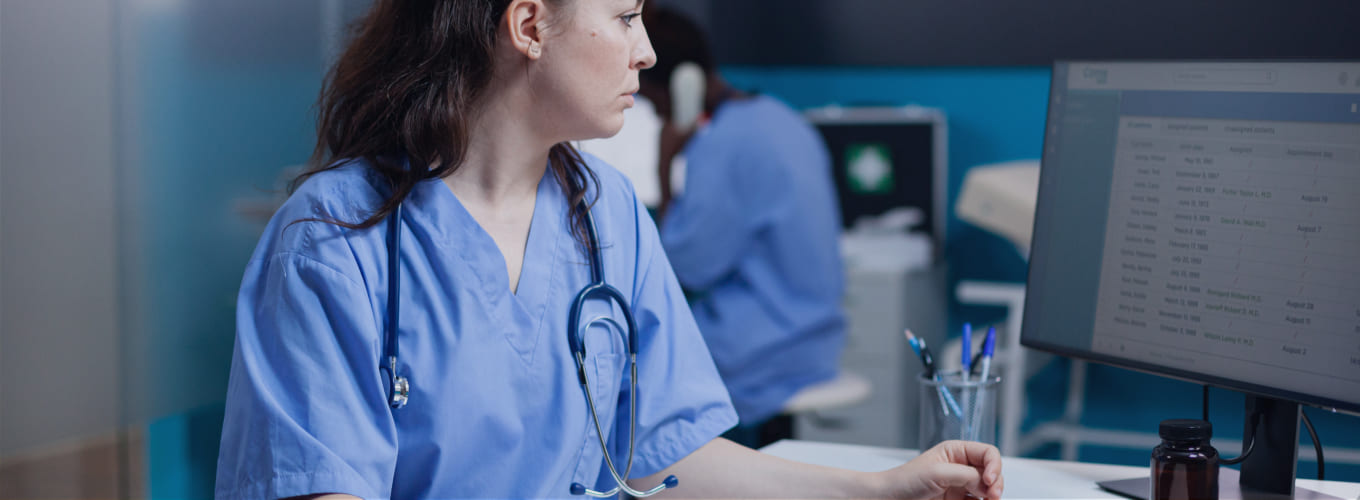
Nurse reviews lab results and medication history in EHR system before patient rounds.

Arquitetura e design

Uma vez acordados os requisitos, os nossos arquitetos concebem uma estrutura de armazenamento em função dos seus sistemas e das cargas de trabalho previstas. Definem como os principais componentes se interligam e onde são armazenados os dados partilhados. A estrutura pode, então, acomodar novas fontes ou necessidades de relatórios à medida que estas surjam.

Building layouts and style guides for a new web application project.

Desenvolvimento de um DWH

Assim que o projeto for aprovado, os nossos engenheiros criam o DWH, incluindo a lógica de transformação e quaisquer data marts necessários. Incorporam verificações de qualidade e controlos de segurança durante o desenvolvimento, para que o armazém de dados possa dar resposta aos relatórios e análises exigidos pelo projeto.

IT specialist analyzing software code during an evening sprint session.

Integração e migração de dados

Ligamos o armazém de dados ao EHR/EMR, aos registos de reclamações, ao laboratório, ao ERP/CRM e a outros sistemas de origem. Os dados históricos são, em seguida, transferidos para o modelo de destino com os mapeamentos e transformações necessários. Antes da transição, são realizadas verificações de reconciliação para comparar os dados migrados com a sua fonte.

Data engineer interacts with a visual dashboard to orchestrate real-time data synchronization across systems.

Modernização do DWH legado

À medida que as fontes de dados e as necessidades de elaboração de relatórios evoluem, um armazém de dados já existente pode necessitar de mais do que apenas manutenção de rotina. Atualizamos modelos de dados e fluxos de dados desatualizados, transferimos cargas de trabalho quando a plataforma atual se torna um obstáculo e automatizamos tarefas repetitivas de gestão de dados sempre que tal se justifica.

IT operations team tracks software patch rollout in real time via a mobile device interface.

Integração de BI e análise de dados

Os nossos especialistas ligam o armazém de dados às ferramentas de BI e de análise que as suas equipas já utilizam. Dependendo da configuração, podem importar dados ou consultar o armazém de dados diretamente. As métricas partilhadas e as regras de elaboração de relatórios ficam num único local, em vez de terem de ser recriadas em cada painel de controlo.

Accessing a centralized analytics portal to evaluate company operations and outcomes.

Suporte e otimização

Após a implementação, o armazém de dados vai-se adaptando continuamente às suas necessidades em termos de dados e relatórios. A nossa equipa pode resolver problemas relacionados com o fluxo de dados ou com os dados propriamente ditos, adicionar novas fontes, otimizar consultas lentas e atualizar modelos quando os requisitos empresariais se alteram.

The consulting team reviews analytics on screen, focusing on data-driven IT strategy and solutions.
Consultoria em armazéns de dados na área da saúde

Se já tem problemas com a elaboração de relatórios ou se dispõe de um armazém que já não se adequa às necessidades, analisamos o que é necessário alterar. A nossa equipa analisa a configuração atual e compara as opções disponíveis. A partir daí, ajudamo-lo a decidir quais os casos de utilização que devem ter prioridade.

Nurse reviews lab results and medication history in EHR system before patient rounds.
Arquitetura e design

Uma vez acordados os requisitos, os nossos arquitetos concebem uma estrutura de armazenamento em função dos seus sistemas e das cargas de trabalho previstas. Definem como os principais componentes se interligam e onde são armazenados os dados partilhados. A estrutura pode, então, acomodar novas fontes ou necessidades de relatórios à medida que estas surjam.

Building layouts and style guides for a new web application project.
Desenvolvimento de um DWH

Assim que o projeto for aprovado, os nossos engenheiros criam o DWH, incluindo a lógica de transformação e quaisquer data marts necessários. Incorporam verificações de qualidade e controlos de segurança durante o desenvolvimento, para que o armazém de dados possa dar resposta aos relatórios e análises exigidos pelo projeto.

IT specialist analyzing software code during an evening sprint session.
Integração e migração de dados

Ligamos o armazém de dados ao EHR/EMR, aos registos de reclamações, ao laboratório, ao ERP/CRM e a outros sistemas de origem. Os dados históricos são, em seguida, transferidos para o modelo de destino com os mapeamentos e transformações necessários. Antes da transição, são realizadas verificações de reconciliação para comparar os dados migrados com a sua fonte.

Data engineer interacts with a visual dashboard to orchestrate real-time data synchronization across systems.
Modernização do DWH legado

À medida que as fontes de dados e as necessidades de elaboração de relatórios evoluem, um armazém de dados já existente pode necessitar de mais do que apenas manutenção de rotina. Atualizamos modelos de dados e fluxos de dados desatualizados, transferimos cargas de trabalho quando a plataforma atual se torna um obstáculo e automatizamos tarefas repetitivas de gestão de dados sempre que tal se justifica.

IT operations team tracks software patch rollout in real time via a mobile device interface.
Integração de BI e análise de dados

Os nossos especialistas ligam o armazém de dados às ferramentas de BI e de análise que as suas equipas já utilizam. Dependendo da configuração, podem importar dados ou consultar o armazém de dados diretamente. As métricas partilhadas e as regras de elaboração de relatórios ficam num único local, em vez de terem de ser recriadas em cada painel de controlo.

Accessing a centralized analytics portal to evaluate company operations and outcomes.
Suporte e otimização

Após a implementação, o armazém de dados vai-se adaptando continuamente às suas necessidades em termos de dados e relatórios. A nossa equipa pode resolver problemas relacionados com o fluxo de dados ou com os dados propriamente ditos, adicionar novas fontes, otimizar consultas lentas e atualizar modelos quando os requisitos empresariais se alteram.

The consulting team reviews analytics on screen, focusing on data-driven IT strategy and solutions.

Precisa de modernizar a sua infraestrutura de dados na área da saúde?

Fornecedores de armazéns de dados na área da saúde

Se estiver a comparar plataformas para um armazém na área da saúde, o seu ambiente de nuvem atual é um bom ponto de partida. As opções abaixo tratam os dados da área da saúde de forma diferente, e os seus modelos de computação e de preços também variam.

Amazon-Redshift-Logo (1)

Amazon Redshift

O Redshift integra-se naturalmente quando a maior parte dos seus dados já se encontra na AWS. Funciona com o S3 e o AWS Glue, enquanto o HealthLake pode exportar dados FHIR para o S3, para análise posterior através do Redshift ou de outros serviços de análise da AWS.

Características principais

  • SQL para dados estruturados e semiestruturados
  • Acesso ao S3 através do Redshift Spectrum
  • Consultas federadas a bases de dados da AWS compatíveis
  • Controlos de acesso ao nível das linhas e das colunas
  • Separar a capacidade de computação do armazenamento gerido
  • Serviço da AWS em conformidade com a HIPAA 

Preços

  • Preços «à pedido» para clusters provisionados
  • Computação sem servidor faturada com base na utilização
  • Encargos relativos ao armazenamento gerido separadamente
  • Preços reservados para cargas de trabalho constantes
Azure Synapse Analytics

Azure Synapse Analytics

O Synapse funciona bem quando os seus dados e relatórios já são gerados no Azure e as suas equipas utilizam o Power BI. Reúne o armazenamento de dados SQL e o Spark num único espaço de trabalho, com pipelines para a transferência de dados entre os serviços do Azure. Os dados FHIR provenientes dos Serviços de Dados de Saúde do Azure também podem ser copiados para o Synapse para análise.

Características principais

  • SQL dedicado e sem servidor
  • Pools do Apache Spark
  • Consultas no Data Lake Azure
  • Pipelines ETL/ELT integrados
  • Integrações ML do Power BI e do Azure
  • Análise de dados FHIR com os Serviços de Dados de Saúde Azure

Preços

  • SQL sem servidor, cobrado com base nos dados processados
  • SQL dedicado faturado com base na utilização de DWU
  • O Spark é faturado com base na utilização do vCore
  • Opções de pré-compra para cargas de trabalho comprometidas

Para as equipas que pretendem maior liberdade na escolha de fornecedores de serviços na nuvem, o Snowflake torna a camada do armazém de dados menos dependente de um único ecossistema. Funciona na AWS, no Azure e no Google Cloud, enquanto os armazéns virtuais independentes permitem que as equipas atribuam recursos de computação específicos a diferentes cargas de trabalho.

Características principais

  • Opções de implementação em múltiplas nuvens
  • Capacidade de computação independente para diferentes cargas de trabalho
  • Armazéns com vários clusters na Enterprise Edition+
  • Suporte nativo a dados semiestruturados
  • Partilha segura de dados
  • Suporte PHI com o Business Critical+

Preços

  • Créditos de computação baseados no consumo
  • Encargos de armazenamento separados
  • Capacidade sob demanda ou pré-paga 
  • Os preços variam consoante a plataforma na nuvem, a região e a edição
GCP BigQuery

Google BigQuery

O BigQuery é adequado para organizações que já utilizam o Google Cloud ou que pretendem um armazém de dados sem servidor, sem terem de gerir clusters de computação. A API Cloud Healthcare permite exportar recursos FHIR e metadados DICOM para o BigQuery, proporcionando às equipas de análise acesso a dados de saúde através de SQL.

Características principais

  • Armazenamento de dados SQL sem servidor
  • Armazenamento e processamento separados
  • Funcionalidades integradas de aprendizagem automática
  • Consultas externas e federadas
  • Integração da API Cloud para o setor da saúde
  • O BigQuery está abrangido pelo Acordo de Parceria HIPAA (BAA) da Google Cloud

Preços

  • Recursos de computação sob demanda faturados com base nos dados processados
  • Tarifação de capacidade com base em intervalos horários
  • O armazenamento é cobrado separadamente
  • Compromissos disponíveis para capacidade reservada

Custos e prazos

Os orçamentos para armazéns de dados na área da saúde podem variar em mais de uma ordem de grandeza. Um data mart de produção limitado, com algumas fontes de dados limpas, pode custar cerca de $60 000–$100 000 e demorar 2 a 4 meses. Um armazém empresarial multissistema, com migração de dados históricos e vários data marts, pode atingir um custo entre $400 000 e $1 milhão ou mais e demorar entre 9 e 18 meses, ou mais.

Escala do projetoÂmbito típicoLinha do tempoOrçamento de execuçãoCustos recorrentes com a nuvem e o software
Data mart do departamento1–2 sistemas de origem, um departamento, histórico limitado, relatórios básicos de BI2 a 4 meses$60k–$100k$1k–$5k/mês
DWH de saúde de média dimensão3 a 6 fontes, modelo de dados partilhado, migração de dados históricos, 2 a 4 data marts, integração com BI5 a 9 meses$150k–$350k$5k–$20k/mês
DWH empresarial / lakehouseMais de 7 fontes, dados históricos abrangentes, múltiplas plataformas de dados, integrações clínicas personalizadas, análises avançadas9–18+ meses$400k–$1m+$20k–$80k+/mês

Soluções na área da saúde fornecidas pela Innowise

Porquê escolher-nos

Um projeto de DWH na área da saúde situa-se entre a engenharia de dados e a área da saúde IT. A Innowise possui experiência em ambas as áreas, apoiada por certificações ISO relevantes e parcerias com os fornecedores de serviços na nuvem e de dados utilizados em projetos de armazenamento de dados.

Experiência na área da saúde

Contamos com mais de 19 anos de experiência na área da saúde IT, incluindo trabalho com registos de saúde eletrónicos (EHR), sistemas laboratoriais, imagiologia médica e plataformas de saúde conectadas. Essa experiência é fundamental quando os fluxos de trabalho clínicos ou as normas relativas aos dados de saúde determinam a conceção do armazém de dados.

Conhecimentos especializados em engenharia de dados

As nossas equipas de dados trabalham com o Snowflake, o BigQuery, o Amazon Redshift e o Azure Synapse, juntamente com as ferramentas de ETL/ELT e de orquestração que os suportam. Isso significa que podemos conceber o armazém de dados em função da pilha de tecnologias existente do cliente, em vez de nos limitarmos a uma plataforma preferencial.

Certificações relevantes

A Innowise possui as certificações ISO 9001, ISO 27001 e ISO 13485, que abrangem normas de qualidade, segurança da informação e dispositivos médicos.

Registo de entregas

O nosso historial inclui mais de 1 600 projetos em diversos setores e mais de 60 soluções IT na área da saúde. Para uma empresa de medicina de precisão, nós melhoria dos fluxos de dados e da infraestrutura da AWS utilizado para processar dados de diagnóstico provenientes de várias fontes.
Experiência em segurança e conformidade

As nossas equipas de cuidados de saúde trabalham em conformidade com os requisitos da HIPAA e do RGPD, bem como com normas de intercâmbio de dados na área da saúde, tais como a HL7 v2 e a FHIR. Essa experiência é relevante quando dados sensíveis relativos à saúde são transferidos entre o armazém de dados e os sistemas clínicos regulamentados.

Parcerias tecnológicas

Enquanto parceira da AWS, da Microsoft, da Google Cloud e da Databricks, a Innowise contribui com conhecimentos especializados e certificados sobre as plataformas para projetos de DWH e pode recorrer ao apoio dos fornecedores sempre que surjam problemas específicos das plataformas.

ISO 13485 certification.
ISO 9001 certification.
ISO/IEC 27001 certification.
GDPR
Select partner AWS
Google_Cloud_Partner

Conclusão

Eu não começaria um projeto de armazém de dados na área da saúde tentando transferir todos os conjuntos de dados para um único local. Em vez disso, escolha um problema de relatórios ou análise que valha a pena resolver e ligue apenas os sistemas necessários para essa tarefa. Por exemplo, pode começar com relatórios sobre o ciclo de receitas ou com a análise de readmissões. Assim que isso estiver a funcionar, pode decidir o que o armazém precisa a seguir, com base na procura real. 

Esta abordagem deve manter-se à medida que o projeto cresce. Adicione novas fontes ou data marts apenas quando houver uma razão clara para tal, em vez de tentar antecipar todas as necessidades futuras possíveis. O importante é manter a consistência das definições e das regras de acesso à medida que o armazém de dados se expande e garantir que os requisitos de conformidade sejam sempre cumpridos. 

Se precisar de apoio externo, os especialistas da Centro de Saúde e Farmacêutica Innowise IT pode analisar o seu armazém de dados atual ou ajudar a criar um adaptado aos seus sistemas de saúde e às suas necessidades de elaboração de relatórios, tendo em conta os requisitos de conformidade relativos aos dados de saúde.

FAQ

Um armazém de dados na área da saúde guarda dados preparados para a elaboração de relatórios e análises. Um lago de dados, por sua vez, armazena normalmente volumes maiores de dados em bruto ou ligeiramente processados. Em muitas arquiteturas, o lago de dados armazena conjuntos de dados mais abrangentes, enquanto o armazém de dados contém os dados de que as equipas necessitam para análises clínicas, financeiras ou operacionais recorrentes.

Os prazos variam consoante o âmbito, os sistemas de origem e a qualidade dos dados. A criação de um data mart específico com poucas integrações pode demorar entre 2 e 4 meses. A implementação de um data warehouse empresarial de maior dimensão no setor da saúde pode demorar entre 9 e 18 meses, ou mais, quando o projeto inclui a migração de dados legados, múltiplas integrações e vários data marts.

O modelo adequado de armazém de dados na área da saúde depende do número de equipas que necessitam dos dados e se estas devem utilizar as mesmas definições de relatórios. Um modelo empresarial suporta a elaboração de relatórios a nível de toda a organização, enquanto os armazéns independentes se centram em departamentos específicos ou casos de utilização. Um modelo híbrido combina um núcleo partilhado com armazéns mais específicos. A conceção do armazém de dados na área da saúde deve refletir os casos de utilização que é necessário apoiar em primeiro lugar.

Sim. Podemos modernizar o seu armazém de dados de saúde existente sem ter de o substituir de uma só vez. A nossa equipa reconstrói pipelines desatualizados, revê modelos de dados, transfere cargas de trabalho selecionadas e integra novas ferramentas de análise por fases. A automatização do armazém de dados de saúde também reduz o trabalho manual na ingestão de dados e nas verificações recorrentes da qualidade dos dados.

A Innowise concebe o armazém de dados tendo em conta os requisitos da HIPAA desde o início, com o acesso às informações de saúde protegidas (PHI) restringido por função e controlos de segurança integrados nos fluxos de dados. Também validamos os dados à medida que estes circulam pelo armazém de dados, verificando se existem mapeamentos incorretos, registos de doentes duplicados ou valores alterados, antes que estes afetem a elaboração de relatórios.

Mostrar tudo

Índice

    Contactar-nos

    Marcar uma chamada ou preencha o formulário abaixo e entraremos em contacto consigo assim que tivermos processado o seu pedido.

    Envie-nos uma mensagem de voz
    Anexar documentos
    Enviar ficheiro

    Pode anexar um ficheiro com um máximo de 2MB. Formatos de ficheiro válidos: pdf, jpg, jpeg, png.

    Ao clicar em Enviar, o utilizador autoriza a Innowise a processar os seus dados pessoais de acordo com a nossa Política de privacidade para lhe fornecer informações relevantes. Ao enviar o seu número de telefone, o utilizador aceita que o possamos contactar através de chamadas de voz, SMS e aplicações de mensagens. Poderão ser aplicadas tarifas de chamadas, mensagens e dados.

    Pode também enviar-nos o seu pedido
    para contact@innowise.com
    O que é que acontece a seguir?
    1

    Assim que recebermos e processarmos o seu pedido, entraremos em contacto consigo para necessidades do seu projeto e assinar um NDA para garantir a confidencialidade.

    2

    Depois de analisarmos os seus desejos, necessidades e expectativas, a nossa equipa elaborará uma proposta de projeto proposta de projeto com o âmbito do trabalho, dimensão da equipa, tempo e estimativas de custos.

    3

    Marcaremos uma reunião consigo para discutir a oferta e acertar os pormenores.

    4

    Por fim, assinaremos um contrato e começaremos a trabalhar no seu projeto imediatamente.

    Mais serviços abrangidos

    arrow