Datavarehus för hälso- och sjukvården: fördelar, arkitektur och användningsfall

21 september 2026 12 min läsa
Aleh Yafimau, Healthcare and MedTech Delivery Manager..
Konsult inom hälso- och sjukvård IT
Verifierad expert
Varje artikel på Innowise är skriven av författare med praktisk erfarenhet. De har en förståelse för ämnet som sträcker sig bortom teorin och bidrar med insikter från verkliga projekt.
Över 19 års erfarenhet
Verifierad expert
Över 19 års erfarenhet
Aleh överbryggar klyftan mellan kliniska behov och tekniskt utförande. Han tillämpar djup domänkunskap för att säkerställa att MedTech-system inte bara är kompatibla, utan också tillräckligt tillförlitliga för att göra en mätbar inverkan på den verkliga sjukvården.
Expertis
Hälso- och sjukvårds IT Medtech Algoritmer
Låt prata

Viktiga lärdomar

  • När patient-, ersättnings-, laboratorie-, ekonomiska och operativa uppgifter lagras i olika system kräver rapporteringen oftast att informationen från olika källor stäms av manuellt. En hdatavarehus för hälso- och sjukvård sammanställer data från dessa system så att teamen kan använda dem för rapportering och analys.
  • Inte ens det bäst utformade lagret kan kompensera för dålig datakvalitet. Problem som dubbla patientregister, inkonsekventa format och motstridiga definitioner kan göra rapporterna opålitliga.
  • Lagermodellen avgör i vilken utsträckning gemensamma data och definitioner delas. Ett företagsdatalager (DWH) används för rapportering på organisationsnivå, medan datamartar är uppbyggda kring specifika avdelningar eller användningsfall. Hybridarkitekturer använder båda. 
  • Affärsanalysen bör utgå från de beslut som lagret ska stödja, allt från folkhälsa och riskbedömning av patienter till klinisk forskning, analys av ersättningsanspråk samt personal- och kapacitetsplanering.
Sammanfatta artikeln med AI

Om dina patientjournaler, laboratorieresultat, ersättningsansökningar och verksamhetsdata finns i olika system kan det kräva mer arbete att få fram ett tillförlitligt svar än själva analysen. Teamet kan behöva sammanställa uppgifterna och kontrollera vad siffrorna egentligen betyder innan de kan använda dem. A datavärdshus för hälso- och sjukvårdsdata (DWH) sammanställer data från dessa system och strukturerar dem för rapportering och analys.

I den här artikeln ska jag förklara hur ett datalager för hälso- och sjukvården byggs upp och vilka funktioner som är viktiga i praktiken. Vi ska också titta på de viktigaste datlagsmodellerna, vanliga användningsfall inom hälso- och sjukvården, affärsnytta, utmaningar vid implementeringen samt de beslut som måste fattas innan projektet inleds.

Vad är ett datalager för hälso- och sjukvårdsdata?

De flesta datavärdshus för hälso- och sjukvårdsdata är en central plattform där data från olika hälso- och sjukvårdssystem rensas, harmoniseras och förbereds för rapportering och analys. Den kan kombinera data från elektroniska patientjournaler (EHR) och elektroniska sjukjournaler (EMR) med försäkringsansökningar, laboratorieresultat, data från patientportaler, uppgifter från ERP- eller CRM-system samt data från anslutna enheter.

En operativ databas stöder vanligtvis en enda applikation och dess dagliga verksamhet. Ett datalager (DWH) är utformat för frågor som kräver data från flera system samtidigt. Om ett sjukhus till exempel vill förstå varför antalet återinläggningar ökar kan analytikerna jämföra diagnoser och behandlingshistorik med ersättningsansökningar, laboratorieresultat och personaluppgifter, istället för att hämta varje datamängd separat.

Till skillnad från ett DWH lagras data i ett datalager vanligtvis innan de har strukturerats för ett specifikt analytiskt ändamål. Det kan rymma stora mängder obearbetade eller lätt bearbetade data i olika format. Ett DWH innehåller däremot förberedda data som teamen kan använda för affärsintelligens (BI), återkommande rapporter och löpande analyser.

Operativ databasDatalagerData lake
HuvudsyfteKör dagliga applikationstransaktionerSamla in data från flera system i ett format som teamen kan rapportera om och analyseraSpara stora mängder av olika typer av data för senare användning
DatakällorData som skapas och används av operativa applikationerData från elektroniska patientjournaler, ersättningssystem, ERP-system, CRM-system och andra affärs- eller kliniska systemData från många källor, däribland strukturerade, delvis strukturerade och ostrukturerade data
Hur data lagrasUppbyggt utifrån applikationens behovRensad och anpassad efter rapporterings- och analysbehovOfta behålls den i sin ursprungliga form och struktureras endast när ett användningsfall kräver det
Typiska användningsområden inom hälso- och sjukvårdenEHR-transaktioner, tidsbokningar eller CRM-aktiviteterSystemöverskridande rapportering, affärsintelligens och analys inom hälso- och sjukvårdenStorskaliga datamängder, utforskande analyser eller maskininlärningsarbetsbelastningar

Arkitektur för datalager inom hälso- och sjukvården

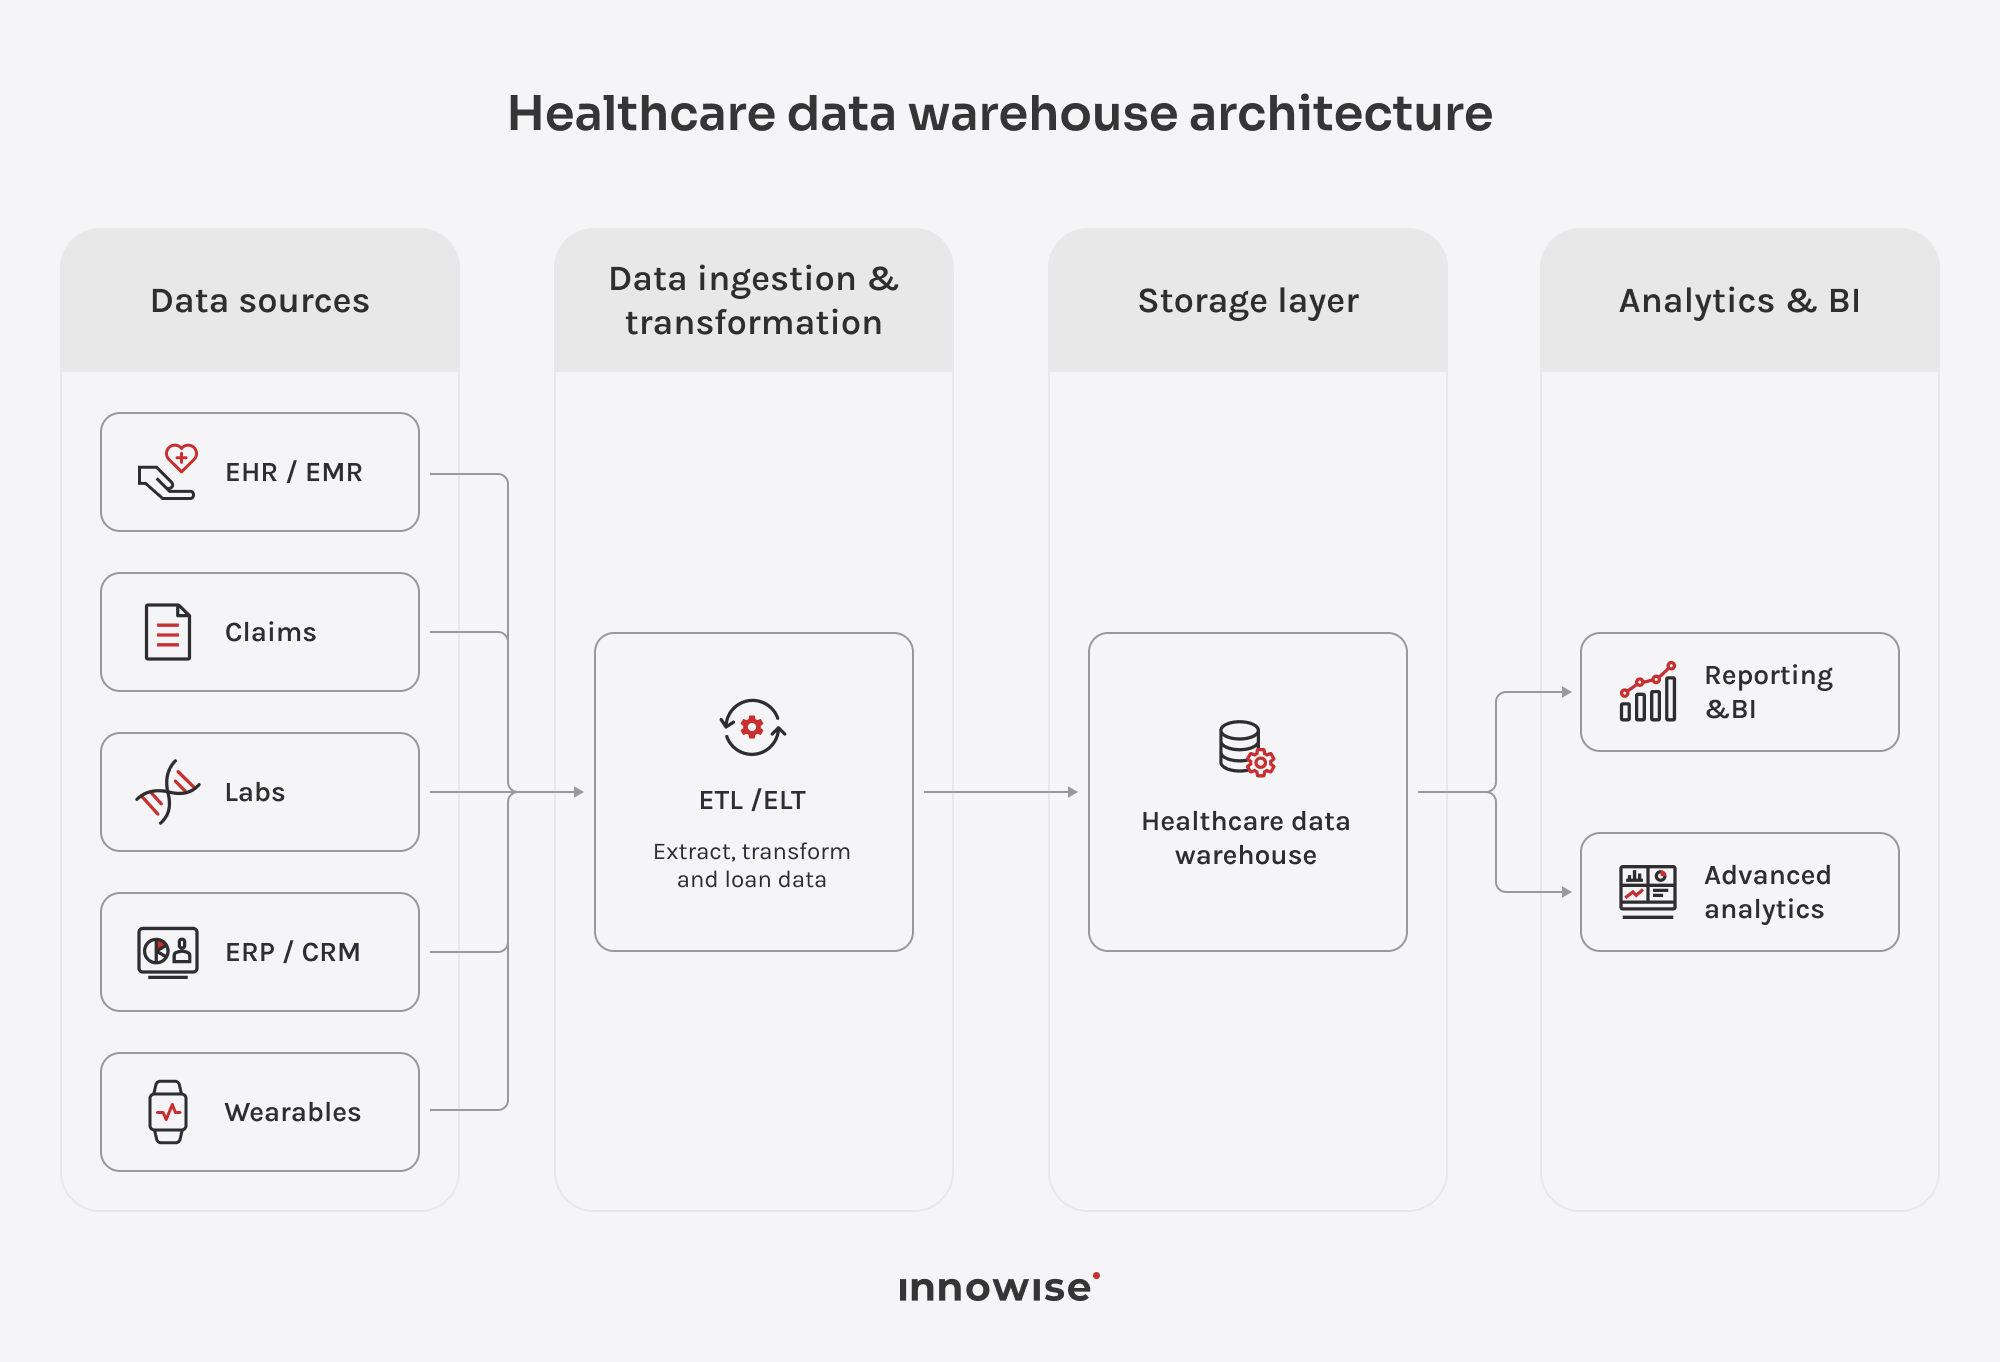
För att bättre förstå hur ett datalager för hälso- och sjukvårdsdata fungerar ska vi titta på de viktigaste lagren som ligger till grund för det. Varje lager har en specifik roll när det gäller att överföra data från källsystemen till lagringsplatsen och sedan göra dem tillgängliga för rapportering, analys och applikationer.

Datakällor

Källskiktet omfattar de system som redan används för kliniskt och administrativt arbete, såsom elektroniska patientjournaler (EHR) och elektroniska medicinska journaler (EMR), ersättningsplattformar, LIS och RIS/PACS samt ERP- eller CRM-programvara. Samma patient eller händelse kan registreras på olika sätt i dessa system, vilket innebär att man måste anpassa formaten och matcha identifierare innan uppgifterna kan användas tillsammans.

Inläsning och ETL/ELT

Detta lager samlar in källdata och förbereder dem för analys. Vid ETL omvandlas data innan de laddas in i datalagret; vid ELT sker omvandlingen efter inläsningen. Processen kan även omfatta standardisering av format, borttagning av dubbletter och tillfällig mellanlagring.

Förvaring

Lagringslagret lagrar historiska data i en struktur som är utformad för rapportering och analys. Beroende på arkitekturen kan det även tillhandahålla datamartar för en specifik avdelning eller ett specifikt användningsfall.

Analys och affärsintelligens

BI-verktyg använder data från datalagret för instrumentpaneler och återkommande rapporter, medan analytiker kan köra ad hoc-frågor mot samma datamängd. Detta ger teamen en gemensam källa för analys istället för att behöva bygga upp logiken på nytt för varje rapport.

Tillämpningar

Data från datalagret kan även ligga till grund för efterföljande kliniska eller affärsmässiga tillämpningar. Forskningsverktyg eller planeringssystem kan till exempel använda bearbetade data från datalagret istället för att ansluta sig separat till varje enskilt källsystem.

Behöver du en samlad och tillförlitlig översikt över både kliniska och affärsrelaterade data?

Viktiga funktioner och egenskaper

Nu när vi har gått igenom arkitekturen ska jag titta närmare på de funktioner som man ofta finner i ett datalager för hälso- och sjukvården. Varje organisation är lite annorlunda, men många av samma behov uppstår när data från olika system måste sammanföras och samtidigt förbli användbara för rapportering och analys.

Dataintegration och ETL/ELT

Vårdsystemen lagrar ofta samma information på olika sätt. En elektronisk patientjournal (EHR), en ersättningsplattform eller ett laboratoriesystem kan använda olika fält och format för jämförbara poster. ETL- och ELT-pipelines samlar in dessa data och samordnar dem i datalagret för analys. Beroende på hur ofta data förändras kan pipelines köras enligt ett schema, endast ladda in nya poster eller bearbeta uppdateringar allteftersom de kommer in.

Hälso- och sjukvårdsdata ändras även i efterhand: laboratorieresultat korrigeras, vårdbesök uppdateras eller avbokas och ersättningsansökningar justeras eller ogiltigförklaras. Bearbetningsflödena måste tillämpa dessa ändringar på redan inlästa uppgifter; annars riskerar en ny körning av förra månadens rapport att inte längre stämma överens med källan.

Datakvalitet och avduplicering

Dubbletter av patientjournaler och motstridiga värden kan snedvrida rapporterna när uppgifterna väl har nått datalagret. Kvalitetskontroller upptäcker saknade eller ogiltiga uppgifter, medan matchningsregler hjälper till att koppla samman poster som tillhör samma patient mellan olika system. Teamen behöver denna rensning innan de jämför resultat eller tar fram analyser.

Hantering av metadata

Metadata förklarar vad varje fält betyder och varifrån det kommer. Det dokumenterar också ändringar som gjorts innan data nådde datalagret. Analytiker kan spåra en siffra i en instrumentpanel tillbaka till dess källa och kontrollera vilken definition som använts.

Datastyrning

Datastyrning fastställer vem som äger data och vilka definitioner alla ska använda. Utan tydliga regler kan två avdelningar använda samma datalager och ändå rapportera olika siffror för samma mått. Dataägare och dataansvariga granskar ändringar och ser till att definitionerna förblir enhetliga över tid.

Säkerhet och åtkomstkontroll

Ett lager inom hälso- och sjukvården kan innehålla personuppgifter (PHI) tillsammans med känslig verksamhets- eller finansiell information, vilket innebär att åtkomsten inte kan vara densamma för alla. Behörigheter kan begränsa vad en användare ser utifrån sin roll och, vid behov, ända ner till specifika rader eller kolumner. Kryptering skyddar data både vid lagring och överföring, medan revisionsloggar visar vem som har haft åtkomst till dem.

Stöd för strukturerade och halvstrukturerade data

De flesta återkommande rapporterna använder strukturerade tabeller, men hälso- och sjukvårdssystemen genererar även data i andra format. API:er och uppkopplade enheter kan till exempel skicka JSON. Ett datalager kan hantera dessa data utan att först behöva konvertera varje fält till en fast tabell. Ostrukturerade filer, såsom medicinska bilder, lagras vanligtvis i ett datalake eller en objektlagring och länkas tillbaka till datalagrets data vid behov.

Skalbarhet och prestanda

I takt med att mängden lagrad data och antalet sökningar ökar måste datalagret fortsätta att leverera snabba rapporter. Plattformar kan använda partitionering, indexering, cachelagring eller separata beräkningsresurser för att hantera större arbetsbelastningar utan att behöva bygga om datalagrets arkitektur.

Driftskompatibilitet

Ett datalager för hälso- och sjukvård måste utbyta data med elektroniska patientjournaler, laboratoriesystem och andra kliniska plattformar. HL7-standarder som FHIR och HL7 v2 ger teamen gemensamma format för detta utbyte, vilket minskar behovet av anpassad mappning. Äldre eller proprietära system kan fortfarande kräva anpassade kopplingar innan datalagret kan använda deras data.

I vårdprojekt skulle jag inte betrakta resultat eller kostnader isolerat. Med ett datalager (DWH) kan man jämföra faktorer som vistelsetid och återinläggningar med resursanvändning och personalens arbetstid. Det är viktigt inom värdebaserad vård, där man måste förstå både resultatet och vad som krävdes för att uppnå det.
Philip Tikhanovich, Head of Big Data.
Philip Tikhanovich
Chef för Big Data

Integrationer av datalager inom hälso- och sjukvården

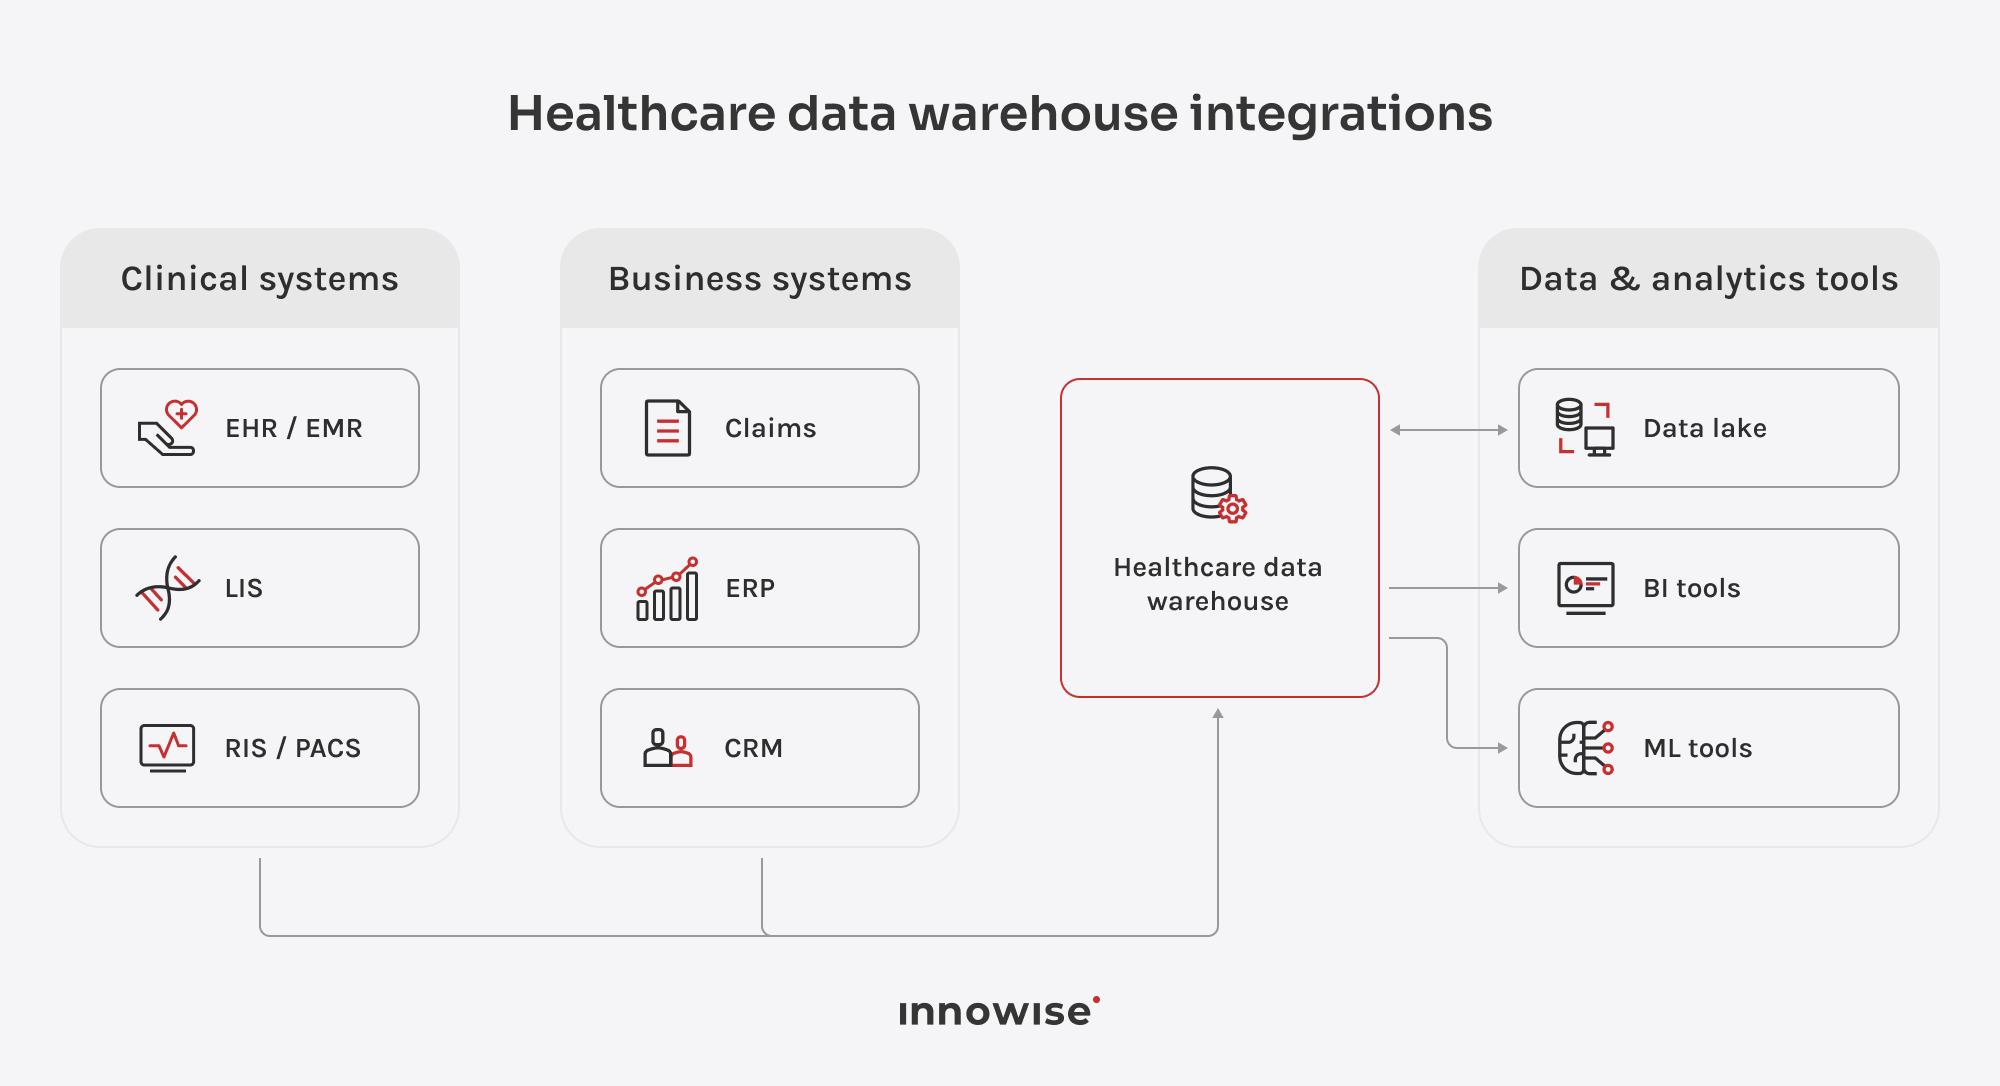
Om du bygger ett kliniskt datalager inom hälso- och sjukvården kopplar du vanligtvis samman de system som dina team redan använder dagligen. De vanligaste integrationerna hämtar data från kliniska system och affärssystem och gör den tillgänglig för BI- och ML-verktyg.

Kliniska system

EHR- och EMR-system skickar vanligtvis strukturerade kliniska data via FHIR-API:er eller HL7 v2-flöden. FHIR fungerar bra för resurser som ”Patient” och ”Encounter”, medan HL7 v2 fortfarande är vanligt för sjukhushändelser och laboratorieresultat. LIS-system använder ofta HL7 v2 ORU-meddelanden för att skicka testresultat till datalagret.

Radiologin fungerar på ett annat sätt eftersom bilddata vanligtvis lagras utanför själva datalagret. PACS eller objektlagring hanterar bilderna, medan datalagret lagrar rapporten och undersökningsmetadata med länkar till motsvarande DICOM-fil.

Affärssystem

Ersättningssystem visar vad vårdgivarna har fakturerat och vad betalningsinstanserna har ersatt. I USA sker datautbytet ofta via X12-transaktioner, bland annat 837-ersättningsfiler och 835-betalningsfiler. Genom att lagra data både på ersättningsnivå och på radnivå kan analytiker jämföra de totala kostnaderna med de enskilda tjänster som ligger till grund för dem.

ERP-system tillhandahåller kostnads- och personaluppgifter, medan CRM-system registrerar kontakter med patienter utanför journalen. När teamen kombinerar denna information med kliniska data kan de undersöka frågor som till exempel om påminnelser om bokade besök förbättrar närvaron eller om personalstyrkan är anpassad till den kliniska verksamheten.

Data och analys

En datalake lagrar rådata eller mindre strukturerade data innan teamen förbereder dem för datalagret. Utvalda datamängder kan rensas i datalaken och sedan laddas in i datalagret. I vissa fall hämtar datalagret data direkt från datalaken istället för att först kopiera dem.

BI-verktyg som Power BI eller Tableau ansluter till datalagret via inbyggda kopplingar eller ODBC/JDBC och läser in förberedda data. ML-plattformar använder historiska data från datalagret för träning eller riskbedömning och skickar sedan modellresultat, till exempel riskpoäng, tillbaka till datalagret för rapporter eller andra tillämpningar.

Affärsmässiga fördelar

Om du utvärderar affärsnyttan av ett datalager för hälso- och sjukvården skulle jag titta på hur det påverkar de team som använder uppgifterna. Fördelarna med ett företagsdatalager inom hälso- och sjukvården, som anges nedan, är de områden där denna påverkan oftast framträder tydligast.

Snabbare rapportering

I stället för att hämta siffror från flera olika system och stämma av dem manuellt kan teamen arbeta med data som redan finns samlad i datalagret. Återkommande rapporter kräver mindre arbete, och analytikerna kan ägna mer tid åt att analysera siffrorna istället för att sammanställa dem.

Samlad patientöversikt

Kliniska uppgifter, ersättningsuppgifter och andra patientrelaterade uppgifter kan kopplas samman mellan olika källsystem för att ge vårdteamet en bredare överblick över patientens sjukdomshistoria. Det gör det enklare att följa vården över flera besök utan att behöva hoppa mellan olika journaler.

Bättre kliniska beslut

Kliniker och analytiker kan använda historiska data från hela organisationen när de besvarar frågor som berör fler än ett system. Detta bredare sammanhang underlättar beslut som rör behandlingsmönster, patientrisk och vårdkvalitet.

Kostnads- och resursoptimering

Genom att koppla samman den kliniska verksamheten med ekonomiska eller operativa uppgifter kan sjukhusen få en överblick över hur resurserna används. Team kan jämföra vårdvolymer med bemanningsnivåer eller kostnader och använda resultaten vid kapacitetsplaneringen.

Förbättrad skadeanalys

När ersättningsansökningarna och de kliniska uppgifterna finns samlade i samma datalager kan analytikerna jämföra de fakturerade tjänsterna med den vård som vårdpersonalen har dokumenterat. De kan undersöka varför försäkringsbolagen har avslagit eller underbetalat ersättningsansökningar och upptäcka återkommande faktureringsproblem.

Prediktiv analys

Eftersom databasen samlar historiska data på ett och samma ställe kan teamen använda den för att göra uppskattningar om vad som sannolikt kommer att hända härnäst. En modell kan till exempel identifiera patienter med högre risk för återinläggning eller förutsäga perioder med ökad efterfrågan. Vård- och driftsteamen kan då planera uppföljningsvård eller bemanning i god tid.

Forskningsstöd

Forskare behöver ofta data som omfattar många patienter under långa tidsperioder. Ett datalager ger dem data som är färdiga för kohortanalys eller retrospektiva studier, utan att de varje gång behöver sammanställa datauppsättningen från olika system.

Värdebaserad vårdanalys

Inom värdebaserad vård måste teamen veta om de resurser de använder faktiskt leder till bättre resultat. När datalagret kopplar samman resultaten med uppgifter om resursanvändningen kan analytikerna jämföra patientgrupper och se om högre kostnader eller ett större utnyttjande av tjänster leder till bättre vårdresultat.

Vanliga utmaningar inom hälso- och sjukvårdens datalager (DWH)

De fördelar som jag har beskrivit ovan medför vissa utmaningar vid implementeringen, men de är mycket lättare att hantera om man planerar för dem i god tid. Ett erfaret team kan upptäcka många av riskerna innan de leder till omarbetningar eller rapporteringsproblem. Det är just dessa som jag skulle hålla ett öga på redan från början.

Fragmenterade data och interoperabilitet

Ett system kan identifiera en patient med hjälp av ett journalnummer, medan ett annat använder ett annat ID. Även dataformaten kan variera. Teamet måste kartlägga dessa skillnader korrekt och uppdatera kopplingarna varje gång ett källsystem ändras.

Dålig datakvalitet

Ett lager får problem från de system som matar in data till det. Saknade värden eller inkonsekventa koder kan leda till opålitliga rapporter och påverka senare analyser. Team måste upptäcka dessa problem innan andra rapporter eller modeller börjar basera sig på samma data.

Dubbla patientjournaler

Samma patient kan förekomma mer än en gång om systemen använder olika identifierare eller innehåller något olika personuppgifter. Matchningsreglerna måste identifiera dessa dubbletter utan att av misstag slå samman poster som gäller olika personer.

Säkerhet och integritet

Ett vårddatabaslager kan innehålla patientjournaler samt ekonomiska och operativa uppgifter, men inte alla användare bör ha tillgång till all information. Vårdpersonal kan behöva detaljer på patientnivå, medan ekonomiavdelningen kanske endast behöver faktureringsuppgifter. Ställ in åtkomsträttigheter utifrån roll och granska behörigheterna varje gång du lägger till en ny datakälla.

Styrning

Arbetsgrupper behöver tydliga regler för vem som äger gemensamma data och vem som fattar beslut om dem. Om till exempel två avdelningar beräknar samma nyckeltal på olika sätt måste någon bestämma vilken definition som alla ska använda. Detsamma gäller för godkännande av åtkomst till känsliga data.

Skalning av datamängder

I takt med att datalagret samlar in data från fler år och lägger till nya källor kan sökningar bli långsammare och lagringskostnaderna stiga. Team måste planera hur de ska organisera äldre data och hur länge de ska behålla den, så att tillväxten inte försvårar den dagliga rapporteringen.

Brist på intern kompetens inom dataengineering

Ert team kanske har goda kunskaper om hälso- och sjukvårdssystemen, men begränsad erfarenhet av att bygga upp ett datalager kring dem. I så fall kan externa dataingenjörer hjälpa till att utforma dataströmmarna och datamodellen, medan ert interna team fastställer vad data ska stödja.

Modeller för datalager inom hälso- och sjukvården

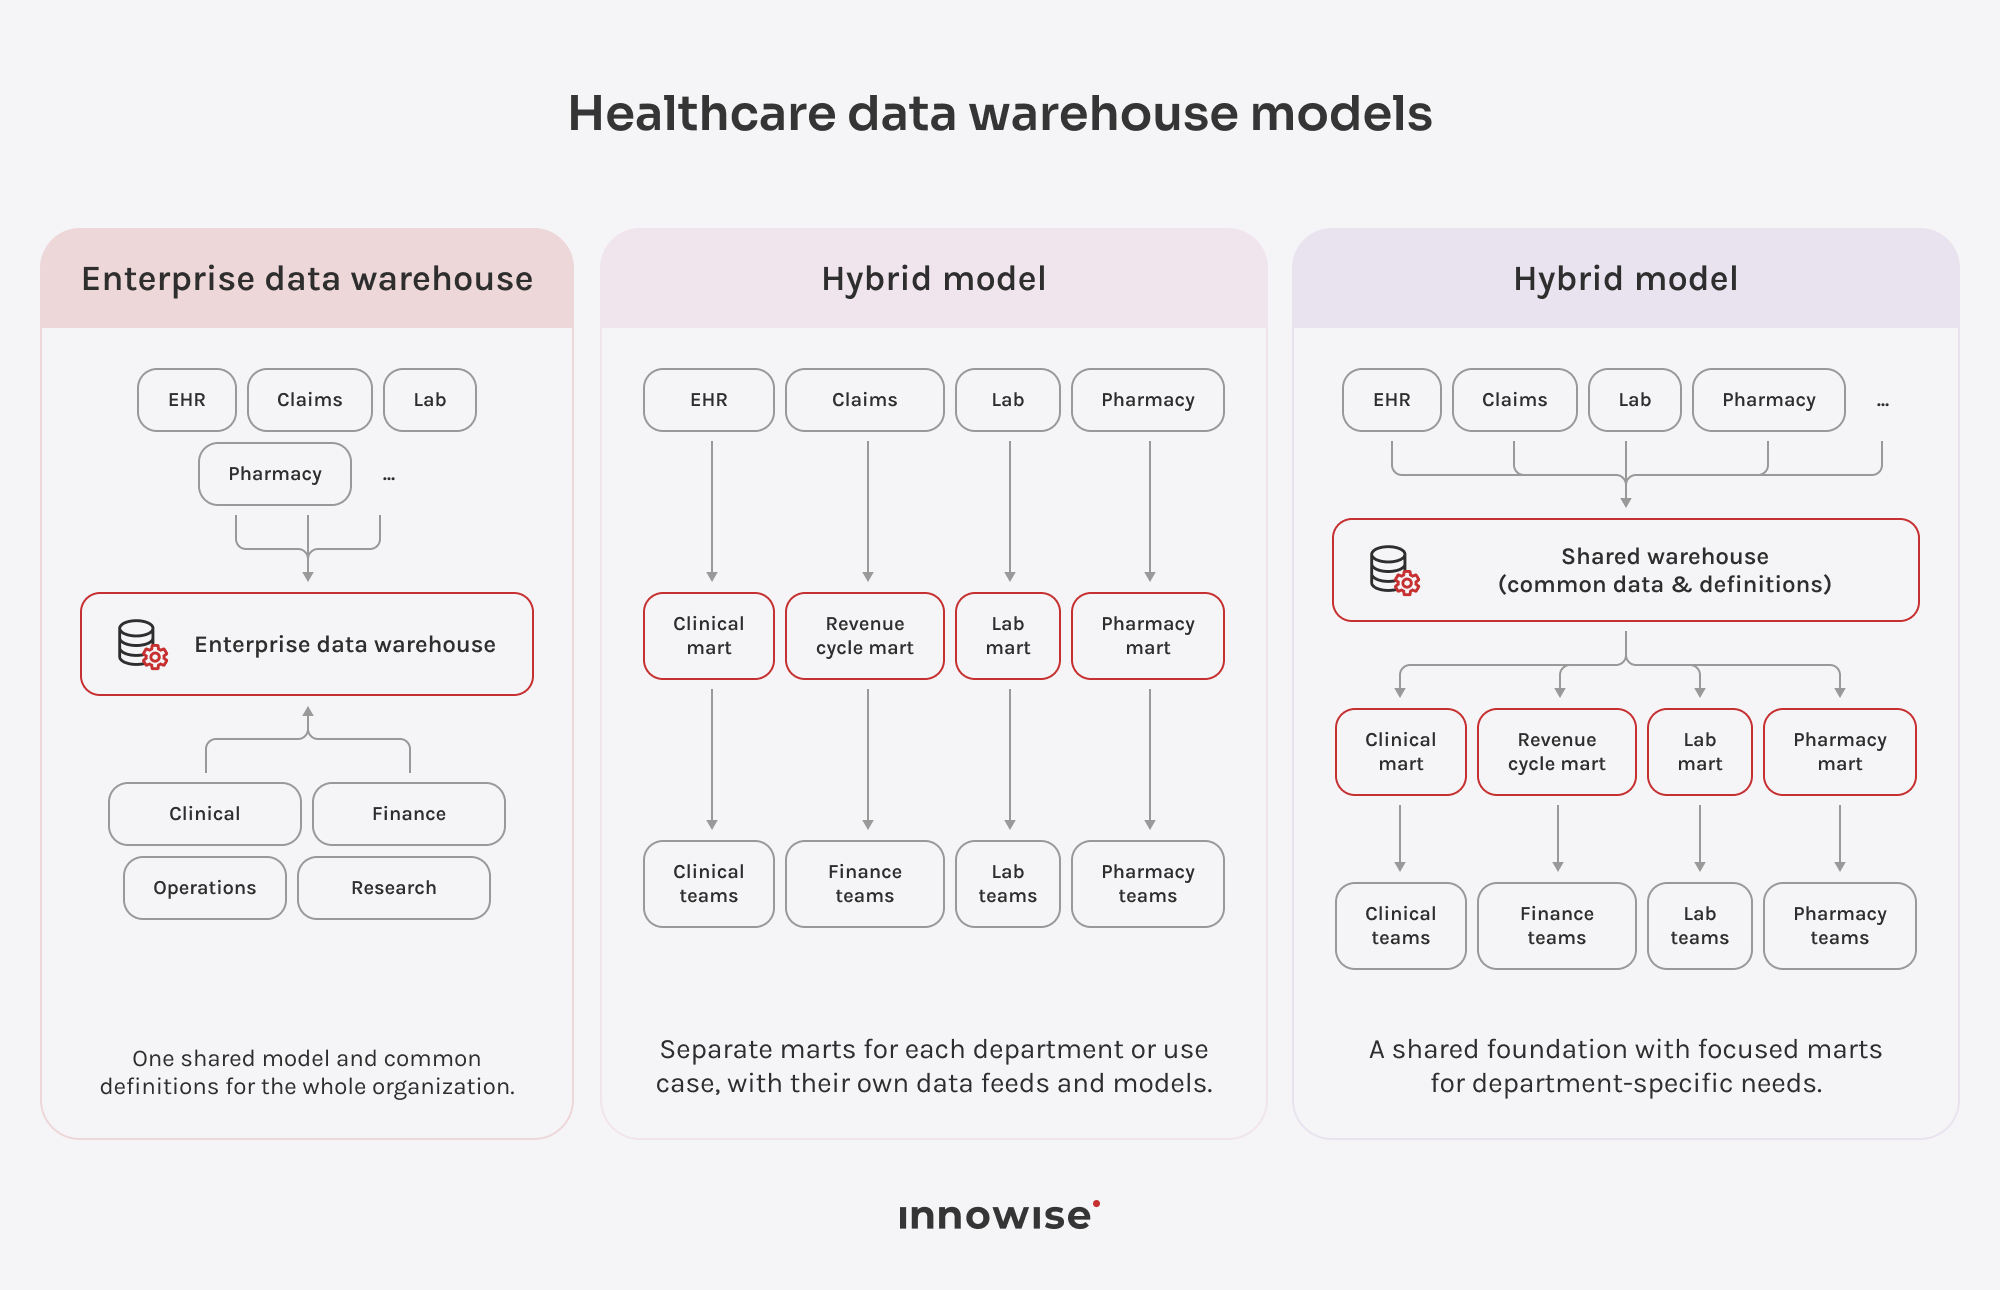
Vilken modell för ett datalager inom hälso- och sjukvården som är lämplig beror på hur centraliserad datahanteringen ska vara och hur mycket självständighet de enskilda avdelningarna behöver. I praktiken väljer organisationer oftast mellan tre modeller:

Företagsdatavarehus

Ett företagsdatalager inom hälso- och sjukvården använder en gemensam datamodell för hela organisationen, så att olika avdelningar arbetar med enhetliga definitioner och rapporteringsregler. Kliniska och ekonomiska team kan till exempel beräkna den genomsnittliga vistelselängden på samma sätt, istället för att definiera måttet separat i sina egna rapporter.

På datanivå kan teamen standardisera centrala enheter såsom patienter, vårdmöten, vårdgivare och vårdinrättningar samt koppla poster från källsystemen till dessa gemensamma strukturer. Nackdelen är att de måste enas om dessa definitioner i ett tidigt skede och se till att de förblir samstämmiga i takt med att datalagret växer. Det kräver mer arbete i början, särskilt i en stor organisation där terminologi och rapporteringsbehov ständigt förändras. När många rapporter bygger på den gemensamma modellen kan till och med en liten ändring av en centrala definition påverka flera team samtidigt.

Fristående datamarknader

En fristående datamart är inriktad på en enskild avdelning eller ett specifikt analysändamål, snarare än att modellera data för hela organisationen. Ett onkologiteam kan till exempel bygga upp en datamart kring de kliniska system som de behöver, medan analytiker som arbetar med intäktscykeln skapar en annan datamart inriktad på ersättningsanspråk och faktureringsdata.

Eftersom varje datamart har ett mindre tillämpningsområde kan teamen ofta få igång de första rapporterna snabbare. När fler marts läggs till kan samma källsystem behöva separata pipelines och mappningar för var och en av dem. Definitionerna kan också variera mellan olika avdelningar. Och eftersom marts ofta lagrar data som redan är bearbetad eller sammanfattad för ett specifikt användningsfall, kan de sakna de detaljer som behövs för en annan analys senare.

Hybridmodell

En hybridmodell kombinerar ett gemensamt företagsdatalager med datamartar som är utformade för specifika avdelningar eller analysbehov. Kärndata och gemensamma definitioner förblir i det centrala lagret, medan varje datamart anpassar dessa data efter sina egna rapporteringsbehov. Eftersom datamartarna hämtar data från datalagret behöver teamen inte skapa separata integrationer tillbaka till varje källsystem.

Denna lösning gör det möjligt för organisationer att lägga till nya marts i takt med att rapporteringsbehoven förändras, utan att behöva modellera varje framtida användningsfall redan från början. Det svåraste är att avgöra vad som bör standardiseras centralt och vad som kan förbli specifikt för en enskild mart. Om för mycket logik flyttas till enskilda marts kan definitionerna avvika från varandra med tiden.

Planerar du ett datalager för hälso- och sjukvården och funderar på vilka alternativ som finns?

Användningsfall för datalager inom hälso- och sjukvården

Vårdorganisationer använder datalager för mycket olika uppgifter, beroende på vilka data de samlar in och vilka beslut de behöver fatta. Exemplen på datalager inom hälso- och sjukvården nedan visar hur detta ser ut i det kliniska och operativa arbetet.

Hantering av befolkningens hälsa

Folkhälsoteamen använder data från databasen för att identifiera grupper av patienter med liknande vårdbehov. De kan till exempel identifiera personer som är försenade med screening eller uppföljning och vidarebefordra dessa listor till uppsökande team.

Hantering av kroniska sjukdomar

När det gäller kroniska sjukdomar behöver vårdteamet kunna se vilka förändringar som sker mellan besöken. En databas kan sammanställa laboratorieresultat och läkemedelshistorik från olika besök, kompletterat med mätvärden från anslutna enheter när sådana finns tillgängliga. Den sammanställda historiken hjälper teamen att upptäcka förändringar i patientens tillstånd och avgöra när en tidigare uppföljning kan behövas.

Analys av patienters risker med syfte att förutsäga framtida händelser

Vårdteam använder historiska data från datalagret för att bedöma vilka patienter som löper högre risk att återinläggas eller utebli från ett besök. Dessa bedömningar vidarebefordras vanligtvis till vårdpersonalen via ett system för vårdhantering eller uppföljning. Att skriva in dem direkt i själva elektroniska patientjournalen (EHR) kräver oftast en separat integration: leverantörer av EHR-system brukar ha strikt kontroll över skrivbehörigheten.

Klinisk forskning och kliniska prövningar

Arbetet med att hitta lämpliga studiedeltagare inleds ofta med en lång lista över inklusions- och exklusionskriterier. Forskarna kan först jämföra dessa kriterier med avidentifierade data från datalagret och därmed begränsa urvalet innan de granskar enskilda journaler. Vid forskning som bedrivs på flera platser kan forskarteamen dessutom samordna journaler från olika vårdinrättningar i en gemensam struktur innan analysen påbörjas.

Analys av intäktscykeln och ersättningsansökningar

Betalningsproblem kan uppstå när som helst mellan den ursprungliga debiteringen och den slutliga återbetalningen. Genom att koppla samman data från klinisk verksamhet, fakturering och ersättningsansökningar kan intäktsteamet se var en ersättningsansökan har fastnat och om samma avslagsskäl återkommer för en viss betalare eller en viss behandling.

Personalplanering och kapacitetsplanering

Cheferna jämför patientvolymerna per avdelning och skift med den personal som är inplanerad under samma tid. Om en viss avdelning upprepade gånger har personalbrist vissa dagar eller under perioder med hög belastning kan de anpassa framtida scheman för att ta hänsyn till detta mönster.

Optimering av driftskostnaderna

När ekonomiska uppgifter kopplas samman med den kliniska verksamheten kan teamen se var driftskostnaderna faktiskt har sitt ursprung. De kan jämföra utgifterna per ingrepp, vårdinrättning eller vårdtyp och undersöka varför kostnaderna är högre inom vissa områden än inom andra.

Genomförandeprocessen

Varje projekt som rör ett datalager för hälso- och sjukvårdsdata inleds på olika sätt. Stegen beror på era befintliga system, kvaliteten på era data och vad ni vill att datalagret ska kunna göra. Så här brukar vi gå tillväga.

01
Identifiering

Vårt team fastställer de inledande rapporterings- eller analysanvändningsfallen för den första versionen och kartlägger vilka användare som behöver dem. Vi bekräftar också vilka källsystem som ingår i projektet och identifierar eventuella regleringsmässiga begränsningar innan vi fattar arkitekturbeslut.

02
Utvärdering av data

Innan vi bygger datapipelines granskar vi varje datakälla för att upptäcka saknade data och inkonsekventa format, och kontrollerar sedan om det finns dubbletter. Resultaten visar vad som kan lämnas som det är och var vi behöver införa rensningsregler innan dessa problem påverkar rapporteringen i produktionsmiljön.

03
Arkitektur

Våra dataarkitekter väljer datalagermodell utifrån hur omfattande behovet är av att dela data och definitioner mellan olika team. Därefter utformar de insamlings- och lagringslagren utifrån organisationens system och bestämmer hur analysverktygen ska få åtkomst till datalagret.

04
Val av teknik

När arkitekturen är fastställd väljer teamet plattform, ETL/ELT-strategi samt BI- eller ML-verktyg utifrån datamängden och den befintliga teknikstacken. Budget- och efterlevnadsaspekter begränsar urvalet, särskilt när åtkomstkontroller eller revisionsloggning krävs.

05
Integration

Datatekniker kopplar samman datalagret med källsystemen. Beroende på miljön kan de använda FHIR eller HL7 v2 för kliniska data, X12 för amerikanska ersättningsansökningar samt API:er eller inbyggda kopplingar för affärsapplikationer. Genom att testa varje dataström mot verkliga data kan man upptäcka mappningsfel i ett tidigt skede.

06
Utveckling

Innowise-ingenjörer bygger datapipelines som standardiserar format och åtgärdar dubbletter i poster innan de tillämpar de överenskomna affärsdefinitionerna. Om designen omfattar datamarts bygger de dessa på det gemensamma lagret istället för att återansluta till varje enskild källa.

07
Migrering och testning

Teamet laddar in historiska data och jämför dem med de ursprungliga källorna för att upptäcka saknade eller ändrade värden. Därefter testar analytikerna rapporterna mot de användningsfall som definierats under kartläggningsfasen, medan affärsanvändarna granskar resultaten innan systemet tas i drift.

08
Lansering

Vid lanseringen kör vårt team ofta både gamla och nya rapporter parallellt så att användarna kan jämföra siffrorna innan de byter över. Vi följer också den inledande produktionsanvändningen noga, eftersom problem med data eller prestanda som inte upptäckts under testningen ofta kommer fram här.

09
Support

Efter driftsättningen övervakar vi prestandan, lägger till nya källor och upprätthåller de styrningsprocesser som säkerställer att de gemensamma definitionerna förblir enhetliga. Det är oftast en av de längsta projektfaserna och en av de som lättast underskattas under planeringsfasen.

arrow-icon. arrow-icon.
01 Identifiering

Vårt team fastställer de inledande rapporterings- eller analysanvändningsfallen för den första versionen och kartlägger vilka användare som behöver dem. Vi bekräftar också vilka källsystem som ingår i projektet och identifierar eventuella regleringsmässiga begränsningar innan vi fattar arkitekturbeslut.

arrow-icon. arrow-icon.
02 Utvärdering av data

Innan vi bygger datapipelines granskar vi varje datakälla för att upptäcka saknade data och inkonsekventa format, och kontrollerar sedan om det finns dubbletter. Resultaten visar vad som kan lämnas som det är och var vi behöver införa rensningsregler innan dessa problem påverkar rapporteringen i produktionsmiljön.

arrow-icon. arrow-icon.
03 Arkitektur

Våra dataarkitekter väljer datalagermodell utifrån hur omfattande behovet är av att dela data och definitioner mellan olika team. Därefter utformar de insamlings- och lagringslagren utifrån organisationens system och bestämmer hur analysverktygen ska få åtkomst till datalagret.

arrow-icon. arrow-icon.
04 Val av teknik

När arkitekturen är fastställd väljer teamet plattform, ETL/ELT-strategi samt BI- eller ML-verktyg utifrån datamängden och den befintliga teknikstacken. Budget- och efterlevnadsaspekter begränsar urvalet, särskilt när åtkomstkontroller eller revisionsloggning krävs.

arrow-icon. arrow-icon.
05 Integration

Datatekniker kopplar samman datalagret med källsystemen. Beroende på miljön kan de använda FHIR eller HL7 v2 för kliniska data, X12 för amerikanska ersättningsansökningar samt API:er eller inbyggda kopplingar för affärsapplikationer. Genom att testa varje dataström mot verkliga data kan man upptäcka mappningsfel i ett tidigt skede.

arrow-icon. arrow-icon.
06 Utveckling

Innowise-ingenjörer bygger datapipelines som standardiserar format och åtgärdar dubbletter i poster innan de tillämpar de överenskomna affärsdefinitionerna. Om designen omfattar datamarts bygger de dessa på det gemensamma lagret istället för att återansluta till varje enskild källa.

arrow-icon. arrow-icon.
07 Migrering och testning

Teamet laddar in historiska data och jämför dem med de ursprungliga källorna för att upptäcka saknade eller ändrade värden. Därefter testar analytikerna rapporterna mot de användningsfall som definierats under kartläggningsfasen, medan affärsanvändarna granskar resultaten innan systemet tas i drift.

arrow-icon. arrow-icon.
08 Lansering

Vid lanseringen kör vårt team ofta både gamla och nya rapporter parallellt så att användarna kan jämföra siffrorna innan de byter över. Vi följer också den inledande produktionsanvändningen noga, eftersom problem med data eller prestanda som inte upptäckts under testningen ofta kommer fram här.

arrow-icon. arrow-icon.
09 Support

Efter driftsättningen övervakar vi prestandan, lägger till nya källor och upprätthåller de styrningsprocesser som säkerställer att de gemensamma definitionerna förblir enhetliga. Det är oftast en av de längsta projektfaserna och en av de som lättast underskattas under planeringsfasen.

Tjänster för datalager inom hälso- och sjukvården

Om du bygger ett datalager för hälso- och sjukvården från grunden behöver du ett annat stöd än om du ska åtgärda eller utöka ett befintligt. Innowise kan komma in i projektet i vilket skede som helst och ta sig an det arbete som din installation kräver.

  • Rådgivning inom datalager för hälso- och sjukvården
  • Arkitektur och design
  • Utveckling av datalager
  • Dataintegration och -migrering
  • Modernisering av äldre datalager (DWH)
  • Integration av affärsintelligens och analysverktyg
  • Support och optimering

Rådgivning inom datalager för hälso- och sjukvården

Om du redan har problem med rapporteringen eller ett befintligt lager som inte längre fyller sin funktion, tar vi reda på vad som behöver ändras. Vårt team granskar den nuvarande lösningen och jämför de tillgängliga alternativen. Utifrån det hjälper vi dig att avgöra vilka användningsfall som bör prioriteras.

Nurse reviews lab results and medication history in EHR system before patient rounds.

Arkitektur och design

När kraven har fastställts utformar våra arkitekter en lagerstruktur utifrån era system och förväntade arbetsbelastningar. De fastställer hur huvudkomponenterna kopplas samman och var den gemensamma datan ska lagras. Strukturen kan sedan anpassas efter nya datakällor eller rapporteringsbehov allteftersom dessa uppstår.

Building layouts and style guides for a new web application project.

Utveckling av datalager

När designen har godkänts bygger våra ingenjörer datalagret (DWH), inklusive omvandlingslogik och eventuella nödvändiga datamartar. De inför kvalitetskontroller och säkerhetsåtgärder under utvecklingen, så att datalagret kan stödja de rapporter och analyser som projektet kräver.

IT specialist analyzing software code during an evening sprint session.

Dataintegration och -migrering

Vi kopplar samman datalagret med EHR/EMR, ersättningshantering, laboratoriehantering, ERP/CRM och andra källsystem. Historiska data överförs sedan till målmodellen med nödvändiga mappningar och omvandlingar. Innan övergången genomförs utförs avstämningskontroller där de migrerade uppgifterna jämförs med källuppgifterna.

Data engineer interacts with a visual dashboard to orchestrate real-time data synchronization across systems.

Modernisering av äldre datalager (DWH)

När datakällor och rapporteringsbehov förändras kan ett befintligt datalager behöva mer än bara rutinmässigt underhåll. Vi uppdaterar föråldrade datamodeller och dataströmmar, flyttar arbetsbelastningar när den nuvarande plattformen blir en begränsning och automatiserar repetitiva uppgifter inom datahantering där det är lämpligt.

IT operations team tracks software patch rollout in real time via a mobile device interface.

Integration av affärsintelligens och analysverktyg

Våra experter kopplar samman datalagret med de BI- och analysverktyg som era team redan använder. Beroende på hur systemet är konfigurerat kan de importera data eller göra sökningar direkt i datalagret. Gemensamma nyckeltal och rapporteringsregler samlas på ett ställe istället för att behöva skapas om i varje instrumentpanel.

Accessing a centralized analytics portal to evaluate company operations and outcomes.

Support och optimering

Efter driftsättningen förändras lagret kontinuerligt i takt med dina data- och rapporteringsbehov. Vårt team kan felsöka problem med dataströmmar eller data, lägga till nya källor, optimera långsamma sökningar och uppdatera modeller när affärskraven förändras.

The consulting team reviews analytics on screen, focusing on data-driven IT strategy and solutions.
Rådgivning inom datalager för hälso- och sjukvården

Om du redan har problem med rapporteringen eller ett befintligt lager som inte längre fyller sin funktion, tar vi reda på vad som behöver ändras. Vårt team granskar den nuvarande lösningen och jämför de tillgängliga alternativen. Utifrån det hjälper vi dig att avgöra vilka användningsfall som bör prioriteras.

Nurse reviews lab results and medication history in EHR system before patient rounds.
Arkitektur och design

När kraven har fastställts utformar våra arkitekter en lagerstruktur utifrån era system och förväntade arbetsbelastningar. De fastställer hur huvudkomponenterna kopplas samman och var den gemensamma datan ska lagras. Strukturen kan sedan anpassas efter nya datakällor eller rapporteringsbehov allteftersom dessa uppstår.

Building layouts and style guides for a new web application project.
Utveckling av datalager

När designen har godkänts bygger våra ingenjörer datalagret (DWH), inklusive omvandlingslogik och eventuella nödvändiga datamartar. De inför kvalitetskontroller och säkerhetsåtgärder under utvecklingen, så att datalagret kan stödja de rapporter och analyser som projektet kräver.

IT specialist analyzing software code during an evening sprint session.
Dataintegration och -migrering

Vi kopplar samman datalagret med EHR/EMR, ersättningshantering, laboratoriehantering, ERP/CRM och andra källsystem. Historiska data överförs sedan till målmodellen med nödvändiga mappningar och omvandlingar. Innan övergången genomförs utförs avstämningskontroller där de migrerade uppgifterna jämförs med källuppgifterna.

Data engineer interacts with a visual dashboard to orchestrate real-time data synchronization across systems.
Modernisering av äldre datalager (DWH)

När datakällor och rapporteringsbehov förändras kan ett befintligt datalager behöva mer än bara rutinmässigt underhåll. Vi uppdaterar föråldrade datamodeller och dataströmmar, flyttar arbetsbelastningar när den nuvarande plattformen blir en begränsning och automatiserar repetitiva uppgifter inom datahantering där det är lämpligt.

IT operations team tracks software patch rollout in real time via a mobile device interface.
Integration av affärsintelligens och analysverktyg

Våra experter kopplar samman datalagret med de BI- och analysverktyg som era team redan använder. Beroende på hur systemet är konfigurerat kan de importera data eller göra sökningar direkt i datalagret. Gemensamma nyckeltal och rapporteringsregler samlas på ett ställe istället för att behöva skapas om i varje instrumentpanel.

Accessing a centralized analytics portal to evaluate company operations and outcomes.
Support och optimering

Efter driftsättningen förändras lagret kontinuerligt i takt med dina data- och rapporteringsbehov. Vårt team kan felsöka problem med dataströmmar eller data, lägga till nya källor, optimera långsamma sökningar och uppdatera modeller när affärskraven förändras.

The consulting team reviews analytics on screen, focusing on data-driven IT strategy and solutions.

Behöver du modernisera din datainfrastruktur inom hälso- och sjukvården?

Leverantörer av datalager för hälso- och sjukvårdsdata

Om du jämför plattformar för ett läkemedelslager är din befintliga molnmiljö en bra utgångspunkt. Alternativen nedan hanterar hälsodata på olika sätt, och även deras beräknings- och prissättningsmodeller skiljer sig åt.

Amazon-Redshift-Logo (1)

Amazon Redshift

Redshift passar perfekt när större delen av dina data redan finns i AWS. Det fungerar tillsammans med S3 och AWS Glue, medan HealthLake kan exportera FHIR-data till S3 för vidare analys via Redshift eller andra analys tjänster från AWS.

Viktiga egenskaper

  • SQL för strukturerade och semistrukturerade data
  • Åtkomst till S3 via Redshift Spectrum
  • Federerade sökningar mot AWS-databaser som stöds
  • Åtkomstkontroller på rad- och kolumnnivå
  • Separat databehandling och hanterad lagring
  • AWS-tjänst som uppfyller HIPAA-kraven 

Prissättning

  • Prissättning på begäran för tilldelade kluster
  • Serverlös databehandling som debiteras efter användning
  • Avgifter för separat förvaltad lagring
  • Specialpriser för stabila arbetsbelastningar
Azure Synapse Analytics

Azure Synapse Analytics

Synapse fungerar bra när dina data och rapporter redan hanteras i Azure och dina team använder Power BI. Det förenar SQL-datalagring och Spark i en enda arbetsyta, med pipeliner för att flytta data mellan Azure-tjänster. FHIR-data från Azure Health Data Services kan också kopieras till Synapse för analys.

Viktiga egenskaper

  • Dedikerad och serverlös SQL
  • Apache Spark-pooler
  • Frågor om Azure Data Lake
  • Inbyggda ETL-/ELT-pipelines
  • ML-integrationer för Power BI och Azure
  • FHIR-analys med Azure Health Data Services

Prissättning

  • Serverlös SQL där avgiften baseras på mängden bearbetad data
  • Särskild SQL som faktureras utifrån DWU-användning
  • Spark faktureras utifrån vCore-användning
  • Förköpsalternativ för fasta arbetsbelastningar

För team som vill ha större frihet när det gäller val av molnleverantörer gör Snowflake att datalagringslagret blir mindre beroende av ett enda ekosystem. Det körs på AWS, Azure och Google Cloud, samtidigt som separata virtuella datalager gör det möjligt för teamen att tilldela olika arbetsbelastningar egna beräkningsresurser.

Viktiga egenskaper

  • Alternativ för distribution i flera moln
  • Oberoende beräkningskapacitet för olika arbetsbelastningar
  • Lager med flera kluster i Enterprise Edition+
  • Inbyggt stöd för semistrukturerade data
  • Säker datadelning
  • PHI-support med Business Critical+

Prissättning

  • Förbrukningsbaserade datorkrediter
  • Separata lagringsavgifter
  • Kapacitet på begäran eller förbetald kapacitet 
  • Priserna varierar beroende på molntjänst, region och version
GCP BigQuery

Google BigQuery

BigQuery passar organisationer som redan använder Google Cloud eller som vill ha ett serverlöst datalager utan att behöva hantera beräkningskluster. Cloud Healthcare API kan exportera FHIR-resurser och DICOM-metadata till BigQuery, vilket ger analysgrupper tillgång till hälso- och sjukvårdsdata via SQL.

Viktiga egenskaper

  • Serverlöst SQL-datalager
  • Separat lagring och databehandling
  • Inbyggda funktioner för maskininlärning
  • Externa och federerade sökningar
  • Cloud – Integration av API för hälso- och sjukvård
  • BigQuery omfattas av Google Cloud:s HIPAA-BAA

Prissättning

  • Datorresurser på begäran som faktureras utifrån mängden bearbetade data
  • Kapacitetsprissättning baserad på ankomst- och avgångstider
  • Lagringsutrymme debiteras separat
  • Åtaganden för reserverad kapacitet

Kostnad och tidsplan

Budgetarna för datalager inom hälso- och sjukvården kan variera med mer än en storleksordning. Ett begränsat produktionsdatamart med ett par välrengjorda datakällor kan kosta omkring $60 000–$100 000 och ta 2–4 månader att bygga upp. Ett företagsdatalager som omfattar flera system, med migrering av historiska data och flera datamartar, kan kosta $400 000–$1 miljon eller mer och ta 9–18 månader eller längre tid.

Projektets omfattningTypisk tillämpningsområdeTidslinjeGenomförandebudgetLöpande kostnader för molntjänster och programvara
Avdelningens datamart1–2 källsystem, en avdelning, begränsad historik, grundläggande BI-rapportering2–4 månader$60k–$100k$1k–$5k/månad
Medelstort datalager för hälso- och sjukvården3–6 källor, gemensam datamodell, migrering av historiska data, 2–4 datamarknader, BI-integration5–9 månader$150k–$350k$5k–$20k/månad
DWH för företag / lakehouse7+ källor, omfattande historiska data, flera marknadsplatser, skräddarsydda kliniska integrationer, avancerad analys9–18+ månader$400k–$1m+$20k–$80k+/månad

Hälso- och sjukvårdslösningar från Innowise

Varför välja oss
Ett DWH-projekt inom hälso- och sjukvården befinner sig i gränslandet mellan dataengineering och hälso- och sjukvården IT. Innowise har erfarenhet från båda områdena, vilket stöds av relevanta ISO-certifieringar och samarbeten med de moln- och dataleverantörer som används i datalagerprojekt.

Erfarenhet inom hälso- och sjukvården

Vi har över 19 års erfarenhet inom hälso- och sjukvården IT, bland annat av arbete med elektroniska patientjournaler, laboratoriesystem, medicinsk bilddiagnostik och uppkopplade plattformar för hälso- och sjukvård. Den erfarenheten är viktig när kliniska arbetsflöden eller standarder för hälso- och sjukvårdsdata påverkar utformningen av datalagret.

Expertis inom dataingenjörsvetenskap

Våra datateam arbetar med Snowflake, BigQuery, Amazon Redshift och Azure Synapse, tillsammans med de ETL/ELT- och orkestreringsverktyg som stöder dessa. Det innebär att vi kan utforma datalagret utifrån kundens befintliga teknikstack istället för att utgå från en enskild plattform.

Relevanta certifieringar

Innowise är certifierat enligt ISO 9001, ISO 27001 och ISO 13485, vilka omfattar standarder för kvalitet, informationssäkerhet och medicintekniska produkter.

Leveransrapport

Vår meritlista omfattar över 1 600 projekt inom olika branscher och över 60 IT-lösningar inom hälso- och sjukvården. För ett företag inom precisionsmedicin kan vi förbättrade datapipelines och AWS-infrastruktur används för att bearbeta diagnostiska data från flera källor.

Erfarenhet av säkerhet och regelefterlevnad

Våra team inom hälso- och sjukvårdssektorn arbetar i enlighet med kraven i HIPAA och GDPR samt standarder för utbyte av hälso- och sjukvårdsdata, såsom HL7 v2 och FHIR. Denna erfarenhet är viktig när känsliga hälso- och sjukvårdsuppgifter överförs mellan datalagret och reglerade kliniska system.

Tekniska samarbeten

Som partner till AWS, Microsoft, Google Cloud och Databricks bidrar Innowise med certifierad plattformsexpertis till DWH-projekt och kan utnyttja leverantörernas support när plattformsspecifika problem uppstår.

ISO 13485 certification.
ISO 9001 certification.
ISO/IEC 27001 certification.
GDPR
Select partner AWS
Google_Cloud_Partner

Slutsats

Jag skulle inte inleda ett projekt för ett datalager inom hälso- och sjukvården genom att försöka samla alla datamängder på ett ställe. Välj istället ett rapporterings- eller analysproblem som är värt att lösa och koppla endast samman de system som behövs för den uppgiften. Du kan till exempel börja med rapportering av intäktscykeln eller analys av återinläggningar. När det väl fungerar kan du bestämma vad datalagret behöver härnäst utifrån den faktiska efterfrågan. 

Denna strategi bör fortsätta i takt med att projektet växer. Lägg till nya källor eller datamartar endast när det finns ett tydligt skäl, istället för att försöka förbereda sig för alla tänkbara framtida behov. Det viktiga är att upprätthålla enhetliga definitioner och åtkomstregler när datalagret växer och att se till att kraven på regelefterlevnad alltid uppfylls. 

Om du behöver hjälp utifrån kan specialister från Innowise:s knutpunkt för hälso- och sjukvård samt läkemedel (IT) kan granska ert befintliga datalager eller hjälpa till att bygga upp ett sådant anpassat efter era hälso- och sjukvårdssystem och rapporteringsbehov, med hänsyn till kraven på efterlevnad av dataskyddsbestämmelser inom hälso- och sjukvården.

FAQ

Ett datalager för hälso- och sjukvård innehåller bearbetade data för rapportering och analys. En datasjö innehåller vanligtvis större mängder rådata eller lätt bearbetade data. I många arkitekturer lagras mer omfattande datamängder i datasjön, medan datalagret innehåller de data som teamen behöver för återkommande kliniska, ekonomiska eller operativa analyser.

Tidsramarna varierar beroende på projektets omfattning, källsystem och datakvalitet. Ett avgränsat datalager med ett fåtal integrationer kan ta 2–4 månader. Ett större datalager för hälso- och sjukvårdssektorn kan ta 9–18 månader eller mer om projektet omfattar migrering av äldre data, flera integrationer och flera datalager.

Vilken modell för ett datalager inom hälso- och sjukvården som är lämplig beror på hur många team som behöver uppgifterna och om de ska använda samma rapporteringsdefinitioner. En företagsmodell stöder rapportering på organisationsnivå, medan fristående datamarknader inriktar sig på specifika avdelningar eller användningsfall. En hybridmodell kombinerar en gemensam kärna med mer specialiserade datamarknader. Utformningen av ett datalager inom hälso- och sjukvården bör spegla de användningsfall som ni behöver stödja i första hand.

Ja. Vi kan modernisera ert befintliga datalager för hälso- och sjukvårdsdata utan att byta ut det i sin helhet på en gång. Vårt team bygger om föråldrade dataflöden, uppdaterar datamodeller, flyttar utvalda arbetsbelastningar och kopplar in nyare analysverktyg steg för steg. Automatiseringen av datalagret för hälso- och sjukvårdsdata minskar dessutom det manuella arbetet vid datainläsning och återkommande kontroller av datakvaliteten.

Innowise utformar datalagret utifrån HIPAA-kraven redan från början, med åtkomst till PHI begränsad efter roll och inbyggda säkerhetskontroller i dataflödena. Vi validerar dessutom data under dess väg genom datalagret och kontrollerar om det finns felaktiga mappningar, dubbla patientposter eller ändrade värden innan dessa påverkar rapporteringen.

Visa alla

Innehållsförteckning

    Kontakta oss
    Boka ett samtal eller fyll i formuläret nedan så återkommer vi till dig när vi har behandlat din förfrågan.

    Skicka ett röstmeddelande till oss
    Bifoga dokument
    Ladda upp filen

    Du kan bifoga 1 fil på upp till 2 MB. Giltiga filformat: pdf, jpg, jpeg, png.

    Genom att klicka på Skicka samtycker du till att Innowise behandlar dina personuppgifter enligt våra Integritetspolicy för att förse dig med relevant information. Genom att lämna ditt telefonnummer samtycker du till att vi kan kontakta dig via röstsamtal, SMS och meddelandeappar. Samtals-, meddelande- och datataxor kan gälla.

    Du kan också skicka oss din förfrågan
    till contact@innowise.com
    Vad händer härnäst?
    1

    När vi har tagit emot och behandlat din förfrågan återkommer vi till dig för att beskriva dina projektbehov och undertecknar en NDA för att säkerställa sekretess.

    2

    Efter att ha undersökt dina önskemål, behov och förväntningar kommer vårt team att ta fram ett projektförslag förslag med arbetsomfattning, teamstorlek, tids- och kostnadsberäkningar.

    3

    Vi ordnar ett möte med dig för att diskutera erbjudandet och fastställa detaljerna.

    4

    Slutligen undertecknar vi ett kontrakt och börjar arbeta med ditt projekt direkt.

    Fler tjänster vi täcker

    arrow