Datenlager für das Gesundheitswesen: Vorteile, Architektur und Anwendungsfälle

21. September 2026 12 min lesen
Aleh Yafimau, Healthcare and MedTech Delivery Manager..
Berater im Gesundheitswesen IT
Verifizierter Experte
Jeder Artikel bei Innowise stammt von Autoren mit praktischer Erfahrung. Sie verstehen das Thema nicht nur theoretisch, sondern bringen auch Erkenntnisse aus konkreten Projekten ein.
Über 19 Jahre Erfahrung
Verifizierter Experte
Über 19 Jahre Erfahrung
Aleh überbrückt die Kluft zwischen klinischen Anforderungen und technischer Ausführung. Er wendet fundiertes Fachwissen an, um sicherzustellen, dass MedTech-Systeme nicht nur konform, sondern auch zuverlässig genug sind, um in der realen Gesundheitsversorgung eine messbare Wirkung zu erzielen.
Fachwissen
Gesundheits-IT Medizintechnik Algorithmen
Gespräch vereinbaren

Wichtige Erkenntnisse

  • Wenn Patienten-, Abrechnungs-, Labor-, Finanz- und Betriebsdaten in verschiedenen Systemen gespeichert sind, erfordert die Berichterstellung in der Regel einen manuellen Abgleich der Informationen aus den verschiedenen Quellen. Ein hDatenlager für das Gesundheitswesen führt Daten aus diesen Systemen zusammen, damit Teams sie für Berichte und Analysen nutzen können.
  • Selbst ein noch so gut konzipiertes Datenlager kann eine schlechte Datenqualität nicht ausgleichen. Probleme wie doppelte Patientendatensätze, uneinheitliche Formate und widersprüchliche Definitionen können dazu führen, dass Berichte unzuverlässig sind.
  • Das Warehouse-Modell legt fest, in welchem Umfang gemeinsame Daten und Definitionen geteilt werden. Ein unternehmensweites Data Warehouse dient dem unternehmensweiten Reporting, während Data Marts auf bestimmte Abteilungen oder Anwendungsfälle ausgerichtet sind. Hybride Architekturen nutzen beides. 
  • Der Business Case sollte bei den Entscheidungen ansetzen, die das Lager unterstützen muss – von der Bevölkerungsgesundheit und der Risikobewertung von Patienten bis hin zur klinischen Forschung, der Analyse von Leistungsansprüchen oder der Personal- und Kapazitätsplanung.
Artikel mit KI zusammenfassen

Wenn Ihre Patientenakten, Laborergebnisse, Abrechnungsdaten und Betriebsdaten in verschiedenen Systemen gespeichert sind, kann es mehr Aufwand erfordern, eine verlässliche Antwort zu erhalten, als die Analyse selbst. Die Teams müssen möglicherweise die Daten abgleichen und prüfen, was die Zahlen tatsächlich bedeuten, bevor sie diese nutzen können. A Datenlager für das Gesundheitswesen (DWH) führt die Daten aus diesen Systemen zusammen und bereitet sie für die Berichterstellung und Analyse auf.

In diesem Artikel werde ich erläutern, wie ein Data Warehouse für das Gesundheitswesen aufgebaut ist und welche Funktionen in der Praxis von Bedeutung sind. Außerdem werden wir uns mit den wichtigsten Data-Warehouse-Modellen, gängigen Anwendungsfällen im Gesundheitswesen, den geschäftlichen Vorteilen, den Herausforderungen bei der Umsetzung sowie den Entscheidungen befassen, die vor Projektbeginn getroffen werden müssen.

Was ist ein Datenlager für das Gesundheitswesen?

Eine Datenlager für das Gesundheitswesen ist eine zentrale Plattform, auf der Daten aus verschiedenen Gesundheitssystemen bereinigt, harmonisiert und für die Berichterstellung und Analyse aufbereitet werden. Sie kann Daten aus elektronischen Patientenakten (EHR und EMR) mit Abrechnungsdaten, Laborergebnissen, Daten aus Patientenportalen, ERP- oder CRM-Datensätzen sowie Daten von vernetzten Geräten zusammenführen.

Eine operative Datenbank unterstützt in der Regel eine Anwendung und deren täglichen Betrieb. Ein Data Warehouse (DWH) ist für Fragestellungen konzipiert, für deren Beantwortung Daten aus mehreren Systemen gleichzeitig benötigt werden. Wenn ein Krankenhaus beispielsweise herausfinden möchte, warum die Zahl der Wiederaufnahmen steigt, können Analysten Diagnosen und Behandlungsverläufe mit Abrechnungsdaten, Laborergebnissen und Personaldaten vergleichen, anstatt jeden Datensatz einzeln abrufen zu müssen.

Im Gegensatz zu einem DWH werden in einem Data Lake Daten in der Regel gespeichert, bevor sie für einen bestimmten Analysezweck strukturiert wurden. Er kann große Mengen an Rohdaten oder nur geringfügig aufbereiteten Daten in verschiedenen Formaten enthalten. Ein DWH hingegen enthält aufbereitete Daten, die Teams für Business Intelligence, wiederkehrende Berichte und laufende Analysen nutzen können.

BetriebsdatenbankData WarehouseDatensee
HauptzweckTägliche Anwendungstransaktionen ausführenDaten aus verschiedenen Systemen in eine Form bringen, die Teams für Auswertungen und Analysen nutzen könnenGroße Mengen verschiedener Arten von Daten für die spätere Verwendung aufbewahren
DatenquellenDaten, die von operativen Anwendungen erstellt und verwendet werdenDaten aus elektronischen Patientenakten (EHR), Abrechnungssystemen, ERP-, CRM- und anderen betriebswirtschaftlichen oder klinischen SystemenDaten aus zahlreichen Quellen, darunter strukturierte, halbstrukturierte und unstrukturierte Daten
Wie Daten gespeichert werdenAusgerichtet auf die Anforderungen der AnwendungAufbereitet und an den Anforderungen im Bereich Berichterstattung und Analyse ausgerichtetWird oft nahe an der ursprünglichen Form beibehalten und strukturiert, wenn ein Anwendungsfall dies erfordert
Typische Anwendungsbereiche im GesundheitswesenEHR-Transaktionen, Termine oder CRM-AktivitätenSystemübergreifendes Berichtswesen, BI und Analysen im GesundheitswesenGroße Datensätze, explorative Analysen oder ML-Workloads

Architektur eines Data Warehouse für das Gesundheitswesen

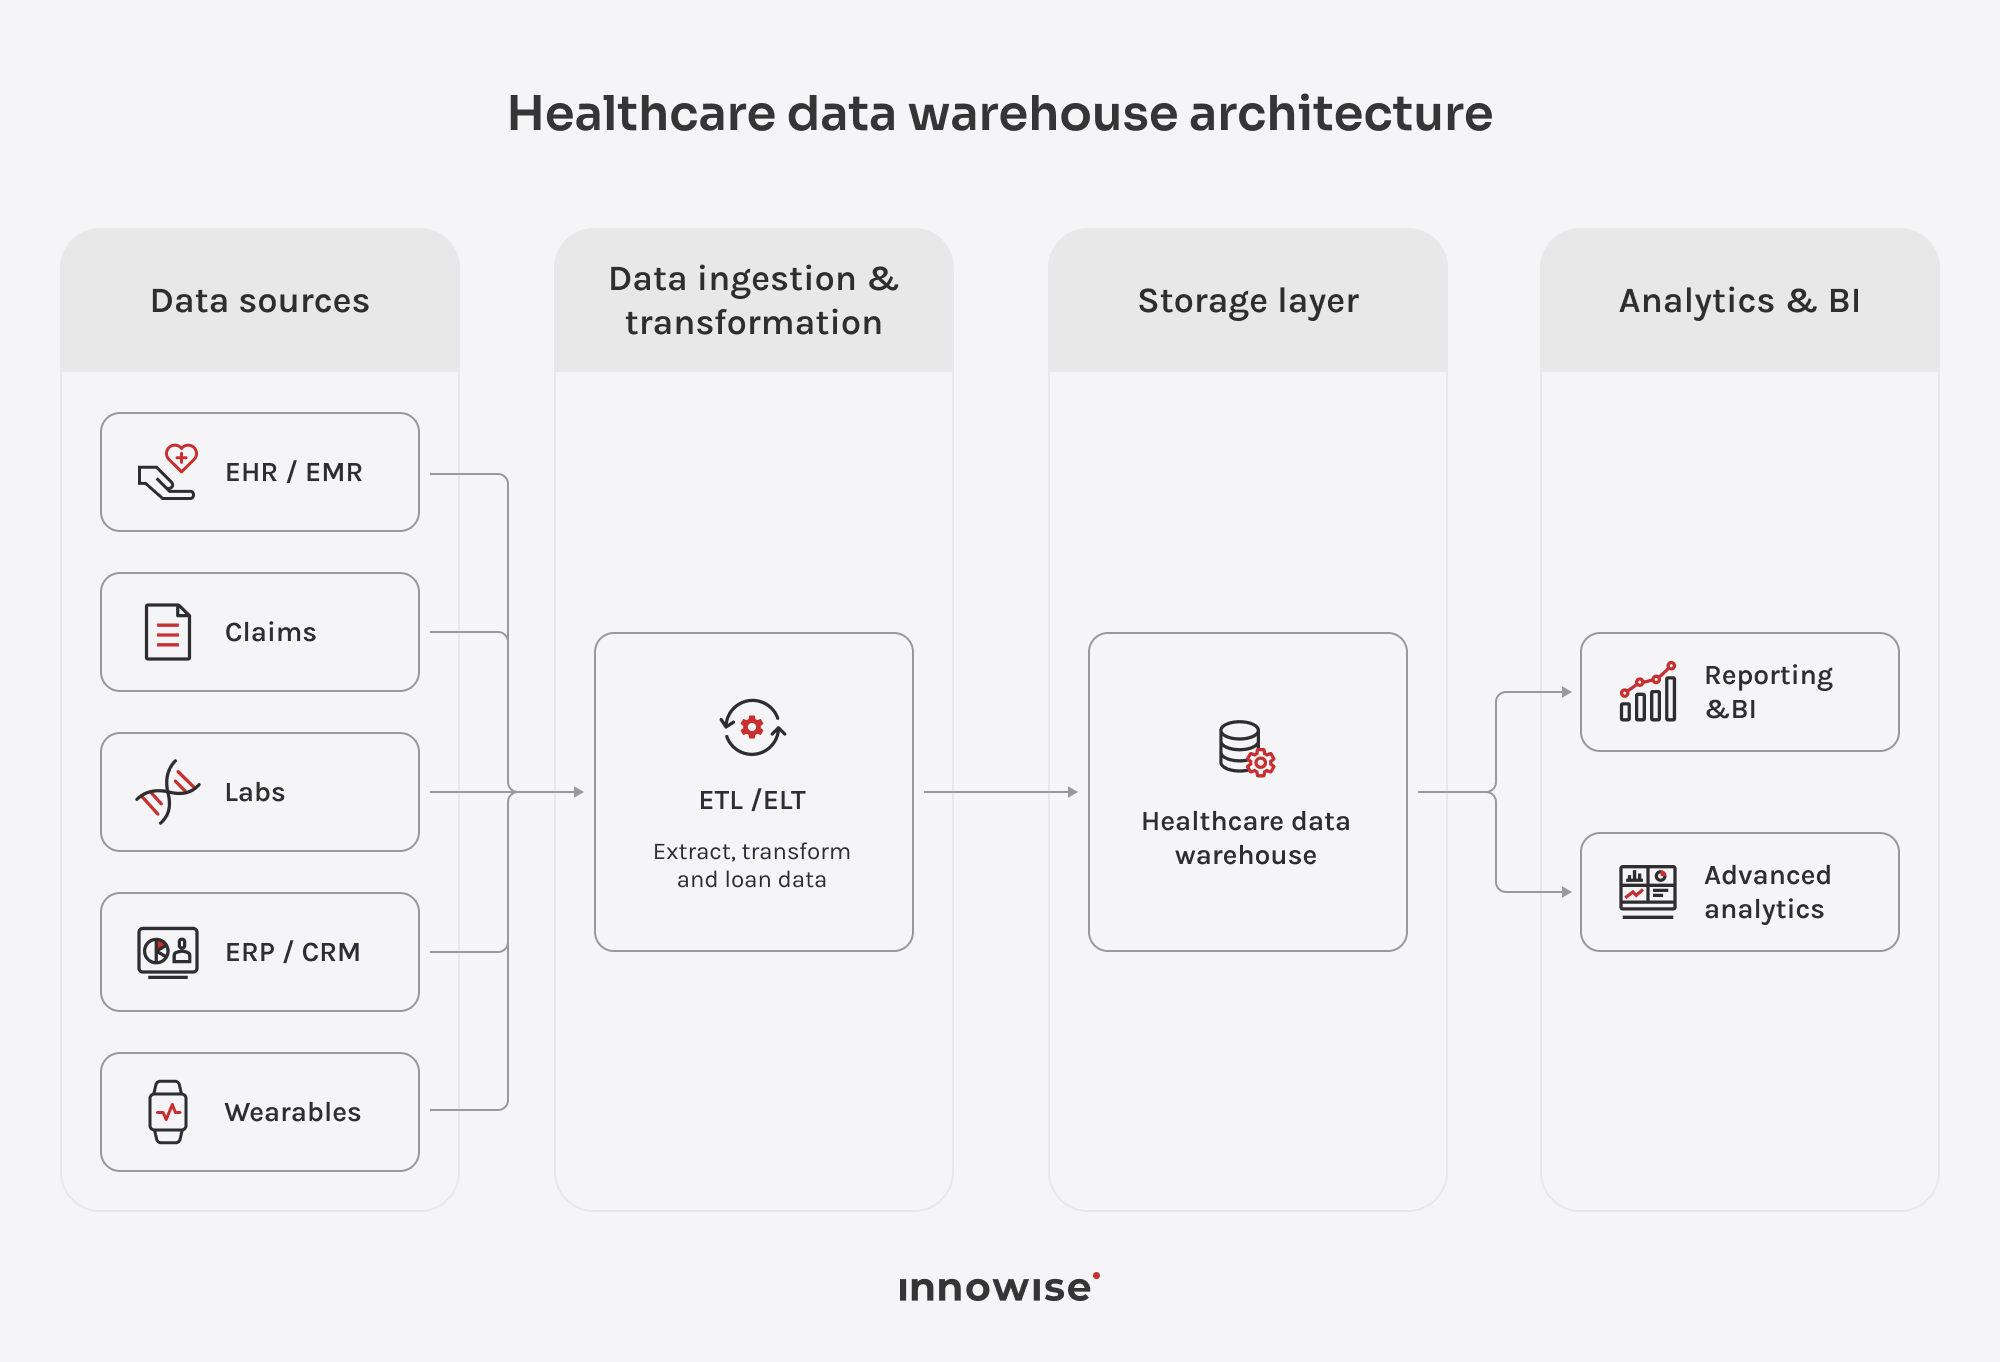
Um besser zu verstehen, wie ein Data Warehouse im Gesundheitswesen funktioniert, wollen wir uns die wichtigsten Ebenen ansehen, auf denen es basiert. Jede dieser Ebenen erfüllt eine bestimmte Aufgabe bei der Übertragung von Daten aus den Quellsystemen in den Speicher und bei der anschließenden Bereitstellung dieser Daten für Berichte, Analysen und Anwendungen.

Datenquellen

Die Quellschicht umfasst die Systeme, die bereits für klinische und betriebswirtschaftliche Aufgaben genutzt werden, wie beispielsweise elektronische Patientenakten (EHRs und EMRs), Abrechnungsplattformen, LIS und RIS/PACS sowie ERP- oder CRM-Software. Da derselbe Patient oder dasselbe Ereignis in diesen Systemen unter Umständen unterschiedlich erfasst wird, müssen Sie die Formate abgleichen und die Identifikatoren miteinander in Einklang bringen, bevor Sie die Daten gemeinsam nutzen können.

Datenaufnahme und ETL/ELT

Diese Ebene sammelt Quelldaten und bereitet sie für die Analyse vor. Bei ETL werden die Daten vor dem Laden in das Data Warehouse transformiert; bei ELT erfolgt die Transformation nach dem Laden. Der Prozess kann auch die Formatstandardisierung, die Entfernung von Duplikaten und die vorübergehende Zwischenspeicherung umfassen.

Lagerung

Die Speicherschicht verwaltet historische Daten in einer Struktur, die speziell für die Berichterstellung und Analyse konzipiert ist. Je nach Architektur kann sie auch Data Marts für eine bestimmte Abteilung oder einen bestimmten Anwendungsfall bereitstellen.

Analytik und BI

BI-Tools nutzen Daten aus dem Data Warehouse für Dashboards und wiederkehrende Berichte, während Analysten Ad-hoc-Abfragen für denselben Datensatz durchführen können. Dadurch steht den Teams eine gemeinsame Datenquelle für Analysen zur Verfügung, sodass die Logik nicht für jeden Bericht neu erstellt werden muss.

Anwendungen

Daten aus dem Data Warehouse können auch nachgelagerte klinische oder betriebswirtschaftliche Anwendungen unterstützen. So können beispielsweise Forschungswerkzeuge oder Planungssysteme auf aufbereitete Daten aus dem Data Warehouse zurückgreifen, anstatt eine separate Verbindung zu jedem einzelnen Quellsystem herzustellen.

Benötigen Sie einen zuverlässigen Überblick über klinische und betriebswirtschaftliche Daten?

Wichtigste Merkmale und Funktionen

Nachdem wir nun über die Architektur gesprochen haben, werde ich auf die Funktionen eingehen, die Sie in einem Data Warehouse für das Gesundheitswesen wahrscheinlich vorfinden werden. Jede Organisation ist ein wenig anders, doch viele der Anforderungen sind dieselben, wenn Daten aus verschiedenen Systemen zusammengeführt werden müssen und für Berichte und Analysen nutzbar bleiben sollen.

Datenintegration und ETL/ELT

Gesundheitssysteme speichern dieselben Informationen oft auf unterschiedliche Weise. Eine elektronische Patientenakte (EHR), eine Abrechnungsplattform oder ein Laborsystem kann für vergleichbare Datensätze unterschiedliche Felder und Formate verwenden. ETL- und ELT-Pipelines sammeln diese Daten und führen sie im Data Warehouse zur Analyse zusammen. Je nachdem, wie oft sich die Daten ändern, können die Pipelines nach einem Zeitplan ablaufen, nur neue Datensätze laden oder Aktualisierungen direkt bei ihrem Eintreffen verarbeiten.

Auch Daten im Gesundheitswesen ändern sich rückwirkend: Laborergebnisse werden korrigiert, Behandlungsfälle aktualisiert oder storniert und Abrechnungen angepasst oder ungültig gemacht. Die Pipelines müssen diese Änderungen auf bereits geladene Datensätze anwenden; andernfalls stimmt eine erneute Ausführung des Berichts vom letzten Monat möglicherweise nicht mehr mit der Quelle überein.

Datenqualität und Dublettenbereinigung

Doppelte Patientendatensätze und widersprüchliche Werte können Berichte verfälschen, sobald die Daten im Data Warehouse eintreffen. Qualitätsprüfungen erkennen fehlende oder ungültige Daten, während Abgleichregeln dabei helfen, Datensätze, die zum selben Patienten gehören, systemübergreifend miteinander zu verknüpfen. Teams benötigen diese Bereinigung, bevor sie Ergebnisse vergleichen oder Analysen erstellen können.

Metadatenverwaltung

Metadaten erläutern, was die einzelnen Felder bedeuten und woher sie stammen. Außerdem werden darin Änderungen erfasst, die vorgenommen wurden, bevor die Daten im Data Warehouse ankamen. Analysten können eine Zahl in einem Dashboard bis zu ihrer Quelle zurückverfolgen und überprüfen, welche Definition verwendet wurde.

Daten-Governance

Daten-Governance legt fest, wem die Daten gehören und welche Definitionen von allen verwendet werden sollen. Ohne klare Regeln kann es vorkommen, dass zwei Abteilungen dasselbe Data Warehouse nutzen und dennoch unterschiedliche Zahlen für dieselbe Kennzahl ausweisen. Dateneigentümer und Datenverwalter prüfen Änderungen und sorgen dafür, dass diese Definitionen im Laufe der Zeit einheitlich bleiben.

Sicherheit und Zugangskontrolle

Ein Lager im Gesundheitswesen kann neben sensiblen betrieblichen oder finanziellen Daten auch geschützte Gesundheitsdaten (PHI) enthalten, sodass nicht jeder denselben Zugriff haben darf. Mithilfe von Berechtigungen lässt sich je nach Rolle einschränken, was ein Benutzer sehen darf – bei Bedarf sogar bis hin zu bestimmten Zeilen oder Spalten. Die Verschlüsselung schützt die Daten sowohl bei der Speicherung als auch während der Übertragung, während Protokolle aufzeigen, wer auf die Daten zugegriffen hat.

Unterstützung für strukturierte und halbstrukturierte Daten

Die meisten wiederkehrenden Berichte nutzen strukturierte Tabellen, doch Gesundheitssysteme erzeugen auch Daten in anderen Formaten. APIs und vernetzte Geräte senden beispielsweise möglicherweise JSON-Daten. Ein Data Warehouse kann diese Daten verarbeiten, ohne jedes Feld zuvor in eine festgelegte Tabelle umwandeln zu müssen. Unstrukturierte Dateien, wie beispielsweise medizinische Bilder, verbleiben in der Regel in einem Data Lake oder einem Objektspeicher und werden bei Bedarf mit den Daten im Data Warehouse verknüpft.

Skalierbarkeit und Leistung

Da die Menge der gespeicherten Daten und die Anzahl der Abfragen zunehmen, muss das Data Warehouse weiterhin reaktionsschnell bleiben. Plattformen können Partitionierung, Indizierung, Caching oder separate Rechenressourcen nutzen, um größere Arbeitslasten zu bewältigen, ohne die Architektur des Data Warehouses neu aufbauen zu müssen.

Interoperabilität

Ein Data Warehouse für das Gesundheitswesen muss Daten mit elektronischen Patientenakten, Laborsystemen und anderen klinischen Plattformen austauschen. HL7-Standards wie FHIR und HL7 v2 bieten den Teams einheitliche Formate für diesen Austausch, wodurch der Bedarf an benutzerdefinierten Zuordnungen sinkt. Für ältere oder proprietäre Systeme sind möglicherweise weiterhin benutzerdefinierte Konnektoren erforderlich, bevor das Data Warehouse deren Daten nutzen kann.

Bei Projekten im Gesundheitswesen würde ich Ergebnisse und Kosten nicht isoliert betrachten. Ein Data Warehouse ermöglicht es, Faktoren wie Aufenthaltsdauer und Wiederaufnahmen mit dem Ressourceneinsatz und dem Zeitaufwand des Personals zu vergleichen. Das ist in der wertorientierten Versorgung von Bedeutung, bei der man sowohl das Ergebnis als auch die dafür erforderlichen Maßnahmen verstehen muss.
Philip Tikhanovich, Head of Big Data.
Philip Tikhanovich
Leiter von Big Data

Integrationen von Datenlagern im Gesundheitswesen

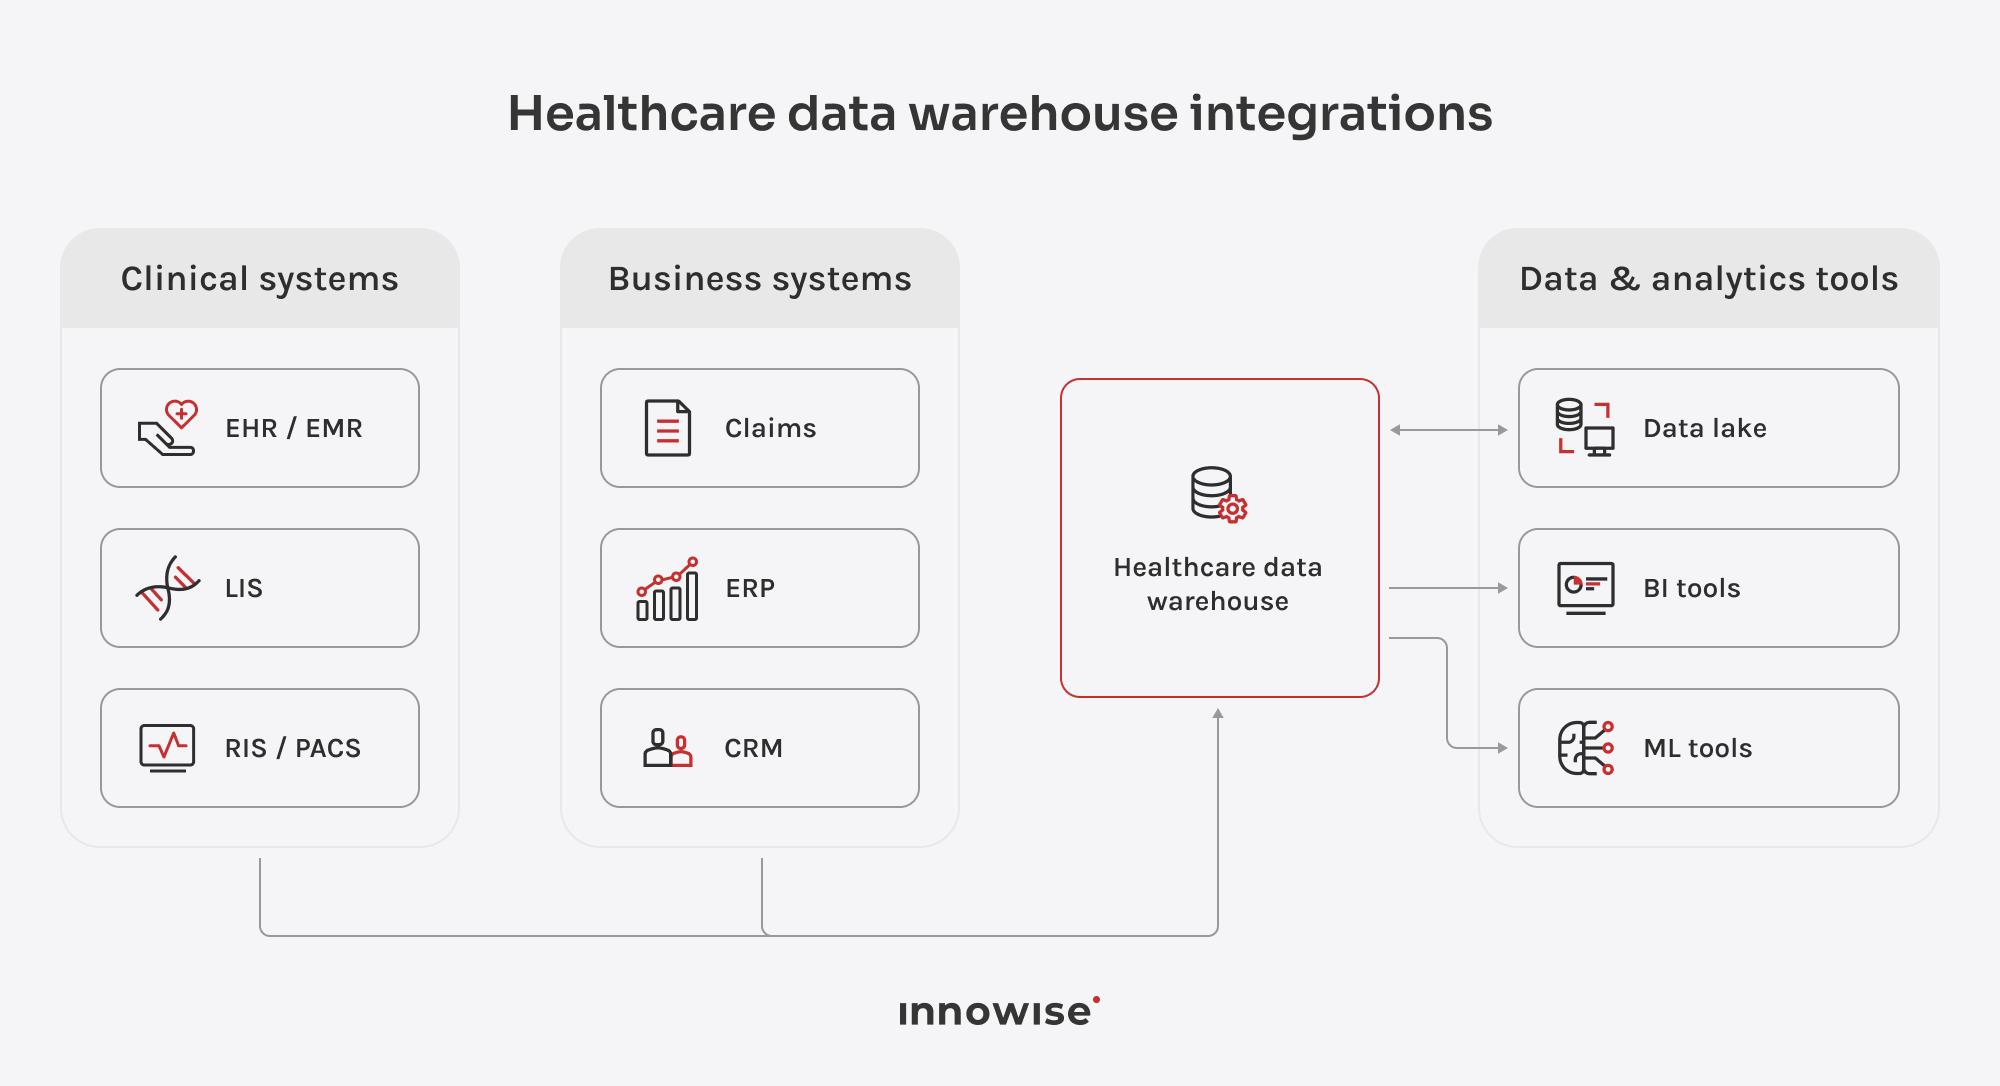
Wenn Sie ein klinisches Data Warehouse im Gesundheitswesen aufbauen, werden Sie in der Regel die Systeme anbinden, die Ihre Teams bereits täglich nutzen. Bei den gängigsten Integrationen werden Daten aus klinischen und betriebswirtschaftlichen Systemen eingespielt und für BI- und ML-Tools bereitgestellt.

Klinische Systeme

EHR- und EMR-Systeme übermitteln strukturierte klinische Daten in der Regel über FHIR-APIs oder HL7-v2-Feeds. FHIR eignet sich gut für Ressourcen wie „Patient“ und „Encounter“, während HL7 v2 nach wie vor häufig für Krankenhausereignisse und Laborergebnisse verwendet wird. LIS-Systeme nutzen oft HL7-v2-ORU-Nachrichten, um Testergebnisse an das Data Warehouse zu übermitteln.

In der Radiologie funktioniert das anders, da Bilddaten in der Regel außerhalb des Data Warehouse selbst gespeichert werden. Die Bilder werden in einem PACS oder einem Objektspeicher aufbewahrt, während das Data Warehouse die Metadaten zu Berichten und Untersuchungen mit Verweisen auf die entsprechenden DICOM-Dateien speichert.

Unternehmenssysteme

Abrechnungssysteme zeigen, was Leistungserbringer in Rechnung gestellt und was Kostenträger erstattet haben. In den USA erfolgt der Datenaustausch häufig über X12-Transaktionen, darunter 837-Abrechnungs- und 835-Zahlungsdateien. Durch die Speicherung von Daten sowohl auf Abrechnungsebene als auch auf Einzelpostenebene können Analysten die Gesamtkosten mit den einzelnen zugrunde liegenden Leistungen vergleichen.

ERP-Systeme liefern Kosten- und Personaldaten, während CRM-Systeme die Patientenkontakte außerhalb der Krankenakte erfassen. Wenn Teams diese Informationen mit klinischen Daten kombinieren, können sie beispielsweise untersuchen, ob Terminerinnerungen die Termintreue verbessern oder ob der Personalbestand der klinischen Tätigkeit entspricht.

Daten und Analysen

Ein Data Lake dient zur Speicherung von Rohdaten oder weniger strukturierten Daten, bevor Teams diese für das Data Warehouse aufbereiten. Ausgewählte Datensätze können im Data Lake bereinigt und anschließend in das Data Warehouse geladen werden. In manchen Konfigurationen fragt das Data Warehouse die Daten direkt aus dem Data Lake ab, anstatt sie zuvor zu kopieren.

BI-Tools wie Power BI oder Tableau stellen über native Konnektoren oder ODBC/JDBC eine Verbindung zum Data Warehouse her und lesen dort die aufbereiteten Daten ein. ML-Plattformen nutzen historische Daten aus dem Data Warehouse für das Training oder die Bewertung und senden anschließend die Modellausgaben, wie beispielsweise Risikowerte, zurück an das Data Warehouse, wo sie für Berichte oder andere Anwendungen verwendet werden.

Geschäftliche Vorteile

Wenn Sie die wirtschaftlichen Argumente für ein Data Warehouse im Gesundheitswesen abwägen, würde ich mir ansehen, welche Veränderungen sich daraus für die Teams ergeben, die die Daten nutzen. Die unten aufgeführten Vorteile eines unternehmensweiten Data Warehouse im Gesundheitswesen sind die Bereiche, in denen sich diese Auswirkungen in der Regel am deutlichsten zeigen.

Schnellere Berichterstattung

Anstatt Zahlen aus verschiedenen Systemen zu extrahieren und manuell abzugleichen, können Teams mit Daten arbeiten, die bereits im Data Warehouse aufbereitet sind. Wiederkehrende Berichte erfordern weniger Aufwand, und Analysten können mehr Zeit damit verbringen, die Zahlen zu analysieren, anstatt sie zusammenzustellen.

Einheitliche Patientenübersicht

Klinische Daten, Abrechnungsdaten und andere patientenbezogene Daten können systemübergreifend miteinander verknüpft werden, um den Teams einen umfassenderen Überblick über die Krankengeschichte eines Patienten zu verschaffen. Dadurch lässt sich der Behandlungsverlauf über verschiedene Konsultationen hinweg leichter nachverfolgen, ohne zwischen einzelnen Datensätzen hin- und herspringen zu müssen.

Bessere klinische Entscheidungen

Kliniker und Analysten können bei der Beantwortung von Fragen, die mehr als ein System betreffen, auf historische Daten aus dem gesamten Unternehmen zurückgreifen. Dieser umfassendere Kontext unterstützt Entscheidungen in Bezug auf Behandlungsmuster, Patientenrisiken und Versorgungsqualität.

Kosten- und Ressourcenoptimierung

Durch die Verknüpfung der klinischen Tätigkeit mit finanziellen oder betrieblichen Daten können Krankenhäuser nachvollziehen, wohin die Ressourcen fließen. Die Teams können das Leistungsvolumen mit dem Personalbestand oder den Kosten vergleichen und die Ergebnisse bei der Kapazitätsplanung berücksichtigen.

Bessere Schadenanalyse

Sobald die Abrechnungsdaten und klinischen Daten in derselben Datenbank vorliegen, können Analysten die abgerechneten Leistungen mit den von den Ärzten dokumentierten Behandlungen vergleichen. Sie können untersuchen, warum Versicherer Forderungen abgelehnt oder zu niedrig erstattet haben, und wiederkehrende Probleme bei der Abrechnung erkennen.

Prädiktive Analyse

Da die Datenbank historische Daten an einem Ort speichert, können Teams diese nutzen, um abzuschätzen, was als Nächstes passieren dürfte. Ein Modell könnte beispielsweise Patienten mit einem höheren Risiko einer erneuten Einweisung identifizieren oder Zeiten mit höherer Nachfrage vorhersagen. Pflege- und Betriebsteams können dann frühzeitig die Nachsorge oder den Personalbedarf planen.

Forschungsförderung

Forscher benötigen häufig Daten, die viele Patienten über lange Zeiträume hinweg abdecken. Ein Data Warehouse stellt ihnen Daten zur Verfügung, die für Kohortenanalysen oder retrospektive Studien bereit sind, ohne dass der Datensatz jedes Mal aus einzelnen Systemen neu zusammengestellt werden muss.

Analytik im Bereich der wertorientierten Versorgung

Bei der wertorientierten Versorgung müssen die Teams wissen, ob die von ihnen eingesetzten Ressourcen tatsächlich zu besseren Ergebnissen führen. Wenn die Datenbank die Ergebnisse mit den Daten zum Ressourceneinsatz verknüpft, können Analysten Patientengruppen vergleichen und feststellen, ob höhere Ausgaben oder eine intensivere Inanspruchnahme von Leistungen zu besseren Versorgungsergebnissen führen.

Häufige Herausforderungen bei Data-Warehouse-Projekten im Gesundheitswesen

Die oben genannten Vorteile sind zwar mit einigen Herausforderungen bei der Umsetzung verbunden, doch lassen sich diese viel leichter bewältigen, wenn man sie frühzeitig einplant. Ein erfahrenes Team kann viele der Risiken erkennen, bevor sie zu Nacharbeiten oder Problemen bei der Berichterstattung führen. Auf diese Punkte würde ich von Anfang an besonders achten.

Fragmentierte Daten und Interoperabilität

Ein System identifiziert einen Patienten möglicherweise anhand der Krankenaktennummer, während ein anderes System eine andere Kennung verwendet. Auch die Datenformate können variieren. Die Teams müssen diese Unterschiede korrekt zuordnen und die Zuordnungen aktualisieren, sobald sich ein Quellsystem ändert.

Schlechte Datenqualität

Ein Data Warehouse übernimmt die Probleme der Systeme, aus denen es gespeist wird. Fehlende Werte oder inkonsistente Codes können zu unzuverlässigen Berichten führen und spätere Analysen beeinträchtigen. Die Teams müssen diese Probleme erkennen, bevor andere Berichte oder Modelle auf dieselben Daten zurückgreifen.

Doppelte Patientenakten

Ein und derselbe Patient kann mehrmals erscheinen, wenn Systeme unterschiedliche Identifikatoren verwenden oder leicht abweichende personenbezogene Daten enthalten. Abgleichregeln müssen diese Duplikate identifizieren, ohne dabei versehentlich Datensätze verschiedener Personen miteinander zu verknüpfen.

Sicherheit und Datenschutz

Ein Gesundheitsdaten-Repository kann neben Finanz- und Betriebsdaten auch Patientenakten enthalten, doch nicht jeder Benutzer sollte Zugriff auf alle Informationen haben. Klinisches Personal benötigt möglicherweise Details auf Patientenebene, während Finanzteams unter Umständen nur Abrechnungsdaten benötigen. Legen Sie die Zugriffsrechte nach Rollen fest und überprüfen Sie die Berechtigungen jedes Mal, wenn Sie eine neue Datenquelle hinzufügen.

Governance

Teams benötigen klare Regeln darüber, wem gemeinsam genutzte Daten gehören und wer darüber entscheidet. Wenn beispielsweise zwei Abteilungen dieselbe Kennzahl unterschiedlich berechnen, muss jemand die Definition festlegen, die dann von allen verwendet wird. Das Gleiche gilt für die Genehmigung des Zugriffs auf sensible Daten.

Skalierung des Datenvolumens

Da im Data Warehouse immer mehr Daten aus früheren Jahren gesammelt und neue Datenquellen hinzugefügt werden, kann es zu Verzögerungen bei Abfragen kommen und die Speicherkosten können steigen. Die Teams müssen planen, wie sie ältere Daten organisieren und wie lange sie diese aufbewahren, damit das Datenwachstum die tägliche Berichterstellung nicht erschwert.

Mangel an internem Fachwissen im Bereich Data Engineering

Ihr Team kennt sich zwar gut mit den Gesundheitssystemen aus, verfügt jedoch nur über begrenzte Erfahrung beim Aufbau eines Data Warehouse auf dieser Grundlage. In diesem Fall können externe Dateningenieure bei der Konzeption der Pipelines und des Datenmodells helfen, während Ihr internes Team festlegt, welche Anforderungen die Daten erfüllen müssen.

Modelle für Data-Warehouses im Gesundheitswesen

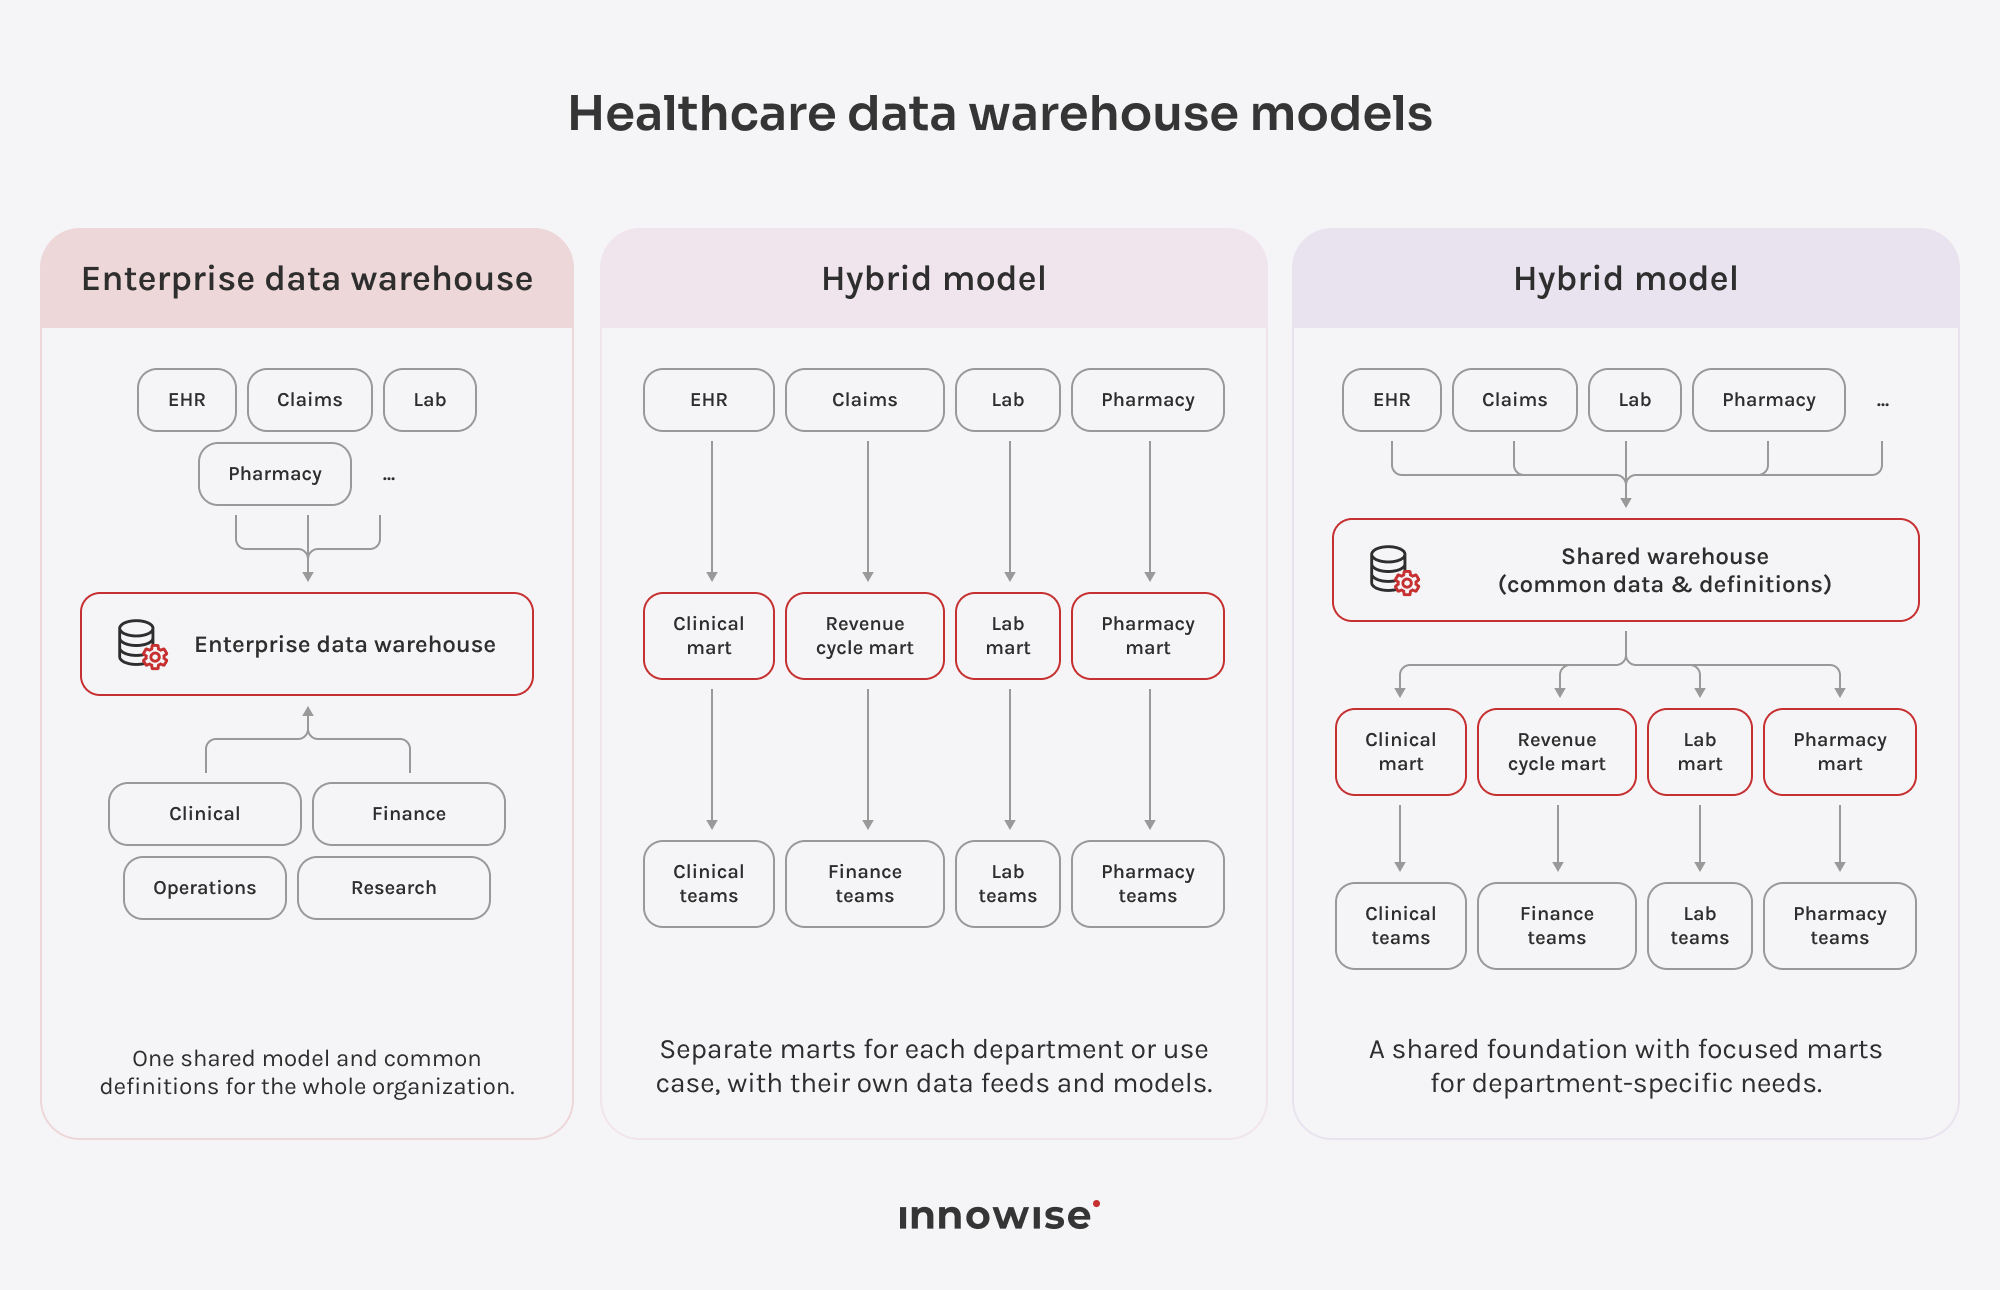
Welches Modell für ein Healthcare-Data-Warehouse das richtige ist, hängt davon ab, wie zentralisiert die Datenverwaltung sein soll und wie viel Eigenständigkeit die einzelnen Abteilungen benötigen. In der Praxis wählen Unternehmen in der Regel zwischen drei Modellen:

Unternehmensweites Data Warehouse

Ein Unternehmens-Data-Warehouse im Gesundheitswesen nutzt ein unternehmensweit einheitliches Datenmodell, sodass verschiedene Abteilungen mit einheitlichen Definitionen und Berichtsregeln arbeiten. So können beispielsweise klinische und finanzielle Teams die durchschnittliche Verweildauer auf dieselbe Weise berechnen, anstatt diese Kennzahl in ihren eigenen Berichten separat zu definieren.

Auf Datenebene können Teams Kernentitäten wie Patienten, Konsultationen, Leistungserbringer und Einrichtungen standardisieren und Datensätze aus Quellsystemen diesen gemeinsamen Strukturen zuordnen. Der Nachteil dabei ist, dass sie sich frühzeitig auf diese Definitionen einigen und diese im Zuge des Wachstums des Data Warehouse aufeinander abstimmen müssen. Das erfordert im Vorfeld mehr Aufwand, insbesondere in einer großen Organisation, in der sich Terminologie und Berichtsanforderungen ständig ändern. Sobald viele Berichte auf dem gemeinsamen Modell basieren, kann bereits eine kleine Änderung an einer Kerndefinition mehrere Teams gleichzeitig betreffen.

Unabhängige Data Marts

Ein unabhängiger Data Mart konzentriert sich auf eine bestimmte Abteilung oder einen bestimmten analytischen Anwendungsfall, anstatt Daten für das gesamte Unternehmen zu modellieren. Ein Onkologie-Team könnte beispielsweise einen Data Mart auf der Grundlage der von ihm benötigten klinischen Systeme aufbauen, während Analysten für den Umsatzzyklus einen weiteren Data Mart erstellen, der sich auf Abrechnungs- und Rechnungsdaten konzentriert.

Da jeder Data Mart einen kleineren Umfang hat, können Teams die ersten Berichte oft schneller bereitstellen. Wenn weitere Marts hinzugefügt werden, benötigt dasselbe Quellsystem möglicherweise für jeden einzelnen separate Pipelines und Zuordnungen. Außerdem können sich die Definitionen zwischen den Abteilungen unterscheiden. Und da Marts oft Daten speichern, die bereits für einen bestimmten Anwendungsfall aufbereitet oder zusammengefasst wurden, fehlen ihnen möglicherweise die Details, die für eine spätere, andere Analyse erforderlich sind.

Hybrides Modell

Ein Hybridmodell kombiniert ein gemeinsames Unternehmens-Data-Warehouse mit Data Marts, die für bestimmte Abteilungen oder Analysezwecke eingerichtet wurden. Kerndaten und gemeinsame Definitionen verbleiben in der zentralen Ebene, während jeder Data Mart diese Daten für seine eigenen Berichtsanforderungen aufbereitet. Da die Data Marts auf das Data-Warehouse zurückgreifen, müssen die Teams keine separate Integration zu jedem Quellsystem aufbauen.

Diese Konfiguration ermöglicht es Unternehmen, neue Marts hinzuzufügen, sobald sich die Berichtsanforderungen ändern, ohne von Anfang an jeden zukünftigen Anwendungsfall modellieren zu müssen. Die größere Herausforderung besteht darin, zu entscheiden, was zentral standardisiert werden sollte und was spezifisch für einen einzelnen Mart bleiben kann. Wenn zu viel Logik in einzelne Marts verlagert wird, können sich die Definitionen im Laufe der Zeit auseinanderentwickeln.

Planen Sie ein Data Warehouse für das Gesundheitswesen und wägen gerade Ihre Optionen ab?

Anwendungsfälle für Data Warehouses im Gesundheitswesen

Einrichtungen des Gesundheitswesens nutzen Data Warehouses für sehr unterschiedliche Aufgaben, je nachdem, welche Daten sie erfassen und welche Entscheidungen sie treffen müssen. Die folgenden Beispiele für Data Warehouses im Gesundheitswesen veranschaulichen, wie sich dies in der klinischen und betrieblichen Arbeit auswirkt.

Population Health Management

Teams für Bevölkerungsgesundheit nutzen Daten aus dem Datenlager, um Patientengruppen mit ähnlichen Versorgungsbedürfnissen zu ermitteln. So können sie beispielsweise Personen identifizieren, bei denen Vorsorgeuntersuchungen oder Nachsorgeuntersuchungen überfällig sind, und diese Listen an die Teams für die Patientenansprache weiterleiten.

Behandlung chronischer Erkrankungen

Bei chronischen Erkrankungen müssen die Behandlungsteams erkennen können, welche Veränderungen zwischen den Terminen auftreten. Eine zentrale Datenbank kann Laborergebnisse und die Medikamentenhistorie über alle Besuche hinweg zusammenführen und, sofern verfügbar, die Messwerte vernetzter Geräte hinzufügen. Anhand dieser zusammengefassten Historie können die Teams Veränderungen im Zustand eines Patienten erkennen und entscheiden, wann möglicherweise ein früherer Folgetermin erforderlich ist.

Prädiktive Risikoanalyse bei Patienten

Die Teams nutzen historische Daten aus dem Data Warehouse, um abzuschätzen, bei welchen Patienten ein erhöhtes Risiko für eine Wiederaufnahme oder das Versäumen eines Termins besteht. Diese Bewertungen werden den Ärzten in der Regel über ein Care-Management- oder Outreach-System übermittelt. Das Zurückschreiben dieser Werte in die elektronische Patientenakte selbst erfolgt meist über eine separate Integration: Anbieter von elektronischen Patientenakten neigen dazu, den Schreibzugriff streng zu kontrollieren.

Klinische Forschung und Studien

Die Suche nach geeigneten Studienteilnehmern beginnt oft mit einer langen Liste von Ein- und Ausschlusskriterien. Forscher können diese Kriterien zunächst auf anonymisierte Daten aus dem Datenlager anwenden und so den Kandidatenpool eingrenzen, bevor sie einzelne Krankenakten prüfen. Bei Studien an mehreren Standorten können die Teams zudem die Datensätze aus verschiedenen Einrichtungen vor der Analyse in eine gemeinsame Struktur überführen.

Analyse des Umsatzzyklus und der Leistungsabrechnungen

Zahlungsprobleme können zu jedem Zeitpunkt zwischen der ursprünglichen Abrechnung und der endgültigen Erstattung auftreten. Durch die Verknüpfung von klinischen Daten, Abrechnungsdaten und Daten zu Leistungsanträgen können die Umsatzteams erkennen, an welcher Stelle ein Leistungsantrag ins Stocken geraten ist und ob bei einem bestimmten Kostenträger oder einer bestimmten Leistung immer wieder derselbe Ablehnungsgrund auftritt.

Personal- und Kapazitätsplanung

Die Führungskräfte vergleichen das Patientenaufkommen pro Station und Schicht mit dem gleichzeitig eingeteilten Personal. Wenn auf einer bestimmten Station an bestimmten Tagen oder zu Spitzenzeiten wiederholt Personalengpässe auftreten, können sie die künftigen Dienstpläne entsprechend anpassen, um diesem Muster Rechnung zu tragen.

Optimierung der Betriebskosten

Wenn Finanzdaten mit klinischen Aktivitäten verknüpft werden, können Teams erkennen, woher die Betriebskosten tatsächlich stammen. Sie können die Ausgaben nach Eingriff, Einrichtung oder Versorgungsart vergleichen und untersuchen, warum die Kosten in einigen Bereichen höher sind als in anderen.

Umsetzungsprozess

Jedes Projekt zum Aufbau eines Data Warehouse im Gesundheitswesen beginnt anders. Die einzelnen Schritte hängen von Ihren derzeitigen Systemen, der Qualität Ihrer Daten und den Anforderungen an das Data Warehouse ab. So gehen wir in der Regel vor.

01
Analyse

Unser Team definiert die ersten Anwendungsfälle für die Berichterstellung bzw. Analyse im Rahmen der ersten Version und ermittelt die Personen, die diese benötigen. Außerdem legen wir fest, welche Quellsysteme in den Umfang fallen, und weisen auf regulatorische Einschränkungen hin, bevor wir architektonische Entscheidungen treffen.

02
Datenbewertung

Bevor wir Pipelines erstellen, überprüfen wir jede Quelle auf fehlende Daten und inkonsistente Formate und suchen anschließend nach Duplikaten. Die Ergebnisse zeigen, was unverändert bleiben kann und wo wir Bereinigungsregeln benötigen, bevor sich diese Probleme auf die Berichterstattung in der Produktion auswirken.

03
Architektur

Unsere Datenarchitekten wählen das Data-Warehouse-Modell danach aus, in welchem Umfang Teams Daten und Definitionen gemeinsam nutzen müssen. Anschließend entwerfen sie die Erfassungs- und Speicherebenen entsprechend den Systemen des Unternehmens und legen fest, wie Analysetools auf das Data Warehouse zugreifen sollen.

04
Technologieauswahl

Nachdem die Architektur festgelegt wurde, wählt das Team die Plattform, den ETL-/ELT-Ansatz sowie die BI- oder ML-Tools auf der Grundlage des Datenvolumens und des bestehenden Tech-Stacks aus. Budget- und Compliance-Aspekte schränken die Auswahl ein, insbesondere wenn Zugriffskontrollen oder Audit-Protokollierung erforderlich sind.

05
Integration

Dateningenieure verbinden das Data Warehouse mit den Quellsystemen. Je nach Umgebung verwenden sie möglicherweise FHIR oder HL7 v2 für klinische Daten, X12 für US-amerikanische Abrechnungsdaten sowie APIs oder native Konnektoren für Geschäftsanwendungen. Durch das Testen jedes Datenfeeds mit Echtdaten lassen sich Mapping-Fehler frühzeitig erkennen.

06
Entwicklung

Innowise-Entwickler erstellen Pipelines, die Formate vereinheitlichen und doppelte Datensätze bereinigen, bevor die vereinbarten Geschäftsdefinitionen angewendet werden. Wenn das Design Data Marts umfasst, erstellen sie diese auf der gemeinsamen Ebene, anstatt erneut eine Verbindung zu jeder einzelnen Quelle herzustellen.

07
Migration und Tests

Das Team lädt historische Daten ein und gleicht sie mit den Originalquellen ab, um fehlende oder veränderte Werte zu erkennen. Anschließend prüfen die Analysten die Berichte anhand der in der Erkundungsphase definierten Anwendungsfälle, während die Fachanwender die Ergebnisse vor der Inbetriebnahme überprüfen.

08
Launch

Bei der Einführung führt unser Team häufig alte und neue Berichte parallel aus, damit die Nutzer die Zahlen vergleichen können, bevor sie umstellen. Außerdem beobachten wir die ersten Einsätze in der Produktion sehr genau, da hier oft Daten- oder Leistungsprobleme zutage treten, die bei den Tests übersehen wurden.

09
Unterstützung

Nach der Inbetriebnahme überwachen wir die Leistung, fügen neue Quellen hinzu und pflegen die Governance-Prozesse, die die Konsistenz der gemeinsamen Definitionen gewährleisten. In der Regel handelt es sich dabei um eine der längsten Projektphasen und eine derjenigen, die bei der Planung am leichtesten unterschätzt werden.

arrow-icon. arrow-icon.
01 Analyse

Unser Team definiert die ersten Anwendungsfälle für die Berichterstellung bzw. Analyse im Rahmen der ersten Version und ermittelt die Personen, die diese benötigen. Außerdem legen wir fest, welche Quellsysteme in den Umfang fallen, und weisen auf regulatorische Einschränkungen hin, bevor wir architektonische Entscheidungen treffen.

arrow-icon. arrow-icon.
02 Datenbewertung

Bevor wir Pipelines erstellen, überprüfen wir jede Quelle auf fehlende Daten und inkonsistente Formate und suchen anschließend nach Duplikaten. Die Ergebnisse zeigen, was unverändert bleiben kann und wo wir Bereinigungsregeln benötigen, bevor sich diese Probleme auf die Berichterstattung in der Produktion auswirken.

arrow-icon. arrow-icon.
03 Architektur

Unsere Datenarchitekten wählen das Data-Warehouse-Modell danach aus, in welchem Umfang Teams Daten und Definitionen gemeinsam nutzen müssen. Anschließend entwerfen sie die Erfassungs- und Speicherebenen entsprechend den Systemen des Unternehmens und legen fest, wie Analysetools auf das Data Warehouse zugreifen sollen.

arrow-icon. arrow-icon.
04 Technologieauswahl

Nachdem die Architektur festgelegt wurde, wählt das Team die Plattform, den ETL-/ELT-Ansatz sowie die BI- oder ML-Tools auf der Grundlage des Datenvolumens und des bestehenden Tech-Stacks aus. Budget- und Compliance-Aspekte schränken die Auswahl ein, insbesondere wenn Zugriffskontrollen oder Audit-Protokollierung erforderlich sind.

arrow-icon. arrow-icon.
05 Integration

Dateningenieure verbinden das Data Warehouse mit den Quellsystemen. Je nach Umgebung verwenden sie möglicherweise FHIR oder HL7 v2 für klinische Daten, X12 für US-amerikanische Abrechnungsdaten sowie APIs oder native Konnektoren für Geschäftsanwendungen. Durch das Testen jedes Datenfeeds mit Echtdaten lassen sich Mapping-Fehler frühzeitig erkennen.

arrow-icon. arrow-icon.
06 Entwicklung

Innowise-Entwickler erstellen Pipelines, die Formate vereinheitlichen und doppelte Datensätze bereinigen, bevor die vereinbarten Geschäftsdefinitionen angewendet werden. Wenn das Design Data Marts umfasst, erstellen sie diese auf der gemeinsamen Ebene, anstatt erneut eine Verbindung zu jeder einzelnen Quelle herzustellen.

arrow-icon. arrow-icon.
07 Migration und Tests

Das Team lädt historische Daten ein und gleicht sie mit den Originalquellen ab, um fehlende oder veränderte Werte zu erkennen. Anschließend prüfen die Analysten die Berichte anhand der in der Erkundungsphase definierten Anwendungsfälle, während die Fachanwender die Ergebnisse vor der Inbetriebnahme überprüfen.

arrow-icon. arrow-icon.
08 Launch

Bei der Einführung führt unser Team häufig alte und neue Berichte parallel aus, damit die Nutzer die Zahlen vergleichen können, bevor sie umstellen. Außerdem beobachten wir die ersten Einsätze in der Produktion sehr genau, da hier oft Daten- oder Leistungsprobleme zutage treten, die bei den Tests übersehen wurden.

arrow-icon. arrow-icon.
09 Unterstützung

Nach der Inbetriebnahme überwachen wir die Leistung, fügen neue Quellen hinzu und pflegen die Governance-Prozesse, die die Konsistenz der gemeinsamen Definitionen gewährleisten. In der Regel handelt es sich dabei um eine der längsten Projektphasen und eine derjenigen, die bei der Planung am leichtesten unterschätzt werden.

Dienstleistungen im Bereich Gesundheits-Data-Warehouse

Wenn Sie ein Data Warehouse für das Gesundheitswesen von Grund auf neu aufbauen, benötigen Sie eine andere Unterstützung als bei der Überarbeitung oder Erweiterung eines bestehenden Systems. Innowise kann in beiden Phasen einsteigen und die für Ihre Konfiguration erforderlichen Aufgaben übernehmen.

  • Beratung zum Thema Data Warehouse im Gesundheitswesen
  • Architektur und Design
  • DWH-Entwicklung
  • Datenintegration und -migration
  • Modernisierung des bestehenden Data Warehouse
  • Integration von BI und Analytik
  • Support und Optimierung

Beratung zum Thema Data Warehouse im Gesundheitswesen

Sollten Sie bereits Probleme mit der Berichterstellung haben oder über ein bestehendes Lager verfügen, das den Anforderungen nicht mehr gerecht wird, erarbeiten wir gemeinsam, was geändert werden muss. Unser Team prüft die aktuelle Situation und vergleicht die verfügbaren Optionen. Auf dieser Grundlage helfen wir Ihnen bei der Entscheidung, welche Anwendungsfälle Priorität haben sollten.

Nurse reviews lab results and medication history in EHR system before patient rounds.

Architektur und Design

Sobald die Anforderungen festgelegt sind, entwerfen unsere Architekten eine Datenbankstruktur, die auf Ihre Systeme und die zu erwartenden Arbeitslasten zugeschnitten ist. Sie legen fest, wie die Hauptkomponenten miteinander verbunden sind und wo sich die gemeinsam genutzten Daten befinden. Die Struktur lässt sich dann an neue Datenquellen oder Berichtsanforderungen anpassen, sobald diese auftreten.

Building layouts and style guides for a new web application project.

DWH-Entwicklung

Sobald der Entwurf genehmigt ist, erstellen unsere Ingenieure das Data Warehouse, einschließlich der Transformationslogik und aller erforderlichen Data Marts. Dabei integrieren sie bereits während der Entwicklung Qualitätsprüfungen und Sicherheitskontrollen, damit das Data Warehouse die für das Projekt erforderlichen Berichte und Analysen unterstützen kann.

IT specialist analyzing software code during an evening sprint session.

Datenintegration und -migration

Wir verbinden das Data Warehouse mit EHR/EMR-, Abrechnungs-, Labor-, ERP/CRM- und anderen Quellsystemen. Die historischen Daten werden dann mit den erforderlichen Zuordnungen und Transformationen in das Zielmodell übertragen. Vor der Umstellung werden die migrierten Daten im Rahmen von Abgleichprüfungen mit den Quelldaten verglichen.

Data engineer interacts with a visual dashboard to orchestrate real-time data synchronization across systems.

Modernisierung des bestehenden Data Warehouse

Da sich Datenquellen und Berichtsanforderungen ändern, reicht bei einem bestehenden Data Warehouse eine routinemäßige Wartung unter Umständen nicht mehr aus. Wir aktualisieren veraltete Datenmodelle und Pipelines, verlagern Workloads, wenn die aktuelle Plattform zu einem Engpass wird, und automatisieren sich wiederholende Aufgaben im Datenmanagement, wo dies sinnvoll ist.

IT operations team tracks software patch rollout in real time via a mobile device interface.

Integration von BI und Analytik

Unsere Experten verbinden das Data Warehouse mit den BI- und Analysetools, die Ihre Teams bereits nutzen. Je nach Konfiguration können sie Daten importieren oder das Data Warehouse direkt abfragen. Gemeinsame Kennzahlen und Berichtsregeln werden an einem Ort zusammengefasst, anstatt in jedem Dashboard neu erstellt zu werden.

Accessing a centralized analytics portal to evaluate company operations and outcomes.

Support und Optimierung

Nach der Inbetriebnahme passt sich das Data Warehouse kontinuierlich an Ihre Daten- und Berichtsanforderungen an. Unser Team kann Probleme mit Pipelines oder Daten beheben, neue Quellen hinzufügen, langsame Abfragen optimieren und Modelle aktualisieren, wenn sich die geschäftlichen Anforderungen ändern.

The consulting team reviews analytics on screen, focusing on data-driven IT strategy and solutions.
Beratung zum Thema Data Warehouse im Gesundheitswesen

Sollten Sie bereits Probleme mit der Berichterstellung haben oder über ein bestehendes Lager verfügen, das den Anforderungen nicht mehr gerecht wird, erarbeiten wir gemeinsam, was geändert werden muss. Unser Team prüft die aktuelle Situation und vergleicht die verfügbaren Optionen. Auf dieser Grundlage helfen wir Ihnen bei der Entscheidung, welche Anwendungsfälle Priorität haben sollten.

Nurse reviews lab results and medication history in EHR system before patient rounds.
Architektur und Design

Sobald die Anforderungen festgelegt sind, entwerfen unsere Architekten eine Datenbankstruktur, die auf Ihre Systeme und die zu erwartenden Arbeitslasten zugeschnitten ist. Sie legen fest, wie die Hauptkomponenten miteinander verbunden sind und wo sich die gemeinsam genutzten Daten befinden. Die Struktur lässt sich dann an neue Datenquellen oder Berichtsanforderungen anpassen, sobald diese auftreten.

Building layouts and style guides for a new web application project.
DWH-Entwicklung

Sobald der Entwurf genehmigt ist, erstellen unsere Ingenieure das Data Warehouse, einschließlich der Transformationslogik und aller erforderlichen Data Marts. Dabei integrieren sie bereits während der Entwicklung Qualitätsprüfungen und Sicherheitskontrollen, damit das Data Warehouse die für das Projekt erforderlichen Berichte und Analysen unterstützen kann.

IT specialist analyzing software code during an evening sprint session.
Datenintegration und -migration

Wir verbinden das Data Warehouse mit EHR/EMR-, Abrechnungs-, Labor-, ERP/CRM- und anderen Quellsystemen. Die historischen Daten werden dann mit den erforderlichen Zuordnungen und Transformationen in das Zielmodell übertragen. Vor der Umstellung werden die migrierten Daten im Rahmen von Abgleichprüfungen mit den Quelldaten verglichen.

Data engineer interacts with a visual dashboard to orchestrate real-time data synchronization across systems.
Modernisierung des bestehenden Data Warehouse

Da sich Datenquellen und Berichtsanforderungen ändern, reicht bei einem bestehenden Data Warehouse eine routinemäßige Wartung unter Umständen nicht mehr aus. Wir aktualisieren veraltete Datenmodelle und Pipelines, verlagern Workloads, wenn die aktuelle Plattform zu einem Engpass wird, und automatisieren sich wiederholende Aufgaben im Datenmanagement, wo dies sinnvoll ist.

IT operations team tracks software patch rollout in real time via a mobile device interface.
Integration von BI und Analytik

Unsere Experten verbinden das Data Warehouse mit den BI- und Analysetools, die Ihre Teams bereits nutzen. Je nach Konfiguration können sie Daten importieren oder das Data Warehouse direkt abfragen. Gemeinsame Kennzahlen und Berichtsregeln werden an einem Ort zusammengefasst, anstatt in jedem Dashboard neu erstellt zu werden.

Accessing a centralized analytics portal to evaluate company operations and outcomes.
Support und Optimierung

Nach der Inbetriebnahme passt sich das Data Warehouse kontinuierlich an Ihre Daten- und Berichtsanforderungen an. Unser Team kann Probleme mit Pipelines oder Daten beheben, neue Quellen hinzufügen, langsame Abfragen optimieren und Modelle aktualisieren, wenn sich die geschäftlichen Anforderungen ändern.

The consulting team reviews analytics on screen, focusing on data-driven IT strategy and solutions.

Möchten Sie Ihre Dateninfrastruktur im Gesundheitswesen modernisieren?

Anbieter von Data Warehouses für das Gesundheitswesen

Wenn Sie Plattformen für ein Lager im Gesundheitswesen vergleichen, ist Ihre bestehende Cloud-Umgebung ein guter Ausgangspunkt. Die unten aufgeführten Optionen gehen unterschiedlich mit Daten aus dem Gesundheitswesen um, und auch ihre Rechen- und Preismodelle unterscheiden sich.

Amazon-Redshift-Logo (1)

Amazon Redshift

Redshift lässt sich nahtlos integrieren, wenn sich der Großteil Ihrer Daten bereits in AWS befindet. Es arbeitet mit S3 und AWS Glue zusammen, während HealthLake FHIR-Daten zur weiteren Analyse über Redshift oder andere AWS-Analysedienste in S3 exportieren kann.

Wichtigste Features

  • SQL für strukturierte und semistrukturierte Daten
  • S3-Zugriff über Redshift Spectrum
  • Föderierte Abfragen an unterstützte AWS-Datenbanken
  • Zugriffskontrollen auf Zeilen- und Spaltenebene
  • Rechenleistung und verwalteter Speicher voneinander trennen
  • HIPAA-konformer AWS-Dienst 

Preisgestaltung

  • On-Demand-Preise für bereitgestellte Cluster
  • Serverlose Rechenleistung, die nach Nutzung abgerechnet wird
  • Gebühren für separat verwalteten Speicherplatz
  • Reservierte Preise für gleichbleibende Arbeitslasten
Azure Synapse Analytics

Azure Synapse Analytics

Synapse eignet sich besonders gut, wenn Ihre Daten und Berichte bereits in Azure verarbeitet werden und Ihre Teams Power BI nutzen. Die Lösung vereint SQL-Data-Warehousing und Spark in einem Arbeitsbereich und bietet Pipelines für den Datentransfer zwischen Azure-Diensten. FHIR-Daten aus den Azure Health Data Services können ebenfalls zur Analyse in Synapse kopiert werden.

Wichtigste Features

  • Dediziertes und serverloses SQL
  • Apache Spark-Pools
  • Abfragen über den Azure-Data-Lake
  • Integrierte ETL-/ELT-Pipelines
  • ML-Integrationen für Power BI und Azure
  • FHIR-Analysen mit Azure Health Data Services

Preisgestaltung

  • Serverloses SQL, Abrechnung nach verarbeiteten Daten
  • Dediziertes SQL, abgerechnet nach DWU-Verbrauch
  • Spark wird nach vCore-Nutzung abgerechnet
  • Vorabkaufoptionen für festgelegte Arbeitslasten

Für Teams, die sich mehr Flexibilität bei der Auswahl der Cloud-Anbieter wünschen, sorgt Snowflake dafür, dass die Warehouse-Ebene weniger stark von einem einzigen Ökosystem abhängig ist. Die Plattform läuft auf AWS, Azure und Google Cloud, während separate virtuelle Warehouses es den Teams ermöglichen, verschiedenen Workloads eigene Rechenressourcen zuzuweisen.

Wichtigste Features

  • Optionen für die Multi-Cloud-Bereitstellung
  • Unabhängige Rechenleistung für unterschiedliche Arbeitslasten
  • Multi-Cluster-Repositorys in der Enterprise Edition+
  • Native Unterstützung für halbstrukturierte Daten
  • Sicherer Datenaustausch
  • PHI-Support mit Business Critical+

Preisgestaltung

  • Verbrauchsabhängige Rechen-Credits
  • Separate Lagergebühren
  • Kapazität auf Abruf oder im Voraus bezahlt 
  • Die Preise variieren je nach Cloud, Region und Edition
GCP BigQuery

Google BigQuery

BigQuery eignet sich für Unternehmen, die bereits Google Cloud nutzen oder ein serverloses Data Warehouse wünschen, ohne Rechencluster verwalten zu müssen. Die Cloud Healthcare API kann FHIR-Ressourcen und DICOM-Metadaten nach BigQuery exportieren, wodurch Analyseteams über SQL Zugriff auf Gesundheitsdaten erhalten.

Wichtigste Features

  • Serverloses SQL-Data-Warehouse
  • Speicher und Rechenleistung trennen
  • Integrierte Funktionen für maschinelles Lernen
  • Externe und föderierte Abfragen
  • Cloud – Integration der Healthcare-API
  • BigQuery fällt unter die HIPAA-BAA von Google Cloud

Preisgestaltung

  • On-Demand-Rechenleistung, abgerechnet nach der verarbeiteten Datenmenge
  • Kapazitätspreisgestaltung auf der Grundlage von Zeitnischen
  • Speicherplatz wird separat abgerechnet
  • Verfügbare Verpflichtungen für reservierte Kapazitäten

Kosten und Zeitplan

Die Budgets für Data Warehouses im Gesundheitswesen können um mehr als eine Größenordnung variieren. Ein kleiner Produktions-Data-Mart mit einigen wenigen bereinigten Datenquellen kann etwa $60.000–$100.000 kosten und 2–4 Monate in Anspruch nehmen. Ein unternehmensweites Data Warehouse mit mehreren Systemen, Migration historischer Daten und mehreren Data Marts kann Kosten von $400.000 bis $1 Million oder mehr verursachen und 9–18 Monate oder länger dauern.

ProjektumfangTypischer AnwendungsbereichZeitraumDurchführungsbudgetLaufende Cloud- und Softwarekosten
Abteilungs-Data-Mart1–2 Quellsysteme, eine Abteilung, begrenzte Datenhistorie, einfache BI-Berichterstellung2–4 Monate$60k–$100k$1k–$5k/Monat
Mittelgroßes Data Warehouse für das Gesundheitswesen3–6 Datenquellen, gemeinsames Datenmodell, Migration historischer Daten, 2–4 Data Marts, BI-Integration5–9 Monate$150k–$350k$5k–$20k/Monat
Unternehmensweites Data Warehouse / LakehouseMehr als 7 Datenquellen, umfangreiche historische Daten, mehrere Marktplätze, maßgeschneiderte klinische Integrationen, fortschrittliche Analysen9–18+ Monate$400k–$1m+$20k–$80k+/Monat

Gesundheitslösungen von Innowise

Warum Sie sich für uns entscheiden sollten
Ein DWH-Projekt im Gesundheitswesen bewegt sich zwischen Data Engineering und dem Gesundheitswesen IT. Innowise verfügt über Erfahrung in beiden Bereichen, untermauert durch entsprechende ISO-Zertifizierungen und Partnerschaften mit den Cloud- und Datenanbietern, die bei Data-Warehouse-Projekten zum Einsatz kommen.

Erfahrung im Gesundheitswesen

Wir verfügen über mehr als 19 Jahre Erfahrung im Gesundheitswesen (IT), darunter in den Bereichen elektronische Patientenakten, Laborsysteme, medizinische Bildgebung und vernetzte Gesundheitsplattformen. Diese Erfahrung ist von entscheidender Bedeutung, wenn klinische Arbeitsabläufe oder Datenstandards im Gesundheitswesen die Gestaltung des Data Warehouse bestimmen.

Fachwissen im Bereich Data Engineering

Unsere Datenteams arbeiten mit Snowflake, BigQuery, Amazon Redshift und Azure Synapse sowie den dazugehörigen ETL/ELT- und Orchestrierungstools. Das bedeutet, dass wir das Data Warehouse an die bestehende Infrastruktur des Kunden anpassen können, anstatt uns auf eine bestimmte Plattform festzulegen.
Relevante Zertifizierungen

Innowise ist nach ISO 9001, ISO 27001 und ISO 13485 zertifiziert, wobei diese Zertifizierungen die Bereiche Qualität, Informationssicherheit und Medizinprodukte abdecken.

Liefernachweis

Zu unseren bisherigen Erfolgen zählen mehr als 1.600 Projekte in verschiedenen Branchen und mehr als 60 IT-Lösungen im Gesundheitswesen. Für ein Unternehmen im Bereich der Präzisionsmedizin haben wir verbesserte Datenpipelines und AWS-Infrastruktur wird zur Verarbeitung von Diagnosedaten aus verschiedenen Quellen verwendet.

Erfahrung in den Bereichen Sicherheit und Compliance

Unsere Teams im Gesundheitswesen arbeiten unter Einhaltung der HIPAA- und DSGVO-Vorschriften sowie nach Standards für den Datenaustausch im Gesundheitswesen wie HL7 v2 und FHIR. Diese Erfahrung ist von Bedeutung, wenn sensible Gesundheitsdaten zwischen dem Data Warehouse und regulierten klinischen Systemen übertragen werden.

Technologiepartnerschaften

Als Partner von AWS, Microsoft, Google Cloud und Databricks bringt Innowise zertifiziertes Plattform-Know-how in DWH-Projekte ein und kann bei plattformspezifischen Problemen auf den Support der Anbieter zurückgreifen.

ISO 13485 certification.
ISO 9001 certification.
ISO/IEC 27001 certification.
DSGVO
Select partner AWS
Google_Cloud_Partner

Abschließend

Ich würde ein Data-Warehouse-Projekt im Gesundheitswesen nicht damit beginnen, alle Datensätze an einem Ort zusammenzuführen. Wählen Sie stattdessen ein Berichts- oder Analyseproblem aus, dessen Lösung sich lohnt, und verbinden Sie nur die Systeme, die für diese Aufgabe erforderlich sind. Sie könnten beispielsweise mit der Berichterstattung zum Umsatzzyklus oder der Analyse von Wiederaufnahmen beginnen. Sobald das funktioniert, können Sie anhand des tatsächlichen Bedarfs entscheiden, was das Data Warehouse als Nächstes benötigt. 

Dieser Ansatz sollte auch im Zuge des Projektwachstums beibehalten werden. Fügen Sie neue Quellen oder Data Marts nur dann hinzu, wenn es einen klaren Grund dafür gibt, anstatt zu versuchen, sich auf jeden möglichen zukünftigen Bedarf vorzubereiten. Wichtig ist, dass die Definitionen und Zugriffsregeln auch bei der Erweiterung des Data Warehouse konsistent bleiben und dass die Compliance-Anforderungen stets erfüllt werden. 

Sollten Sie externe Unterstützung benötigen, stehen Ihnen Fachleute von Innowise – Hub für das Gesundheitswesen und die Pharmabranche IT kann Ihr bestehendes Data Warehouse überprüfen oder Ihnen dabei helfen, ein neues Data Warehouse zu entwickeln, das auf Ihre Gesundheitssysteme und Berichtsanforderungen zugeschnitten ist und dabei die Compliance-Anforderungen für Gesundheitsdaten berücksichtigt.

FAQ

Ein Healthcare-Data-Warehouse speichert aufbereitete Daten für die Berichterstellung und Analyse. Ein Data Lake enthält in der Regel größere Mengen an Rohdaten oder nur geringfügig verarbeiteten Daten. In vielen Architekturen werden im Data Lake umfassendere Datensätze gespeichert, während das Data Warehouse die Daten enthält, die die Teams für wiederkehrende klinische, finanzielle oder betriebliche Analysen benötigen.

Die Zeitpläne variieren je nach Umfang, Quellsystemen und Datenqualität. Die Einrichtung eines fokussierten Data Marts mit wenigen Integrationen kann 2 bis 4 Monate dauern. Die Einrichtung eines größeren Unternehmens-Data-Warehouse im Gesundheitswesen kann 9 bis 18 Monate oder länger dauern, wenn das Projekt die Migration von Altdaten, mehrere Integrationen und mehrere Data Marts umfasst.

Das richtige Datenlagermodell für das Gesundheitswesen hängt davon ab, wie viele Teams die Daten benötigen und ob sie dieselben Berichtsdefinitionen verwenden sollen. Ein Unternehmensmodell unterstützt die organisationsweite Berichterstellung, während unabhängige Datenmärkte sich auf bestimmte Abteilungen oder Anwendungsfälle konzentrieren. Ein Hybridmodell kombiniert einen gemeinsamen Kern mit stärker fokussierten Datenmärkten. Die Gestaltung eines Datenlagers für das Gesundheitswesen sollte die Anwendungsfälle widerspiegeln, die Sie als Erstes unterstützen müssen.

Ja. Wir können Ihr bestehendes Data Warehouse für das Gesundheitswesen modernisieren, ohne es auf einen Schlag komplett zu ersetzen. Unser Team baut veraltete Pipelines neu auf, überarbeitet Datenmodelle, verlagert ausgewählte Workloads und bindet schrittweise neuere Analysetools ein. Die Automatisierung des Data Warehouses für das Gesundheitswesen reduziert zudem den manuellen Aufwand bei der Datenerfassung und bei wiederkehrenden Datenqualitätsprüfungen.

Innowise konzipiert das Data Warehouse von Anfang an gemäß den HIPAA-Anforderungen, wobei der Zugriff auf geschützte Gesundheitsdaten (PHI) je nach Rolle eingeschränkt ist und Sicherheitskontrollen in die Datenflüsse integriert sind. Außerdem überprüfen wir die Daten während ihrer Durchlaufzeit durch das Data Warehouse auf fehlerhafte Zuordnungen, doppelte Patientendatensätze oder veränderte Werte, bevor diese sich auf die Berichterstellung auswirken.

Alles anzeigen

Inhaltsübersicht

    Kontakt aufnehmen

    Anruf vereinbaren oder füllen Sie das Formular aus. Wir kontaktieren Sie, sobald wir Ihre Anfrage bearbeitet haben.

    Sprachnachricht senden
    Datei beifügen
    Datei hochladen

    Sie können 1 Datei mit bis zu 2 MB anhängen. Gültige Dateiformate: pdf, jpg, jpeg, png.

    Mit dem Klicken auf Senden erklären Sie sich damit einverstanden, dass Innowise Ihre personenbezogenen Daten gemäß unserer Datenschutzerklärung verarbeitet, um Ihnen relevante Informationen bereitzustellen. Mit Angabe Ihrer Telefonnummer stimmen Sie zu, dass wir Sie per Sprachanruf, SMS oder Messaging-Apps kontaktieren. Es können Gebühren für Anrufe, Nachrichten und Datenübertragung anfallen.

    Sie können uns auch kontaktieren
    bis hin zu contact@innowise.com
    Wie geht es weiter?
    1

    Sobald wir Ihre Anfrage erhalten und geprüft haben, melden wir uns bei Ihnen, klären erste Fragen und unterzeichnen bei Bedarf ein NDA, um die Vertraulichkeit zu gewährleisten.
    2

    Nach genauer Prüfung Ihrer Anforderungen, Bedürfnisse und Erwartungen wird unser Team einen Projektvorschlag mit Angaben zu Arbeitsumfang, Teamgröße, Zeitaufwand und Kosten erstellen.

    3

    Wir vereinbaren einen Termin, um das Angebot gemeinsam zu besprechen und alle Details festzulegen.
    4

    Abschließend unterzeichnen wir den Vertrag und starten umgehend mit der Umsetzung Ihres Projekts.

    Weitere von uns abgedeckte Dienstleistungen

    arrow