Datawarehouse voor de gezondheidszorg: voordelen, architectuur en toepassingsvoorbeelden

21 september 2026 12 min lezen
Aleh Yafimau, Healthcare and MedTech Delivery Manager..
Gezondheidszorg IT-consultant
Gecertificeerde deskundige
Elk artikel op Innowise is geschreven door auteurs met praktijkervaring. Zij hebben niet alleen theoretische kennis van het onderwerp, maar delen ook inzichten uit concrete projecten.
Meer dan 19 jaar ervaring
Gecertificeerde deskundige
Meer dan 19 jaar ervaring
Aleh overbrugt de kloof tussen klinische behoeften en technische uitvoering. Hij past diepgaande domeinkennis toe om ervoor te zorgen dat MedTech-systemen niet alleen voldoen aan de voorschriften, maar ook betrouwbaar genoeg zijn om een meetbare impact te hebben in de echte gezondheidszorg.
Expertise
Gezondheidszorg IT Medtech Algoritmen
Laten we praten

Belangrijkste opmerkingen

  • Wanneer gegevens over patiënten, declaraties, laboratoriumuitslagen, financiën en bedrijfsvoering in verschillende systemen zijn opgeslagen, moet voor het opstellen van rapportages de informatie uit de verschillende bronnen meestal handmatig worden afgestemd. Een hgegevensopslagplaats voor de gezondheidszorg brengt gegevens uit deze systemen samen, zodat teams deze kunnen gebruiken voor rapportage en analyse.
  • Zelfs het best ontworpen magazijn kan een slechte gegevenskwaliteit niet compenseren. Problemen zoals dubbele patiëntendossiers, inconsistente formaten en tegenstrijdige definities kunnen ervoor zorgen dat rapporten onbetrouwbaar zijn.
  • Het magazijnmodel bepaalt in hoeverre gemeenschappelijke gegevens en definities worden gedeeld. Een bedrijfsbreed datawarehouse (DWH) ondersteunt rapportages voor de hele organisatie, terwijl datamarts zijn opgezet rond specifieke afdelingen of gebruiksscenario’s. Hybride architecturen maken gebruik van beide. 
  • De businesscase moet uitgaan van de beslissingen die het magazijn moet ondersteunen, variërend van volksgezondheid en risicobeoordeling van patiënten tot klinisch onderzoek, analyse van verzekeringsclaims of personeels- en capaciteitsplanning.
Artikel samenvatten met AI

Als uw patiëntendossiers, laboratoriumuitslagen, declaraties en operationele gegevens in verschillende systemen zijn opgeslagen, kan het verkrijgen van een betrouwbaar antwoord meer werk kosten dan de analyse zelf. Teams moeten mogelijk gegevens met elkaar in overeenstemming brengen en nagaan wat de cijfers daadwerkelijk betekenen, voordat ze er gebruik van kunnen maken. A gegevensmagazijn voor de gezondheidszorg (DWH) voegt de gegevens uit deze systemen samen en structureert deze voor rapportage en analyse.

In dit artikel leg ik uit hoe een datawarehouse voor de gezondheidszorg wordt opgezet en welke functies in de praktijk van belang zijn. We zullen ook ingaan op de belangrijkste datawarehouse-modellen, veelvoorkomende toepassingen in de gezondheidszorg, zakelijke voordelen, uitdagingen bij de implementatie en de beslissingen die moeten worden genomen voordat het project van start gaat.

Wat is een datawarehouse voor de gezondheidszorg?

De meeste gegevensmagazijn voor de gezondheidszorg is een centrale omgeving waarin gegevens uit verschillende zorgsystemen worden opgeschoond, geharmoniseerd en voorbereid voor rapportage en analyse. Het kan EHR- en EMR-gegevens combineren met declaraties, laboratoriumuitslagen, gegevens uit het patiëntenportaal, ERP- of CRM-records en gegevens van aangesloten apparaten.

Een operationele database ondersteunt doorgaans één applicatie en de dagelijkse werkzaamheden daarvan. Een datawarehouse (DWH) is bedoeld voor vraagstukken waarvoor gegevens uit meerdere systemen tegelijk nodig zijn. Als een ziekenhuis bijvoorbeeld wil achterhalen waarom het aantal heropnames toeneemt, kunnen analisten diagnoses en behandelingsgeschiedenis vergelijken met declaraties, laboratoriumuitslagen en personeelsgegevens, in plaats van elke dataset afzonderlijk op te halen.

In tegenstelling tot een DWH worden gegevens in een data lake doorgaans opgeslagen voordat ze voor een specifiek analytisch doel zijn gestructureerd. Het kan grote hoeveelheden onbewerkte of licht bewerkte gegevens in verschillende formaten bevatten. Een DWH bevat daarentegen bewerkte gegevens die teams kunnen gebruiken voor BI, terugkerende rapportages en doorlopende analyses.

Operationele databaseData warehouseDatameer
HoofddoelDe dagelijkse transacties van de applicatie uitvoerenBreng gegevens uit verschillende systemen samen in een vorm die teams kunnen gebruiken voor rapportages en analysesBewaar grote hoeveelheden verschillende soorten gegevens voor later gebruik
GegevensbronnenGegevens die door operationele applicaties worden aangemaakt en gebruiktGegevens uit EPD’s, declaratiesystemen, ERP-systemen, CRM-systemen en andere bedrijfs- of klinische systemenGegevens uit talrijke bronnen, waaronder gestructureerde, semi-gestructureerde en ongestructureerde gegevens
Hoe gegevens worden opgeslagenAfgestemd op de behoeften van de toepassingOpgeschoond en gestructureerd op basis van rapportage- en analysebehoeftenVaak wordt de oorspronkelijke vorm grotendeels behouden en wordt de structuur aangepast wanneer een gebruiksscenario dat vereist
Typische toepassingen in de gezondheidszorgEHR-transacties, afspraken of CRM-activiteitenSysteemoverschrijdende rapportage, BI en analyses in de gezondheidszorgGrootschalige datasets, verkennende analyses of ML-workloads

Architectuur van een datawarehouse voor de gezondheidszorg

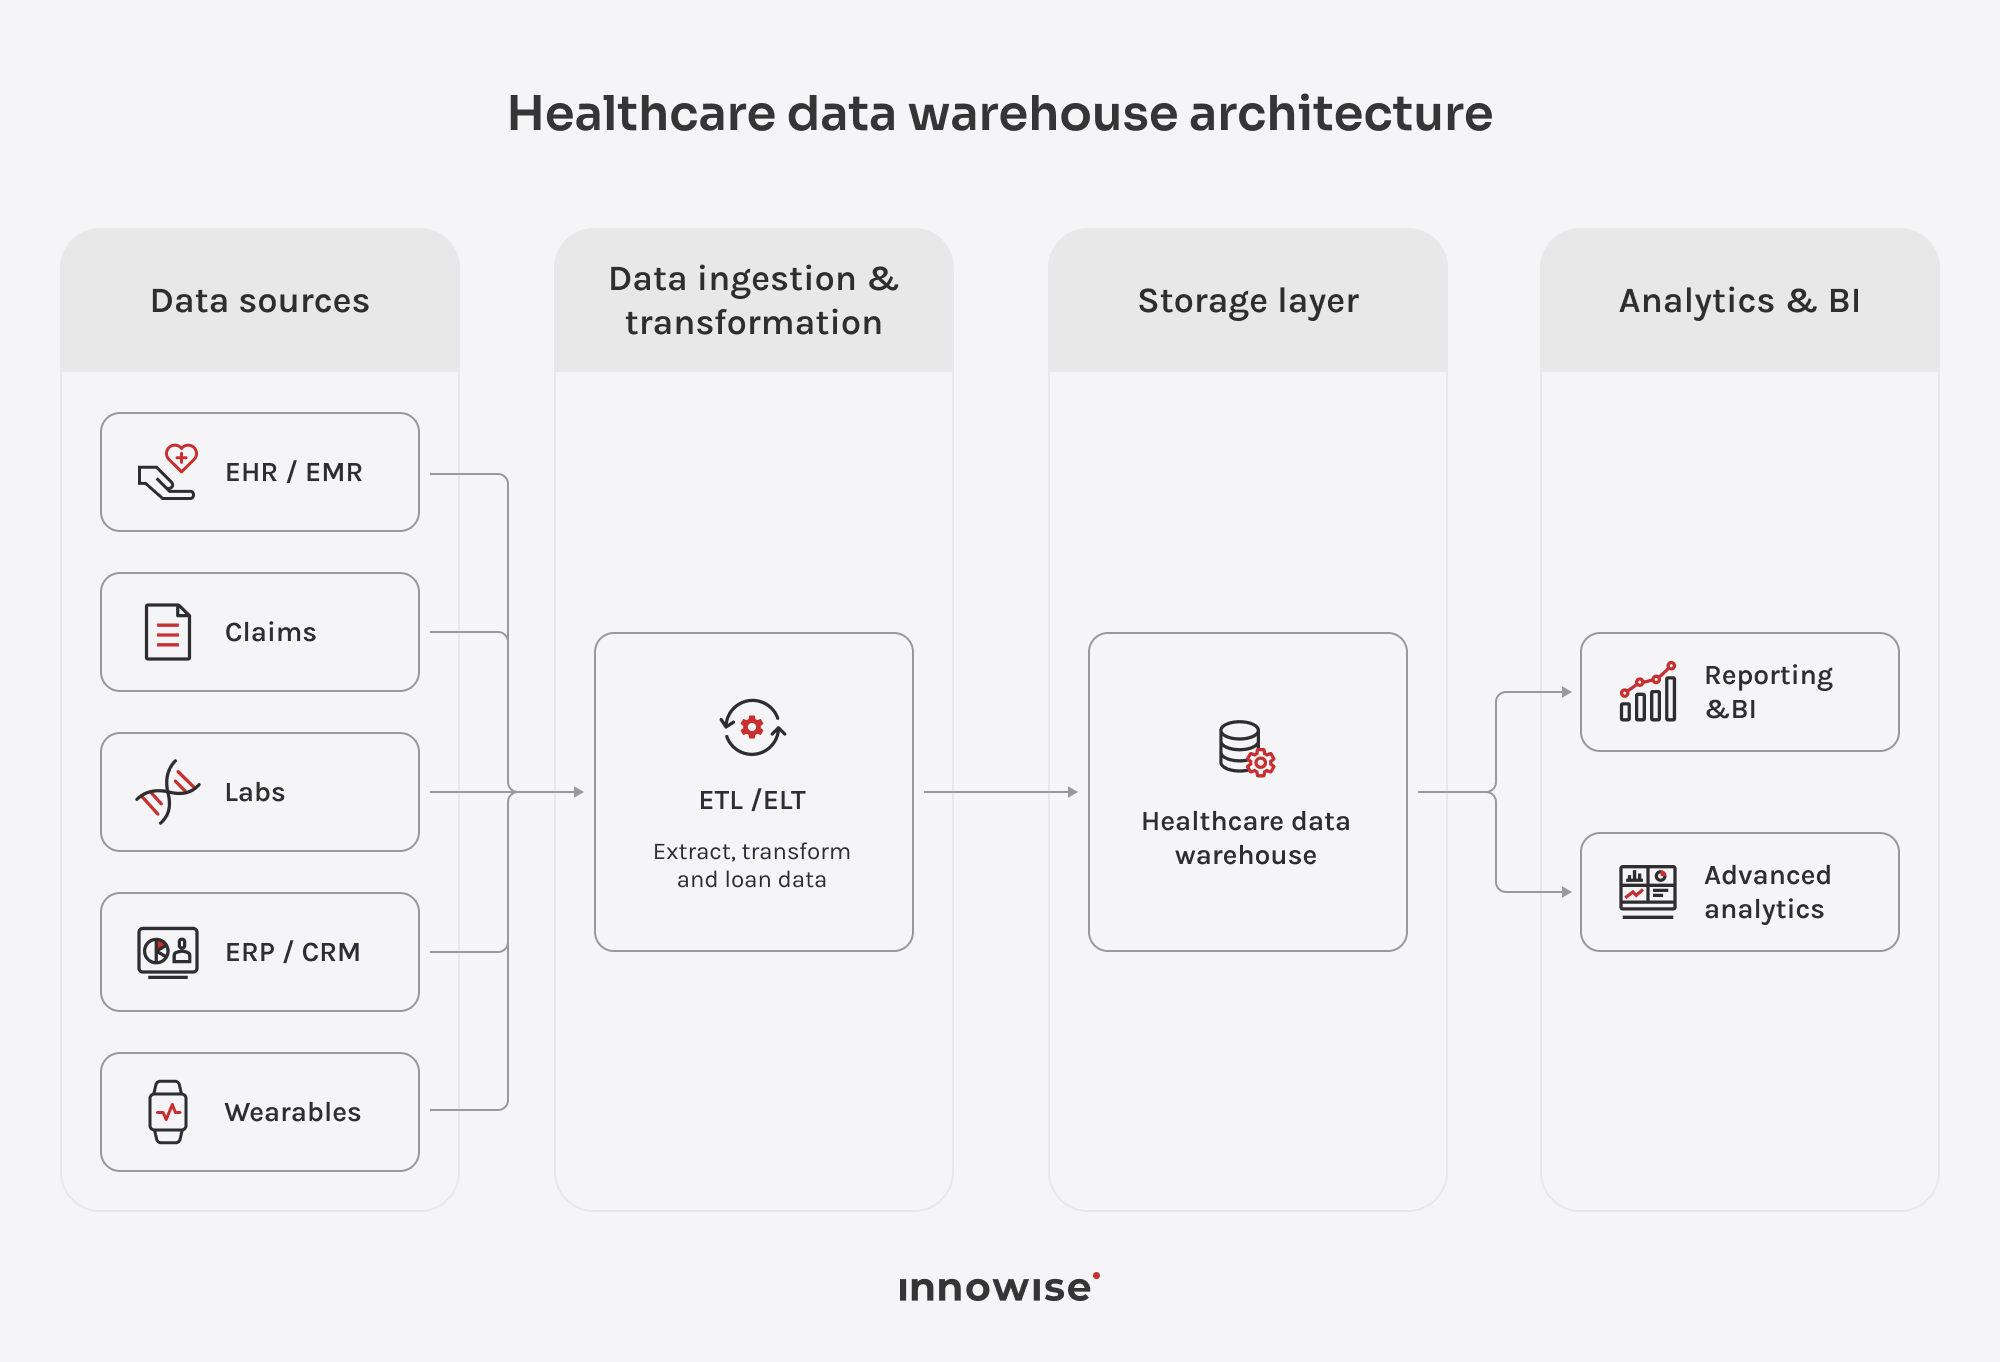
Om beter te begrijpen hoe een datawarehouse voor de gezondheidszorg werkt, gaan we eens kijken naar de belangrijkste lagen die eraan ten grondslag liggen. Elke laag vervult een specifieke rol bij het overbrengen van gegevens vanuit bronsystemen naar de opslag en het vervolgens beschikbaar stellen ervan voor rapportages, analyses en applicaties.

Gegevensbronnen

De bronlaag omvat de systemen die al worden gebruikt voor klinische en zakelijke werkzaamheden, zoals EHR’s en EMR’s, declaratieplatforms, LIS en RIS/PACS, en ERP- of CRM-software. Dezelfde patiënt of gebeurtenis kan in deze systemen op verschillende manieren worden vastgelegd, dus moet u de formaten op elkaar afstemmen en identificatiegegevens aan elkaar koppelen voordat u de gegevens gezamenlijk kunt gebruiken.

Opname en ETL/ELT

Deze laag verzamelt brongegevens en maakt deze klaar voor analyse. Bij ETL worden de gegevens getransformeerd voordat ze in het datawarehouse worden geladen; bij ELT vindt de transformatie plaats na het laden. Het proces kan ook het standaardiseren van formaten, het verwijderen van duplicaten en tijdelijke opslag omvatten.

Opslag

De opslaglaag bewaart historische gegevens in een structuur die is ontworpen voor rapportage en analyse. Afhankelijk van de architectuur kan deze laag ook datamarts aanbieden voor een specifieke afdeling of een specifiek gebruiksscenario.

Analytics en BI

BI-tools maken gebruik van data uit het datawarehouse voor dashboards en periodieke rapporten, terwijl analisten ad-hocquery’s kunnen uitvoeren op dezelfde dataset. Hierdoor beschikken teams over één gezamenlijke bron voor analyses, in plaats van dat ze voor elk rapport opnieuw de logica moeten opbouwen.

Toepassingen

Gegevens uit het datawarehouse kunnen ook worden gebruikt ter ondersteuning van daarop aansluitende klinische of bedrijfsapplicaties. Onderzoekstools of planningssystemen kunnen bijvoorbeeld gebruikmaken van voorbewerkte gegevens uit het datawarehouse, in plaats van afzonderlijk verbinding te maken met elk bronsysteem.

Wilt u één betrouwbaar overzicht van zowel klinische als bedrijfsgegevens?

Belangrijkste kenmerken en mogelijkheden

Nu we het over de architectuur hebben gehad, ga ik in op de functies die je waarschijnlijk in een datawarehouse voor de gezondheidszorg zult aantreffen. Elke organisatie is net even anders, maar er zijn veel gemeenschappelijke behoeften wanneer gegevens uit verschillende systemen moeten worden samengevoegd en bruikbaar moeten blijven voor rapportage en analyse.

Gegevensintegratie en ETL/ELT

Zorgsystemen slaan dezelfde informatie vaak op verschillende manieren op. Een EPD, een declaratieplatform of een laboratoriumsysteem kan voor vergelijkbare records verschillende velden en formaten gebruiken. ETL- en ELT-pijplijnen verzamelen die gegevens en brengen ze in het datawarehouse op één lijn voor analyse. Afhankelijk van hoe vaak de gegevens veranderen, kunnen pijplijnen volgens een schema worden uitgevoerd, alleen nieuwe records laden of updates verwerken zodra deze binnenkomen.

Gegevens in de gezondheidszorg veranderen ook met terugwerkende kracht: laboratoriumresultaten worden gecorrigeerd, consulten worden bijgewerkt of geannuleerd en declaraties worden aangepast of ongeldig verklaard. Pipelines moeten deze wijzigingen toepassen op reeds geladen gegevens; anders komt een herhaling van het rapport van vorige maand mogelijk niet meer overeen met de bron.

Gegevenskwaliteit en ontdubbeling

Dubbele patiëntdossiers en tegenstrijdige waarden kunnen rapporten vertekenen zodra de gegevens in het datawarehouse terechtkomen. Kwaliteitscontroles sporen ontbrekende of ongeldige gegevens op, terwijl koppelingsregels helpen om dossiers die bij dezelfde patiënt horen, systeemoverschrijdend aan elkaar te koppelen. Teams hebben deze opschoning nodig voordat ze resultaten kunnen vergelijken of analyses kunnen uitvoeren.

Beheer van metadata

Metadata geven uitleg over de betekenis van elk veld en de herkomst ervan. Daarnaast worden hierin wijzigingen vastgelegd die zijn aangebracht voordat de gegevens in het datawarehouse terechtkwamen. Analisten kunnen een cijfer in een dashboard terugvoeren naar de bron en nagaan welke definitie is gebruikt.

Datagovernance

Data governance bepaalt wie de eigenaar van de gegevens is en welke definities iedereen moet hanteren. Zonder duidelijke regels kunnen twee afdelingen hetzelfde datawarehouse gebruiken en toch verschillende cijfers rapporteren voor dezelfde maatstaf. Gegevensbezitters en -beheerders beoordelen wijzigingen en zorgen ervoor dat die definities in de loop van de tijd consistent blijven.

Beveiliging en toegangscontrole

Een magazijn in de gezondheidszorg kan naast gevoelige operationele of financiële gegevens ook PHI bevatten, waardoor niet iedereen dezelfde toegangsrechten kan hebben. Met behulp van machtigingen kan worden beperkt wat een gebruiker te zien krijgt, op basis van zijn of haar rol en, indien nodig, tot op het niveau van specifieke rijen of kolommen. Versleuteling beschermt gegevens zowel tijdens opslag als tijdens overdracht, terwijl auditlogboeken laten zien wie er toegang toe heeft gehad.

Ondersteuning voor gestructureerde en semi-gestructureerde gegevens

De meeste terugkerende rapporten maken gebruik van gestructureerde tabellen, maar zorgsystemen genereren ook gegevens in andere formaten. API’s en aangesloten apparaten kunnen bijvoorbeeld JSON versturen. Een datawarehouse kan met deze gegevens werken zonder dat elk veld eerst naar een vaste tabel hoeft te worden geconverteerd. Ongestructureerde bestanden, zoals medische beelden, blijven doorgaans in een data lake of objectopslag opgeslagen en worden indien nodig gekoppeld aan de gegevens in het datawarehouse.

Schaalbaarheid en prestaties

Naarmate de hoeveelheid opgeslagen gegevens en het aantal zoekopdrachten toeneemt, moet het datawarehouse ervoor zorgen dat de rapportage snel blijft reageren. Platforms kunnen gebruikmaken van partitionering, indexering, caching of afzonderlijke rekenbronnen om grotere werklasten te verwerken zonder dat de architectuur van het datawarehouse opnieuw hoeft te worden opgebouwd.

Interoperabiliteit

Een datawarehouse voor de gezondheidszorg moet gegevens uitwisselen met EPD’s, laboratoriumsystemen en andere klinische platforms. HL7-standaarden zoals FHIR en HL7 v2 bieden teams gemeenschappelijke formaten voor die uitwisseling, waardoor er minder maatwerk nodig is bij het koppelen van gegevens. Voor verouderde of propriëtaire systemen zijn mogelijk nog steeds aangepaste koppelingen nodig voordat het datawarehouse hun gegevens kan gebruiken.

Bij projecten in de gezondheidszorg zou ik de resultaten of kosten niet afzonderlijk bekijken. Met een datawarehouse kun je zaken als verblijfsduur en heropnames vergelijken met het gebruik van middelen en de tijd die het personeel eraan besteedt. Dat is van belang bij waardegedreven zorg, waarbij je zowel het resultaat moet begrijpen als wat er nodig was om dat te bereiken.
Philip Tikhanovich, Head of Big Data.
Philip Tikhanovich
Hoofd Big Data

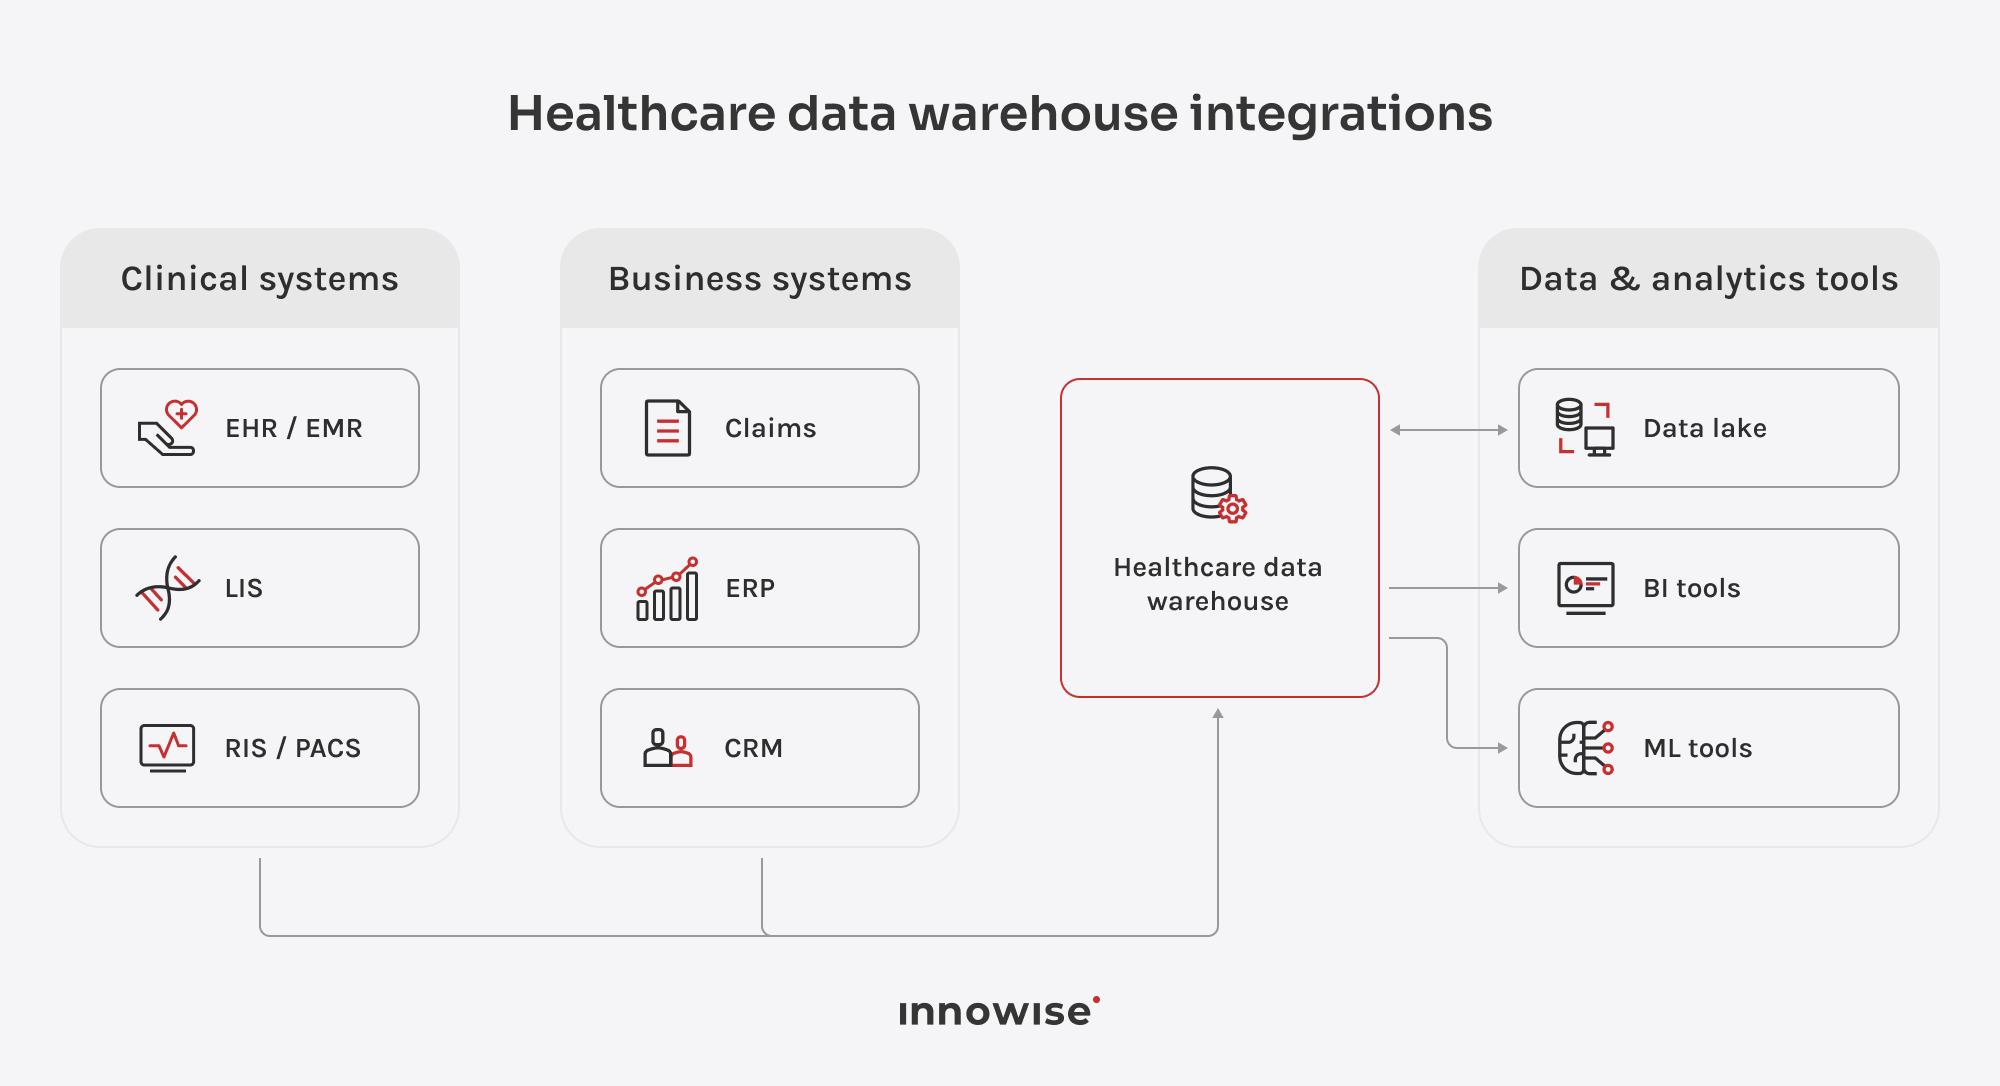
Integraties van datawarehouses in de gezondheidszorg

Als je een klinisch datawarehouse in de gezondheidszorg opzet, sluit je doorgaans de systemen aan die je teams al dagelijks gebruiken. De meest voorkomende integraties halen gegevens uit klinische en bedrijfssystemen binnen en stellen deze beschikbaar voor BI- en ML-tools.

Klinische systemen

EHR- en EMR-systemen verzenden doorgaans gestructureerde klinische gegevens via FHIR-API’s of HL7 v2-feeds. FHIR leent zich goed voor entiteiten zoals ‘Patiënt’ en ‘Bezoek’, terwijl HL7 v2 nog steeds veel wordt gebruikt voor ziekenhuisgebeurtenissen en laboratoriumuitslagen. LIS-systemen maken vaak gebruik van HL7 v2 ORU-berichten om testresultaten naar het datawarehouse te verzenden.

Radiologie werkt anders, omdat beeldgegevens doorgaans buiten het datawarehouse zelf worden bewaard. De beelden worden opgeslagen in een PACS-systeem of objectopslag, terwijl het datawarehouse de rapporten en de metagegevens van de onderzoeken opslaat, met koppelingen naar het bijbehorende DICOM-bestand.

Bedrijfssystemen

Claimsystemen geven weer wat zorgverleners in rekening hebben gebracht en wat zorgverzekeraars hebben vergoed. In de VS worden gegevens vaak uitgewisseld via X12-transacties, waaronder 837-claims en 835-betalingsbestanden. Door zowel gegevens op claimniveau als op regelniveau bij te houden, kunnen analisten de totale kosten vergelijken met de afzonderlijke diensten die daaraan ten grondslag liggen.

ERP-systemen leveren gegevens over kosten en personeelsbezetting, terwijl CRM-systemen informatie vastleggen over het contact met patiënten buiten het medisch dossier om. Wanneer teams die informatie combineren met klinische gegevens, kunnen ze onderzoeken of bijvoorbeeld afspraakherinneringen de opkomst verbeteren of dat de personeelsbezetting aansluit bij de klinische activiteiten.

Gegevens en analyses

Een data lake slaat ruwe of minder gestructureerde gegevens op voordat teams deze voorbereiden voor het datawarehouse. Geselecteerde datasets kunnen in het data lake worden opgeschoond en vervolgens in het datawarehouse worden geladen. In sommige opstellingen haalt het datawarehouse de gegevens rechtstreeks uit het data lake, in plaats van deze eerst te kopiëren.

BI-tools zoals Power BI of Tableau maken via native connectoren of ODBC/JDBC verbinding met het datawarehouse en lezen daar voorbereide gegevens in. ML-platforms gebruiken historische gegevens uit het datawarehouse voor training of scoring, en sturen vervolgens de resultaten van de modellen, zoals risicoscores, terug naar het datawarehouse voor rapportages of andere toepassingen.

Zakelijke voordelen

Als je de businesscase voor een datawarehouse in de gezondheidszorg aan het afwegen bent, zou ik kijken naar wat dit betekent voor de teams die de gegevens gebruiken. De hieronder genoemde voordelen van een bedrijfsbreed datawarehouse in de gezondheidszorg zijn de gebieden waarop die impact doorgaans het duidelijkst zichtbaar is.

Sneller rapporteren

In plaats van cijfers uit verschillende systemen te halen en deze handmatig op elkaar af te stemmen, kunnen teams werken met gegevens die al in het datawarehouse zijn verwerkt. Het opstellen van terugkerende rapporten kost minder moeite, en analisten kunnen meer tijd besteden aan het analyseren van de cijfers in plaats van aan het verzamelen ervan.

Geconsolideerd patiëntenoverzicht

Klinische gegevens, declaratiegegevens en andere patiëntgerelateerde gegevens kunnen tussen verschillende bronsystemen worden gekoppeld, zodat teams een breder beeld krijgen van de geschiedenis van een patiënt. Daardoor wordt het eenvoudiger om de zorg over verschillende consulten heen te volgen, zonder tussen afzonderlijke dossiers te hoeven schakelen.

Betere klinische beslissingen

Klinische medewerkers en analisten kunnen gebruikmaken van historische gegevens uit de hele organisatie bij het beantwoorden van vragen waarvoor informatie uit meer dan één systeem nodig is. Die bredere context ondersteunt beslissingen over behandelpatronen, patiëntenrisico’s en de kwaliteit van de zorg.

Kosten- en middelenoptimalisatie

Door klinische activiteiten te koppelen aan financiële of operationele gegevens krijgen ziekenhuizen inzicht in waar hun middelen naartoe gaan. Teams kunnen het aantal behandelingen vergelijken met de personeelsbezetting of de kosten, en de resultaten gebruiken bij het plannen van de capaciteit.

Betere analyse van schadeclaims

Zodra de declaraties en klinische gegevens in hetzelfde datawarehouse zijn opgeslagen, kunnen analisten de gefactureerde diensten vergelijken met de zorg die door zorgverleners is gedocumenteerd. Ze kunnen onderzoeken waarom verzekeraars declaraties hebben afgewezen of te weinig hebben uitbetaald, en terugkerende factureringsproblemen opsporen.

Voorspellende analyses

Omdat het datawarehouse historische gegevens op één plek bewaart, kunnen teams deze gebruiken om in te schatten wat er waarschijnlijk gaat gebeuren. Een model kan bijvoorbeeld patiënten met een hoger risico op heropname signaleren of periodes van grotere vraag voorspellen. Zorg- en operationele teams kunnen dan eerder vervolgzorg of personeelsbezetting plannen.

Onderzoeksondersteuning

Onderzoekers hebben vaak gegevens nodig van een groot aantal patiënten over een lange periode. Een datawarehouse biedt hen gegevens die direct geschikt zijn voor cohortanalyses of retrospectieve studies, zonder dat ze de dataset telkens opnieuw hoeven samen te stellen uit afzonderlijke systemen.

Analyse van op waarde gebaseerde zorg

Bij waardegedreven zorg moeten teams weten of de middelen die ze inzetten daadwerkelijk tot betere resultaten leiden. Wanneer het datawarehouse de resultaten koppelt aan gegevens over het gebruik van middelen, kunnen analisten patiëntengroepen met elkaar vergelijken en nagaan of hogere uitgaven of intensiever gebruik van zorgdiensten tot betere zorgresultaten leiden.

Veelvoorkomende uitdagingen bij datawarehouses in de gezondheidszorg

De voordelen die ik hierboven heb besproken, brengen weliswaar enkele uitdagingen bij de implementatie met zich mee, maar die zijn veel gemakkelijker op te lossen als je er vroeg rekening mee houdt. Een ervaren team kan veel van de risico’s opmerken voordat ze uitmonden in extra werk of rapportageproblemen. Dit zijn de punten waar ik vanaf het begin op zou letten.

Versnipperde gegevens en interoperabiliteit

Het ene systeem identificeert een patiënt misschien aan de hand van een dossiernummer, terwijl een ander systeem een andere identificatiecode gebruikt. Ook de gegevensformaten kunnen verschillen. Teams moeten die verschillen correct in kaart brengen en de koppelingen bijwerken telkens wanneer er een wijziging plaatsvindt in een bronsysteem.

Slechte gegevenskwaliteit

Een datawarehouse neemt problemen over van de systemen die er gegevens in invoeren. Ontbrekende waarden of inconsistente codes kunnen leiden tot onbetrouwbare rapporten en hebben gevolgen voor latere analyses. Teams moeten deze problemen opsporen voordat andere rapporten of modellen op dezelfde gegevens gaan vertrouwen.

Dubbele patiëntendossiers

Dezelfde patiënt kan meerdere keren voorkomen wanneer systemen verschillende identificatiecodes gebruiken of licht afwijkende persoonlijke gegevens bevatten. De vergelijkingsregels moeten deze dubbele vermeldingen opsporen zonder per ongeluk gegevens van verschillende personen met elkaar te combineren.

Veiligheid en privacy

Een zorgdatabank kan zowel patiëntendossiers als financiële en operationele gegevens bevatten, maar niet elke gebruiker hoeft alles te kunnen inzien. Zorgverleners hebben wellicht details op patiëntniveau nodig, terwijl financiële teams mogelijk alleen factuurgegevens nodig hebben. Stel de toegang in op basis van rol en controleer de machtigingen telkens wanneer u een nieuwe gegevensbron toevoegt.

Bestuur

Teams hebben duidelijke regels nodig over wie eigenaar is van gedeelde gegevens en wie daarover beslissingen neemt. Als twee afdelingen bijvoorbeeld dezelfde statistiek op verschillende manieren berekenen, moet iemand bepalen welke definitie iedereen gaat gebruiken. Hetzelfde geldt voor het verlenen van toegang tot gevoelige gegevens.

Het opschalen van gegevensvolumes

Naarmate het datawarehouse meer gegevens uit eerdere jaren verzamelt en nieuwe bronnen toevoegt, kunnen zoekopdrachten trager worden en kunnen de opslagkosten stijgen. Teams moeten plannen hoe ze oudere gegevens ordenen en hoe lang ze deze bewaren, zodat de groei de dagelijkse rapportage niet bemoeilijkt.

Gebrek aan interne expertise op het gebied van data-engineering

Uw team kent de gezondheidszorgsystemen wellicht goed, maar heeft wellicht weinig ervaring met het opzetten van een datawarehouse rondom deze systemen. In dat geval kunnen externe data-engineers helpen bij het ontwerpen van de pijplijnen en het datamodel, terwijl uw interne team bepaalt waarvoor de gegevens moeten dienen.

Modellen voor datawarehouses in de gezondheidszorg

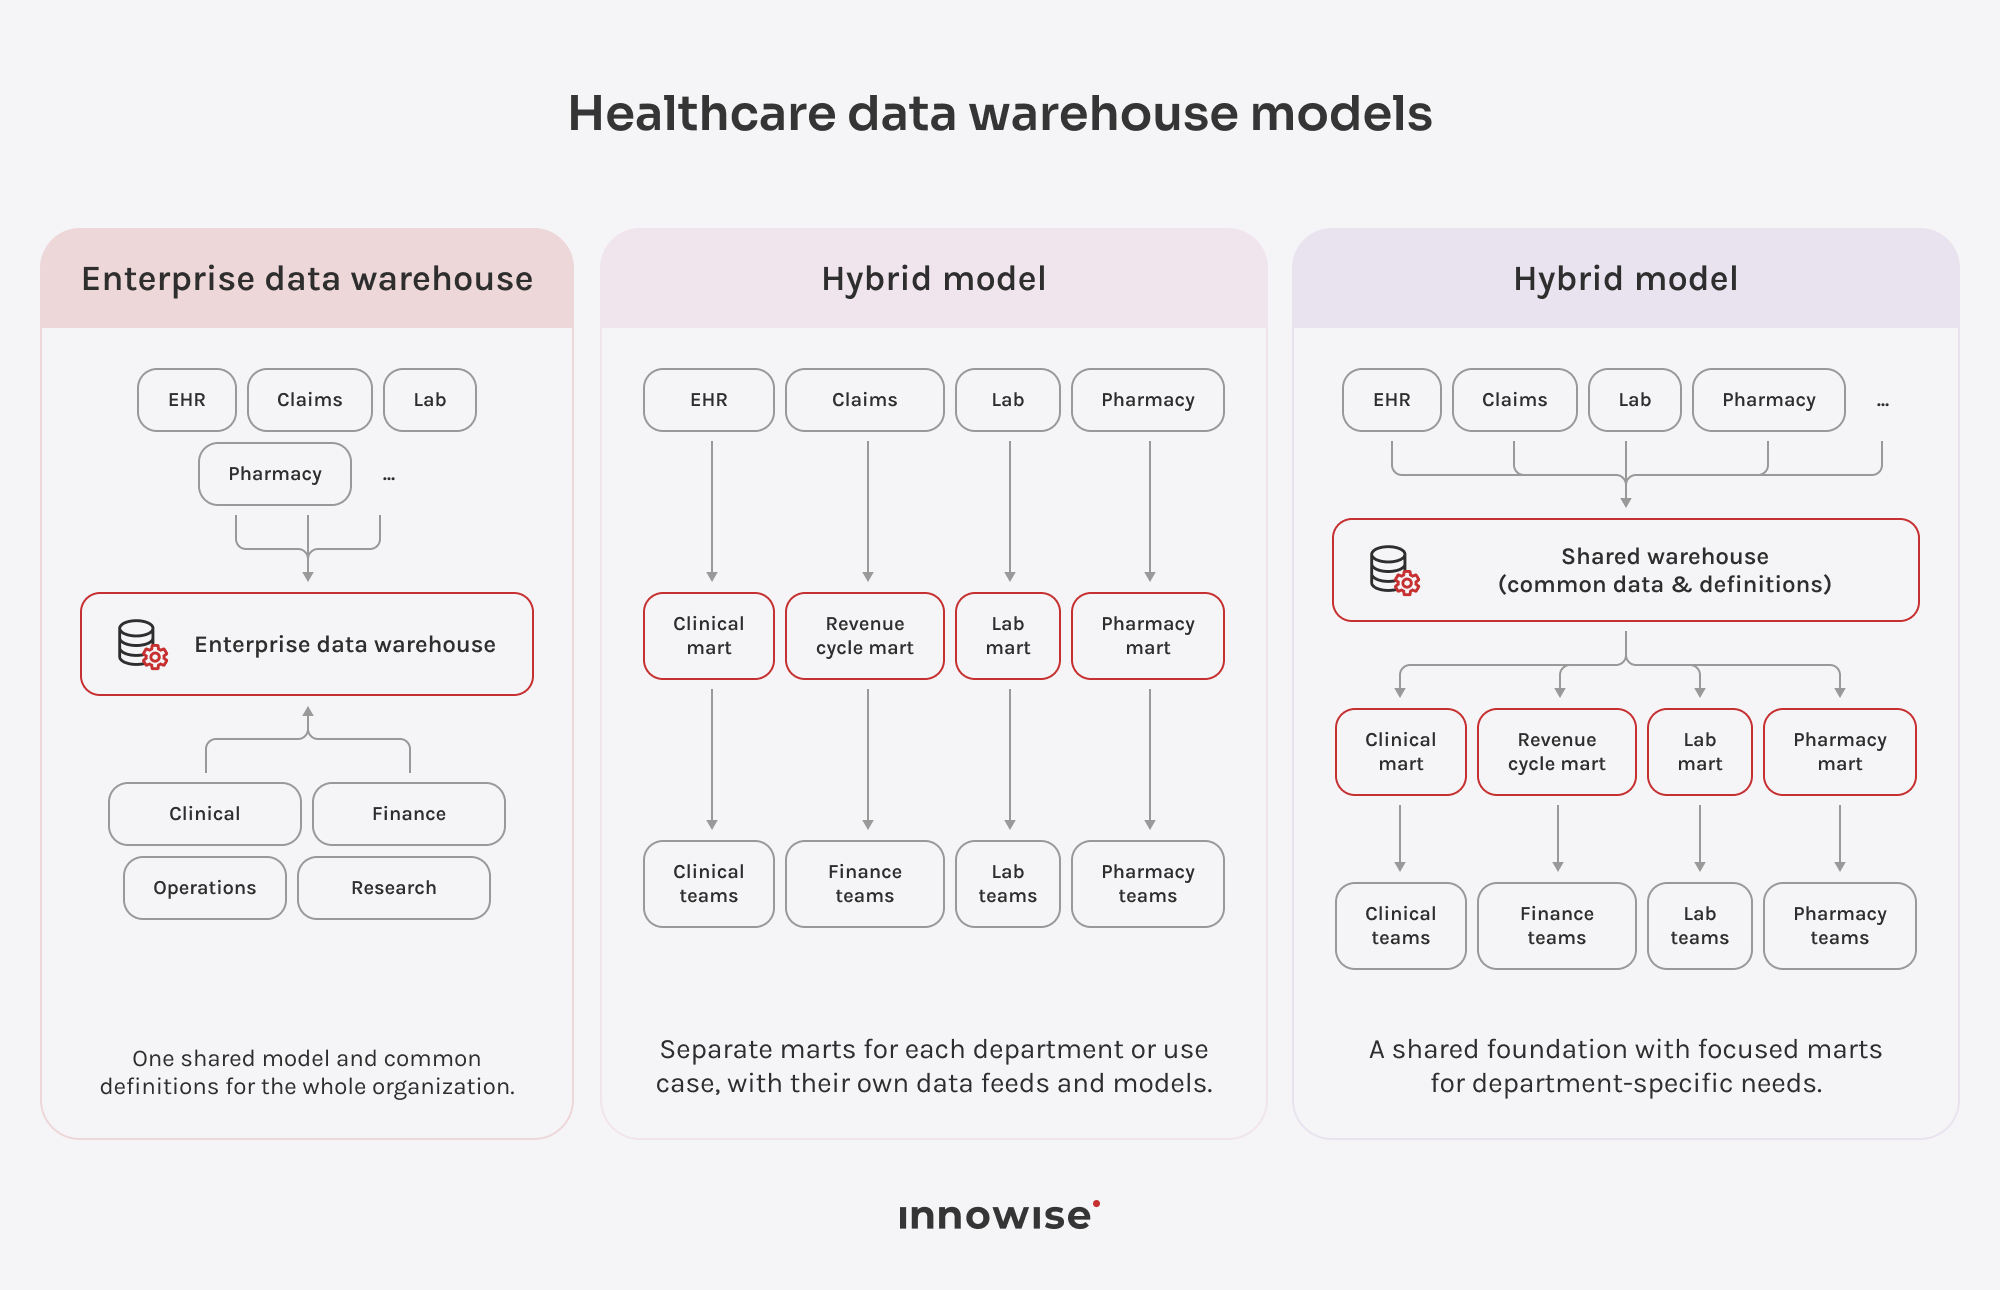
Welk model voor een datawarehouse in de gezondheidszorg het meest geschikt is, hangt af van de mate waarin u het gegevensbeheer wilt centraliseren en van de mate van autonomie die afzonderlijke afdelingen nodig hebben. In de praktijk kiezen organisaties meestal uit drie modellen:

Bedrijfsdatamagazijn

Een enterprise datawarehouse in de gezondheidszorg maakt gebruik van een organisatiebreed gedeeld datamodel, zodat verschillende afdelingen met consistente definities en rapportageregels werken. Zo kunnen bijvoorbeeld klinische en financiële teams de gemiddelde verblijfsduur op dezelfde manier berekenen, in plaats van deze maatstaf afzonderlijk in hun eigen rapporten te definiëren.

Op dataniveau kunnen teams kernentiteiten zoals patiënten, consulten, zorgverleners en instellingen standaardiseren en records uit bronsystemen aan die gedeelde structuren koppelen. Het nadeel is dat ze het in een vroeg stadium eens moeten worden over die definities en deze op elkaar moeten blijven afstemmen naarmate het datawarehouse groeit. Dat vergt in het begin meer werk, vooral in een grote organisatie waar terminologie en rapportagebehoeften voortdurend veranderen. Zodra veel rapporten afhankelijk zijn van het gedeelde model, kan zelfs een kleine wijziging in een kerndefinitie gevolgen hebben voor meerdere teams tegelijk.

Onafhankelijke datamarts

Een onafhankelijke datamart richt zich op één afdeling of één analytisch gebruiksscenario, in plaats van gegevens voor de hele organisatie te modelleren. Een oncologieteam zou bijvoorbeeld een datamart kunnen opzetten rond de klinische systemen die het nodig heeft, terwijl analisten op het gebied van de inkomstencyclus een andere datamart kunnen creëren die gericht is op claim- en factureringsgegevens.

Omdat elke mart een beperktere reikwijdte heeft, kunnen teams de eerste rapporten vaak sneller in gebruik nemen. Naarmate er meer marts worden toegevoegd, kan het zijn dat voor hetzelfde bronsysteem voor elke mart afzonderlijke pijplijnen en toewijzingen nodig zijn. Definities kunnen ook per afdeling verschillen. En omdat marts vaak gegevens opslaan die al zijn bewerkt of samengevat voor een specifieke toepassing, ontbreken er mogelijk details die later nodig zijn voor een andere analyse.

Hybride model

Een hybride model combineert een gedeeld bedrijfsdatawarehouse met datamarts die zijn opgezet voor specifieke afdelingen of analytische behoeften. De kerngegevens en gedeelde definities blijven in de centrale laag, terwijl elke mart die gegevens aanpast aan zijn eigen rapportagebehoeften. Omdat de marts hun gegevens uit het datawarehouse halen, hoeven teams geen afzonderlijke integratie met elk bronsysteem te bouwen.

Dankzij deze opzet kunnen organisaties nieuwe marts toevoegen naarmate de rapportagebehoeften veranderen, zonder dat ze vanaf het begin elke toekomstige gebruikssituatie hoeven te modelleren. Het lastigste is om te bepalen wat centraal moet worden gestandaardiseerd en wat specifiek voor één mart kan blijven. Als er te veel logica in afzonderlijke marts terechtkomt, kunnen definities in de loop van de tijd afwijken.

Bent u van plan een DWH voor de gezondheidszorg op te zetten en weegt u de verschillende opties af?

Toepassingsvoorbeelden van DWH in de gezondheidszorg

Zorginstellingen gebruiken datawarehouses voor zeer uiteenlopende taken, afhankelijk van de gegevens die ze verzamelen en de beslissingen die ze moeten nemen. De onderstaande voorbeelden van datawarehouses in de gezondheidszorg laten zien hoe dit in de praktijk uitpakt bij klinische en operationele werkzaamheden.

Population Health Management

Teams voor volksgezondheid gebruiken gegevens uit het gegevensmagazijn om groepen patiënten met vergelijkbare zorgbehoeften te identificeren. Zo kunnen ze bijvoorbeeld mensen opsporen bij wie de screening of follow-up al te lang uitgesteld is, en die lijsten doorgeven aan outreach-teams.

Beheer van chronische ziekten

Bij chronische aandoeningen moeten zorgteams kunnen zien wat er tussen de afspraken door verandert. Een gegevensopslagplaats kan laboratoriumuitslagen en medicatiegeschiedenis van verschillende bezoeken samenvoegen, aangevuld met meetgegevens van gekoppelde apparaten indien beschikbaar. Aan de hand van deze gecombineerde geschiedenis kunnen teams veranderingen in de toestand van een patiënt opmerken en bepalen wanneer een eerdere vervolgafspraak nodig kan zijn.

Voorspellende risicoanalyses voor patiënten

Teams gebruiken historische gegevens uit het datawarehouse om in te schatten welke patiënten een hoger risico lopen op heropname of het niet nakomen van een afspraak. Die scores worden doorgaans via een zorgbeheer- of outreach-systeem aan zorgverleners doorgegeven. Het terugschrijven van deze scores in het EPD zelf is meestal een aparte integratie: EPD-leveranciers houden doorgaans strikte controle over de schrijftoegang.

Klinisch onderzoek en proeven

Het vinden van geschikte deelnemers aan een onderzoek begint vaak met een lange lijst van inclusie- en exclusiecriteria. Onderzoekers kunnen die criteria eerst toetsen aan geanonimiseerde gegevens uit het gegevensmagazijn en zo de groep verkleinen voordat ze individuele dossiers gaan bekijken. Bij onderzoek dat op meerdere locaties plaatsvindt, kunnen teams bovendien de dossiers van verschillende instellingen vóór de analyse in een gemeenschappelijke structuur onderbrengen.

Analyse van de inkomstencyclus en schadeclaims

Er kunnen op elk moment tussen de oorspronkelijke afschrijving en de uiteindelijke terugbetaling betalingsproblemen optreden. Door klinische, facturerings- en declaratiegegevens aan elkaar te koppelen, kunnen inkomstenafdelingen zien waar een declaratie is vastgelopen en of dezelfde afwijzingsreden zich bij een bepaalde betaler of behandeling steeds weer voordoet.

Personeelsbezetting en capaciteitsplanning

Leidinggevenden vergelijken het aantal patiënten per afdeling en per dienst met het personeel dat voor diezelfde tijd is ingeroosterd. Als er op bepaalde dagen of tijdens piekperiodes herhaaldelijk te weinig personeel is op een bepaalde afdeling, kunnen ze toekomstige dienstroosters aanpassen om rekening te houden met dat patroon.

Optimalisatie van de operationele kosten

Wanneer financiële gegevens worden gekoppeld aan klinische activiteiten, kunnen teams zien waar de operationele kosten daadwerkelijk vandaan komen. Ze kunnen de uitgaven per ingreep, vestiging of soort zorg vergelijken en onderzoeken waarom de kosten op sommige gebieden hoger zijn dan op andere.

Implementatieproces

Elk project voor een datawarehouse in de gezondheidszorg begint anders. De stappen hangen af van uw huidige systemen, de kwaliteit van uw gegevens en wat u met het datawarehouse wilt bereiken. Hieronder leest u hoe wij dit doorgaans aanpakken.

01
Ontdekking

Ons team stelt de eerste rapportage- of analytische use cases voor de eerste release vast en brengt in kaart voor welke gebruikers deze bedoeld zijn. Daarnaast gaan we na welke bronsystemen binnen het toepassingsgebied vallen en brengen we regelgevende beperkingen in kaart voordat we architectuurbeslissingen nemen.

02
Beoordeling van gegevens

Voordat we pijplijnen opzetten, controleren we elke bron op ontbrekende gegevens en inconsistente formaten, en zoeken we vervolgens naar duplicaten. Uit de bevindingen blijkt wat ongewijzigd kan blijven en waar we opschoningsregels nodig hebben, voordat deze problemen de rapportage in de productie beïnvloeden.

03
Architectuur

Onze data-architecten kiezen het datawarehouse-model op basis van de mate waarin teams gegevens en definities moeten delen. Vervolgens ontwerpen ze de invoer- en opslaglagen, afgestemd op de systemen van de organisatie, en bepalen ze hoe analysetools toegang krijgen tot het datawarehouse.

04
Technologie selecteren

Nadat de architectuur is vastgesteld, kiest het team het platform, de ETL/ELT-aanpak en de BI- of ML-tools op basis van het gegevensvolume en de bestaande techstack. Budgettaire en compliance-overwegingen zorgen ervoor dat de lijst wordt ingeperkt, vooral wanneer toegangscontroles of auditlogging vereist zijn.

05
Integratie

Data-engineers koppelen het datawarehouse aan de bronsystemen. Afhankelijk van de omgeving kunnen ze FHIR of HL7 v2 gebruiken voor klinische gegevens, X12 voor Amerikaanse declaraties en API’s of native connectoren voor bedrijfsapplicaties. Door elke feed te testen met echte gegevens kunnen mappingfouten in een vroeg stadium worden opgespoord.

06
Ontwikkeling

Innowise-ontwikkelaars bouwen pijplijnen die formaten standaardiseren en dubbele records verwijderen, voordat de overeengekomen bedrijfsdefinities worden toegepast. Als het ontwerp datamarts omvat, bouwen ze deze op de gedeelde laag in plaats van opnieuw verbinding te maken met elke bron.

07
Migratie en testen

Het team laadt historische gegevens in en vergelijkt deze met de oorspronkelijke bronnen om ontbrekende of gewijzigde waarden op te sporen. Vervolgens toetsen analisten de rapporten aan de hand van de use cases die tijdens de verkenningsfase zijn gedefinieerd, waarna zakelijke gebruikers de resultaten beoordelen voordat het systeem in gebruik wordt genomen.

08
Lancering

Bij de lancering voert ons team vaak zowel oude als nieuwe rapporten tegelijkertijd uit, zodat gebruikers de cijfers kunnen vergelijken voordat ze overschakelen. We houden ook het vroege gebruik in de productie nauwlettend in de gaten, omdat hier vaak problemen met gegevens of prestaties aan het licht komen die tijdens het testen over het hoofd zijn gezien.

09
Ondersteuning

Na de livegang houden we de prestaties in de gaten, voegen we nieuwe bronnen toe en zorgen we ervoor dat de governanceprocessen die de consistentie van de gedeelde definities waarborgen, goed worden onderhouden. Meestal is dit een van de langste projectfasen en een van de fasen die tijdens de planning het gemakkelijkst worden onderschat.

arrow-icon. arrow-icon.
01 Ontdekking

Ons team stelt de eerste rapportage- of analytische use cases voor de eerste release vast en brengt in kaart voor welke gebruikers deze bedoeld zijn. Daarnaast gaan we na welke bronsystemen binnen het toepassingsgebied vallen en brengen we regelgevende beperkingen in kaart voordat we architectuurbeslissingen nemen.

arrow-icon. arrow-icon.
02 Beoordeling van gegevens

Voordat we pijplijnen opzetten, controleren we elke bron op ontbrekende gegevens en inconsistente formaten, en zoeken we vervolgens naar duplicaten. Uit de bevindingen blijkt wat ongewijzigd kan blijven en waar we opschoningsregels nodig hebben, voordat deze problemen de rapportage in de productie beïnvloeden.

arrow-icon. arrow-icon.
03 Architectuur

Onze data-architecten kiezen het datawarehouse-model op basis van de mate waarin teams gegevens en definities moeten delen. Vervolgens ontwerpen ze de invoer- en opslaglagen, afgestemd op de systemen van de organisatie, en bepalen ze hoe analysetools toegang krijgen tot het datawarehouse.

arrow-icon. arrow-icon.
04 Technologie selecteren

Nadat de architectuur is vastgesteld, kiest het team het platform, de ETL/ELT-aanpak en de BI- of ML-tools op basis van het gegevensvolume en de bestaande techstack. Budgettaire en compliance-overwegingen zorgen ervoor dat de lijst wordt ingeperkt, vooral wanneer toegangscontroles of auditlogging vereist zijn.

arrow-icon. arrow-icon.
05 Integratie

Data-engineers koppelen het datawarehouse aan de bronsystemen. Afhankelijk van de omgeving kunnen ze FHIR of HL7 v2 gebruiken voor klinische gegevens, X12 voor Amerikaanse declaraties en API’s of native connectoren voor bedrijfsapplicaties. Door elke feed te testen met echte gegevens kunnen mappingfouten in een vroeg stadium worden opgespoord.

arrow-icon. arrow-icon.
06 Ontwikkeling

Innowise-ontwikkelaars bouwen pijplijnen die formaten standaardiseren en dubbele records verwijderen, voordat de overeengekomen bedrijfsdefinities worden toegepast. Als het ontwerp datamarts omvat, bouwen ze deze op de gedeelde laag in plaats van opnieuw verbinding te maken met elke bron.

arrow-icon. arrow-icon.
07 Migratie en testen

Het team laadt historische gegevens in en vergelijkt deze met de oorspronkelijke bronnen om ontbrekende of gewijzigde waarden op te sporen. Vervolgens toetsen analisten de rapporten aan de hand van de use cases die tijdens de verkenningsfase zijn gedefinieerd, waarna zakelijke gebruikers de resultaten beoordelen voordat het systeem in gebruik wordt genomen.

arrow-icon. arrow-icon.
08 Lancering

Bij de lancering voert ons team vaak zowel oude als nieuwe rapporten tegelijkertijd uit, zodat gebruikers de cijfers kunnen vergelijken voordat ze overschakelen. We houden ook het vroege gebruik in de productie nauwlettend in de gaten, omdat hier vaak problemen met gegevens of prestaties aan het licht komen die tijdens het testen over het hoofd zijn gezien.

arrow-icon. arrow-icon.
09 Ondersteuning

Na de livegang houden we de prestaties in de gaten, voegen we nieuwe bronnen toe en zorgen we ervoor dat de governanceprocessen die de consistentie van de gedeelde definities waarborgen, goed worden onderhouden. Meestal is dit een van de langste projectfasen en een van de fasen die tijdens de planning het gemakkelijkst worden onderschat.

Diensten op het gebied van datawarehouses voor de gezondheidszorg

Als u een DWH voor de gezondheidszorg helemaal vanaf nul opbouwt, heeft u andere ondersteuning nodig dan wanneer u een bestaand systeem aanpast of uitbreidt. Innowise kan in beide fasen instappen en de werkzaamheden uitvoeren die uw opzet vereist.

  • Advies op het gebied van datawarehouses voor de gezondheidszorg
  • Architectuur en ontwerp
  • Ontwikkeling van een datawarehouse
  • Data-integratie en -migratie
  • Modernisering van het verouderde datawarehouse
  • Integratie van BI en analytics
  • Ondersteuning en optimalisatie

Advies op het gebied van datawarehouses voor de gezondheidszorg

Als u al problemen hebt met de rapportage of een bestaand magazijn hebt dat niet meer aan de eisen voldoet, brengen we in kaart wat er moet veranderen. Ons team bekijkt de huidige opzet en vergelijkt de beschikbare opties. Op basis daarvan helpen we u te bepalen welke toepassingen prioriteit moeten krijgen.

Nurse reviews lab results and medication history in EHR system before patient rounds.

Architectuur en ontwerp

Zodra de vereisten zijn vastgesteld, ontwerpen onze architecten een magazijnstructuur die is afgestemd op uw systemen en de verwachte werklast. Zij bepalen hoe de belangrijkste componenten met elkaar worden verbonden en waar de gedeelde gegevens worden opgeslagen. De structuur kan vervolgens worden aangepast aan nieuwe bronnen of rapportagebehoeften zodra deze zich voordoen.

Building layouts and style guides for a new web application project.

Ontwikkeling van een datawarehouse

Zodra het ontwerp is goedgekeurd, bouwen onze ingenieurs het datawarehouse, inclusief de transformatielogica en eventuele benodigde datamarts. Tijdens de ontwikkeling voegen ze kwaliteitscontroles en beveiligingsmaatregelen toe, zodat het datawarehouse de rapportages en analyses kan ondersteunen die het project vereist.

IT specialist analyzing software code during an evening sprint session.

Data-integratie en -migratie

We koppelen het datawarehouse aan EHR/EMR, declaratiesystemen, laboratoriumsystemen, ERP/CRM en andere bronsystemen. Historische gegevens worden vervolgens met de vereiste toewijzingen en transformaties naar het doelmodel overgebracht. Vóór de overgang worden de gemigreerde gegevens aan de hand van afstemmingscontroles vergeleken met de brongegevens.

Data engineer interacts with a visual dashboard to orchestrate real-time data synchronization across systems.

Modernisering van het verouderde datawarehouse

Naarmate gegevensbronnen en rapportagebehoeften veranderen, kan het zijn dat een bestaand datawarehouse meer nodig heeft dan alleen routineonderhoud. We werken verouderde gegevensmodellen en pijplijnen bij, verplaatsen workloads wanneer het huidige platform een beperking vormt, en automatiseren repetitieve taken op het gebied van gegevensbeheer waar dat zinvol is.

IT operations team tracks software patch rollout in real time via a mobile device interface.

Integratie van BI en analytics

Onze experts koppelen het datawarehouse aan de BI- en analysetools die uw teams al gebruiken. Afhankelijk van de opzet kunnen ze gegevens importeren of rechtstreeks query’s uitvoeren op het datawarehouse. Gedeelde statistieken en rapportageregels blijven op één plek verzameld, in plaats van dat ze in elk dashboard opnieuw moeten worden opgebouwd.

Accessing a centralized analytics portal to evaluate company operations and outcomes.

Ondersteuning en optimalisatie

Na de lancering blijft het datawarehouse zich aanpassen aan uw gegevens en rapportagebehoeften. Ons team kan problemen met de pijplijn of gegevens oplossen, nieuwe bronnen toevoegen, trage query’s optimaliseren en modellen bijwerken wanneer de zakelijke vereisten veranderen.

The consulting team reviews analytics on screen, focusing on data-driven IT strategy and solutions.
Advies op het gebied van datawarehouses voor de gezondheidszorg

Als u al problemen hebt met de rapportage of een bestaand magazijn hebt dat niet meer aan de eisen voldoet, brengen we in kaart wat er moet veranderen. Ons team bekijkt de huidige opzet en vergelijkt de beschikbare opties. Op basis daarvan helpen we u te bepalen welke toepassingen prioriteit moeten krijgen.

Nurse reviews lab results and medication history in EHR system before patient rounds.
Architectuur en ontwerp

Zodra de vereisten zijn vastgesteld, ontwerpen onze architecten een magazijnstructuur die is afgestemd op uw systemen en de verwachte werklast. Zij bepalen hoe de belangrijkste componenten met elkaar worden verbonden en waar de gedeelde gegevens worden opgeslagen. De structuur kan vervolgens worden aangepast aan nieuwe bronnen of rapportagebehoeften zodra deze zich voordoen.

Building layouts and style guides for a new web application project.
Ontwikkeling van een datawarehouse

Zodra het ontwerp is goedgekeurd, bouwen onze ingenieurs het datawarehouse, inclusief de transformatielogica en eventuele benodigde datamarts. Tijdens de ontwikkeling voegen ze kwaliteitscontroles en beveiligingsmaatregelen toe, zodat het datawarehouse de rapportages en analyses kan ondersteunen die het project vereist.

IT specialist analyzing software code during an evening sprint session.
Data-integratie en -migratie

We koppelen het datawarehouse aan EHR/EMR, declaratiesystemen, laboratoriumsystemen, ERP/CRM en andere bronsystemen. Historische gegevens worden vervolgens met de vereiste toewijzingen en transformaties naar het doelmodel overgebracht. Vóór de overgang worden de gemigreerde gegevens aan de hand van afstemmingscontroles vergeleken met de brongegevens.

Data engineer interacts with a visual dashboard to orchestrate real-time data synchronization across systems.
Modernisering van het verouderde datawarehouse

Naarmate gegevensbronnen en rapportagebehoeften veranderen, kan het zijn dat een bestaand datawarehouse meer nodig heeft dan alleen routineonderhoud. We werken verouderde gegevensmodellen en pijplijnen bij, verplaatsen workloads wanneer het huidige platform een beperking vormt, en automatiseren repetitieve taken op het gebied van gegevensbeheer waar dat zinvol is.

IT operations team tracks software patch rollout in real time via a mobile device interface.
Integratie van BI en analytics

Onze experts koppelen het datawarehouse aan de BI- en analysetools die uw teams al gebruiken. Afhankelijk van de opzet kunnen ze gegevens importeren of rechtstreeks query’s uitvoeren op het datawarehouse. Gedeelde statistieken en rapportageregels blijven op één plek verzameld, in plaats van dat ze in elk dashboard opnieuw moeten worden opgebouwd.

Accessing a centralized analytics portal to evaluate company operations and outcomes.
Ondersteuning en optimalisatie

Na de lancering blijft het datawarehouse zich aanpassen aan uw gegevens en rapportagebehoeften. Ons team kan problemen met de pijplijn of gegevens oplossen, nieuwe bronnen toevoegen, trage query’s optimaliseren en modellen bijwerken wanneer de zakelijke vereisten veranderen.

The consulting team reviews analytics on screen, focusing on data-driven IT strategy and solutions.

Wilt u uw gegevenssysteem voor de gezondheidszorg moderniseren?

Leveranciers van datawarehouses voor de gezondheidszorg

Als u verschillende platforms voor een magazijn in de gezondheidszorg met elkaar vergelijkt, is uw bestaande cloudomgeving een goed uitgangspunt. De onderstaande opties gaan op verschillende manieren om met gegevens uit de gezondheidszorg, en ook hun reken- en prijsmodellen lopen uiteen.

Amazon-Redshift-Logo (1)

Amazon Redshift

Redshift is een logische keuze wanneer het grootste deel van je gegevens al in AWS staat. Het werkt samen met S3 en AWS Glue, terwijl HealthLake FHIR-gegevens naar S3 kan exporteren voor verdere analyse via Redshift of andere AWS-analysediensten.

Belangrijkste kenmerken

  • SQL voor gestructureerde en semi-gestructureerde gegevens
  • Toegang tot S3 via Redshift Spectrum
  • Gefederde query's naar ondersteunde AWS-databases
  • Toegangscontroles op rij- en kolomniveau
  • Compute- en beheerde opslag gescheiden houden
  • AWS-dienst die voldoet aan de HIPAA-vereisten 

Prijzen

  • Prijzen op aanvraag voor geconfigureerde clusters
  • Serverloze rekenkracht die op basis van gebruik wordt gefactureerd
  • Kosten voor afzonderlijk beheerde opslag
  • Speciale tarieven voor stabiele werklasten
Azure Synapse Analytics

Azure Synapse Analytics

Synapse werkt goed wanneer uw gegevens en rapportages al in Azure worden verwerkt en uw teams Power BI gebruiken. Het brengt SQL-datawarehousing en Spark samen in één werkruimte, met pijplijnen voor het verplaatsen van gegevens tussen Azure-diensten. FHIR-gegevens uit Azure Health Data Services kunnen ook naar Synapse worden gekopieerd voor analyse.

Belangrijkste kenmerken

  • Toegewijde en serverloze SQL
  • Apache Spark-pools
  • Zoekopdrachten in het Azure-datameer
  • Ingebouwde ETL/ELT-pijplijnen
  • Power BI- en Azure-ML-integraties
  • FHIR-analyses met Azure Health Data Services

Prijzen

  • Serverloze SQL, gefactureerd op basis van de verwerkte gegevens
  • Specifieke SQL-dienst, gefactureerd op basis van DWU-verbruik
  • Spark wordt gefactureerd op basis van vCore-gebruik
  • Opties vóór aankoop voor vaste workloads

Voor teams die meer vrijheid willen bij de keuze van cloudproviders, zorgt Snowflake ervoor dat de datawarehouse-laag minder afhankelijk is van één enkel ecosysteem. Het draait op AWS, Azure en Google Cloud, terwijl teams dankzij afzonderlijke virtuele datawarehouses verschillende workloads hun eigen rekenkracht kunnen toewijzen.

Belangrijkste kenmerken

  • Opties voor multi-cloudimplementatie
  • Onafhankelijke rekenkracht voor verschillende werklasten
  • Magazijnen met meerdere clusters in Enterprise Edition+
  • Ondersteuning voor inheemse semi-gestructureerde gegevens
  • Veilig delen van gegevens
  • PHI-ondersteuning met Business Critical+

Prijzen

  • Computercredits op basis van verbruik
  • Afzonderlijke opslagkosten
  • Capaciteit op aanvraag of vooraf betaald 
  • De tarieven variëren per cloud, regio en editie
GCP BigQuery

Google BigQuery

BigQuery is geschikt voor organisaties die al gebruikmaken van Google Cloud of die een serverloze datawarehouse willen zonder dat ze rekenclusters hoeven te beheren. De Cloud Healthcare API kan FHIR-bronnen en DICOM-metadata naar BigQuery exporteren, waardoor analyseteams via SQL toegang krijgen tot gegevens uit de gezondheidszorg.

Belangrijkste kenmerken

  • Serverloos SQL-datawarehouse
  • Opslag en rekenkracht scheiden
  • Ingebouwde mogelijkheden voor machine learning
  • Externe en federatieve zoekopdrachten
  • Cloud Integratie van de Healthcare API
  • BigQuery valt onder de HIPAA BAA van Google Cloud

Prijzen

  • Compute-capaciteit op aanvraag, gefactureerd op basis van de verwerkte gegevens
  • Capaciteitsprijzen op basis van slots
  • Opslag wordt apart in rekening gebracht
  • Beschikbare verbintenissen voor gereserveerde capaciteit

Kosten en tijdschema

De budgetten voor datawarehouses in de gezondheidszorg kunnen met meer dan een orde van grootte variëren. Een beperkte productiemart met een paar schone bronnen kan ongeveer $60.000–$100.000 kosten en 2–4 maanden in beslag nemen. Een enterprise-datawarehouse met meerdere systemen, inclusief migratie van historische gegevens en verschillende datamarts, kan $400.000–$1 miljoen of meer kosten en 9–18 maanden of langer in beslag nemen.

Schaal van het projectTypische reikwijdteTijdlijnUitvoeringsbegrotingLopende kosten voor cloud en software
Afdelingsdatamart1–2 bronsystemen, één afdeling, beperkte historiek, eenvoudige BI-rapportage2–4 maanden$60k–$100k$1k–$5k/maand
Middelgroot datawarehouse voor de gezondheidszorg3–6 bronnen, gedeeld gegevensmodel, migratie van historische gegevens, 2–4 data marts, BI-integratie5–9 maanden$150k–$350k$5k–$20k/maand
Enterprise DWH / lakehouse7+ bronnen, uitgebreide historische gegevens, meerdere markten, klinische integraties op maat, geavanceerde analyses9–18+ maanden$400k–$1m+$20k–$80k+/maand

Oplossingen voor de gezondheidszorg van Innowise

Waarom voor ons kiezen

Een DWH-project in de gezondheidszorg bevindt zich op het snijvlak van data-engineering en de gezondheidszorg IT. Innowise heeft ervaring op beide gebieden, ondersteund door relevante ISO-certificeringen en samenwerkingsverbanden met de cloud- en dataleveranciers die bij datawarehouse-projecten worden ingezet.

Ervaring in de gezondheidszorg

We beschikken over meer dan 19 jaar ervaring in de gezondheidszorg (IT), waaronder werkzaamheden op het gebied van EPD’s, laboratoriumsystemen, medische beeldvorming en verbonden zorgplatforms. Die ervaring is van groot belang wanneer klinische workflows of normen voor gezondheidszorggegevens bepalend zijn voor het ontwerp van het datawarehouse.

Expertise op het gebied van data-engineering

Onze datateams werken met Snowflake, BigQuery, Amazon Redshift en Azure Synapse, in combinatie met de bijbehorende ETL/ELT- en orkestratietools. Dit betekent dat we het datawarehouse kunnen ontwerpen op basis van de bestaande stack van de klant, in plaats van één specifiek platform te kiezen.

Relevante certificeringen

Innowise beschikt over ISO 9001-, ISO 27001- en ISO 13485-certificeringen op het gebied van kwaliteit, informatiebeveiliging en normen voor medische hulpmiddelen.

Leveringsoverzicht

Ons trackrecord omvat meer dan 1.600 projecten in diverse sectoren en meer dan 60 IT-oplossingen voor de gezondheidszorg. Voor een bedrijf op het gebied van precisiegeneeskunde hebben we verbeterde datapijplijnen en AWS-infrastructuur wordt gebruikt om diagnostische gegevens uit verschillende bronnen te verwerken.

Ervaring op het gebied van beveiliging en naleving

Onze zorgteams werken volgens de HIPAA- en AVG-voorschriften en volgens uitwisselingsstandaarden voor de gezondheidszorg, zoals HL7 v2 en FHIR. Die ervaring is van belang wanneer gevoelige gezondheidsgegevens worden uitgewisseld tussen het datawarehouse en gereguleerde klinische systemen.

Technologische samenwerkingsverbanden

Als partner van AWS, Microsoft, Google Cloud en Databricks brengt Innowise gecertificeerde platformkennis in bij DWH-projecten en kan het een beroep doen op ondersteuning van de leveranciers wanneer er platformspecifieke problemen optreden.

ISO 13485 certification.
ISO 9001 certification.
ISO/IEC 27001 certification.
GDPR
Select partner AWS
Google_Cloud_Partner

Conclusie

Ik zou een project voor een datawarehouse in de gezondheidszorg niet beginnen door te proberen alle datasets op één plek samen te brengen. Kies in plaats daarvan een rapportage- of analyseprobleem dat de moeite waard is om op te lossen en koppel alleen de systemen aan die voor die taak nodig zijn. Je zou bijvoorbeeld kunnen beginnen met rapportage over de inkomstencyclus of met een analyse van heropnames. Zodra dat werkt, kun je op basis van de daadwerkelijke vraag bepalen wat het datawarehouse vervolgens nodig heeft. 

Deze aanpak moet worden voortgezet naarmate het project groeit. Voeg alleen nieuwe bronnen of datamarts toe als daar een duidelijke reden voor is, in plaats van te proberen op elke mogelijke toekomstige behoefte vooruit te lopen. Het is belangrijk om definities en toegangsregels consistent te houden naarmate het datawarehouse groeit, en ervoor te zorgen dat altijd aan de nalevingsvereisten wordt voldaan. 

Als u hulp van buitenaf nodig hebt, kunnen specialisten van Innowise’s Hub voor gezondheidszorg en farmacie IT kan uw bestaande datawarehouse beoordelen of u helpen bij het opzetten van een datawarehouse dat is afgestemd op uw zorgsystemen en rapportagebehoeften, waarbij rekening wordt gehouden met de nalevingsvereisten voor zorggegevens.

FAQ

Een datawarehouse voor de gezondheidszorg bevat opgeschoonde gegevens voor rapportage en analyse. Een datameer bevat doorgaans grotere hoeveelheden onbewerkte of licht bewerkte gegevens. In veel architecturen worden in het datameer bredere datasets opgeslagen, terwijl het datawarehouse de gegevens bevat die teams nodig hebben voor terugkerende klinische, financiële of operationele analyses.

De doorlooptijden variëren afhankelijk van de omvang, de bronsystemen en de gegevenskwaliteit. Een gerichte data mart met enkele integraties kan 2 tot 4 maanden in beslag nemen. Een grotere implementatie van een enterprise data warehouse voor de gezondheidszorg kan 9 tot 18 maanden of langer duren wanneer het project de migratie van legacy-gegevens, meerdere integraties en verschillende data marts omvat.

Welk model voor een datawarehouse in de gezondheidszorg het meest geschikt is, hangt af van het aantal teams dat de gegevens nodig heeft en of zij dezelfde rapportagedefinities moeten hanteren. Een bedrijfsbreed model ondersteunt organisatiebrede rapportage, terwijl onafhankelijke data marts zich richten op specifieke afdelingen of gebruiksscenario’s. Een hybride model combineert een gedeelde kern met meer gespecialiseerde data marts. Het ontwerp van een datawarehouse in de gezondheidszorg moet aansluiten bij de gebruiksscenario’s die u als eerste moet ondersteunen.

Ja. We kunnen uw bestaande datawarehouse voor de gezondheidszorg moderniseren zonder het in één keer volledig te vervangen. Ons team vernieuwt verouderde pijplijnen, herzien data-modellen, verplaatst geselecteerde workloads en integreert in fasen nieuwere analysetools. Automatisering van het datawarehouse voor de gezondheidszorg vermindert bovendien het handmatige werk bij het inlezen van gegevens en bij terugkerende controles van de gegevenskwaliteit.

Innowise ontwerpt het datawarehouse vanaf het begin volgens de HIPAA-vereisten, waarbij de toegang tot PHI wordt beperkt op basis van functies en beveiligingsmaatregelen in de gegevensstromen zijn ingebouwd. We valideren de gegevens ook terwijl ze door het datawarehouse stromen, waarbij we controleren op onjuiste koppelingen, dubbele patiëntdossiers of gewijzigde waarden, voordat deze van invloed zijn op de rapportage.

Alles tonen

Inhoudsopgave

    Contacteer ons
    Boek een gesprek of vul het onderstaande formulier in en we nemen contact met je op zodra we je aanvraag hebben verwerkt.

    Stuur ons een spraakbericht
    Documenten bijvoegen
    Bestand uploaden

    Je kunt 1 bestand van maximaal 2 MB bijvoegen. Geldige bestandsformaten: pdf, jpg, jpeg, png.

    Door op Verzenden te klikken, stemt u ermee in dat Innowise uw persoonsgegevens verwerkt volgens onze Privacybeleid om u van relevante informatie te voorzien. Door je telefoonnummer op te geven, ga je ermee akkoord dat we contact met je opnemen via telefoongesprekken, sms en messaging-apps. Bellen, berichten en datatarieven kunnen van toepassing zijn.

    U kunt ons ook uw verzoek sturen
    naar contact@innowise.com
    Wat gebeurt er nu?
    1

    Zodra we je aanvraag hebben ontvangen en verwerkt, nemen we contact met je op om de details van je projectbehoeften en tekenen we een NDA om vertrouwelijkheid te garanderen.

    2

    Na het bestuderen van uw wensen, behoeften en verwachtingen zal ons team een projectvoorstel opstellen met de omvang van het werk, de teamgrootte, de tijd en de geschatte kosten voorstel met de omvang van het werk, de grootte van het team, de tijd en de geschatte kosten.
    3

    We zullen een afspraak met je maken om het aanbod te bespreken en de details vast te leggen.
    4

    Tot slot tekenen we een contract en gaan we meteen aan de slag met je project.

    Meer diensten die we aanbieden

    arrow