Trends op het gebied van machine learning 2026: technologische veranderingen en de gevolgen voor het bedrijfsleven

12 november 2026 17 min gelezen
Hoofd van de afdelingen Big Data, AI/ML/DS
Geverifieerde expert
Elk artikel op Innowise is geschreven door auteurs met praktijkervaring. Zij hebben niet alleen theoretische kennis van het onderwerp, maar delen ook inzichten uit concrete projecten.
11+ jaar ervaring
Geverifieerde expert
11+ jaar ervaring
Philip bouwt data-infrastructuren die voor duidelijkheid zorgen. Hij richt zich op het "waarom" achter de data en ontwerpt systemen die enorme volumes omzetten in bruikbare inzichten, terwijl hij ervoor zorgt dat de technische visie scherp en doelgericht blijft.
Expertise
Big Data AI & ML Python
Laten we praten

Belangrijkste inzichten

  • ML in 2026 wordt steeds praktischer. Veel van de vooruitgang zit hem in hergebruik, efficiëntie, monitoring, kalibratie en het minder lastig maken van het draaien van modellen in de productieomgeving.
  • Vooraf getrainde en zelfgestuurde modellen zorgen ervoor dat er steeds minder helemaal vanaf nul hoeft te worden opgebouwd. Tabelvormige basismodellen, herbruikbare visuele weergaven en synthetische trainingsgegevens kunnen een deel van het gebruikelijke werk op het gebied van training en labeling verminderen.
  • Beperkingen bij de implementatie zijn belangrijker dan het behalen van goede benchmarkresultaten. Latentie, geheugengebruik, energieverbruik, drift, prestaties van subgroepen en inferentiekosten kunnen belangrijker zijn dan het eruit persen van nog een fractie van een procent aan nauwkeurigheid.
  • Dezelfde trends zorgen voor ingrijpende veranderingen in zeer uiteenlopende werkprocessen. In de detailhandel komt dit tot uiting in prognoses en aanbevelingen; in het bankwezen in fraude- en kredietrisico’s; in de gezondheidszorg in het toekennen van prioriteit aan patiënten; in de productiesector in voorspellend onderhoud en het opsporen van defecten; en in de logistiek in verwachte aankomsttijden en het voorspellen van vertragingen.
  • Een aantal veelbelovende gebieden bevindt zich nog volop in ontwikkeling. Continu leren, causaal ML, hybride modellen, domeinoverschrijdende aanpassing en onzekerheidsbewuste voorspellingen lijken allemaal nuttig, maar ik zou een onderscheid maken tussen wat al is aangetoond en wat klaar is voor implementatie.
Artikel samenvatten met AI

ML is tegenwoordig saai. Dat is de trend.

Of in ieder geval: veel van de interessante vooruitgang vindt plaats op gebieden die niet echt voor krantenkoppen zorgen: 40 milliseconden van de inferentietijd afhalen, trainen met minder labels, een model hergebruiken in plaats van een nieuw te bouwen, uitzoeken waarom een systeem met een nauwkeurigheid van 96% steeds weer fouten maakt bij dezelfde groep gebruikers.

En dit is waarschijnlijk goed nieuws. Ik denk dat de meeste bedrijven niet echt een grote doorbraak op het gebied van ML nodig hebben. Ze zouden het prima vinden als ze een goed model hadden dat blijft werken wanneer de data verandert, dat geen fortuin kost om te draaien en dat een waarschuwing geeft wanneer het zich vreemd begint te gedragen.

Laten we dus eens kijken naar de nieuwste trends in machine learning om te zien welke richting dat werk opgaat.

Zet ML aan het werk

Overzicht en prognose van de markt voor machine learning

De ML-markt groeit snel. Maar er is geen eensgezindheid over hoe groot deze precies is.

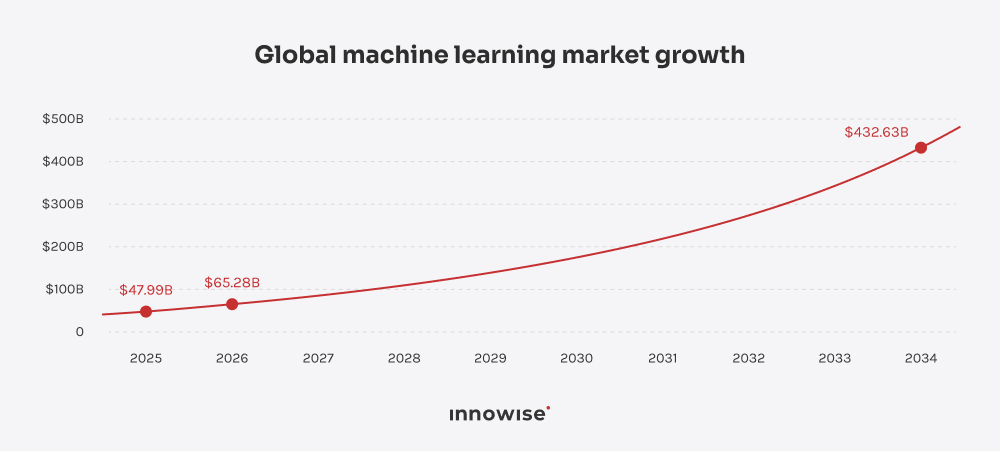
Fortune Business Insights schat de wereldwijde markt voor machine learning op 65,28 miljard dollar in 2026 en verwacht dat deze tegen 2034 432,63 miljard dollar zal bedragen. The Business Research Company geeft een veel hogere schatting voor hetzelfde jaar: 127,94 miljard dollar in 2026, oplopend tot 445,25 miljard dollar in 2030.

Global machine learning market growth 2025-2034.

Dat is bijna een verdubbeling voor 2026. Dit laat vooral zien dat de “machine learning-markt” een verrassend elastische categorie is: verschillende analisten nemen verschillende combinaties van software, infrastructuur, diensten en hardware mee in hun berekeningen.

Ook de details in de prognoses zijn nuttig. Fortune verwacht dat cloudimplementatie in 2026 53,14% van de ML-markt zal uitmaken, waarbij grote ondernemingen 55,61% en IT en telecommunicatie 17,56% van het eindgebruik voor hun rekening nemen.

Ondertussen Gartner verwacht dat de uitgaven aan AI-platforms voor datawetenschap en machine learning in 2026 $26,44 miljard zullen bedragen, een stijging van 36,3% ten opzichte van 2025.

Ik zou me dus niet te veel blindstaren op één gigantisch marktcijfer. Het nuttige is de richting: de uitgaven stijgen, de cloud neemt een groot deel van de implementaties voor zijn rekening en de tooling rondom ML wordt een omvangrijke markt op zich.

Laten we nu eens kijken naar de recente trends op het gebied van machine learning zelf.

Huidige trends op het gebied van machine learning

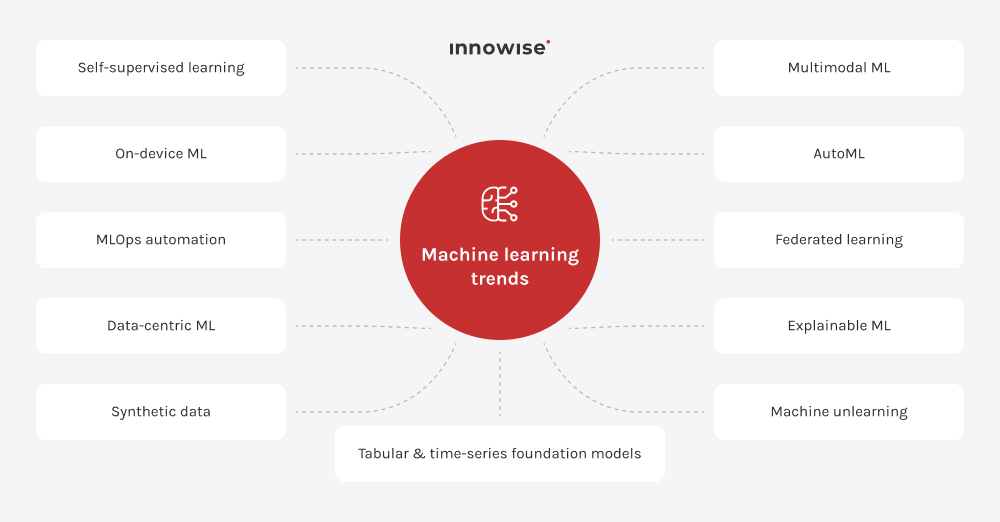
Sommige van de belangrijkste trends op het gebied van machine learning zijn nieuw. Andere bestaan al jaren en worden nu pas praktisch genoeg om ook buiten onderzoeksteams toegepast te worden. Eerlijk gezegd ben ik meer geïnteresseerd in de tweede groep, maar goed, laten we er eens dieper op ingaan.

Key machine learning trends this year.

Basismodellen voor tabelgegevens en tijdreeksen

Tabellen beleven momenteel hun "foundation-model"-moment.

In juni 2026 heeft introduceerde Google TabFM, een model voor classificatie en regressie in tabelvorm dat voorspellingen kan doen op nieuwe datasets zonder de gebruikelijke ronde van taakspecifieke training en afstemming van hyperparameters. Google heeft het getest op 38 classificatie- en 13 regressiedatasets, waaronder tabellen met tot wel 150.000 voorbeelden.

Wat is er zo bijzonder aan? Het is de manier waarop het is getraind. Er bestaat geen gigantische openbare opslagplaats met schone bedrijfstabellen, dus heeft Google in plaats daarvan honderden miljoenen synthetische datasets gegenereerd.

Ik zou XGBoost nog niet zomaar verwijderen. Voor veel problemen met gestructureerde gegevens zijn conventionele modellen nog steeds goedkoper, gemakkelijker te debuggen en zeer moeilijk te verslaan. Maar het idee om een nieuwe dataset te openen en een fatsoenlijke baseline te krijgen zonder weer een afstemmingsmarathon is behoorlijk aantrekkelijk.

En tijdreeksen gaan dezelfde kant op. Google’s TimesFM van Google is vooraf getraind op grote verzamelingen tijdreeksgegevens en kan zero-shot-voorspellingen genereren voor datasets die het nog nooit eerder heeft gezien. De aantrekkingskracht is vergelijkbaar met die van TabFM: er is minder taakspecifieke training nodig telkens wanneer iemand een nieuwe vraag-, verkeers- of capaciteitsprognose nodig heeft.

Zou ik elke bestaande prognosepijplijn hiermee vervangen? Nee. Maar het is de moeite waard om te testen wanneer het alternatief bestaat uit nog een ronde van modeltraining en -afstemming vanaf nul.

Bij zelfgestuurd leren zijn minder labels nodig

Het labelen van gegevens is een van die taken waarvan iedereen het erover eens is dat ze essentieel zijn, maar waar niemand graag voor wil betalen.

Zelfgestuurd leren omzeilt een deel van dat probleem door eerst nuttige representaties te leren uit ongelabelde gegevens en deze vervolgens aan te passen aan een kleinere gelabelde dataset.

Meta’s DINOv3 is een goed voorbeeld. Het is getraind op 1,7 miljard afbeeldingen zonder menselijke labels, waarbij het grootste model 7 miljard parameters bereikte. Dezelfde ‘bevroren’ visuele backbone kan vervolgens taken ondersteunen zoals classificatie, objectdetectie, segmentatie en tracking.

Voor bedrijven die beschikken over jaren aan ongelabelde inspectiefoto’s, satellietbeelden, medische beelden of video’s, verandert dit de economische aspecten enigszins. U hebt wellicht nog steeds labels nodig. Maar misschien niet enkele miljoenen.

Kleinere modellen worden weer interessanter

Een prachtig model dat een datacenter nodig heeft om een eenvoudige vraag te beantwoorden, heeft weinig aantrekkingskracht op een telefoon, sensor, camera of industriële besturingseenheid.

Daarom krijgt modelcompressie steeds meer aandacht: kwantisering vermindert de numerieke precisie, pruning verwijdert minder nuttige gewichten en distillatie brengt kennis over naar een kleiner model. TensorFlow’s eigen optimalisatietoolkit noemt latentie, geheugengebruik, stroomverbruik en modelgrootte als centrale beperkingen voor implementatie op de rand.

Er is hier geen gratis lunch. Comprimeer te agressief en de nauwkeurigheid daalt.

De uitdaging is het vinden van het punt waarop niemand het merkt, behalve de infrastructuurkosten.

MLOps wordt steeds minder een keuze

Het trainen van het model was nooit het hele werk. We hebben gewoon verrassend veel tijd besteed aan doen alsof dat wel zo was.

Zodra een ML-systeem live is, moet iemand weten welke dataset het heeft voortgebracht, met welke codeversie het is getraind, of de invoergegevens zijn gewijzigd, of de prestaties afwijken, wanneer hertraining is toegestaan en hoe een slechte release kan worden teruggedraaid.

Tools weerspiegelen dit. MLflow 3, bijvoorbeeld, heeft zijn architectuur voor modelbeheer uitgebreid met een betere traceerbaarheid en vergelijking tussen modelversies en experimenten.

Dit is waarschijnlijk een van de minst glamoureuze machine learning-trends op de lijst, en een van de trends die ik het meest serieus zou nemen.

Synthetische gegevens worden aan een realiteitscheck onderworpen

Synthetische gegevens klinken ontzettend handig. Ontbreken er voorbeelden? Maak er dan zelf een paar.

Dat kan werken. Het kan er ook voor zorgen dat een model heel goed wordt in het begrijpen van een kunstmatige wereld die niet echt bestaat.

Een onderzoeksrapport van Apple uit 2026 onderzocht het combineren van echte en synthetische trainingsgegevens en ontdekte iets nuttigers dan “synthetische gegevens helpen”. Hun resultaten suggereren dat er een optimale verhouding kan bestaan: voeg synthetische gegevens toe en de prestaties verbeteren tot een bepaald punt, waarna ze slechter worden naarmate de synthetische en echte verdelingen te ver uit elkaar komen te liggen.

Multimodale machine learning vindt zijn weg naar alledaagse voorspellingen

Multimodaal hoeft niet per se te betekenen dat een model je foto kan bespreken en er een gedicht over kan schrijven.

Voor voorspellende ML kan het veel minder spannend en veel nuttiger zijn: productafbeelding + beschrijving + prijs, medische scan + patiëntgeschiedenis, sensormetingen + onderhoudsnotities.

De huidige AutoGluon-tools kunnen bijvoorbeeld afbeeldingen, tekst, tabelgegevens en documentgegevens combineren voor taken zoals classificatie en regressie.

Het vervelende deel komt later. Wat gebeurt er als de afbeelding ontbreekt? Of als de sensor het begeeft? Of als één gegevensbron twee uur later binnenkomt dan de andere?

Dat moet deel uitmaken van de evaluatie, en mag geen verrassing zijn die pas na de lancering aan het licht komt.

AutoML neemt steeds weer de saaie klusjes uit handen

Modelkeuze, het afstemmen van hyperparameters, ensembling, bepaalde aspecten van featureverwerking: veel hiervan kan al redelijk goed worden geautomatiseerd.

Goed.

Ik ben er niet van overtuigd dat een goedbetaalde ML-engineer een middag moet besteden aan het handmatig testen van 47 combinaties van leersnelheid en boomdiepte, alleen maar om zijn toewijding aan het vak te bewijzen.

Wat AutoML niet zo goed automatiseert, is beslissen of de doelvariabele zinvol is, of de trainingsdata informatie uit de toekomst prijsgeeft, of de evaluatiemaatstaf de bedrijfskosten weerspiegelt, of dat het model überhaupt zou moeten bestaan.

Dat blijven lastige menselijke problemen.

Federatief leren staat nog steeds niet gelijk aan privacy

Federated learning heeft een zeer aantrekkelijke opzet: trainen op meerdere apparaten of binnen verschillende organisaties zonder alle ruwe gegevens naar één centrale database te verplaatsen.

Handig, ja. Automatisch privé? Nee.

NIST heeft aanvallen gedocumenteerd waarmee informatie kan worden achterhaald uit de modelupdates die tijdens federated training worden uitgewisseld, en beveelt aanvullende beveiligingsmaatregelen aan in plaats van decentralisatie op zich als een privacygarantie te beschouwen.

En echte implementaties zijn rommelig. Verschillende apparaten hebben verschillende rekenkracht, deelnemers verdwijnen, gegevensdistributies verschillen, beveiligingsaannames gaan niet op. De implementatiebeoordeling van NIST uit 2024 legt de kloof tussen de keurige theorie van federated learning en productiesystemen vrij duidelijk bloot.

Een daar geciteerde deskundige, dr. Mat Weldon van het Britse Office for National Statistics, verwoordde het beter dan ik dat kan:

“Het is makkelijker om een nieuwe federated learning-architectuur te ontwerpen dan om er een red team-test op uit te voeren.”

Dat klopt.

Verklaarbaarheid wordt minder plechtig

Jarenlang kon het toevoegen van een SHAP-diagram aan een dashboard ervoor zorgen dat een model op bevredigende wijze “verklaarbaar” aanvoelde.

Dat is een lage lat.

NIST maakt onderscheid tussen verklaarbaarheid, oftewel het begrijpen hoe een systeem tot een uitkomst is gekomen, en interpreteerbaarheid, wat betekent wat dat resultaat in zijn context inhoudt. In de richtlijnen wordt ook aanbevolen om verklaringsmethoden te testen vóór implementatie, in plaats van ervan uit te gaan dat de verklaring correct is omdat de grafiek er overtuigend uitziet.

NIST-onderzoekers publiceerden in 2026 een artikel over verklaarbare validatie en kenmerkreducering, wat interessant is omdat het verklaarbaarheid dichter bij het testen van modellen brengt in plaats van het als een achteraf toegevoegde laag te laten.

Ik vind die richting goed. Een verklaring moet iets zijn dat we testen, geen versiering voor de modelkaart.

Het ‘afleren’ van machines wordt een echte technische uitdaging

Stel dat iemand je vraagt om zijn of haar gegevens te verwijderen.

Je verwijdert het record uit de database.

Prima.

Maar hoe zit het dan met het model dat er al op is getraind?

Dat is waar machine unlearning om de hoek komt kijken: het verwijderen van de invloed van bepaalde trainingsgegevens zonder het hele model helemaal opnieuw te trainen. In juni 2026 heeft publiceerde Google Research een raamwerk om te controleren of een “afgeleerd” model zich daadwerkelijk meer gedraagt als een pas opnieuw getraind model dan als het oorspronkelijke model.

En dat tweede deel is belangrijk. Iets vergeten is één ding. Bewijzen dat het model het vergeten is, is iets anders.

Het ‘afleren’ van machines is nog steeds veel meer actief onderzoek dan een gangbare bedrijfsoplossing, maar ik zou het in de gaten houden. Op het moment dat ‘verwijder mijn gegevens’ meer moet betekenen dan het verwijderen van een rij, is dit niet langer theoretisch.

Ontwikkel een ML-oplossing voor uw bedrijf

Hoe ML-trends de werkprocessen in verschillende sectoren veranderen

Dezelfde ML-trend kan heel anders uitpakken zodra deze in een echte workflow wordt toegepast. In de detailhandel kan snellere inferentie betekenen dat aanbevelingen worden bijgewerkt terwijl iemand nog aan het rondkijken is. In de productiesector kan het betekenen dat een defect wordt opgemerkt voordat het product verder op de productielijn is doorgestuurd.

  • Onderwijs
  • Detailhandel en e-commerce
  • Bankieren en financiën
  • Gezondheidszorg
  • Maakindustrie
  • Logistiek en vervoer

Onderwijs

Onderwijsplatforms beschikken al over een schat aan gegevens: antwoorden, pogingen, reactietijden, overgeslagen opdrachten, voortgang in de cursus. Het lastige is om daar iets nuttigs van te maken, zonder te doen alsof een model een leerling beter begrijpt dan een docent.

Machine learning was al de grootste technologiesegment op de markt voor AI in het onderwijs in 2025, waarbij prestatiebewaking, personalisatie en intelligente begeleiding tot de belangrijkste toepassingen behoren.

  • Pas de moeilijkheidsgraad en de volgorde van de oefeningen aan op basis van eerdere prestaties, in plaats van iedereen hetzelfde traject op te leggen.
  • Het risico op schooluitval voorspellen aan de hand van patronen zoals een afnemende deelname, herhaaldelijke mislukkingen of lange pauzes tussen de sessies.
  • Kennislacunes eerder opsporen en het rooster aanpassen voordat de leerling volledig onvoorbereid aan het volgende onderwerp begint.
Detailhandel en e-commerce

De detailhandel maakt al jaren gebruik van ML, maar de interessante veranderingen doen zich voor op het gebied van snelheid en de verscheidenheid aan gegevens. Voorspellingen kunnen vaker worden bijgewerkt, aanbevelingen kunnen op meer dan alleen aankoopgeschiedenis worden gebaseerd, en bij visueel zoeken kunnen afbeeldingen worden gecombineerd met productbeschrijvingen en catalogusgegevens.

  • De vraag voorspellen en de bevoorrading automatiseren op basis van verkoopgeschiedenis, seizoensinvloeden, promoties en recentere operationele gegevens.
  • Aanbevelingen personaliseren op basis van surf- en koopgedrag in plaats van op basis van statische klantsegmenten.
  • Productzoekfunctie verbeteren door tekst- en beeldgegevens te combineren, wat handig is wanneer de klant niet weet hoe het artikel heet, maar wel een foto heeft.

Bankieren en financiën

In de banksector zijn modelmonitoring, verklaarbaarheid en drift zaken die je niet langer kunt negeren. Fraude patronen veranderen, het gedrag van klanten verandert, en een model dat zes maanden geleden nog goed leek, kan in een mum van tijd erg duur worden.

De wereldwijde machinaal leren in het bankwezen de markt had in 2025 een waarde van ongeveer 40 miljard dollar en zal naar verwachting uitkomen op ongeveer 150 miljard dollar tegen 2034volgens Fortune Bedrijfsinzichten.

  • Verdachte transacties opsporen en de zaken rangschikken, zodat onderzoekers beginnen met de zaken die het meest risicovol lijken.
  • Leg uit kredietbeslissingen door aan te geven welke factoren de grootste invloed hadden op een score.
  • Modelafwijkingen in de gaten houden naarmate fraudetechnieken, bestedingsgedrag en klantprofielen veranderen.

Gezondheidszorg

De gezondheidszorg is een van die sectoren waar een goed referentiecijfer bij lange na niet voldoende is. Modellen kunnen zich verschillend gedragen naargelang het ziekenhuis, de patiëntengroep, de apparatuur en de klinische context, dus kalibratie en monitoring zijn net zo belangrijk als de ruwe voorspellende prestaties.

De wereldwijde markt voor voorspellende analyses in de gezondheidszorg wordt geschat op 19,7 miljard dollar in 2026 door Grand View Onderzoek, dat verwacht dat het zal uitkomen op 49,3 miljard dollar tegen 2033.

  • Vroegtijdige tekenen van achteruitgang herkennen, waaronder het risico op sepsis, voordat de situatie klinisch duidelijk wordt.
  • Het risico op heropname voorspellen en prioriteit geven aan de nazorg voor patiënten die eerder geneigd zijn terug te komen.
  • Zaken rangschikken voor beoordeling zodat zorgverleners hun aandacht kunnen richten op de gevallen waarin het voorspelde risico het grootst is.

Maakindustrie

De productiesector is waarschijnlijk het duidelijkste voorbeeld voor machine learning op het apparaat zelf. Als een camera onderdelen controleert die over een productielijn lopen, heeft het vaak weinig zin om elk beeld naar de cloud te sturen en op een reactie te wachten.

De bredere markt voor AI in de productiesector wordt geschat op 9,85 miljard dollar in 2026, waarbij machine learning en computervisie worden ingezet voor preventief onderhoud, inspectie, kwaliteitscontrole en productieplanning.

  • Storingen in apparatuur voorspellen op basis van trillingen, temperatuur, druk en onderhoudsgeschiedenis.
  • Detecteer defecten met computervisie terwijl het product zich nog op de productielijn bevindt.
  • De productkwaliteit voorspellen op basis van de productieparameters vóór de eindcontrole.

Logistiek en vervoer

De logistiek zit vol met voorspellingsproblemen, waardoor het een voor de hand liggend toepassingsgebied is voor machine learning: aankomsttijden, vertragingen, vraag in magazijnen, verkeer, routewijzigingen, gemiste aansluitingen.

De De markt voor machine learning in de logistiek wordt voor 2026 geschat op 5,3 miljard dollar en zal naar verwachting uitkomen op 44,5 miljard dollar tegen 2035volgens Global Market Insights.

Ook hier speelt onzekerheid een rol. “Aankomsttijd 14:10” en “Aankomsttijd 14:10, maar we weten het eigenlijk niet zeker” zijn twee heel verschillende soorten informatie voor iemand die bij een laadperron staat te wachten.

  • Aankomsttijden voorspellen op basis van historische vertragingen, verkeerssituaties en realtime voertuigposities.
  • Verwachte vertragingen bij verzendingen vroeg genoeg om de magazijn- of leveringsplannen aan te passen.
  • Reistijd en vraag voorspellen ter ondersteuning van routeplanning en de inzet van het wagenpark.

Onderwijs

Onderwijsplatforms beschikken al over een schat aan gegevens: antwoorden, pogingen, reactietijden, overgeslagen opdrachten, voortgang in de cursus. Het lastige is om daar iets nuttigs van te maken, zonder te doen alsof een model een leerling beter begrijpt dan een docent.

Machine learning was al de grootste technologiesegment op de markt voor AI in het onderwijs in 2025, waarbij prestatiebewaking, personalisatie en intelligente begeleiding tot de belangrijkste toepassingen behoren.

  • Pas de moeilijkheidsgraad en de volgorde van de oefeningen aan op basis van eerdere prestaties, in plaats van iedereen hetzelfde traject op te leggen.
  • Het risico op schooluitval voorspellen aan de hand van patronen zoals een afnemende deelname, herhaaldelijke mislukkingen of lange pauzes tussen de sessies.
  • Kennislacunes eerder opsporen en het rooster aanpassen voordat de leerling volledig onvoorbereid aan het volgende onderwerp begint.

Detailhandel en e-commerce

De detailhandel maakt al jaren gebruik van ML, maar de interessante veranderingen doen zich voor op het gebied van snelheid en de verscheidenheid aan gegevens. Voorspellingen kunnen vaker worden bijgewerkt, aanbevelingen kunnen op meer dan alleen aankoopgeschiedenis worden gebaseerd, en bij visueel zoeken kunnen afbeeldingen worden gecombineerd met productbeschrijvingen en catalogusgegevens.

  • De vraag voorspellen en de bevoorrading automatiseren op basis van verkoopgeschiedenis, seizoensinvloeden, promoties en recentere operationele gegevens.
  • Aanbevelingen personaliseren op basis van surf- en koopgedrag in plaats van op basis van statische klantsegmenten.
  • Productzoekfunctie verbeteren door tekst- en beeldgegevens te combineren, wat handig is wanneer de klant niet weet hoe het artikel heet, maar wel een foto heeft.

Bankieren en financiën

In de banksector zijn modelmonitoring, verklaarbaarheid en drift zaken die je niet langer kunt negeren. Fraude patronen veranderen, het gedrag van klanten verandert, en een model dat zes maanden geleden nog goed leek, kan in een mum van tijd erg duur worden.

De wereldwijde machinaal leren in het bankwezen de markt had in 2025 een waarde van ongeveer 40 miljard dollar en zal naar verwachting uitkomen op ongeveer 150 miljard dollar tegen 2034volgens Fortune Bedrijfsinzichten.

  • Verdachte transacties opsporen en de zaken rangschikken, zodat onderzoekers beginnen met de zaken die het meest risicovol lijken.
  • Leg uit kredietbeslissingen door aan te geven welke factoren de grootste invloed hadden op een score.
  • Modelafwijkingen in de gaten houden naarmate fraudetechnieken, bestedingsgedrag en klantprofielen veranderen.

Gezondheidszorg

De gezondheidszorg is een van die sectoren waar een goed referentiecijfer bij lange na niet voldoende is. Modellen kunnen zich verschillend gedragen naargelang het ziekenhuis, de patiëntengroep, de apparatuur en de klinische context, dus kalibratie en monitoring zijn net zo belangrijk als de ruwe voorspellende prestaties.

De wereldwijde markt voor voorspellende analyses in de gezondheidszorg wordt geschat op 19,7 miljard dollar in 2026 door Grand View Onderzoek, dat verwacht dat het zal uitkomen op 49,3 miljard dollar tegen 2033.

  • Vroegtijdige tekenen van achteruitgang herkennen, waaronder het risico op sepsis, voordat de situatie klinisch duidelijk wordt.
  • Het risico op heropname voorspellen en prioriteit geven aan de nazorg voor patiënten die eerder geneigd zijn terug te komen.
  • Zaken rangschikken voor beoordeling zodat zorgverleners hun aandacht kunnen richten op de gevallen waarin het voorspelde risico het grootst is.

Maakindustrie

De productiesector is waarschijnlijk het duidelijkste voorbeeld voor machine learning op het apparaat zelf. Als een camera onderdelen controleert die over een productielijn lopen, heeft het vaak weinig zin om elk beeld naar de cloud te sturen en op een reactie te wachten.

De bredere markt voor AI in de productiesector wordt geschat op 9,85 miljard dollar in 2026, waarbij machine learning en computervisie worden ingezet voor preventief onderhoud, inspectie, kwaliteitscontrole en productieplanning.

  • Storingen in apparatuur voorspellen op basis van trillingen, temperatuur, druk en onderhoudsgeschiedenis.
  • Detecteer defecten met computervisie terwijl het product zich nog op de productielijn bevindt.
  • De productkwaliteit voorspellen op basis van de productieparameters vóór de eindcontrole.

Logistiek en vervoer

De logistiek zit vol met voorspellingsproblemen, waardoor het een voor de hand liggend toepassingsgebied is voor machine learning: aankomsttijden, vertragingen, vraag in magazijnen, verkeer, routewijzigingen, gemiste aansluitingen.

De De markt voor machine learning in de logistiek wordt voor 2026 geschat op 5,3 miljard dollar en zal naar verwachting uitkomen op 44,5 miljard dollar tegen 2035volgens Global Market Insights.

Ook hier speelt onzekerheid een rol. “Aankomsttijd 14:10” en “Aankomsttijd 14:10, maar we weten het eigenlijk niet zeker” zijn twee heel verschillende soorten informatie voor iemand die bij een laadperron staat te wachten.

  • Aankomsttijden voorspellen op basis van historische vertragingen, verkeerssituaties en realtime voertuigposities.
  • Verwachte vertragingen bij verzendingen vroeg genoeg om de magazijn- of leveringsplannen aan te passen.
  • Reistijd en vraag voorspellen ter ondersteuning van routeplanning en de inzet van het wagenpark.
Het model dat uit de benchmark als beste naar voren komt, is niet altijd het model dat ik in productie zou nemen. Als je factoren als latentie, infrastructuurkosten, drift en onderhoud meerekent, kan een iets minder nauwkeurig model al snel de betere technische keuze blijken te zijn.
Dmitry Nazarevich, CTO.
Dmitry Nazarevich
Technisch Directeur (CTO)

Toekomstige trends op het gebied van machine learning

Sommige ML-ideeën zijn nu al bruikbaar. Voor andere zijn nog betere benchmarks, goedkopere rekenkracht of een paar onaangename ervaringen in de productie nodig voordat ik ze als klaar zou beschouwen.

Dit zijn de opkomende trends in machine learning die ik in de gaten zou blijven houden.

  • Cross-domain generalization and adaptation icon.

    Domeinoverschrijdende generalisatie en aanpassing

    Een van de oudste problemen op het gebied van machine learning speelt nog steeds een grote rol: train een model in de ene omgeving, pas het toe in een iets andere omgeving, en zie hoe de prestaties achteruitgaan.

    Domein-generalisatie heeft tot doel modellen in staat te stellen goed te presteren op gegevensverdelingen die ze nog niet eerder hebben gezien. Een onderzoek uit 2026 naar patroonclassificatie in onbekende omgevingen beschrijft precies dit probleem: veranderingen in sensoren, acquisitieomstandigheden of andere domeinkenmerken kunnen al voldoende zijn om een model ernstig te verstoren.

    De praktische toepassing is gemakkelijk voor te stellen. Een visiemodel dat in de ene fabriek is getraind, moet in een andere fabriek met andere camera’s functioneren. Een medisch model wordt in een ander ziekenhuis ingezet. Een fraudemodel krijgt te maken met een nieuwe klantengroep.

    Ik vermoed dat dit minder een onderzoeksspecialisme zal worden en meer een basisvereiste voor de implementatie.

  • Continual learning icon.

    Voortdurend leren

    De meeste productiemodellen leren nog steeds in stappen: nieuwe gegevens verzamelen, opnieuw trainen, valideren en opnieuw implementeren.

    Bij continu leren wordt gestreefd naar een soepeler proces. Het model blijft leren naarmate er nieuwe gegevens binnenkomen, zonder te vergeten wat het eerder wist.

    Dat laatste is het addertje onder het gras.

    Een systematische review uit 2026 van 189 peer-reviewed artikelen over continu leren identificeert catastrofaal vergeten nog steeds als een van de centrale problemen binnen het vakgebied: het leren van iets nieuws kan de prestaties bij oudere taken negatief beïnvloeden.

    Ik zou geplande bijscholing dus niet vervangen door continu leren, alleen maar omdat die naam beter klinkt. Maar voor fraudedetectie, industriële systemen, aanbevelingen en andere omgevingen die voortdurend veranderen, ligt de aantrekkingskracht voor de hand.

  • Hybrid ML models icon.

    Hybride ML-modellen

    Het heeft wel iets grappigs dat we jarenlang hebben geprobeerd om neurale netwerken alles uit gegevens te laten leren, om er vervolgens achter te komen dat de bekende natuurkundige wetten toch nog van nut kunnen zijn.

    Google’s NeuralGCM is een goed voorbeeld. Het combineert machine learning met een op fysica gebaseerde atmosferische solver, in plaats van één van beide het hele werk te laten doen. In onderzoek dat is gepubliceerd in Nature, leverde het model concurrerende weer- en klimaatvoorspellingen op, terwijl het drie tot vijf ordes van grootte minder rekenkracht gebruikte dan vergelijkbare conventionele modellen.

    Dat idee reikt veel verder dan alleen het weer.

    Als we de fysische beperkingen, technische regels of andere domeinrelaties al kennen, kan het zinvoller zijn om deze in het model in te voeren dan een neuraal netwerk te vragen om de zwaartekracht opnieuw te ontdekken aan de hand van een spreadsheet.

  • Causal ML icon.

    Causale ML

    Voorspellingen geven antwoord op vragen als:

    Wie loopt het risico om weg te gaan?

    Bedrijven willen meestal weten wat de volgende vraag is:

    Wie blijft er als we korting geven?

    Dat is een causale vraag.

    Causale ML combineert machine learning met causale inferentie om in te schatten wat er bij verschillende interventies kan gebeuren. Deze methode wordt in de geneeskunde al gebruikt om de effecten van individuele behandelingen in te schatten, hoewel onderzoekers nog steeds waarschuwen dat onjuiste aannames en verstorende factoren tot overtuigende maar verkeerde conclusies kunnen leiden.

    Ik denk dat dit een van de interessantere invalshoeken is, omdat het de doelstelling van het model verandert. Voorspelling beschrijft een waarschijnlijke toekomst. Causale machine learning probeert je te vertellen of een bepaalde handeling die toekomst zal veranderen.

    Een veel moeilijker probleem.

    Een veel nuttiger exemplaar.

  • Uncertainty-aware predictions icon.

    Voorspellingen die rekening houden met onzekerheid

    Een model dat aangeeft dat het “92% betrouwbaar” is, geeft een geruststellend gevoel.

    Het kan ook onzin zijn.

    Bij onzekerheidskalibratie wordt getracht de betrouwbaarheid in overeenstemming te brengen met de werkelijke voorspellende nauwkeurigheid. In een in 2026 gepubliceerd onderzoek in Nature Machine Intelligence in 2026 beschrijft kalibratie als essentieel voor een betrouwbare implementatie van machine learning, juist omdat moderne modellen een hoge mate van zekerheid kunnen uitstralen terwijl ze toch onjuist zijn.

    De verschuiving in de distributie maakt dit nog erger. Uit een studie uit 2026 Scientific Reports bleek dat voorspellende modellen zowel aan prestaties als aan kalibratie kunnen inboeten wanneer ze worden toegepast op heterogene datasets uit de praktijk.

    Voor bedrijven is het nuttige resultaat niet een model dat altijd een antwoord geeft. Soms is het betere model juist het model dat in feite zegt: Ik weet het hier niet zo zeker over, geef het maar aan een mens.

    Daar zou ik graag veel meer van zien.

Hulp nodig bij het kiezen van de juiste ML-aanpak?

Volgende stappen: hoe bedrijven trends op het gebied van ML-technologie kunnen implementeren

De slechtste manier om deze lijst te gebruiken, is door een trend te kiezen omdat die actueel klinkt, en vervolgens op zoek te gaan naar een probleem waaraan je die trend kunt koppelen.

Begin in plaats daarvan met dat vervelende bedrijfsprobleem.

01
Bepaal wat er moet worden verbeterd

Nauwkeurigere voorspellingen? Minder valse fraudemeldingen? Lagere kosten voor het trekken van conclusies? Snellere controle? Kies eerst het gewenste resultaat en gebruik het huidige proces als uitgangspunt.

02
Ga na of de gegevens dit kunnen staven

Voordat je modellen met elkaar vergelijkt, moet je kijken naar labels, ontbrekende waarden, toegangsrechten, onevenwichtigheid tussen klassen, de dekking en of de productiegegevens zullen lijken op de gegevens die voor de training zijn gebruikt. Dit is ook het punt waarop veel ML-projecten al snel minder spannend worden.

03
Vergelijk het nieuwe met het saaie

Als een vooraf getraind model, een AutoML-systeem of een multimodale architectuur in aanmerking wordt genomen, test het dan tegen een eenvoudigere referentie onder dezelfde omstandigheden. Dezelfde gegevens, dezelfde meetcriteria, dezelfde latentiegrenzen, dezelfde bedrijfsdoelstelling.

Als het ingewikkelde model 0,3% beter presteert maar vier keer zo veel kost om te gebruiken, zou ik een heel goede reden willen hebben om het te behouden.

04
Probeer het uit in een omgeving waar je een mislukking kunt overleven

Gebruik representatieve gegevens en test de scenario’s die de grootste kans op problemen bieden: ontbrekende invoergegevens, zeldzame klassen, ongebruikelijke apparaten, kwetsbaardere klantsegmenten, piekbelastingen. Bepaal van tevoren onder welke omstandigheden je de pilot zou stopzetten.

05
Wijs na de lancering een eigenaar toe aan het model

Er moet iemand toezicht houden op drift, latentie, kosten, kalibratie, de prestaties van subgroepen en de bedrijfsindicator die het model had moeten verbeteren. Ook moet worden besloten wanneer het model opnieuw moet worden getraind, teruggedraaid, vervangen of gewoon uitgeschakeld.

En ja, soms is de juiste conclusie dat de nieuwe ML-trend niet genoeg verbetering biedt om een verandering te rechtvaardigen.

Ook dat geldt als een geslaagde evaluatie.

arrow-icon.arrow-icon.
01 Bepaal wat er moet worden verbeterd

Nauwkeurigere voorspellingen? Minder valse fraudemeldingen? Lagere kosten voor het trekken van conclusies? Snellere controle? Kies eerst het gewenste resultaat en gebruik het huidige proces als uitgangspunt.

arrow-icon.arrow-icon.
02 Ga na of de gegevens dit kunnen staven

Voordat je modellen met elkaar vergelijkt, moet je kijken naar labels, ontbrekende waarden, toegangsrechten, onevenwichtigheid tussen klassen, de dekking en of de productiegegevens zullen lijken op de gegevens die voor de training zijn gebruikt. Dit is ook het punt waarop veel ML-projecten al snel minder spannend worden.

arrow-icon.arrow-icon.
03 Vergelijk het nieuwe met het saaie

Als een vooraf getraind model, een AutoML-systeem of een multimodale architectuur in aanmerking wordt genomen, test het dan tegen een eenvoudigere referentie onder dezelfde omstandigheden. Dezelfde gegevens, dezelfde meetcriteria, dezelfde latentiegrenzen, dezelfde bedrijfsdoelstelling.

Als het ingewikkelde model 0,3% beter presteert maar vier keer zo veel kost om te gebruiken, zou ik een heel goede reden willen hebben om het te behouden.

arrow-icon.arrow-icon.
04 Probeer het uit in een omgeving waar je een mislukking kunt overleven

Gebruik representatieve gegevens en test de scenario’s die de grootste kans op problemen bieden: ontbrekende invoergegevens, zeldzame klassen, ongebruikelijke apparaten, kwetsbaardere klantsegmenten, piekbelastingen. Bepaal van tevoren onder welke omstandigheden je de pilot zou stopzetten.

arrow-icon.arrow-icon.
05 Wijs na de lancering een eigenaar toe aan het model

Er moet iemand toezicht houden op drift, latentie, kosten, kalibratie, de prestaties van subgroepen en de bedrijfsindicator die het model had moeten verbeteren. Ook moet worden besloten wanneer het model opnieuw moet worden getraind, teruggedraaid, vervangen of gewoon uitgeschakeld.

En ja, soms is de juiste conclusie dat de nieuwe ML-trend niet genoeg verbetering biedt om een verandering te rechtvaardigen.

Ook dat geldt als een geslaagde evaluatie.

Toepassingen en trends op het gebied van machine learning in de praktijk: Innowise casestudies

Alle casestudies
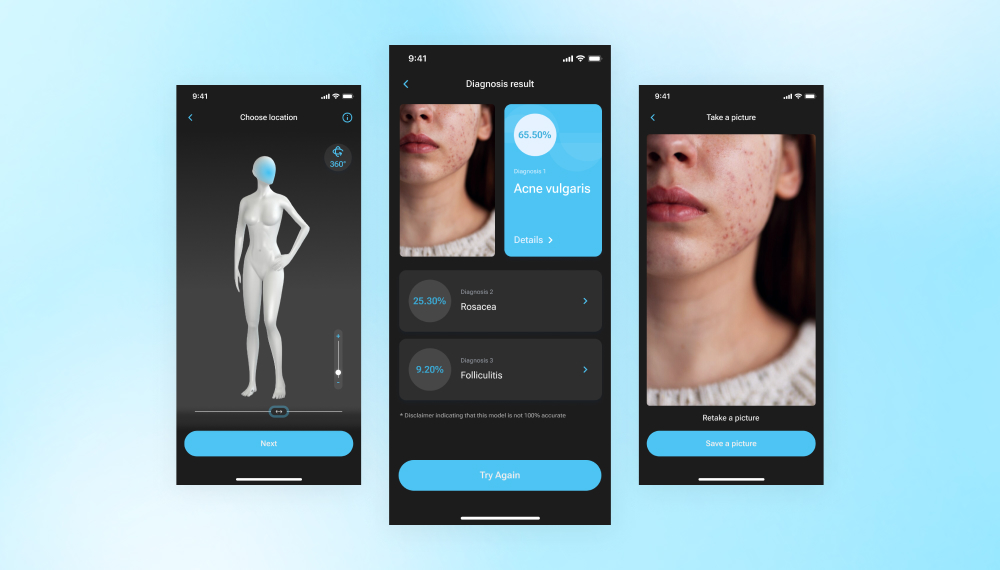
Ontwikkeling van een app voor een AI-huidscanner door een dermatoloog
Een AI-app die we hebben ontwikkeld, maakt gebruik van deep learning en beeldherkenning om huidaandoeningen snel te beoordelen en op basis van foto’s een voorlopige diagnose te stellen.
30 ondersteunde dermatologische aandoeningen
Het ontwikkelen van een AI-systeem voor patiëntmonitoring op afstand
We hebben een app voor wondverzorging ontwikkeld als onderdeel van de software voor patiëntmonitoring op afstand en een AI-gestuurde analyse geïmplementeerd voor een nauwkeurige beoordeling.
2-traps systeem voor gebruikersrollen
100% naleving van de systeemvoorschriften
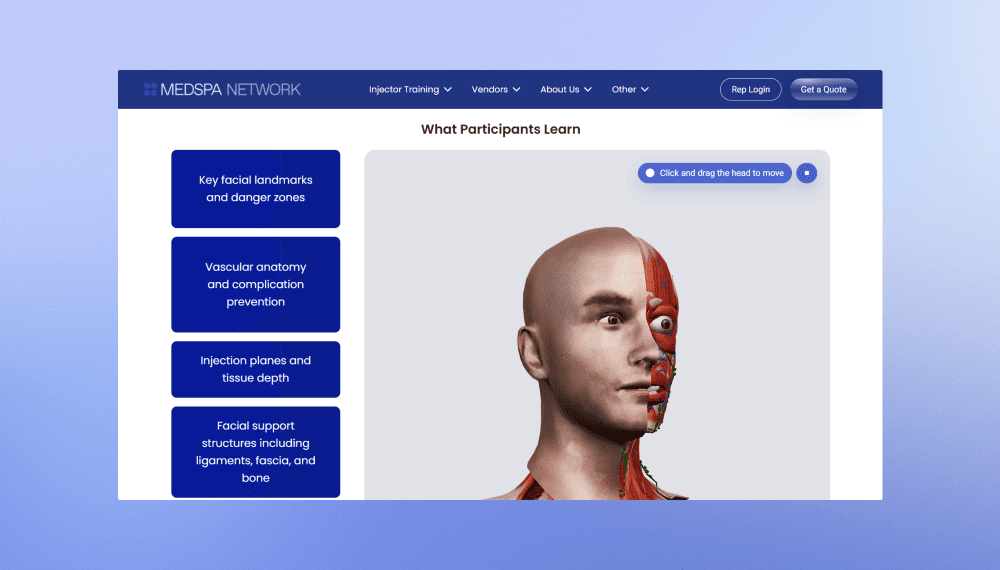
Herontwerp en heropbouw van de website van MedSpa Network
Innowise heeft de website van MedSpa Network opnieuw opgebouwd in WordPress, waardoor het team nu zelf de dagelijkse inhoudsupdates kan beheren.
2 maanden vanaf de start tot de lancering
3-5 leads per week, een stijging ten opzichte van 1 per maand
Bekijk de casestudy
Beoordeling door een klant
Bekijk de casestudy
Client review logo. Beoordeling door een klant
MedSpa Network website redesign and rebuild.
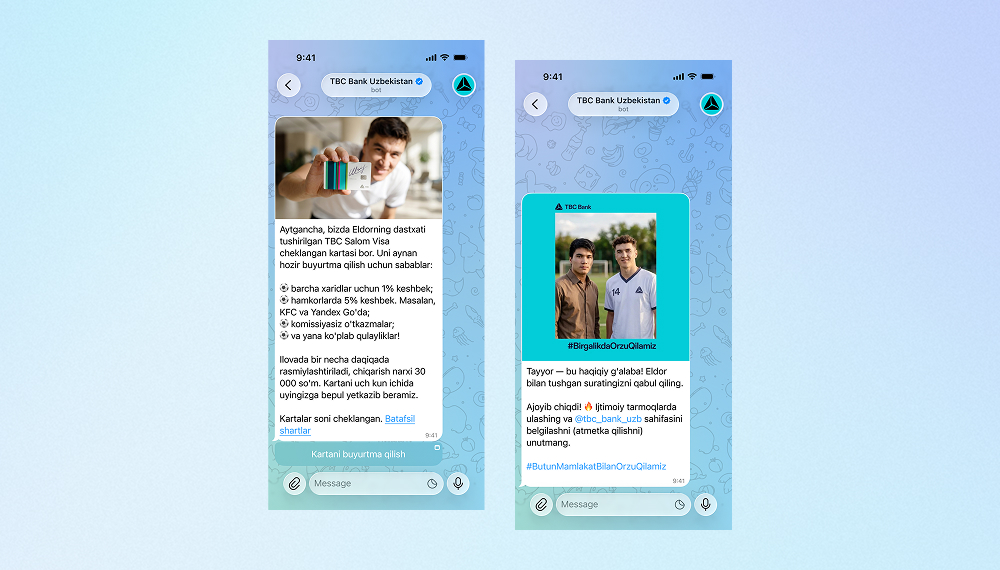
AI-bot voor de marketingcampagne van TBC Bank
Innowise heeft een tweetalige Telegram-bot ontwikkeld die met behulp van AI selfies genereert met de voetbalster die als merkambassadeur voor TBC Bank optreedt.
3,000 betrokken gebruikers
2 ondersteunde talen
Bekijk de casestudy
Beoordeling door een klant
Bekijk de casestudy
Client review logo. Beoordeling door een klant
AI Telegram bot..
Het vaststellen van de productstrategie voor het bitcoin-uitleenplatform van Bitlendex
Innowise heeft voor Bitlendex een verkenningsfase uitgevoerd en de klant daarbij geholpen om een productconcept in een vroeg stadium om te zetten in een gevalideerd bedrijfsmodel en een duidelijk omschreven MVP.
1 maand voor een uitgebreide verkenningsfase
Financieel adviessysteem voor Bonnfinanz
Innowise heeft Bonnfinanz geholpen bij het opzetten van een webgebaseerd advies- en administratiesysteem dat mobiel werken en directe interactie met de klant ondersteunt.
Laadplatform voor elektrische voertuigen met flexibele facturering
Innowise heeft bijgedragen aan de modernisering van het e-mobiliteitsplatform van SMART/LAB door de functionaliteiten op het gebied van facturering, betalingen, transactiebeheer en rapportage te verbeteren.
>50% snellere facturering en betalingsverwerking
Cloud-native DevOps-transformatie van FinXP
Innowise heeft FinXP geholpen bij het moderniseren van zijn infrastructuur voor financiële diensten door verouderde, op PHP gebaseerde API’s en applicaties te migreren naar een cloud-native architectuur.
11 apps verplaatst naar Azure App Service
100% Infrastructuur als code
01 / 01
Close popup icon

Conclusie

In 2026 wordt er meer aandacht besteed aan herbruikbare modellen, betere representaties, kleinere inferentievoetafdrukken, monitoring, kalibratie en het uitzoeken wat er gebeurt zodra een model gegevens tegenkomt die niet in de trainingsset zaten.

Dat is waarschijnlijk de nuttige verschuiving om in gedachten te houden. Een nieuwere aanpak is alleen beter als deze past bij het probleem, de gegevens, de infrastructuur en de manier waarop het model zal worden gebruikt. Als een ouder model net zo goed presteert en gemakkelijker te draaien is, houd dan het oudere model aan. Als een basismodel weken aan training bespaart, gebruik het dan. Als geen van beide een goede pilot doorstaat, ga dan verder.

De trend zelf is nooit de reden.

Als u aan het evalueren bent welke ML-benaderingen zinvol zijn voor een echt product of een echte workflow, kan ons machine learning-advies team u helpen met de architectuur, modelkeuze, validatie en implementatie.

FAQ

Machine learning (ML) is een tak van kunstmatige intelligentie (AI) waarbij modellen patronen uit gegevens leren en deze gebruiken om voorspellingen te doen of beslissingen te nemen, zonder dat elke regel handmatig hoeft te worden vastgelegd.

In de praktijk kan dat betekenen: het voorspellen van de vraag, het opsporen van fraude, het inschatten van risico’s, het aanbevelen van producten, het opsporen van defecten of het voorspellen wanneer apparatuur waarschijnlijk defect zal raken.

AI is de overkoepelende categorie. Machine learning is een manier om AI-systemen te ontwikkelen door te leren van gegevens. Deep learning is een onderdeel van machine learning dat is gebaseerd op neurale netwerken met vele lagen.

De relatie is dus vrij eenvoudig: deep learning valt onder machine learning, en machine learning valt onder AI.

Absoluut.

Gradient boosting, random forests, logistische regressie en andere beproefde methoden blijven voor veel problemen met gestructureerde gegevens een uitstekende keuze. Ze kunnen sneller, goedkoper en gemakkelijker uit te leggen zijn dan nieuwere deep-learning-benaderingen.

Een model raakt niet uit de mode alleen omdat er een modieuzer model bestaat.

Meestal zijn het de saaie dingen: slechte gegevenskwaliteit, ontbrekende labels, een zwakke infrastructuur, onduidelijkheid over de verantwoordelijkheid, privacybeperkingen, integratieproblemen en te weinig mensen die zowel het model als het bijbehorende bedrijfsproces begrijpen.

Er is nog iets anders: soms zorgt het voorgestelde ML-systeem niet voor voldoende verbetering van het bestaande proces om de inspanning te rechtvaardigen.

Dat is het waard om daar vroeg achter te komen.

AutoML kan bepaalde aspecten van modelselectie, het afstemmen van hyperparameters, featureverwerking, ensembling en experimenteren voor zijn rekening nemen.

Mensen moeten nog steeds bepalen wat het model moet voorspellen, of de gegevens kloppen, welke fouten het belangrijkst zijn, hoe het succes moet worden gemeten en of het uiteindelijke systeem veilig en bruikbaar genoeg is om in gebruik te nemen.

AutoML kan experimenten uitvoeren. Het kan echter niet bepalen of het de moeite waard was om het experiment uit te voeren.

Machine learning op het apparaat zelf is zinvol wanneer latentie een rol speelt, de verbinding onbetrouwbaar is, de bandbreedte beperkt is of wanneer gevoelige gegevens lokaal moeten blijven.

De keerzijde is de hardware. Kleinere apparaten hebben strengere beperkingen wat betreft geheugen, rekenkracht en energieverbruik, waardoor modellen meestal moeten worden gecomprimeerd of op andere manieren geoptimaliseerd voordat ze daar soepel kunnen draaien.

Voor de meeste bedrijven geldt: nee.

Kwantummachine learning is nog grotendeels een onderzoeksonderwerp. Er worden experimenten uitgevoerd op het gebied van optimalisatie, kwantumkernels en hybride kwantum-klassieke modellen, maar conventionele machine learning blijft veel praktischer voor gewone productiesystemen in 2026.

Als iemand vandaag de dag kwantum-ML zou voorstellen voor een alledaags prognoseprobleem, zou ik eerst vragen wat het reguliere model precies niet heeft kunnen doen.

Alles tonen

Inhoudsopgave

Zet ML aan het werk

    Contacteer ons

    Boek een gesprek of vul het onderstaande formulier in en we nemen contact met u op zodra we uw aanvraag hebben verwerkt.

    Stuur ons een spraakbericht
    Documenten bijvoegen
    Bestand uploaden

    Je kunt 1 bestand van maximaal 2 MB bijvoegen. Geldige bestandsformaten: pdf, jpg, jpeg, png.

    Door op ‘Stuur’ te klikken, stemt u ermee in dat Innowise uw persoonsgegevens verwerkt volgens ons privacybeleid om u van relevante informatie te voorzien. Door uw telefoonnummer op te geven, gaat u ermee akkoord dat we contact met u opnemen via telefoongesprekken, sms en messaging-apps. Voor bellen, berichten en dataverbruik kunnen kosten in rekening worden gebracht.

    U kunt ons ook uw verzoek sturen
    naar contact@innowise.com
    Wat gebeurt er nu?
    1

    Zodra we uw aanvraag hebben ontvangen en verwerkt, nemen we contact met u op om de details van uw projectbehoeften te bespreken en tekenen we een NDA om vertrouwelijkheid te garanderen.

    2

    Na het bestuderen van uw wensen, behoeften en verwachtingen zal ons team een projectvoorstel opstellen met de omvang van het werk, de teamgrootte, de tijd en de geschatte kosten.

    3

    We zullen een afspraak met u maken om het aanbod te bespreken en de details vast te leggen.

    4

    Tot slot tekenen we een contract en gaan we meteen aan de slag met uw project.

    Meer diensten die we aanbieden

    arrow