Trender inom maskininlärning 2026: tekniska förändringar och deras inverkan på verksamheten

12 november 2026 17 min läsning
Chef för avdelningarna för big data, AI/ML/DS
Verifierad expert
Varje artikel på Innowise är skriven av författare med praktisk erfarenhet. De har en förståelse för ämnet som sträcker sig bortom teorin och bidrar med insikter från verkliga projekt.
11+ års erfarenhet
Verifierad expert
11+ års erfarenhet
Philip bygger datainfrastrukturer som skapar tydlighet. Han fokuserar på "varför" bakom data och designar system som omvandlar enorma volymer till användbara insikter, samtidigt som han ser till att den tekniska visionen förblir tydlig och målinriktad.
Expertis
Big data AI & ML Python
Låt oss prata

Viktiga punkter

  • ML år 2026 blir allt mer praktiskt tillämpbart. En stor del av framstegen handlar om återanvändning, effektivitet, övervakning, kalibrering och att göra det enklare att köra modeller i produktion.
  • Förtränade och självövervakade modeller förändrar i vilken utsträckning man behöver bygga upp allt från grunden. Tabellbaserade grundmodeller, återanvändbara visuella representationer och syntetiska träningsdata kan minska en del av det vanliga arbetet med träning och märkning.
  • Driftsbegränsningar är viktigare än att vinna jämförelsetester. Latens, minnesanvändning, energiförbrukning, avvikelser, prestanda i undergrupper och inferenskostnad kan vara viktigare än att pressa fram ytterligare en bråkdel av en procent i noggrannhet.
  • Samma trender förändrar helt olika arbetsflöden. Inom detaljhandeln märks det i prognoser och rekommendationer; inom bankväsendet i bedrägeri- och kreditriskhantering; inom hälso- och sjukvården i prioritering av patienter; inom tillverkningsindustrin i förebyggande underhåll och felupptäckt; inom logistiken i beräknade ankomsttider och förutsägelser om förseningar.
  • Några lovande områden befinner sig fortfarande i ett mycket tidigt utvecklingsskede. Kontinuerligt lärande, kausalt maskininlärning, hybridmodeller, domänöverskridande anpassning och osäkerhetsmedveten prognostisering verkar alla vara användbara, men jag skulle skilja på vad som redan har visats fungera och vad som är klart för implementering.
Sammanfatta artikeln med AI

Maskininlärning är tråkigt nuförtiden. Det är trenden.

Eller åtminstone sker många av de intressanta framstegen på områden som inte ger särskilt bra rubriker: att korta ned inferenstiden med 40 millisekunder, träna med färre etiketter, återanvända en modell istället för att bygga en ny, ta reda på varför ett system med 96 % träffsäkerhet hela tiden misslyckas med samma grupp användare.

Och det här är förmodligen goda nyheter. Jag tror att de flesta företag egentligen inte behöver något stort genombrott inom maskininlärning. De skulle gärna se en bra modell som fortsätter att fungera när data förändras, som inte kostar en förmögenhet att driva och som ger en varning när den börjar bete sig konstigt.

Låt oss därför titta på de senaste trenderna inom maskininlärning för att se vart utvecklingen är på väg.

Sätt ML i arbete

Översikt och prognos för marknaden för maskininlärning

Marknaden för maskininlärning växer snabbt. Men ingen är helt överens om hur stor den egentligen är.

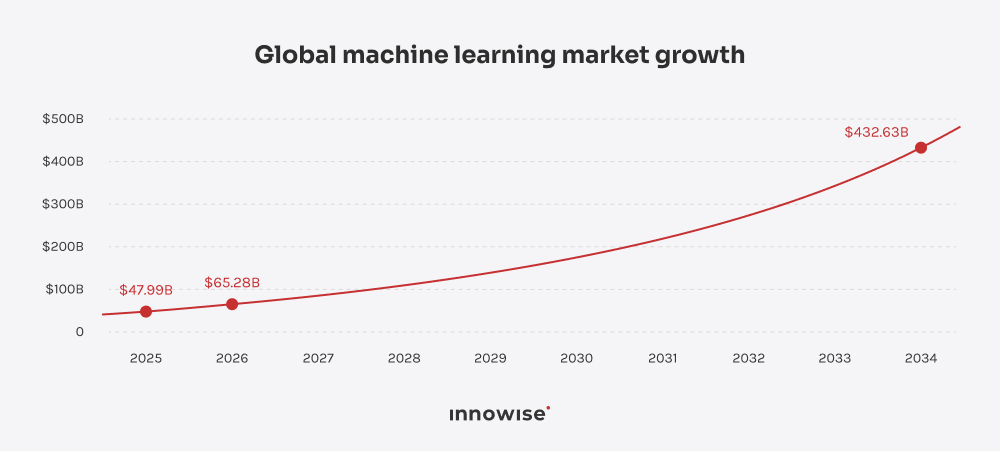
Fortune Business Insights uppskattar den globala marknaden för maskininlärning till 65,28 miljarder dollar år 2026 och förväntar sig att den ska nå 432,63 miljarder dollar år 2034. The Business Research Company ger en betydligt högre uppskattning för samma år: 127,94 miljarder dollar år 2026, vilket stiger till 445,25 miljarder dollar år 2030.

Global machine learning market growth 2025-2034.

Det är nästan en fördubbling till 2026. Framför allt visar det att “marknaden för maskininlärning” är en förvånansvärt elastisk kategori: olika analytiker inkluderar olika kombinationer av programvara, infrastruktur, tjänster och hårdvara.

Detaljerna i prognoserna är också användbara. Fortune förväntar sig att molnbaserade lösningar ska stå för 53,14 % av ML-marknaden år 2026, där stora företag står för 55,61 % och IT och telekom står för 17,56 % av slutanvändningen.

Samtidigt Gartner förväntar sig att utgifterna för AI-plattformar för datavetenskap och maskininlärning ska uppgå till 26,44 miljarder dollar år 2026, en ökning med 36,3 % jämfört med 2025.

Så jag skulle inte fästa för mycket vikt vid en enskild enorm siffra. Det viktiga är riktningen: utgifterna ökar, molnet står för en stor andel av implementeringarna och verktygen kring maskininlärning håller på att bli en betydande marknad i sig.

Låt oss nu titta på de senaste trenderna inom maskininlärning i sig.

Aktuella trender inom maskininlärning

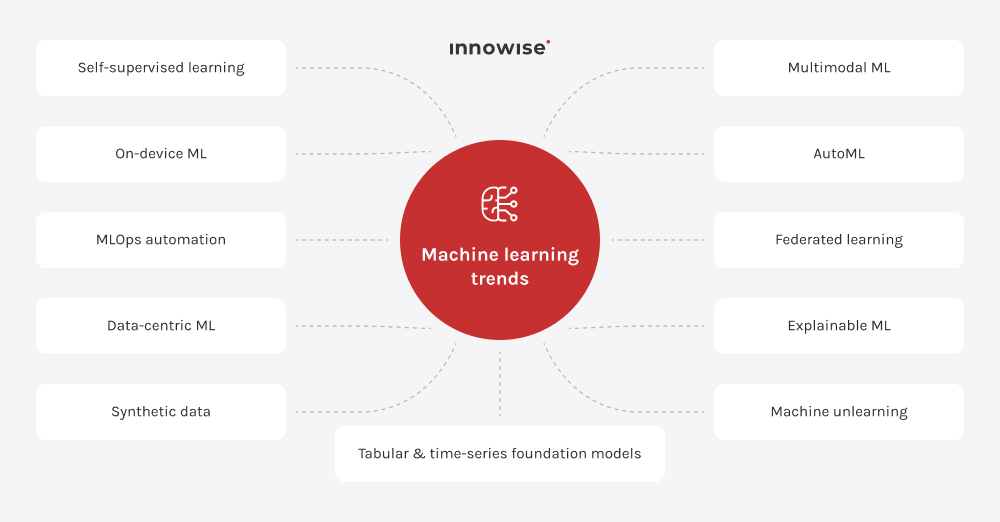
Vissa av de främsta trenderna inom maskininlärning är nya. Andra har funnits i flera år och börjar först nu bli tillräckligt praktiskt användbara för att spridas utanför forskarteamen. Ärligt talat är jag mer intresserad av den andra gruppen, men hur som helst – låt oss dyka in i ämnet.

Key machine learning trends this year.

Grundläggande modeller för tabelldata och tidsserier

Tabeller upplever just nu sin "foundation-model"-våg.

I juni 2026 introducerade Google TabFM, en modell för tabellbaserad klassificering och regression som kan göra förutsägelser om nya datamängder utan den vanliga omgången av uppgiftsspecifik träning och hyperparameterjustering. Google testade den på 38 klassificerings- och 13 regressionsdatauppsättningar, inklusive tabeller med upp till 150 000 exempel.

Vad är det som är så intressant med den? Det är hur den tränades. Det finns inget gigantiskt offentligt lager med rena företagstabeller, så Google genererade istället hundratals miljoner syntetiska datamängder.

Jag skulle inte ta bort XGBoost just ännu. För många problem med strukturerade data är konventionella modeller fortfarande billigare, enklare att felsöka och mycket svåra att slå. Men tanken på att öppna en ny datamängd och få en hyfsad baslinje utan ännu ett maratonlopp av finjusteringar är ganska lockande.

Och tidsserier går i samma riktning. Googles TimesFM är förtränad på stora samlingar av tidsseriedata och kan producera zero-shot-prognoser för datamängder den inte har sett tidigare. Fördelen är liknande den med TabFM: mindre uppgiftsspecifik träning varje gång någon behöver en ny prognos för efterfrågan, trafik eller kapacitet.

Skulle jag ersätta alla befintliga prognospipelines med den här modellen? Nej. Men det är värt att testa när alternativet är ytterligare en omgång med modellträning och finjustering från grunden.

Självstyrt lärande kräver färre etiketter

Att märka upp data är en av de uppgifter som alla är överens om är nödvändiga, men som ingen gärna vill betala för.

Självövervakad inlärning kringgår en del av det problemet genom att först lära sig användbara representationer från omärkta data och sedan anpassa dem till en mindre uppsättning märkta data.

Metas DINOv3 är ett bra exempel. Den tränades på 1,7 miljarder bilder utan mänskliga etiketter, och den största modellen nådde 7 miljarder parametrar. Samma frysta visuella grundstruktur kan sedan stödja uppgifter som klassificering, objektdetektering, segmentering och spårning.

För företag som sitter på år av omärkta inspektionsfoton, satellitbilder, medicinska bilder eller video förändrar detta ekonomin något. Du kanske fortfarande behöver märkningar. Men kanske inte flera miljoner av dem.

De mindre modellerna börjar bli intressanta igen

En vacker modell som kräver ett datacenter för att besvara en enkel fråga har begränsad attraktionskraft på en telefon, en sensor, en kamera eller en industriell styrenhet.

Därför får modellkomprimering allt mer uppmärksamhet: kvantisering minskar den numeriska precisionen, beskärning tar bort mindre användbara vikter och destillering överför kunskap till en mindre modell. TensorFlows eget optimeringsverktyg listar latens, minnesanvändning, strömförbrukning och modellstorlek som centrala begränsningar för edge-distribution.

Det finns inga gratis luncher här. Komprimerar man för aggressivt sjunker noggrannheten.

Uppgiften är att hitta den punkt där ingen märker något, förutom på infrastrukturkostnaden.

MLOps blir allt mindre valfritt

Att träna modellen var aldrig hela uppgiften. Vi ägnade bara förvånansvärt mycket tid åt att låtsas att det var så.

När ett ML-system väl är i drift måste någon veta vilken dataset som genererade det, vilken kodversion som tränade det, om indata har ändrats, om prestandan avviker, när omskolning är tillåten och hur man återställer en felaktig release.

Verktygen speglar detta. MLflow 3, till exempel, utökade sin arkitektur för modellhantering med fokus på tydligare spårbarhet och jämförelser mellan modellversioner och experiment.

Detta är förmodligen en av de minst glamorösa trenderna inom maskininlärning på listan, men också en av de jag skulle ta allvarligast.

Syntetiska data utsätts för en verklighetskontroll

Syntetiska data låter fantastiskt praktiskt. Saknar du exempel? Skapa några själv.

Det kan fungera. Det kan också göra att en modell blir väldigt bra på att förstå en artificiell värld som inte riktigt existerar.

En forskningsrapport från Apple från 2026 undersökte blandningen av verkliga och syntetiska träningsdata och fann något mer användbart än att “syntetiska data hjälper”. Deras resultat tyder på att det kan finnas ett optimalt förhållande: om man lägger till syntetiska data förbättras prestandan upp till en viss punkt, men börjar sedan försämras när de syntetiska och verkliga fördelningarna skiljer sig för mycket åt.

Multimodal maskininlärning tar steget in i den vanliga prognosverksamheten

"Multimodal" behöver inte betyda en modell som kan diskutera din bild och skriva en dikt om den.

När det gäller prediktiv maskininlärning kan det vara mycket mindre spännande och mycket mer användbart: produktbild + beskrivning + pris, medicinsk skanning + patientjournal, sensoravläsningar + underhållsanteckningar.

De nuvarande AutoGluon-verktygen, till exempel, kan kombinera bild-, text-, tabell- och dokumentdata för uppgifter som klassificering och regression.

Det besvärliga kommer senare. Vad händer när bilden saknas? Eller när sensorn slutar fungera? Eller när en datakälla anländer två timmar senare än de andra?

Det måste ingå i utvärderingen, inte vara en överraskning som upptäcks efter lanseringen.

AutoML tar hela tiden bort de tråkiga delarna

Modellval, hyperparameterjustering, ensembling, delar av databehandlingen: mycket av detta går redan att automatisera ganska bra.

Bra.

Jag är inte övertygad om att en högavlönad ML-ingenjör behöver ägna en eftermiddag åt att manuellt testa 47 kombinationer av inlärningshastighet och träddjup bara för att bevisa sitt engagemang för yrket.

Det som AutoML inte automatiserar särskilt bra är att avgöra om målet är rimligt, om träningsdata avslöjar information om framtiden, om utvärderingsmåttet återspeglar affärskostnaden eller om modellen överhuvudtaget bör existera.

Dessa förblir besvärligt mänskliga problem.

Federerat lärande innebär fortfarande inte integritetsskydd

Federerat lärande har en mycket tilltalande uppbyggnad: man kan träna modeller över flera enheter eller organisationer utan att behöva flytta all rådata till en central databas.

Praktiskt, ja. Automatiskt privat? Nej.

NIST har dokumenterat attacker som kan återställa information från modelluppdateringar som utbyts under federerad träning, och rekommenderar ytterligare skyddsåtgärder istället för att betrakta decentraliseringen i sig som en garanti för integriteten.

Och verkliga implementeringar är kaotiska. Olika enheter har olika beräkningskapacitet, deltagare försvinner, datadistributionen varierar och säkerhetsantaganden bryts. NIST:s implementeringsöversyn från 2024 belyser ganska tydligt klyftan mellan den snygga teorin om federerat lärande och produktionssystemen.

En expert som citeras där, dr Mat Weldon från Storbritanniens Office for National Statistics, uttryckte det bättre än jag kan:

“Det är lättare att utforma en ny arkitektur för federerat lärande än att utföra en red team-analys av den.”

Rimligt.

Förklarbarheten blir mindre formell

I åratal kunde man genom att lägga till ett SHAP-diagram i en översiktspanel få en modell att kännas tillfredsställande “förklarbar”.

Det är en låg ribba.

NIST skiljer mellan förklarbarhet, det vill säga att förstå hur ett system kom fram till ett resultat, och tolkningsbarhet, det vill säga vad resultatet betyder i sitt sammanhang. I sina riktlinjer rekommenderar man också att man testar förklaringsmetoderna innan de tas i bruk, istället för att utgå från att förklaringen är korrekt bara för att diagrammet ser övertygande ut.

NIST-forskare publicerade en studie år 2026 om förklarbar validering och funktionsreduktion, vilket är intressant eftersom det för förklarbarheten närmare modelltestningen istället för att lämna den som ett lager som läggs till i efterhand.

Jag gillar den inriktningen. En förklaring bör vara något vi testar, inte en dekoration för modellkortet.

Att få maskiner att glömma vad de lärt sig blir en verklig teknisk utmaning

Anta att någon ber dig att radera sina uppgifter.

Du raderar posten i databasen.

Okej.

Men hur blir det med modellen som redan har tränats på den?

Det är där maskinavlärning kommer in: att ta bort påverkan från specifika träningsdata utan att behöva träna om hela modellen från grunden. I juni 2026 publicerade Google Research ett ramverk för att granska om en avlärd modell verkligen beter sig mer som en nyligen omskolad modell än den ursprungliga.

Och den andra delen är viktig. Att glömma något är ett problem. Att bevisa att modellen har glömt det är ett annat.

Maskinell avlärning ligger fortfarande mycket närmare aktiv forskning än rutinmässiga verktyg för företag, men jag skulle hålla ett öga på det. I det ögonblick då “radera mina data” måste betyda mer än att radera en rad, upphör detta att vara teoretiskt.

Skapa en ML-lösning för ditt företag

Hur trenderna inom maskininlärning förändrar arbetsflödena inom olika branscher

Samma ML-trend kan fungera på helt olika sätt när den väl integreras i ett verkligt arbetsflöde. Inom detaljhandeln kan snabbare inferens innebära att rekommendationerna uppdateras medan kunden fortfarande tittar på varor. Inom tillverkningsindustrin kan det innebära att man upptäcker ett fel innan produkten hunnit vidare i produktionslinjen.

  • Utbildning
  • Detaljhandel och e-handel
  • Bank och finans
  • Vård
  • Tillverkning
  • Logistik och transport

Utbildning

Utbildningsplattformar har redan tillgång till stora mängder data: svar, försök, svarstider, hoppade uppgifter och kursframsteg. Det svåra är att omvandla detta till något användbart utan att låtsas att en modell förstår en elev bättre än en lärare gör.

Maskininlärning var redan den det största tekniksegmentet på marknaden för AI inom utbildning år 2025, där resultatuppföljning, anpassning och intelligent handledning är några av de viktigaste tillämpningarna.

  • Anpassa träningens svårighetsgrad och ordningsföljd utifrån tidigare resultat istället för att tvinga alla att följa samma väg.
  • Förutsäga risken för avhopp från mönster som till exempel minskande deltagande, upprepade misslyckanden eller långa uppehåll mellan tillfällena.
  • Upptäck kunskapsluckor i ett tidigare skede och se över schemat innan eleven går vidare till nästa ämne helt oförberedd.
Detaljhandel och e-handel

Detaljhandeln har använt maskininlärning i flera år, men de intressanta förändringarna sker när det gäller hastighet och datavariation. Prognoser kan uppdateras oftare, rekommendationer kan baseras på mer än bara köphistorik, och visuell sökning kan kombinera bilder med produktbeskrivningar och katalogdata.

  • Prognosera efterfrågan och automatisera påfyllningen med hjälp av försäljningshistorik, säsongsvariationer, kampanjer och färskare operativa data.
  • Anpassa rekommendationerna utifrån kundernas surf- och köpbeteende snarare än utifrån statiska kundsegment.
  • Förbättra produktsökningen genom att kombinera text- och bilddata, vilket är användbart när kunden inte vet vad varan heter men har en bild på den.

Bank och finans

Inom bankväsendet är det svårt att bortse från modellövervakning, förklarbarhet och avvikelser. Bedrägerimönstren förändras, kundernas beteende förändras, och en modell som verkade fungera bra för sex månader sedan kan mycket snabbt bli mycket kostsam.

Den globala machine learning in banksektorn marknaden uppgick till cirka 40 miljarder dollar år 2025 och beräknas uppgå till cirka 150 miljarder dollar fram till 2034, enligt Fortune Business Insights.

  • Upptäcka misstänkta transaktioner och rangordna ärendena så att utredarna börjar med de som verkar mest riskfyllda.
  • Förklara kreditbeslut genom att visa vilka faktorer som hade störst inverkan på poängen.
  • Övervaka modellavvikelser i takt med att bedrägerimetoder, konsumtionsbeteenden och kundprofiler förändras.

Vård

Hälso- och sjukvården är ett av de områden där ett bra jämförelsetal inte på långa vägar räcker till. Modellerna kan fungera olika beroende på sjukhus, patientgrupper, utrustning och kliniska miljöer, så kalibrering och övervakning är lika viktiga som rådata prediktiv prestanda.

Den globala marknaden för prediktiv analys inom hälso- och sjukvården uppskattas till 19,7 miljarder dollar år 2026 av Grand View Research, som räknar med att den kommer att nå 49,3 miljarder dollar fram till 2033.

  • Upptäcka tidiga tecken på försämring, inklusive risken för sepsis, innan situationen blir kliniskt uppenbar.
  • Förutsäga risken för återinläggning och prioritera uppföljningen av de patienter som har större sannolikhet att återkomma.
  • Prioritera ärenden för granskning så att vårdpersonalen kan rikta sin uppmärksamhet mot de områden där den förväntade risken är som högst.

Tillverkning

Tillverkningsindustrin är förmodligen det tydligaste exemplet för maskininlärning på enheten. Om en kamera övervakar delar som rör sig längs en produktionslinje är det ofta inte särskilt meningsfullt att skicka varje bild till molnet och vänta på ett svar.

Den bredare marknaden för AI inom tillverkningsindustrin uppskattas till 9,85 miljarder dollar år 2026, där maskininlärning och datorseende används för förebyggande underhåll, inspektion, kvalitetskontroll och produktionsplanering.

  • Förutse fel på utrustning baserat på vibrationer, temperatur, tryck och underhållshistorik.
  • Upptäcka fel med datorseende medan produkten fortfarande befinner sig på produktionslinjen.
  • Förutsäga produktkvaliteten från tillverkningsparametrarna före slutkontrollen.

Logistik och transport

Logistiken är full av prognosproblem, vilket gör den till en naturlig tillämpningsområde för maskininlärning: ankomsttider, förseningar, efterfrågan i lager, trafik, ruttändringar, missade anslutningar.

Framtiden Marknaden för maskininlärning inom logistik beräknas uppgå till 5,3 miljarder dollar år 2026 och beräknas nå 44,5 miljarder dollar fram till 2035, enligt Globala marknadsinsikter.

Även här spelar osäkerheten en roll. “Beräknad ankomsttid 14:10” och “Beräknad ankomsttid 14:10, men vi är faktiskt inte säkra” är två helt olika uppgifter för någon som väntar vid en lastkaj.

  • Beräkna ankomsttider med hjälp av historiska förseningar, trafikförhållanden och fordonens aktuella positioner.
  • Förväntade leveransförseningar i god tid för att kunna anpassa lager- eller leveransplanerna.
  • Beräkna restid och efterfrågan för att underlätta ruttplanering och fordonsfördelning.

Utbildning

Utbildningsplattformar har redan tillgång till stora mängder data: svar, försök, svarstider, hoppade uppgifter och kursframsteg. Det svåra är att omvandla detta till något användbart utan att låtsas att en modell förstår en elev bättre än en lärare gör.

Maskininlärning var redan den det största tekniksegmentet på marknaden för AI inom utbildning år 2025, där resultatuppföljning, anpassning och intelligent handledning är några av de viktigaste tillämpningarna.

  • Anpassa träningens svårighetsgrad och ordningsföljd utifrån tidigare resultat istället för att tvinga alla att följa samma väg.
  • Förutsäga risken för avhopp från mönster som till exempel minskande deltagande, upprepade misslyckanden eller långa uppehåll mellan tillfällena.
  • Upptäck kunskapsluckor i ett tidigare skede och se över schemat innan eleven går vidare till nästa ämne helt oförberedd.

Detaljhandel och e-handel

Detaljhandeln har använt maskininlärning i flera år, men de intressanta förändringarna sker när det gäller hastighet och datavariation. Prognoser kan uppdateras oftare, rekommendationer kan baseras på mer än bara köphistorik, och visuell sökning kan kombinera bilder med produktbeskrivningar och katalogdata.

  • Prognosera efterfrågan och automatisera påfyllningen med hjälp av försäljningshistorik, säsongsvariationer, kampanjer och färskare operativa data.
  • Anpassa rekommendationerna utifrån kundernas surf- och köpbeteende snarare än utifrån statiska kundsegment.
  • Förbättra produktsökningen genom att kombinera text- och bilddata, vilket är användbart när kunden inte vet vad varan heter men har en bild på den.

Bank och finans

Inom bankväsendet är det svårt att bortse från modellövervakning, förklarbarhet och avvikelser. Bedrägerimönstren förändras, kundernas beteende förändras, och en modell som verkade fungera bra för sex månader sedan kan mycket snabbt bli mycket kostsam.

Den globala machine learning in banksektorn marknaden uppgick till cirka 40 miljarder dollar år 2025 och beräknas uppgå till cirka 150 miljarder dollar fram till 2034, enligt Fortune Business Insights.

  • Upptäcka misstänkta transaktioner och rangordna ärendena så att utredarna börjar med de som verkar mest riskfyllda.
  • Förklara kreditbeslut genom att visa vilka faktorer som hade störst inverkan på poängen.
  • Övervaka modellavvikelser i takt med att bedrägerimetoder, konsumtionsbeteenden och kundprofiler förändras.

Vård

Hälso- och sjukvården är ett av de områden där ett bra jämförelsetal inte på långa vägar räcker till. Modellerna kan fungera olika beroende på sjukhus, patientgrupper, utrustning och kliniska miljöer, så kalibrering och övervakning är lika viktiga som rådata prediktiv prestanda.

Den globala marknaden för prediktiv analys inom hälso- och sjukvården uppskattas till 19,7 miljarder dollar år 2026 av Grand View Research, som räknar med att den kommer att nå 49,3 miljarder dollar fram till 2033.

  • Upptäcka tidiga tecken på försämring, inklusive risken för sepsis, innan situationen blir kliniskt uppenbar.
  • Förutsäga risken för återinläggning och prioritera uppföljningen av de patienter som har större sannolikhet att återkomma.
  • Prioritera ärenden för granskning så att vårdpersonalen kan rikta sin uppmärksamhet mot de områden där den förväntade risken är som högst.

Tillverkning

Tillverkningsindustrin är förmodligen det tydligaste exemplet för maskininlärning på enheten. Om en kamera övervakar delar som rör sig längs en produktionslinje är det ofta inte särskilt meningsfullt att skicka varje bild till molnet och vänta på ett svar.

Den bredare marknaden för AI inom tillverkningsindustrin uppskattas till 9,85 miljarder dollar år 2026, där maskininlärning och datorseende används för förebyggande underhåll, inspektion, kvalitetskontroll och produktionsplanering.

  • Förutse fel på utrustning baserat på vibrationer, temperatur, tryck och underhållshistorik.
  • Upptäcka fel med datorseende medan produkten fortfarande befinner sig på produktionslinjen.
  • Förutsäga produktkvaliteten från tillverkningsparametrarna före slutkontrollen.

Logistik och transport

Logistiken är full av prognosproblem, vilket gör den till en naturlig tillämpningsområde för maskininlärning: ankomsttider, förseningar, efterfrågan i lager, trafik, ruttändringar, missade anslutningar.

Framtiden Marknaden för maskininlärning inom logistik beräknas uppgå till 5,3 miljarder dollar år 2026 och beräknas nå 44,5 miljarder dollar fram till 2035, enligt Globala marknadsinsikter.

Även här spelar osäkerheten en roll. “Beräknad ankomsttid 14:10” och “Beräknad ankomsttid 14:10, men vi är faktiskt inte säkra” är två helt olika uppgifter för någon som väntar vid en lastkaj.

  • Beräkna ankomsttider med hjälp av historiska förseningar, trafikförhållanden och fordonens aktuella positioner.
  • Förväntade leveransförseningar i god tid för att kunna anpassa lager- eller leveransplanerna.
  • Beräkna restid och efterfrågan för att underlätta ruttplanering och fordonsfördelning.
Den modell som vinner jämföretestet är inte alltid den jag skulle välja för produktion. När man tar hänsyn till fördröjning, infrastrukturkostnader, avvikelser och underhåll kan en något mindre exakt modell lätt bli det bättre tekniska valet.

Framtida trender inom maskininlärning

Vissa idéer inom maskininlärning är redan användbara idag. Andra behöver fortfarande bättre jämförelsetester, billigare datorkraft eller några obehagliga erfarenheter i produktionsmiljön innan jag skulle kalla dem färdiga.

Detta är de nya trenderna inom maskininlärning som jag skulle fortsätta att hålla ett öga på.

  • Cross-domain generalization and adaptation icon.

    Generalisering och anpassning mellan olika domäner

    Ett av de äldsta problemen inom maskininlärning är fortfarande högaktuellt: träna en modell i en miljö, flytta den till en något annorlunda miljö – och se hur prestandan försämras.

    Domän generalisering syftar till att få modeller att fungera på datadistributioner som de inte har stött på tidigare. En studie från 2026 om mönsterklassificering i okända miljöer beskriver just detta problem: förändringar i sensorer, insamlingsförhållanden eller andra domänegenskaper kan räcka för att allvarligt försämra en modell.

    Det är lätt att föreställa sig hur detta fungerar i praktiken. En bildigenkänningsmodell som tränats i en fabrik måste fungera i en annan fabrik med andra kameror. En medicinsk modell flyttas till ett annat sjukhus. En bedrägerimodell får en ny kundgrupp att analysera.

    Jag misstänker att detta kommer att bli mindre av ett forskningsområde och mer av ett grundläggande krav vid driftsättning.

  • Continual learning icon.

    Kontinuerligt lärande

    De flesta produktionsmodeller lär sig fortfarande i etapper: samla in nya data, träna om modellen, validera och driftsätt den på nytt.

    Kontinuerligt lärande syftar till en smidigare process. Modellen fortsätter att lära sig när nya data kommer in, utan att glömma det den redan visste.

    Det är just den sista delen som är haken.

    En systematisk översikt från 2026 av 189 vetenskapligt granskade artiklar om kontinuerligt lärande identifierar fortfarande katastrofalt glömska som ett av områdets centrala problem: att lära sig något nytt kan försämra prestationen vid äldre uppgifter.

    Jag skulle alltså inte ersätta schemalagd vidareutbildning med kontinuerligt lärande bara för att namnet låter bättre. Men när det gäller bedrägeriupptäckt, industriella system, rekommendationer och andra miljöer som förändras ständigt är fördelarna uppenbara.

  • Hybrid ML models icon.

    Hybridmodeller för maskininlärning

    Det är på något sätt lite lustigt att ägna år åt att försöka få neurala nätverk att lära sig allt från data, bara för att upptäcka att känd fysik fortfarande kan vara till nytta.

    Googles NeuralGCM är ett bra exempel. Modellen kombinerar maskininlärning med en fysikbaserad atmosfärsberäknare, istället för att låta endera av dem sköta hela uppgiften. I en studie publicerad i Nature genererade modellen konkurrenskraftiga väder- och klimatprognoser samtidigt som den använde tre till fem storleksordningar mindre beräkningsresurser än jämförbara konventionella modeller.

    Den tanken sträcker sig långt bortom vädret.

    Om vi redan känner till fysiska begränsningar, tekniska regler eller andra samband inom området, kan det vara mer meningsfullt att mata in dessa uppgifter i modellen än att be ett neuralt nätverk att på nytt upptäcka gravitationen utifrån ett kalkylblad.

  • Causal ML icon.

    Kausal maskininlärning

    Prognoser ger svar på frågor som:

    Vilka kunder riskerar att säga upp sitt abonnemang?

    Företag brukar vilja ställa följande fråga:

    Vem kommer att stanna kvar om vi ger dem rabatt?

    Det är en fråga om orsakssamband.

    Kausal maskininlärning kombinerar maskininlärning med kausal inferens för att uppskatta vad som kan hända vid olika ingrepp. Området används redan för att uppskatta individualiserade behandlingseffekter inom medicinen, även om forskare fortfarande varnar för att felaktiga antaganden och confounding kan leda till övertygande men felaktiga slutsatser.

    Jag tror att det här är en av de mer intressanta inriktningarna här, eftersom det förändrar syftet med modellen. Prognoser beskriver en trolig framtid. Kausal maskininlärning försöker visa om en viss handling kommer att förändra den framtiden.

    Ett betydligt svårare problem.

    Den här är mycket mer användbar.

  • Uncertainty-aware predictions icon.

    Prognoser som tar hänsyn till osäkerhet

    En modell som anger “92 % konfidens” känns betryggande.

    Det kan också vara struntprat.

    Kalibrering av osäkerhet syftar till att anpassa konfidensintervallet till den faktiska prediktiva noggrannheten. En studie som publicerades i Nature Machine Intelligence år 2026 beskriver kalibrering som avgörande för en tillförlitlig tillämpning av maskininlärning, just därför att moderna modeller kan ha hög konfidens även när de har fel.

    Förändringar i distributionen förvärrar situationen. En studie från 2026 Scientific Reports visade att prediktiva modeller kan förlora både prestanda och kalibrering när de flyttas över heterogena datamängder från den verkliga världen.

    För företag är det inte en modell som alltid ger ett svar som är det mest användbara resultatet. Ibland är den bästa modellen den som i praktiken säger: Jag är inte helt säker på det här, låt en människa ta hand om det.

    Jag skulle gärna vilja se mycket mer av det.

Behöver du hjälp med att välja rätt maskininlärningsmetod?

Nästa steg: hur företag kan tillämpa de senaste trenderna inom maskininlärningsteknik

Det sämsta sättet att använda den här listan är att välja en trend bara för att den låter aktuell och sedan leta efter ett problem som man kan koppla den till.

Börja istället med det besvärliga affärsproblemet.

01
Ange vad som behöver förbättras

Mer exakta prognoser? Färre falska bedrägerivarningar? Lägre kostnader för slutsatsdragning? Snabbare granskning? Välj först vilket resultat du vill uppnå och använd den nuvarande processen som utgångspunkt.

02
Kontrollera om uppgifterna stöder detta

Innan du jämför modeller bör du ta hänsyn till etiketter, saknade värden, åtkomsträttigheter, obalans mellan klasserna, täckning samt huruvida produktionsdata kommer att likna de data som använts för träning. Det är också här som många ML-projekt snabbt tappar sin spänning.

03
Jämför det nya med det tråkiga

Om man överväger att använda en förtränad modell, ett AutoML-system eller en multimodal arkitektur, bör man testa den mot en enklare referensmodell under samma förhållanden. Samma data, samma mätvärden, samma gränser för latens och samma affärsmål.

Om den komplicerade modellen ger ett bättre resultat med 0,3 % men kostar fyra gånger så mycket att driva, skulle jag vilja ha en mycket god anledning för att behålla den.

04
Testa det i situationer där ett misslyckande inte är ödesdigert

Använd representativa data och testa de scenarier som med störst sannolikhet kan orsaka problem: saknade indata, sällsynta klasser, ovanliga enheter, svagare kundsegment, toppbelastningar. Bestäm i förväg under vilka omständigheter du skulle avbryta pilotprojektet.

05
Tilldela modellen en ägare efter lanseringen

Någon måste hålla koll på avvikelser, fördröjning, kostnader, kalibrering, prestanda hos undergrupper samt det affärsmått som modellen var avsedd att förbättra. Man måste också besluta när modellen ska tränas om, återställas till tidigare version, bytas ut eller helt enkelt stängas av.

Och ja, ibland är den rätta slutsatsen att den nya trenden inom maskininlärning inte innebär tillräckliga förbättringar för att det ska vara motiverat att ändra något.

Det räknas också som en lyckad utvärdering.

arrow-icon.arrow-icon.
01 Ange vad som behöver förbättras

Mer exakta prognoser? Färre falska bedrägerivarningar? Lägre kostnader för slutsatsdragning? Snabbare granskning? Välj först vilket resultat du vill uppnå och använd den nuvarande processen som utgångspunkt.

arrow-icon.arrow-icon.
02 Kontrollera om uppgifterna stöder detta

Innan du jämför modeller bör du ta hänsyn till etiketter, saknade värden, åtkomsträttigheter, obalans mellan klasserna, täckning samt huruvida produktionsdata kommer att likna de data som använts för träning. Det är också här som många ML-projekt snabbt tappar sin spänning.

arrow-icon.arrow-icon.
03 Jämför det nya med det tråkiga

Om man överväger att använda en förtränad modell, ett AutoML-system eller en multimodal arkitektur, bör man testa den mot en enklare referensmodell under samma förhållanden. Samma data, samma mätvärden, samma gränser för latens och samma affärsmål.

Om den komplicerade modellen ger ett bättre resultat med 0,3 % men kostar fyra gånger så mycket att driva, skulle jag vilja ha en mycket god anledning för att behålla den.

arrow-icon.arrow-icon.
04 Testa det i situationer där ett misslyckande inte är ödesdigert

Använd representativa data och testa de scenarier som med störst sannolikhet kan orsaka problem: saknade indata, sällsynta klasser, ovanliga enheter, svagare kundsegment, toppbelastningar. Bestäm i förväg under vilka omständigheter du skulle avbryta pilotprojektet.

arrow-icon.arrow-icon.
05 Tilldela modellen en ägare efter lanseringen

Någon måste hålla koll på avvikelser, fördröjning, kostnader, kalibrering, prestanda hos undergrupper samt det affärsmått som modellen var avsedd att förbättra. Man måste också besluta när modellen ska tränas om, återställas till tidigare version, bytas ut eller helt enkelt stängas av.

Och ja, ibland är den rätta slutsatsen att den nya trenden inom maskininlärning inte innebär tillräckliga förbättringar för att det ska vara motiverat att ändra något.

Det räknas också som en lyckad utvärdering.

Tillämpningar och trender inom maskininlärning i praktiken: Innowise fallstudier

Alla fallstudier
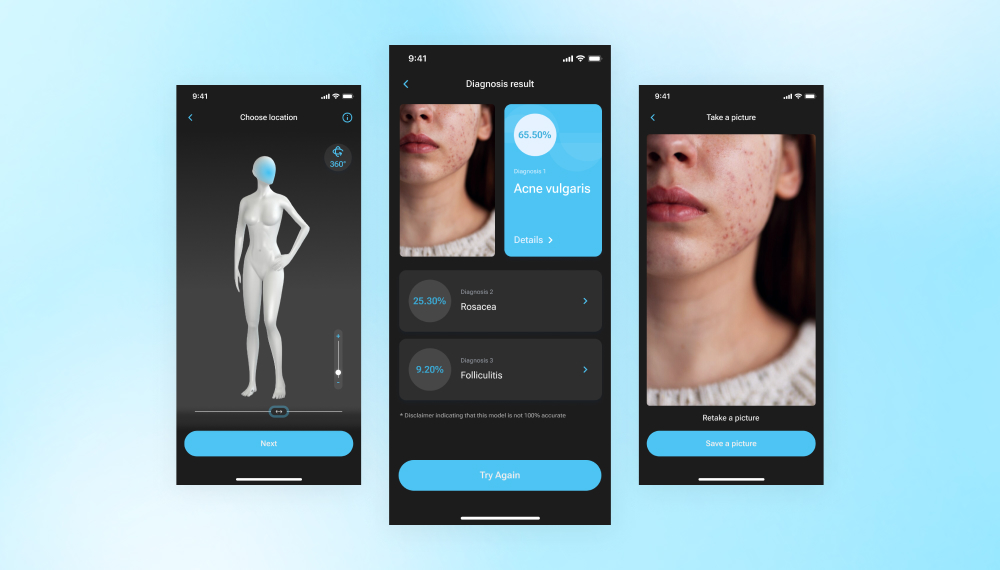
Utveckling av en app för hudskanning med AI-baserad hudläkare
En AI-app som vi har utvecklat använder djupinlärning och bildigenkänning för att snabbt bedöma hudåkommor och ställa preliminära diagnoser utifrån foton.
30 hudåkommor som behandlas
Utveckling av ett AI-baserat system för fjärrövervakning av patienter
Vi har utvecklat en app för sårvård som en del av programvaran för fjärrövervakning av patienter och implementerat en AI-driven analys för en noggrann bedömning.
2-nivå användarrollsystem
100% systemöverensstämmelse
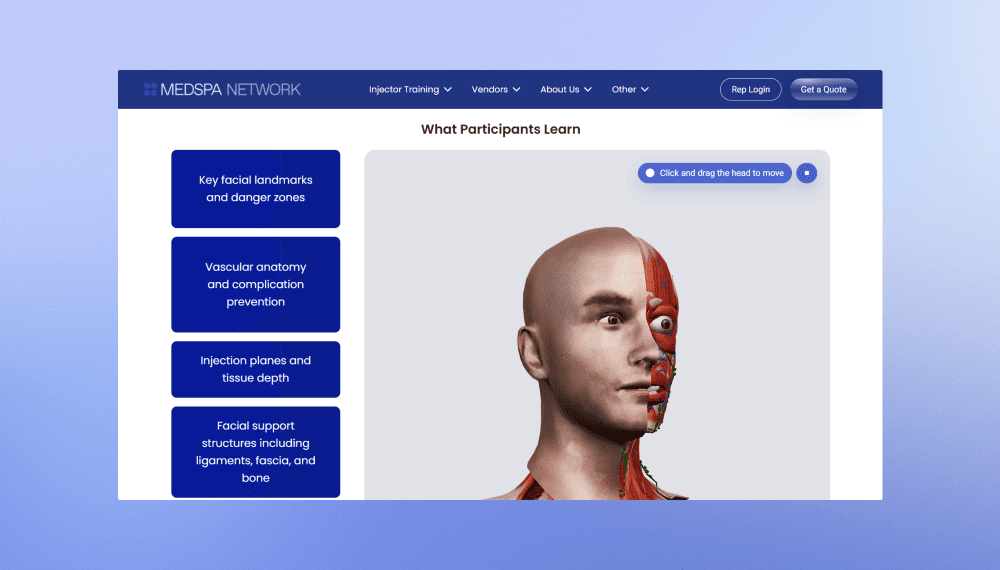
Omdesign och ombyggnad av MedSpa Networks webbplats
Innowise byggde om MedSpa Networks webbplats i WordPress, vilket gav företagets team möjlighet att själva sköta de dagliga innehållsuppdateringarna.
2 månader från projektstart till lansering
3-5 leads per vecka (en ökning från 1 per månad)
Läs fallstudien
Kundrecension
Läs fallstudien
Client review logo. Kundrecension
MedSpa Network website redesign and rebuild.
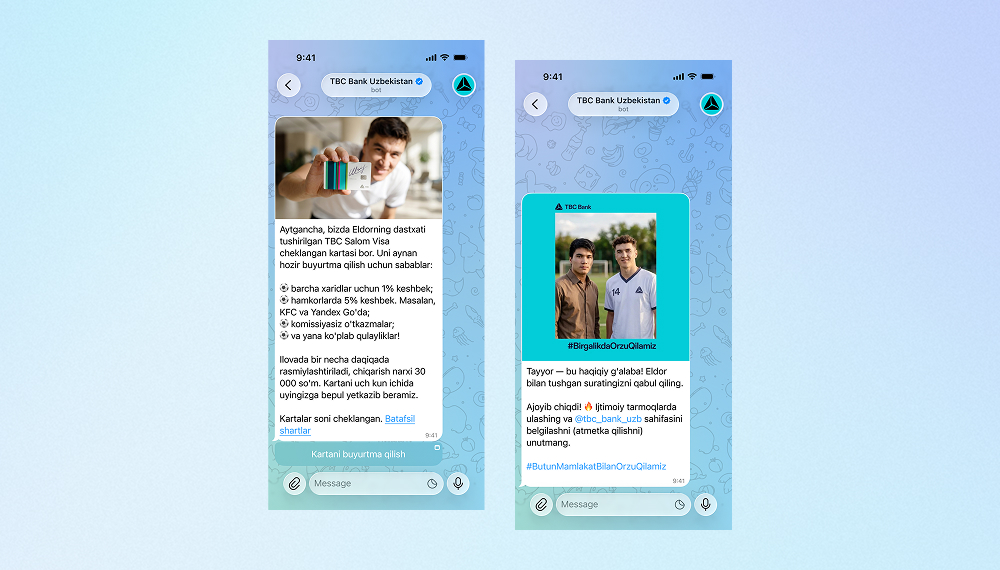
AI-bot för TBC Banks marknadsföringskampanj
Innowise har utvecklat en tvåspråkig Telegram-bot som skapar AI-selfies med TBC Banks fotbollsstjärna som varumärkesambassadör.
3,000 engagerade användare
2 språk som stöds
Läs fallstudien
Kundrecension
Läs fallstudien
Client review logo. Kundrecension
AI Telegram bot..
Produktstrategi för Bitlendex plattform för bitcoin-utlåning
Innowise genomförde en utredningsfas för Bitlendex och hjälpte kunden att omvandla ett produktkoncept i ett tidigt skede till en validerad affärsmodell och en tydligt definierad MVP.
1 månad under hela utredningsfasen
Finansiellt rådgivningssystem för Bonnfinanz
Innowise hjälpte Bonnfinanz att utveckla ett webbaserat rådgivnings- och administrationssystem som möjliggör mobilt arbete och direkt interaktion med kunden.
Laddningsplattform för elbilar med flexibel fakturering
Innowise bidrog till att modernisera SMART/LAB:s plattform för e-mobilitet genom att förbättra funktionerna för fakturering, betalning, transaktionshantering och rapportering.
>50% snabbare fakturering och betalningshantering
FinXPs molnbaserade DevOps-transformation
Innowise hjälpte FinXP att modernisera sin infrastruktur för finansiella tjänster genom att migrera äldre PHP-baserade API:er och applikationer till en molnbaserad arkitektur.
11 appar som har flyttats till Azure App Service
100% Infrastruktur som kod
01 / 01
Close popup icon

Slutsats

År 2026 lägger man mer resurser på återanvändbara modeller, bättre representationer, mindre inferensavtryck, övervakning, kalibrering och att ta reda på vad som händer när en modell möter data som inte fanns i träningsuppsättningen.

Det är förmodligen den viktiga förändringen att ha i åtanke. En nyare metod är bara bättre om den passar problemet, data, infrastrukturen och hur modellen kommer att användas. Om en äldre modell fungerar lika bra och är enklare att köra, behåll den äldre modellen. Om en basmodell sparar veckor av träning, använd den. Om ingen av dem klarar ett ordentligt pilotprojekt, gå vidare.

Trenden i sig är aldrig anledningen.

Om du utvärderar vilka ML-metoder som är lämpliga för en verklig produkt eller ett arbetsflöde, kan vårt konsultteam inom maskininlärning hjälpa till med arkitektur, modellval, validering och driftsättning.

FAQ

Maskininlärning (ML) är en gren av artificiell intelligens där modeller lär sig mönster från data och använder dem för att göra förutsägelser eller fatta beslut utan att varje regel behöver skrivas in manuellt.

I praktiken kan det handla om att förutsäga efterfrågan, upptäcka bedrägerier, bedöma risker, rekommendera produkter, upptäcka fel eller förutsäga när utrustning sannolikt kommer att gå sönder.

AI är den övergripande kategorin. Maskininlärning är ett sätt att bygga AI-system genom att lära sig av data. Djupinlärning är en delmängd av maskininlärning som bygger på neurala nätverk med många lager.

Sambandet är alltså ganska enkelt: djupinlärning ingår i maskininlärning, och maskininlärning ingår i AI.

Absolut.

Gradient boosting, random forests, logistisk regression och andra etablerade metoder är fortfarande bra alternativ för många problem som rör strukturerade data. De kan vara snabbare, billigare och lättare att förklara än nyare metoder inom djupinlärning.

En modell blir inte föråldrad bara för att det finns en mer trendig modell.

Oftast de tråkiga: dålig datakvalitet, saknade etiketter, bristfällig infrastruktur, oklart ägarskap, integritetsbegränsningar, integrationsproblem och för få personer som förstår både modellen och affärsprocessen kring den.

Det finns ytterligare en aspekt: ibland förbättrar det föreslagna maskininlärningssystemet inte den befintliga processen tillräckligt mycket för att motivera insatsen.

Det är värt att ta reda på så tidigt som möjligt.

AutoML kan hantera delar av modellval, hyperparameterjustering, bearbetning av egenskaper, ensembling och experimentering.

Människor måste fortfarande avgöra vad modellen ska förutsäga, om data är rimliga, vilka fel som är viktigast, hur framgång ska mätas och om det slutliga systemet är tillräckligt säkert och användbart för att kunna tas i drift.

AutoML kan genomföra experiment. Det kan dock inte avgöra om experimentet var värt att genomföra.

Maskininlärning på enheten är ett bra val när latensen spelar roll, uppkopplingen är opålitlig, bandbredden är begränsad eller när känslig data bör förvaras lokalt.

Nackdelen är hårdvaran. Mindre enheter har strängare begränsningar vad gäller minne, beräkningskapacitet och energiförbrukning, vilket innebär att modellerna oftast måste komprimeras eller optimeras på annat sätt innan de kan köras smidigt på dessa enheter.

För de flesta företag är svaret nej.

Kvantmaskininlärning är fortfarande till stor del ett forskningsämne. Det finns experiment som rör optimering, kvantkärnor och hybridmodeller som kombinerar kvant- och klassisk teknik, men konventionell maskininlärning är fortfarande betydligt mer praktiskt användbar för vanliga produktionssystem i 2026.

Om någon idag föreslår kvantmaskininlärning för ett vanligt prognosproblem, skulle jag först fråga vad den vanliga modellen egentligen misslyckades med.

Visa alla

Innehållsförteckning

Sätt ML i arbete

    Kontakta oss

    Boka ett samtal eller fyll i formuläret nedan så återkommer vi till dig när vi har behandlat din förfrågan.

    Skicka ett röstmeddelande till oss
    Bifoga dokument
    Ladda upp filen

    Du kan bifoga 1 fil på upp till 2 MB. Giltiga filformat: pdf, jpg, jpeg, png.

    Genom att klicka på Skicka samtycker du till att Innowise behandlar dina personuppgifter enligt vår integritetspolicy för att förse dig med relevant information. Genom att lämna ditt telefonnummer samtycker du till att vi kan kontakta dig via röstsamtal, SMS och meddelandeappar. Avgifter för samtal, SMS och datatrafik kan tillkomma.

    Du kan också skicka din förfrågan till oss

    på contact@innowise.com
    Vad händer härnäst?
    1

    När vi har tagit emot och behandlat din förfrågan återkommer vi till dig för att diskutera era projektbehov och underteckna ett sekretessavtal (NDA).

    2

    Efter att ha undersökt dina önskemål, behov och förväntningar kommer vårt team att ta fram ett projektförslag med arbetsomfattning, teamstorlek, tids- och kostnadsberäkningar.

    3

    Vi ordnar ett möte med dig för att diskutera erbjudandet och fastställa detaljerna.

    4

    Slutligen signerar vi avtalet och påbörjar arbetet med ert projekt omgående.

    Fler tjänster vi täcker

    arrow