Data warehouse sanitario: vantaggi, architettura e casi d'uso

21 settembre 2026 12 minuti di lettura
Aleh Yafimau, Healthcare and MedTech Delivery Manager..
Consulente IT nel settore sanitario
Esperto verificato
Ogni articolo pubblicato su Innowise è redatto da autori con esperienza sul campo. Questi autori conoscono l'argomento non solo a livello teorico, ma apportano anche approfondimenti tratti da progetti reali.
Oltre 19 anni di esperienza
Esperto verificato
Oltre 19 anni di esperienza
Aleh sa tradurre le esigenze cliniche in soluzioni tecniche che funzionano anche nella pratica. Conosce a fondo il settore e sviluppa sistemi MedTech conformi ai requisiti normativi, affidabili e progettati per avere un impatto misurabile sull’assistenza.
Competenza
Informatica sanitaria Medtech Algoritmi
Parliamo

Punti di forza

  • Quando i dati relativi ai pazienti, alle richieste di rimborso, alle analisi di laboratorio, alla contabilità e alle operazioni sono archiviati in sistemi diversi, la creazione dei report richiede solitamente una riconciliazione manuale delle informazioni provenienti da fonti diverse. A hData warehouse sanitario integra i dati provenienti da questi sistemi in modo che i team possano utilizzarli per la creazione di report e l'analisi.
  • Anche il magazzino progettato al meglio non può compensare una scarsa qualità dei dati. Problemi quali la presenza di record duplicati dei pazienti, formati non uniformi e definizioni contraddittorie possono rendere inaffidabili i report.
  • Il modello di warehouse definisce la portata della condivisione dei dati e delle definizioni comuni. Un DWH aziendale è al servizio del reporting a livello dell'intera organizzazione, mentre i data mart sono strutturati attorno a reparti specifici o casi d'uso specifici. Le architetture ibride utilizzano entrambi. 
  • Il business case dovrebbe partire dalle decisioni che il magazzino deve supportare, dalla salute della popolazione e dalla valutazione del rischio dei pazienti alla ricerca clinica, all’analisi delle richieste di rimborso o alla pianificazione del personale e della capacità operativa.
Riassumere l'articolo con IA

Se le cartelle cliniche dei pazienti, i risultati delle analisi di laboratorio, le richieste di rimborso e i dati operativi sono archiviati in sistemi diversi, ottenere una risposta attendibile può richiedere più lavoro dell’analisi stessa. I team potrebbero dover riconciliare i dati e verificare il significato effettivo delle cifre prima di poterli utilizzare. A data warehouse sanitario (DWH) consolida i dati provenienti da questi sistemi e li struttura ai fini della reportistica e dell'analisi.

In questo articolo spiegherò come viene realizzato un DWH per il settore sanitario e quali caratteristiche sono rilevanti nella pratica. Esamineremo inoltre i principali modelli di data warehouse, i casi d'uso più comuni nel settore sanitario, i vantaggi aziendali, le sfide legate all'implementazione e le decisioni da prendere prima dell'avvio del progetto.

Che cos’è un data warehouse sanitario?

A data warehouse sanitario è un ambiente centrale in cui i dati provenienti da diversi sistemi sanitari vengono puliti, armonizzati e preparati per la reportistica e l'analisi. È in grado di integrare i dati delle cartelle cliniche elettroniche (EHR) e dei registri medici elettronici (EMR) con quelli relativi alle richieste di rimborso, ai risultati di laboratorio, al portale pazienti, ai registri ERP o CRM e ai dati provenienti dai dispositivi connessi.

Un database operativo di solito supporta una singola applicazione e le sue attività quotidiane. Un DWH è progettato per rispondere a domande che richiedono dati provenienti da più sistemi contemporaneamente. Se, ad esempio, un ospedale vuole capire perché le riammissioni sono in aumento, gli analisti possono confrontare le diagnosi e la storia terapeutica con i dati relativi alle richieste di rimborso, ai risultati di laboratorio e al personale, invece di estrarre ogni set di dati separatamente.

A differenza di un DWH, un data lake in genere archivia i dati prima che questi siano stati strutturati per uno specifico scopo analitico. È in grado di contenere grandi volumi di dati grezzi o leggermente elaborati in diversi formati. Un DWH, al contrario, contiene dati preparati che i team possono utilizzare per la BI, i report periodici e le analisi continue.

Database operativoData warehouseLago di dati
Scopo principaleEseguire le transazioni quotidiane delle applicazioniRaccogliere i dati provenienti da diversi sistemi in un formato che consenta ai team di elaborare report e analizzarliConservare grandi quantità di dati di vario tipo per un utilizzo futuro
Fonti dei datiDati creati e utilizzati dalle applicazioni operativeDati provenienti da cartelle cliniche elettroniche (EHR), sistemi di gestione delle richieste di rimborso, ERP, CRM e altri sistemi aziendali o cliniciDati provenienti da numerose fonti, inclusi dati strutturati, semi-strutturati e non strutturati
Come vengono archiviati i datiStrutturato in base alle esigenze dell'applicazionePulito e organizzato in base alle esigenze di reporting e analisiSpesso viene mantenuta vicina alla sua forma originale e strutturata quando un caso d'uso lo richiede
Uso tipico in ambito sanitarioTransazioni relative alla cartella clinica elettronica (EHR), appuntamenti o attività CRMReportistica intersistemica, BI e analisi dei dati nel settore sanitarioSet di dati su larga scala, analisi esplorative o carichi di lavoro di apprendimento automatico

Architettura del data warehouse sanitario

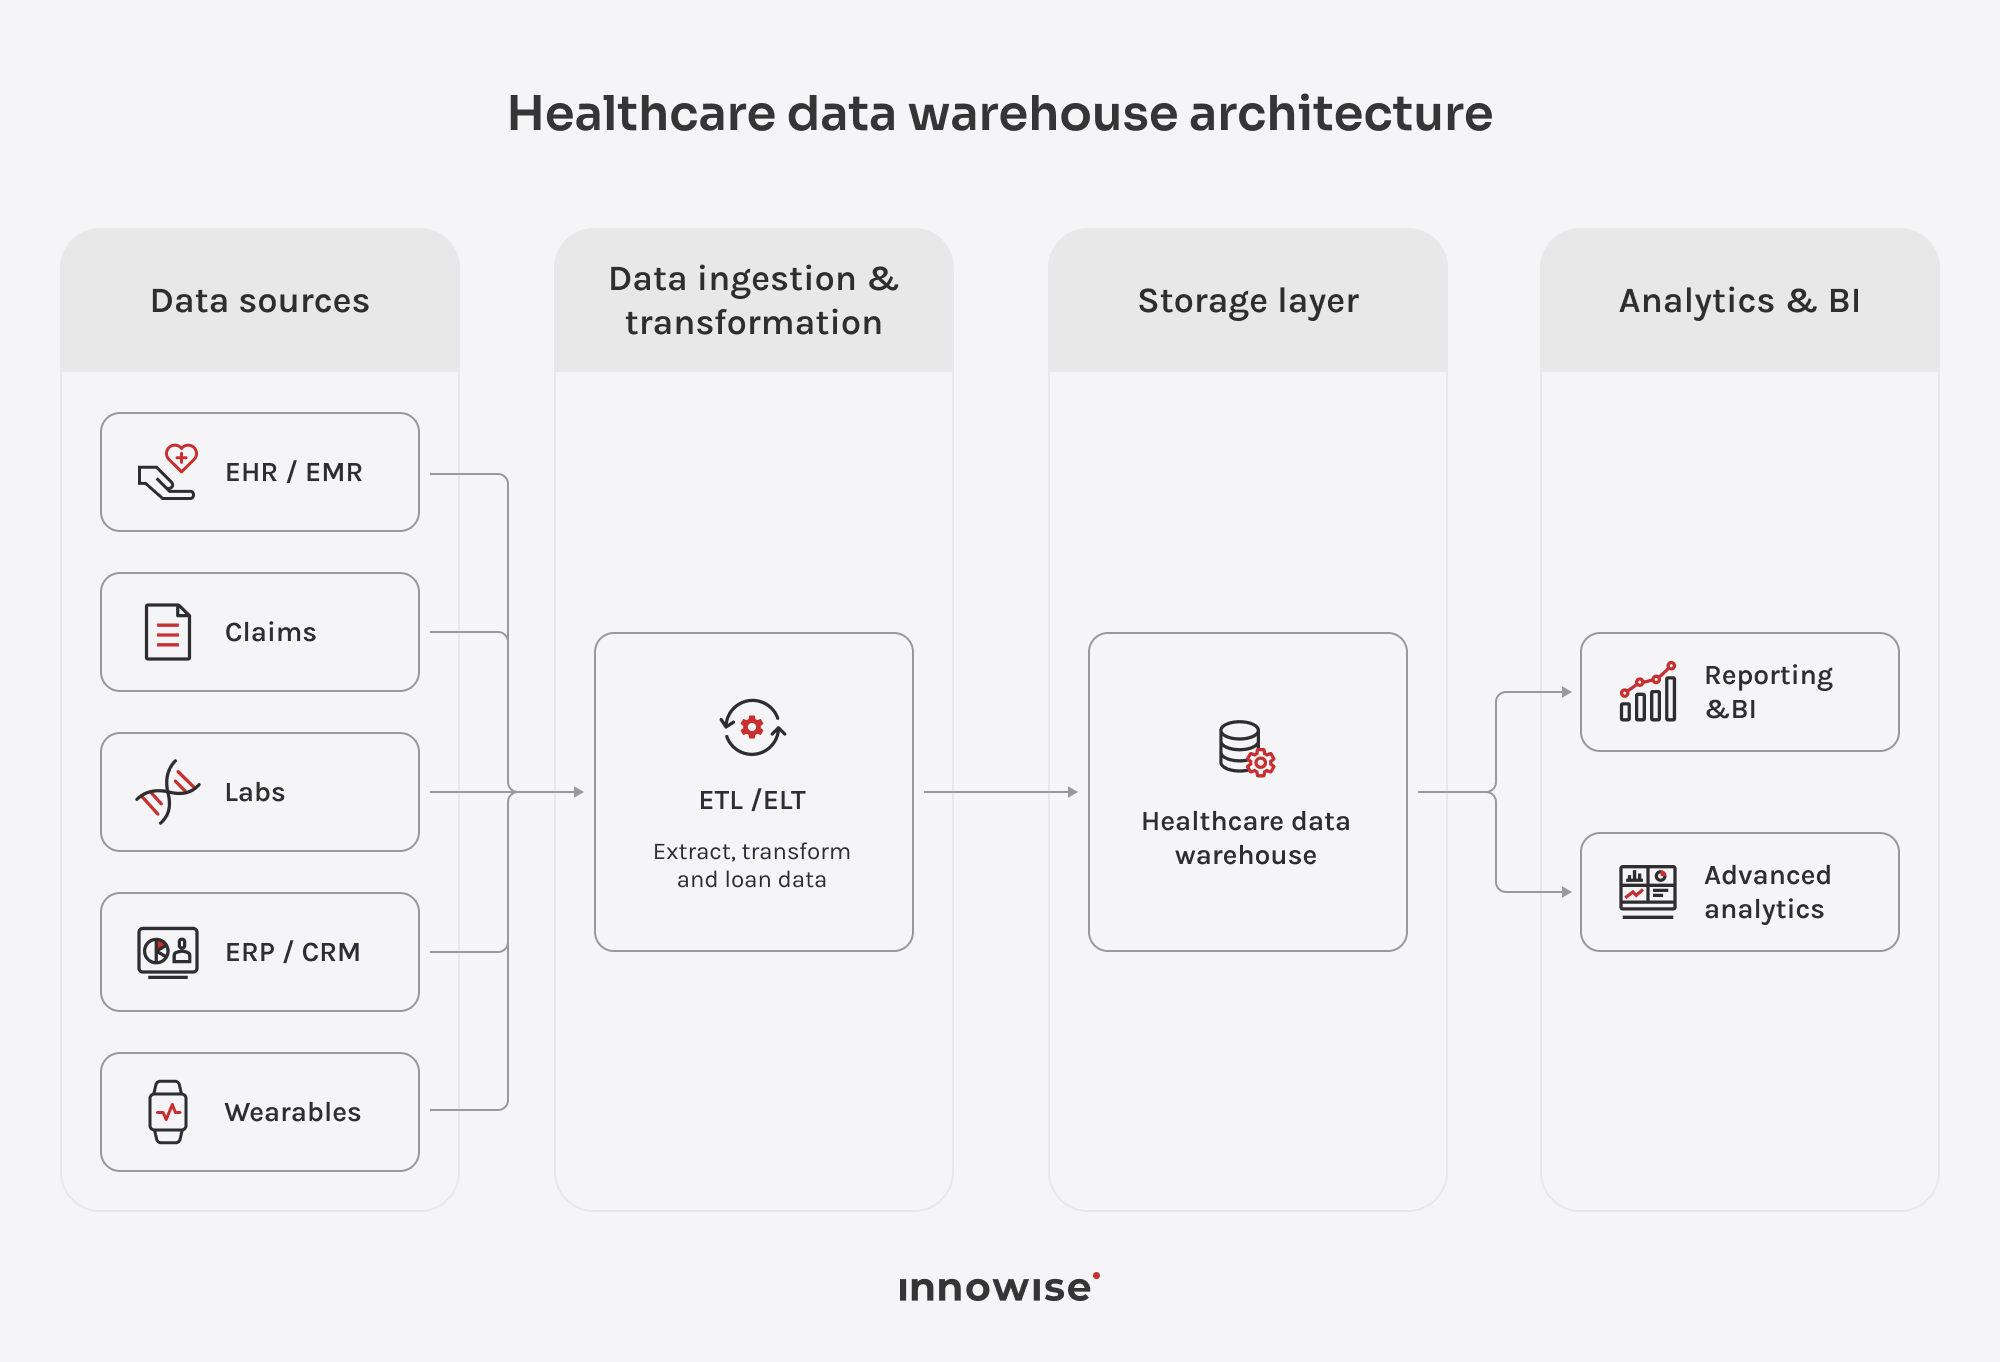
Per comprendere meglio come funziona un data warehouse sanitario, esaminiamo i principali livelli che ne costituiscono la struttura. Ciascuno di essi svolge un ruolo specifico nel trasferimento dei dati dai sistemi di origine all’archivio e nel renderli poi disponibili per la reportistica, l’analisi e le applicazioni.

Fonti dei dati

Il livello di origine comprende i sistemi già utilizzati per le attività cliniche e aziendali, quali le cartelle cliniche elettroniche (EHR ed EMR), le piattaforme di gestione delle richieste di rimborso, i sistemi LIS e RIS/PACS, nonché i software ERP o CRM. Lo stesso paziente o evento può essere registrato in modo diverso nei vari sistemi; pertanto, prima di poter utilizzare i dati in modo integrato, è necessario armonizzare i formati e allineare gli identificatori.

Acquisizione e ETL/ELT

Questo livello raccoglie i dati di origine e li prepara per l'analisi. Con l'ETL, i dati vengono trasformati prima di essere caricati nel data warehouse; con l'ELT, la trasformazione avviene dopo il caricamento. Il processo può includere anche la standardizzazione del formato, la rimozione dei duplicati e lo staging temporaneo.

Immagazzinamento

Il livello di archiviazione conserva i dati storici in una struttura progettata per la reportistica e l'analisi. A seconda dell'architettura, può anche fornire data mart per un reparto specifico o un caso d'uso particolare.

Analisi dei dati e BI

Gli strumenti di BI utilizzano i dati del data warehouse per creare dashboard e report periodici, mentre gli analisti possono eseguire query ad hoc sullo stesso set di dati. Ciò offre ai team una fonte condivisa per le analisi, evitando di dover ricostruire la logica per ogni singolo report.

Applicazioni

I dati del data warehouse possono inoltre supportare applicazioni cliniche o aziendali a valle. Gli strumenti di ricerca o i sistemi di pianificazione, ad esempio, possono utilizzare i dati già elaborati provenienti dal data warehouse invece di collegarsi separatamente a ciascun sistema di origine.

Hai bisogno di una visione unica e affidabile dei dati clinici e aziendali?

Caratteristiche e funzionalità principali

Ora che abbiamo parlato dell'architettura, esaminerò le caratteristiche che probabilmente troverete in un data warehouse dedicato al settore sanitario. Ogni organizzazione è leggermente diversa dalle altre, ma emergono molte esigenze comuni quando è necessario combinare dati provenienti da sistemi diversi e garantire che rimangano utilizzabili per la reportistica e l'analisi.

Integrazione dei dati ed ETL/ELT

I sistemi sanitari spesso archiviano le stesse informazioni in modi diversi. Una cartella clinica elettronica (EHR), una piattaforma di gestione delle richieste di rimborso o un sistema di analisi di laboratorio possono utilizzare campi e formati diversi per record comparabili. Le pipeline ETL ed ELT raccolgono tali dati e li allineano nel data warehouse per l’analisi. A seconda della frequenza con cui i dati cambiano, le pipeline possono essere eseguite secondo una pianificazione prestabilita, caricare solo i nuovi record oppure elaborare gli aggiornamenti man mano che arrivano.

Anche i dati sanitari subiscono modifiche retroattive: i risultati di laboratorio vengono corretti, le visite vengono aggiornate o annullate e le richieste di rimborso vengono modificate o annullate. I flussi di lavoro devono applicare tali modifiche alle registrazioni già caricate; in caso contrario, una nuova esecuzione del report del mese scorso potrebbe non corrispondere più ai dati di origine.

Qualità dei dati e deduplicazione

I record duplicati dei pazienti e i valori contraddittori possono distorcere i report una volta che i dati raggiungono il data warehouse. I controlli di qualità individuano i dati mancanti o non validi, mentre le regole di abbinamento aiutano a collegare i record appartenenti allo stesso paziente tra i vari sistemi. I team hanno bisogno di questa operazione di pulizia prima di confrontare i risultati o elaborare analisi.

Gestione dei metadati

I metadati spiegano il significato di ciascun campo e la sua provenienza. Inoltre, registrano le modifiche apportate prima che i dati raggiungessero il data warehouse. Gli analisti possono risalire alla fonte di un dato presente in una dashboard e verificare quale definizione sia stata utilizzata.

Governance dei dati

La governance dei dati definisce chi è il titolare dei dati e quali definizioni devono essere utilizzate da tutti. In assenza di regole chiare, due reparti potrebbero utilizzare lo stesso data warehouse e riportare comunque valori diversi per la stessa metrica. I titolari e i responsabili dei dati esaminano le modifiche e garantiscono la coerenza di tali definizioni nel tempo.

Sicurezza e controllo degli accessi

Un archivio sanitario può contenere dati sanitari protetti (PHI) insieme a dati operativi o finanziari sensibili, pertanto l’accesso non può essere uguale per tutti. Le autorizzazioni consentono di limitare ciò che un utente può visualizzare in base al proprio ruolo e, se necessario, fino a livelli specifici di righe o colonne. La crittografia protegge i dati sia in fase di archiviazione che durante il trasferimento, mentre i registri di controllo indicano chi vi ha avuto accesso.

Supporto per dati strutturati e semi-strutturati

La maggior parte dei report ricorrenti utilizza tabelle strutturate, ma i sistemi sanitari generano dati anche in altri formati. Le API e i dispositivi connessi, ad esempio, possono inviare dati in formato JSON. Un data warehouse può elaborare questi dati senza dover prima convertire ogni campo in una tabella fissa. I file non strutturati, come le immagini mediche, vengono solitamente conservati in un data lake o in un sistema di archiviazione a oggetti e, all’occorrenza, vengono collegati ai dati del data warehouse.

Scalabilità e prestazioni

Con l'aumentare della quantità di dati archiviati e del numero di query, il data warehouse deve garantire che la generazione dei report rimanga reattiva. Le piattaforme possono ricorrere alla partizionatura, all'indicizzazione, alla memorizzazione nella cache o a risorse di elaborazione separate per gestire carichi di lavoro più consistenti senza dover ricostruire l'architettura del data warehouse.

Interoperabilità

Un data warehouse sanitario deve scambiare dati con cartelle cliniche elettroniche (EHR), sistemi di laboratorio e altre piattaforme cliniche. Gli standard HL7, come FHIR e HL7 v2, forniscono ai team formati comuni per tale scambio, riducendo così la necessità di mappature personalizzate. I sistemi legacy o proprietari potrebbero comunque richiedere connettori personalizzati prima che il data warehouse possa utilizzare i loro dati.

Nei progetti sanitari, non considererei i risultati o i costi in modo isolato. Un DWH consente di mettere a confronto aspetti quali la durata della degenza e le riammissioni con l’utilizzo delle risorse e il tempo impiegato dal personale. Questo è importante nell’assistenza sanitaria basata sul valore, dove è necessario comprendere sia il risultato sia ciò che è stato necessario per ottenerlo.
Philip Tikhanovich, Head of Big Data.
Philip Tikhanovich
Responsabile Big Data

Integrazioni con i data warehouse del settore sanitario

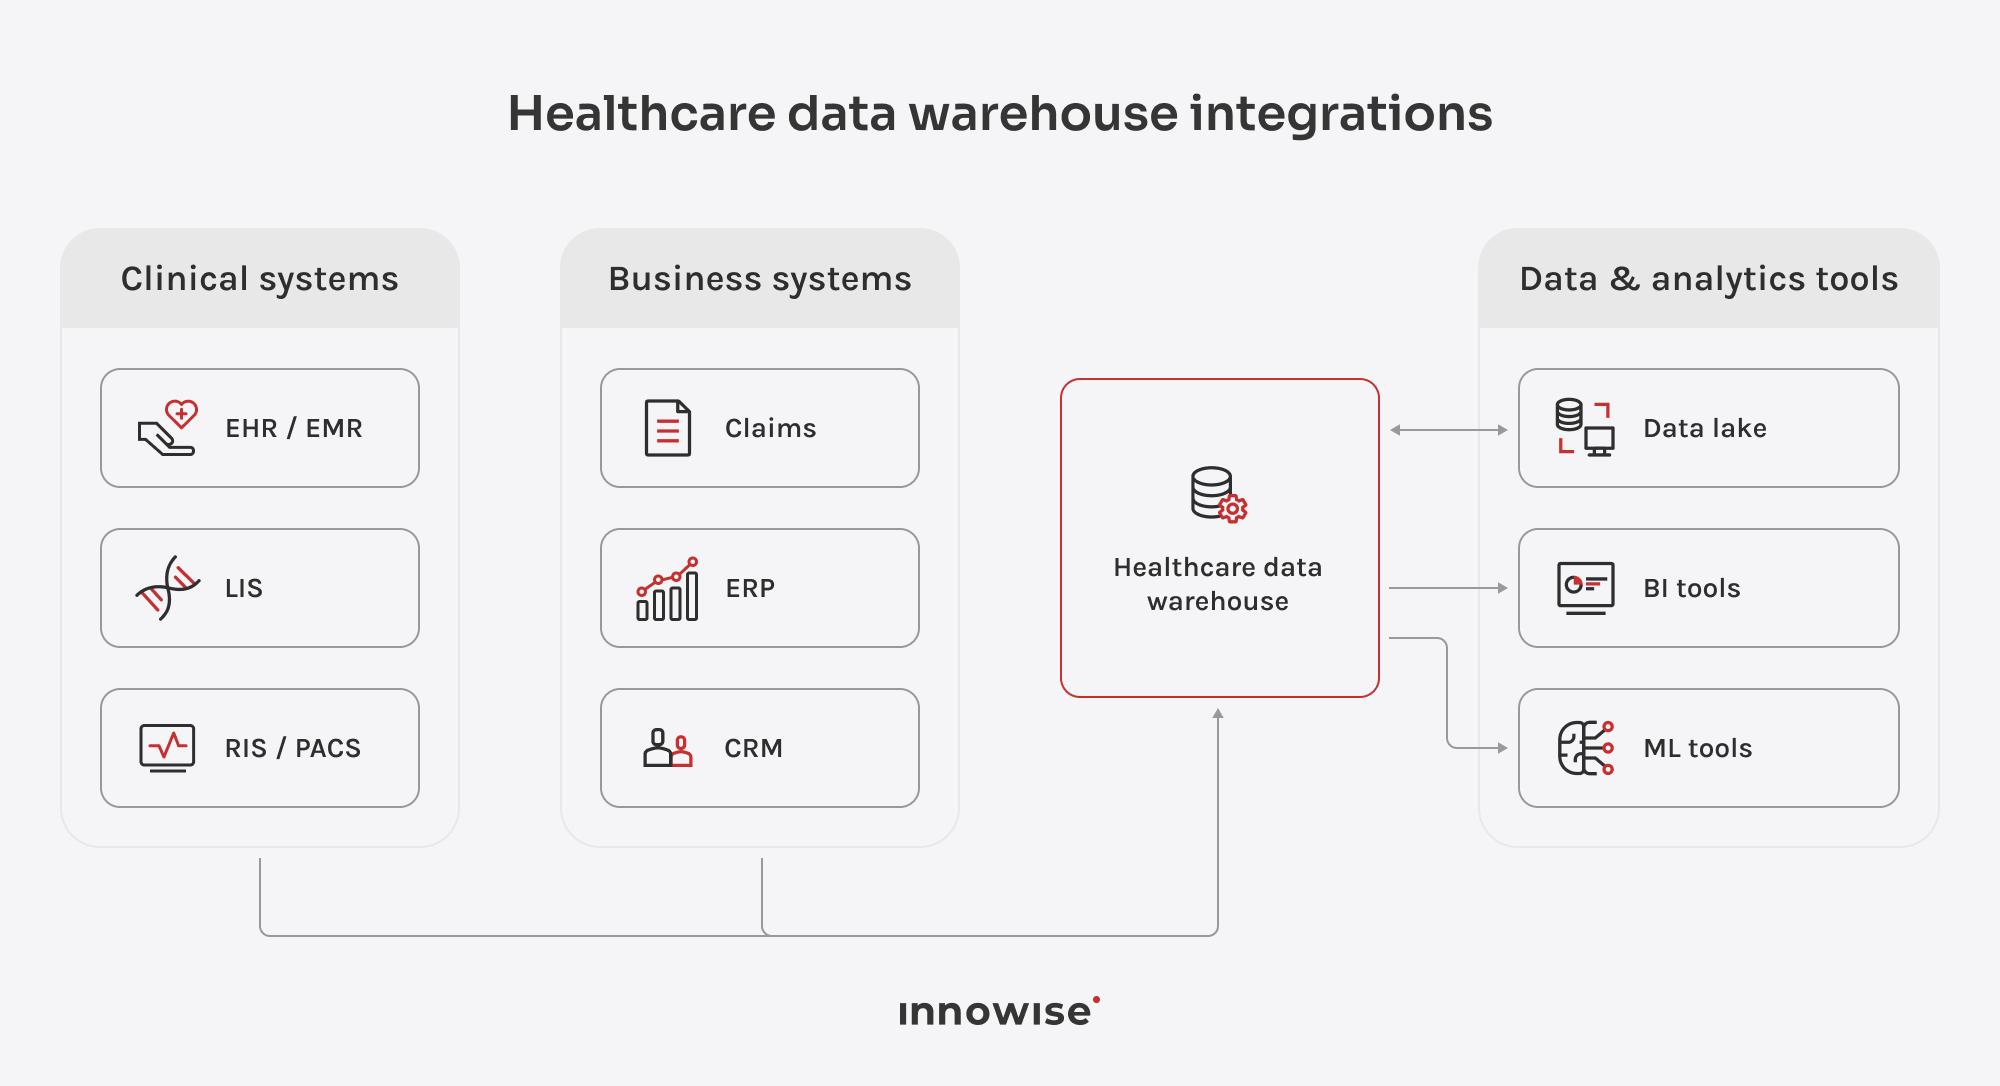
Se state realizzando un data warehouse clinico nel settore sanitario, solitamente collegherete i sistemi che i vostri team utilizzano già quotidianamente. Le integrazioni più comuni acquisiscono dati dai sistemi clinici e aziendali e li rendono disponibili agli strumenti di BI e ML.

Sistemi clinici

I sistemi EHR ed EMR inviano solitamente dati clinici strutturati tramite API FHIR o feed HL7 v2. FHIR è particolarmente adatto per risorse quali “Paziente” e “Visita”, mentre HL7 v2 rimane lo standard più diffuso per gli eventi ospedalieri e i risultati di laboratorio. I sistemi LIS utilizzano spesso messaggi HL7 v2 ORU per inviare i risultati degli esami al data warehouse.

La radiologia funziona in modo diverso perché i dati di imaging vengono solitamente conservati al di fuori del warehouse stesso. Il PACS o l'object storage conserva le immagini, mentre il warehouse archivia il referto e i metadati dello studio con collegamenti al file DICOM corrispondente.

Sistemi aziendali

I sistemi di gestione delle richieste di rimborso mostrano quanto è stato fatturato dai fornitori e quanto è stato rimborsato dai pagatori. Negli Stati Uniti, lo scambio di dati avviene spesso tramite transazioni X12, tra cui i file 837 relativi alle richieste di rimborso e i file 835 relativi ai pagamenti. La conservazione dei dati sia a livello di richiesta che a livello di voce consente agli analisti di confrontare i costi totali con i singoli servizi a cui si riferiscono.

I sistemi ERP forniscono dati relativi ai costi e al personale, mentre i sistemi CRM registrano le interazioni con i pazienti al di fuori della cartella clinica. Quando i team combinano tali informazioni con i dati clinici, possono analizzare aspetti quali l’eventuale aumento della partecipazione agli appuntamenti grazie ai promemoria o l’adeguatezza dell’organico rispetto all’attività clinica.

Dati e analisi

Un data lake archivia dati grezzi o meno strutturati prima che i team li preparino per il data warehouse. I set di dati selezionati possono essere puliti all’interno del data lake e poi caricati nel data warehouse. In alcune configurazioni, il data warehouse interroga direttamente i dati del data lake invece di copiarli prima.

Gli strumenti di BI, come Power BI o Tableau, si collegano al data warehouse tramite connettori nativi o ODBC/JDBC e leggono i dati già preparati. Le piattaforme di ML utilizzano i dati storici del data warehouse per l’addestramento o il scoring, quindi inviano i risultati dei modelli, come i punteggi di rischio, al data warehouse per la creazione di report o altre applicazioni.

Vantaggi aziendali

Se state valutando i vantaggi economici di un data warehouse per il settore sanitario, vi consiglio di considerare quali cambiamenti comporta per i team che utilizzano i dati. I vantaggi di un data warehouse aziendale nel settore sanitario elencati di seguito sono gli ambiti in cui tale impatto tende a manifestarsi in modo più evidente.

Reporting più rapido

Anziché estrarre i dati da diversi sistemi e riconciliarli manualmente, i team possono lavorare con i dati già disponibili nel data warehouse. La generazione dei report ricorrenti richiede meno impegno e gli analisti possono dedicare più tempo all’analisi dei dati piuttosto che alla loro raccolta.

Panoramica unificata del paziente

I dati clinici, relativi alle richieste di rimborso e di altro tipo riguardanti i pazienti possono essere collegati tra i diversi sistemi di origine, offrendo così ai team una visione più completa della storia clinica del paziente. Ciò semplifica il monitoraggio del percorso di cura nel corso delle visite, senza dover passare da una cartella clinica all’altra.

Decisioni cliniche più efficaci

I medici e gli analisti possono avvalersi dei dati storici provenienti da tutta l'organizzazione per rispondere a domande che coinvolgono più di un sistema. Questo contesto più ampio supporta le decisioni relative ai modelli terapeutici, al rischio dei pazienti e alla qualità dell'assistenza.

Ottimizzazione dei costi e delle risorse

Collegare l'attività clinica ai dati finanziari o operativi aiuta gli ospedali a capire dove vengono impiegate le risorse. I team possono confrontare i volumi dei servizi con il numero di personale o i costi e utilizzare i risultati nella pianificazione della capacità.

Migliore analisi dei sinistri

Una volta che le richieste di rimborso e i dati clinici sono stati inseriti nello stesso database, gli analisti possono confrontare le prestazioni fatturate con le cure documentate dal personale sanitario. Possono così indagare sui motivi per cui gli assicuratori hanno respinto o liquidato in misura insufficiente le richieste di rimborso e individuare eventuali problemi ricorrenti nella fatturazione.

Analisi predittiva

Poiché il database centralizza i dati storici in un unico luogo, i team possono utilizzarli per prevedere con maggiore precisione gli sviluppi futuri. Un modello potrebbe individuare i pazienti a più alto rischio di riammissione o prevedere periodi di maggiore domanda. I team assistenziali e operativi possono così pianificare in anticipo le cure di follow-up o l'assegnazione del personale.

Sostegno alla ricerca

I ricercatori hanno spesso bisogno di dati relativi a numerosi pazienti raccolti nell'arco di lunghi periodi. Un data warehouse mette a loro disposizione dati già pronti per analisi di coorte o studi retrospettivi, senza dover ricompilare ogni volta il set di dati da sistemi separati.

Analisi dei dati sanitari basate sul valore

Nell'assistenza sanitaria basata sul valore, i team devono sapere se le risorse che utilizzano portano effettivamente a risultati migliori. Quando il sistema di gestione dei dati collega i risultati ai dati sull'utilizzo delle risorse, gli analisti possono confrontare i gruppi di pazienti e verificare se una maggiore spesa o un maggiore ricorso ai servizi comporti risultati migliori in termini di assistenza.

Sfide comuni relative ai data warehouse nel settore sanitario

I vantaggi che ho illustrato sopra comportano alcune difficoltà di implementazione, ma è molto più facile affrontarle se le si pianifica in anticipo. Un team esperto è in grado di individuare molti dei rischi prima che si trasformino in rielaborazioni o problemi di rendicontazione. Questi sono gli aspetti su cui terrei d’occhio fin dall’inizio.

Dati frammentati e interoperabilità

Un sistema può identificare un paziente tramite il numero della cartella clinica, mentre un altro utilizza un identificativo diverso. Anche i formati dei dati possono variare. I team devono mappare correttamente tali differenze e aggiornare le mappature ogni volta che il sistema di origine subisce modifiche.

Scarsa qualità dei dati

Un magazzino eredita i problemi dai sistemi che lo alimentano. Valori mancanti o codici incoerenti possono generare report inaffidabili e compromettere le analisi successive. I team devono individuare questi problemi prima che altri report o modelli inizino a fare affidamento sugli stessi dati.

Cartelle cliniche duplicate

Lo stesso paziente può comparire più di una volta quando i sistemi utilizzano identificativi diversi o contengono dati personali leggermente diversi. Le regole di abbinamento devono individuare tali duplicati senza combinare accidentalmente record relativi a persone diverse.

Sicurezza e privacy

Un archivio sanitario può contenere cartelle cliniche dei pazienti insieme a dati finanziari e operativi, ma non tutti gli utenti devono necessariamente avere accesso a tutte le informazioni. Il personale medico potrebbe aver bisogno di dettagli relativi ai singoli pazienti, mentre i team finanziari potrebbero aver bisogno solo dei dati di fatturazione. Imposta l'accesso in base al ruolo e verifica le autorizzazioni ogni volta che aggiungi una nuova fonte di dati.

La governance

I team hanno bisogno di regole chiare su chi detiene la titolarità dei dati condivisi e chi prende le decisioni al riguardo. Ad esempio, se due reparti calcolano la stessa metrica in modo diverso, qualcuno deve scegliere la definizione che tutti useranno. Lo stesso vale per l’approvazione dell’accesso ai dati sensibili.

Adattamento dei volumi di dati

Man mano che il data warehouse accumula dati relativi a un numero sempre maggiore di anni e integra nuove fonti, le query possono rallentare e i costi di archiviazione possono aumentare. I team devono pianificare come organizzare i dati più vecchi e per quanto tempo conservarli, in modo che la crescita dei dati non complichi la creazione dei report quotidiani.

Mancanza di competenze interne nel campo del data engineering

Il vostro team potrebbe conoscere bene i sistemi sanitari, ma avere un’esperienza limitata nella creazione di un data warehouse basato su di essi. In tal caso, dei data engineer esterni possono aiutare a progettare le pipeline e il modello di dati, mentre il vostro team interno definisce quali esigenze i dati devono soddisfare.

Modelli di data warehouse nel settore sanitario

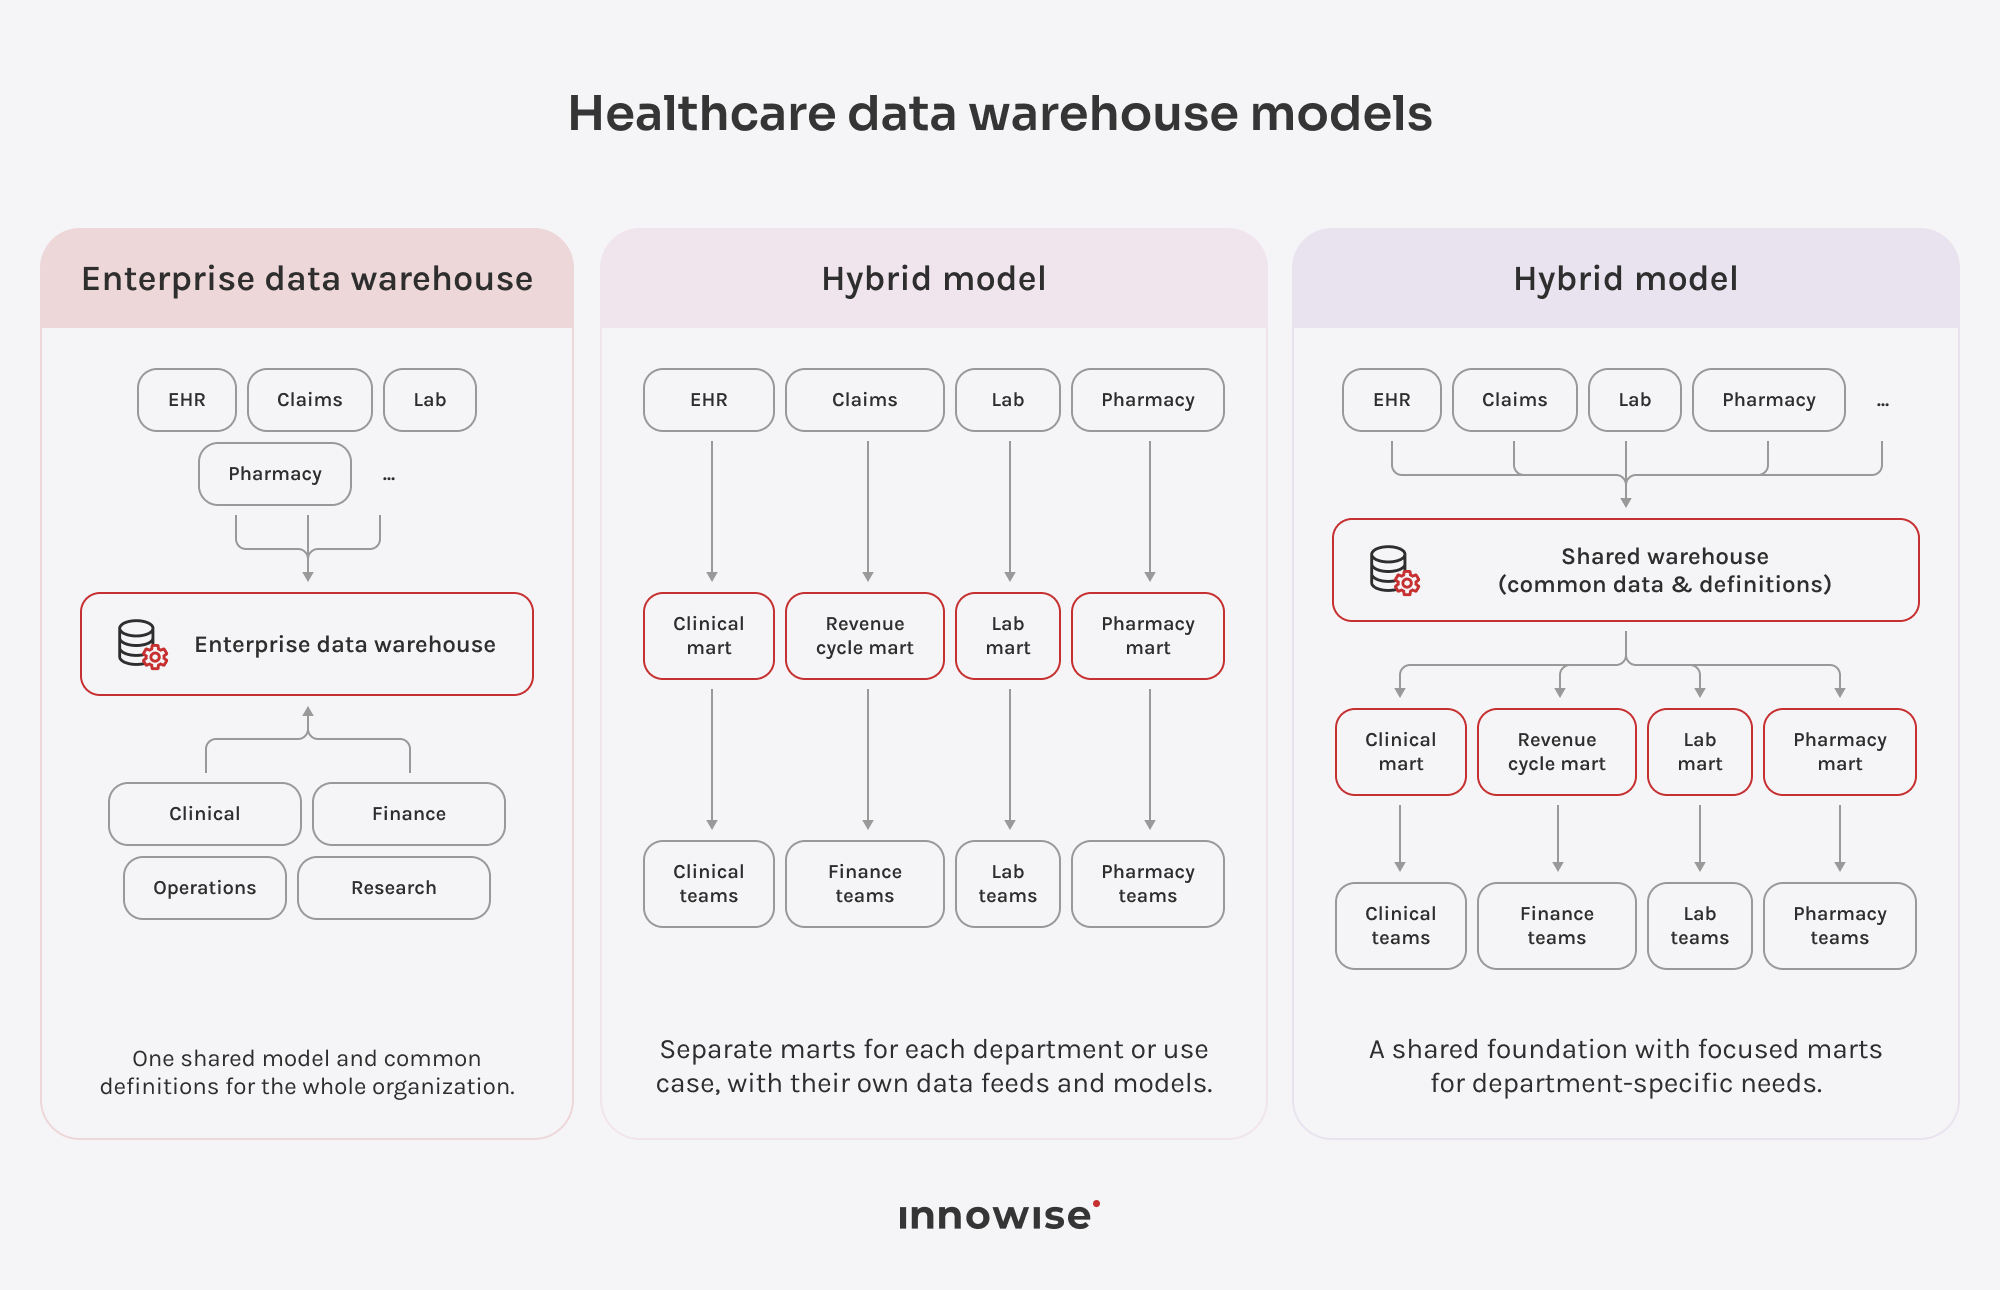
La scelta del modello di data warehouse sanitario più adeguato dipende dal grado di centralizzazione che si desidera per la gestione dei dati e dal livello di autonomia richiesto dai singoli reparti. In pratica, le organizzazioni scelgono solitamente tra tre modelli:

Data warehouse aziendale

Un data warehouse aziendale nel settore sanitario utilizza un modello di dati condiviso a livello dell’intera organizzazione, in modo che i diversi reparti operino sulla base di definizioni e regole di rendicontazione uniformi. I team clinici e quelli finanziari, ad esempio, possono calcolare la durata media della degenza nello stesso modo, anziché definire separatamente tale parametro nei propri report.

A livello di dati, i team possono standardizzare le entità fondamentali quali pazienti, visite, operatori sanitari e strutture e mappare i record del sistema di origine a tali strutture condivise. Il compromesso è che devono concordare tali definizioni sin dall’inizio e mantenerle allineate man mano che il data warehouse cresce. Ciò richiede un maggiore impegno iniziale, specialmente in un’organizzazione di grandi dimensioni in cui la terminologia e le esigenze di reporting sono in continua evoluzione. Una volta che numerosi report dipendono dal modello condiviso, anche una piccola modifica a una definizione fondamentale può influire contemporaneamente su diversi team.

Data mart indipendenti

Un data mart indipendente è incentrato su un singolo reparto o su un caso d’uso analitico specifico, anziché sulla modellazione dei dati dell’intera organizzazione. Un team oncologico, ad esempio, potrebbe creare un data mart basato sui sistemi clinici di cui ha bisogno, mentre gli analisti del ciclo dei ricavi ne creerebbero un altro incentrato sui dati relativi alle richieste di rimborso e alla fatturazione.

Poiché ogni data mart ha un ambito più ristretto, i team riescono spesso a rendere operativi i primi report in tempi più rapidi. Man mano che vengono aggiunti nuovi mart, lo stesso sistema sorgente potrebbe richiedere pipeline e mappature separate per ciascuno di essi. Le definizioni possono inoltre variare da un reparto all’altro. Inoltre, poiché i mart spesso memorizzano dati già strutturati o riepilogati per un caso d’uso specifico, potrebbero non disporre dei dettagli necessari per un’analisi diversa da effettuare in un secondo momento.

Modello ibrido

Un modello ibrido combina un data warehouse aziendale condiviso con data mart creati per reparti specifici o esigenze analitiche particolari. I dati fondamentali e le definizioni condivise rimangono nel livello centrale, mentre ogni data mart adatta tali dati alle proprie esigenze di reporting. Poiché i data mart attingono dal data warehouse, i team non devono creare un’integrazione separata con ogni singolo sistema sorgente.

Questa configurazione consente alle organizzazioni di aggiungere nuovi marts man mano che cambiano le esigenze di reporting, senza dover modellare fin dall’inizio ogni possibile caso d’uso futuro. La parte più difficile consiste nel decidere cosa debba essere standardizzato a livello centrale e cosa possa rimanere specifico di un singolo mart. Se una quantità eccessiva di logica viene trasferita nei singoli marts, le definizioni possono subire variazioni nel tempo.

Stai progettando un DWH per il settore sanitario e stai valutando le diverse opzioni?

Casi d'uso del DWH nel settore sanitario

Le organizzazioni sanitarie utilizzano i data warehouse per attività molto diverse tra loro, a seconda dei dati che raccolgono e delle decisioni che devono prendere. Gli esempi di data warehouse sanitari riportati di seguito mostrano come ciò si concretizzi nell'ambito clinico e operativo.

Gestione della salute della popolazione

I team che si occupano di salute della popolazione utilizzano i dati presenti nel database per individuare gruppi di pazienti con esigenze assistenziali simili. Ad esempio, possono identificare le persone che hanno superato i termini previsti per gli screening o i controlli di follow-up e trasmettere tali elenchi ai team di sensibilizzazione.

Gestione delle malattie croniche

Nel caso delle patologie croniche, i team sanitari devono poter verificare quali cambiamenti si verificano tra un appuntamento e l’altro. Un archivio può riunire i risultati delle analisi di laboratorio e la cronologia terapeutica relative a tutte le visite, integrandoli, quando disponibili, con i dati rilevati dai dispositivi connessi. La cronologia completa aiuta i team a individuare eventuali cambiamenti nelle condizioni del paziente e a decidere quando potrebbe essere necessario un controllo anticipato.

Analisi predittiva del rischio dei pazienti

I team utilizzano i dati storici archiviati per stimare quali pazienti presentino un rischio maggiore di riammissione o di mancata presentazione a un appuntamento. Tali punteggi vengono solitamente comunicati ai medici tramite un sistema di gestione delle cure o di assistenza sul territorio. La loro registrazione direttamente nella cartella clinica elettronica (EHR) richiede in genere un’integrazione separata: i fornitori di EHR tendono infatti a mantenere uno stretto controllo sull’accesso in scrittura.

Ricerca e sperimentazione clinica

La ricerca di partecipanti idonei allo studio spesso parte da un lungo elenco di criteri di inclusione ed esclusione. I ricercatori possono innanzitutto applicare tali criteri ai dati anonimizzati presenti nel data warehouse e restringere il campo prima di esaminare le singole cartelle cliniche. Nel caso di ricerche condotte in più centri, i team possono anche mappare le cartelle cliniche provenienti da diverse strutture in una struttura comune prima di procedere all’analisi.

Analisi del ciclo di fatturazione e delle richieste di rimborso

Possono verificarsi problemi di pagamento in qualsiasi momento tra l’addebito iniziale e il rimborso finale. Grazie all’integrazione dei dati clinici, di fatturazione e relativi alle richieste di rimborso, i team addetti alla gestione dei ricavi possono individuare in quale fase una richiesta di rimborso si sia bloccata e verificare se lo stesso motivo di rifiuto si ripete per un determinato pagatore o una determinata procedura.

Pianificazione del personale e delle capacità

I responsabili confrontano il numero di pazienti per reparto e turno con il personale in servizio in quel momento. Se in un determinato reparto si verificano ripetutamente carenze di personale in determinati giorni o durante i periodi di picco, possono modificare i turni futuri per tenere conto di tale andamento.

Ottimizzazione dei costi operativi

Quando i dati finanziari vengono collegati all’attività clinica, i team possono capire da dove provengono effettivamente le spese operative. Possono confrontare la spesa per procedura, struttura o tipo di assistenza e analizzare perché i costi siano più elevati in alcune aree rispetto ad altre.

Processo di implementazione

Ogni progetto di data warehouse nel settore sanitario ha un inizio diverso. Le fasi da seguire dipendono dai sistemi attualmente in uso, dalla qualità dei dati e dalle funzionalità che si desidera che il data warehouse offra. Ecco come affrontiamo solitamente questo tipo di progetti.

01
Analisi iniziale

Il nostro team definisce i casi d'uso iniziali relativi alla reportistica o all'analisi per la prima versione e individua i soggetti che ne hanno bisogno. Inoltre, verifichiamo quali sistemi di origine rientrano nell'ambito di applicazione e segnaliamo eventuali vincoli normativi prima di prendere decisioni relative all'architettura.

02
Valutazione dei dati

Prima di creare le pipeline, esaminiamo ogni fonte per individuare eventuali dati mancanti e formati incoerenti, quindi verifichiamo la presenza di duplicati. I risultati ci indicano quali dati possono rimanere così come sono e dove è necessario applicare regole di pulizia prima che tali problemi influenzino i report di produzione.

03
Architettura

I nostri architetti dei dati scelgono il modello di data warehouse in base all'ampiezza della condivisione dei dati e delle definizioni richiesta dai team. Successivamente, progettano i livelli di acquisizione e archiviazione in base ai sistemi dell'organizzazione e stabiliscono le modalità di accesso al data warehouse da parte degli strumenti di analisi.

04
Scelta delle tecnologie

Una volta definita l'architettura, il team sceglie la piattaforma, l'approccio ETL/ELT e gli strumenti di BI o ML in base al volume dei dati e allo stack tecnologico esistente. Le considerazioni relative al budget e alla conformità restringono l'elenco, soprattutto nei casi in cui siano richiesti controlli di accesso o la registrazione degli audit.

05
Integrazione

I data engineer collegano il data warehouse ai sistemi di origine. A seconda dell'ambiente, possono utilizzare FHIR o HL7 v2 per i dati clinici, X12 per le richieste di rimborso negli Stati Uniti e API o connettori nativi per le applicazioni aziendali. Verificare ogni feed con dati reali aiuta a individuare tempestivamente eventuali errori di mappatura.

06
Sviluppo

Gli ingegneri Innowise realizzano pipeline che standardizzano i formati ed eliminano i record duplicati prima di applicare le definizioni aziendali concordate. Se la progettazione prevede la creazione di data mart, questi vengono realizzati sul livello condiviso, anziché ricollegarsi a ogni singola fonte.

07
Migrazione e test

Il team carica i dati storici e li confronta con le fonti originali per individuare eventuali valori mancanti o alterati. Gli analisti verificano quindi i report rispetto ai casi d'uso definiti nella fase di analisi, mentre gli utenti aziendali esaminano i risultati prima della messa in produzione.

08
Lancio

Al momento del lancio, il nostro team esegue spesso i report vecchi e quelli nuovi in parallelo, in modo che gli utenti possano confrontare i dati prima di passare alla nuova versione. Inoltre, monitoriamo attentamente l’utilizzo iniziale in produzione, poiché è proprio in questa fase che tendono a emergere eventuali problemi relativi ai dati o alle prestazioni che non erano stati individuati durante i test.

09
Supporto

Dopo la messa in produzione, monitoriamo le prestazioni, aggiungiamo nuove fonti e gestiamo i processi di governance che garantiscono la coerenza delle definizioni condivise. Di solito, si tratta di una delle fasi più lunghe del progetto e una delle più facili da sottovalutare durante la pianificazione.

arrow-icon. arrow-icon.
01 Analisi iniziale

Il nostro team definisce i casi d'uso iniziali relativi alla reportistica o all'analisi per la prima versione e individua i soggetti che ne hanno bisogno. Inoltre, verifichiamo quali sistemi di origine rientrano nell'ambito di applicazione e segnaliamo eventuali vincoli normativi prima di prendere decisioni relative all'architettura.

arrow-icon. arrow-icon.
02 Valutazione dei dati

Prima di creare le pipeline, esaminiamo ogni fonte per individuare eventuali dati mancanti e formati incoerenti, quindi verifichiamo la presenza di duplicati. I risultati ci indicano quali dati possono rimanere così come sono e dove è necessario applicare regole di pulizia prima che tali problemi influenzino i report di produzione.

arrow-icon. arrow-icon.
03 Architettura

I nostri architetti dei dati scelgono il modello di data warehouse in base all'ampiezza della condivisione dei dati e delle definizioni richiesta dai team. Successivamente, progettano i livelli di acquisizione e archiviazione in base ai sistemi dell'organizzazione e stabiliscono le modalità di accesso al data warehouse da parte degli strumenti di analisi.

arrow-icon. arrow-icon.
04 Scelta delle tecnologie

Una volta definita l'architettura, il team sceglie la piattaforma, l'approccio ETL/ELT e gli strumenti di BI o ML in base al volume dei dati e allo stack tecnologico esistente. Le considerazioni relative al budget e alla conformità restringono l'elenco, soprattutto nei casi in cui siano richiesti controlli di accesso o la registrazione degli audit.

arrow-icon. arrow-icon.
05 Integrazione

I data engineer collegano il data warehouse ai sistemi di origine. A seconda dell'ambiente, possono utilizzare FHIR o HL7 v2 per i dati clinici, X12 per le richieste di rimborso negli Stati Uniti e API o connettori nativi per le applicazioni aziendali. Verificare ogni feed con dati reali aiuta a individuare tempestivamente eventuali errori di mappatura.

arrow-icon. arrow-icon.
06 Sviluppo

Gli ingegneri Innowise realizzano pipeline che standardizzano i formati ed eliminano i record duplicati prima di applicare le definizioni aziendali concordate. Se la progettazione prevede la creazione di data mart, questi vengono realizzati sul livello condiviso, anziché ricollegarsi a ogni singola fonte.

arrow-icon. arrow-icon.
07 Migrazione e test

Il team carica i dati storici e li confronta con le fonti originali per individuare eventuali valori mancanti o alterati. Gli analisti verificano quindi i report rispetto ai casi d'uso definiti nella fase di analisi, mentre gli utenti aziendali esaminano i risultati prima della messa in produzione.

arrow-icon. arrow-icon.
08 Lancio

Al momento del lancio, il nostro team esegue spesso i report vecchi e quelli nuovi in parallelo, in modo che gli utenti possano confrontare i dati prima di passare alla nuova versione. Inoltre, monitoriamo attentamente l’utilizzo iniziale in produzione, poiché è proprio in questa fase che tendono a emergere eventuali problemi relativi ai dati o alle prestazioni che non erano stati individuati durante i test.

arrow-icon. arrow-icon.
09 Supporto

Dopo la messa in produzione, monitoriamo le prestazioni, aggiungiamo nuove fonti e gestiamo i processi di governance che garantiscono la coerenza delle definizioni condivise. Di solito, si tratta di una delle fasi più lunghe del progetto e una delle più facili da sottovalutare durante la pianificazione.

Servizi di data warehouse per il settore sanitario

Se state realizzando un DWH per il settore sanitario partendo da zero, avrete bisogno di un supporto diverso rispetto a quello necessario per correggere o ampliare un sistema esistente. Innowise può intervenire in entrambe le fasi e occuparsi del lavoro richiesto dalla vostra configurazione.

  • Consulenza in materia di data warehouse nel settore sanitario
  • Architettura e design
  • Sviluppo del DWH
  • Integrazione e migrazione dei dati
  • Modernizzazione del DWH legacy
  • Integrazione tra BI e analisi dei dati
  • Assistenza e ottimizzazione

Consulenza in materia di data warehouse nel settore sanitario

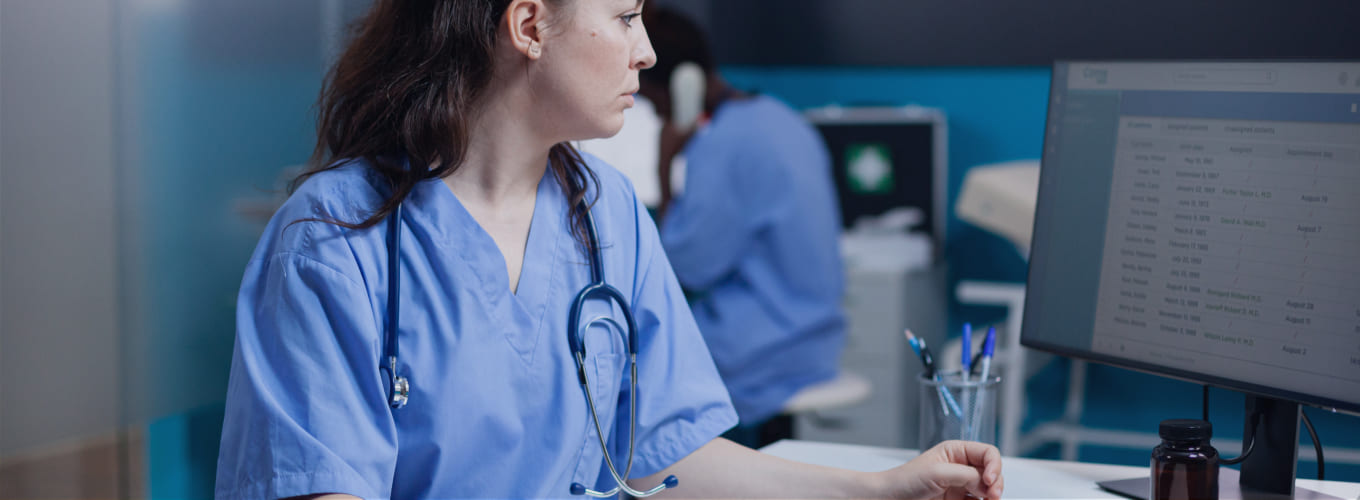
Se avete già problemi con la reportistica o disponete di un magazzino che non è più adeguato alle vostre esigenze, individuiamo insieme quali cambiamenti sono necessari. Il nostro team esamina la configurazione attuale e confronta le opzioni disponibili. A quel punto, vi aiutiamo a decidere quali casi d'uso dovrebbero avere la priorità.

Nurse reviews lab results and medication history in EHR system before patient rounds.

Architettura e design

Una volta concordati i requisiti, i nostri architetti progettano una struttura di magazzino su misura per i vostri sistemi e i carichi di lavoro previsti. Definiscono le modalità di interconnessione dei componenti principali e la posizione in cui vengono archiviati i dati condivisi. La struttura è quindi in grado di adattarsi a nuove fonti o esigenze di reporting man mano che si presentano.

Building layouts and style guides for a new web application project.

Sviluppo del DWH

Una volta approvato il progetto, i nostri ingegneri realizzano il DWH, compresa la logica di trasformazione e gli eventuali data mart necessari. Durante lo sviluppo, integrano controlli di qualità e di sicurezza, in modo che il data warehouse possa supportare i report e le analisi richiesti dal progetto.

IT specialist analyzing software code during an evening sprint session.

Integrazione e migrazione dei dati

Colleghiamo il data warehouse ai sistemi EHR/EMR, alle richieste di rimborso, ai laboratori, ai sistemi ERP/CRM e ad altri sistemi di origine. I dati storici vengono quindi trasferiti nel modello di destinazione con le mappature e le trasformazioni necessarie. Prima del passaggio definitivo, vengono effettuati controlli di riconciliazione per confrontare i dati migrati con quelli di origine.

Data engineer interacts with a visual dashboard to orchestrate real-time data synchronization across systems.

Modernizzazione del DWH legacy

Man mano che le fonti di dati e le esigenze di reporting cambiano, un data warehouse esistente potrebbe richiedere più di una semplice manutenzione ordinaria. Aggiorniamo i modelli di dati e le pipeline obsoleti, trasferiamo i carichi di lavoro quando la piattaforma attuale diventa un ostacolo e automatizziamo le attività ripetitive di gestione dei dati laddove è opportuno farlo.

IT operations team tracks software patch rollout in real time via a mobile device interface.

Integrazione tra BI e analisi dei dati

I nostri esperti collegano il data warehouse agli strumenti di BI e analisi già utilizzati dai vostri team. A seconda della configurazione, possono importare i dati o eseguire query direttamente sul data warehouse. Le metriche condivise e le regole di reporting rimangono in un unico posto, invece di dover essere ricreate in ogni dashboard.

Accessing a centralized analytics portal to evaluate company operations and outcomes.

Assistenza e ottimizzazione

Dopo il lancio, il data warehouse continua ad adattarsi alle vostre esigenze in termini di dati e reportistica. Il nostro team è in grado di risolvere eventuali problemi relativi alle pipeline o ai dati, aggiungere nuove fonti, ottimizzare le query lente e aggiornare i modelli quando cambiano i requisiti aziendali.

The consulting team reviews analytics on screen, focusing on data-driven IT strategy and solutions.
Consulenza in materia di data warehouse nel settore sanitario

Se avete già problemi con la reportistica o disponete di un magazzino che non è più adeguato alle vostre esigenze, individuiamo insieme quali cambiamenti sono necessari. Il nostro team esamina la configurazione attuale e confronta le opzioni disponibili. A quel punto, vi aiutiamo a decidere quali casi d'uso dovrebbero avere la priorità.

Nurse reviews lab results and medication history in EHR system before patient rounds.
Architettura e design

Una volta concordati i requisiti, i nostri architetti progettano una struttura di magazzino su misura per i vostri sistemi e i carichi di lavoro previsti. Definiscono le modalità di interconnessione dei componenti principali e la posizione in cui vengono archiviati i dati condivisi. La struttura è quindi in grado di adattarsi a nuove fonti o esigenze di reporting man mano che si presentano.

Building layouts and style guides for a new web application project.
Sviluppo del DWH

Una volta approvato il progetto, i nostri ingegneri realizzano il DWH, compresa la logica di trasformazione e gli eventuali data mart necessari. Durante lo sviluppo, integrano controlli di qualità e di sicurezza, in modo che il data warehouse possa supportare i report e le analisi richiesti dal progetto.

IT specialist analyzing software code during an evening sprint session.
Integrazione e migrazione dei dati

Colleghiamo il data warehouse ai sistemi EHR/EMR, alle richieste di rimborso, ai laboratori, ai sistemi ERP/CRM e ad altri sistemi di origine. I dati storici vengono quindi trasferiti nel modello di destinazione con le mappature e le trasformazioni necessarie. Prima del passaggio definitivo, vengono effettuati controlli di riconciliazione per confrontare i dati migrati con quelli di origine.

Data engineer interacts with a visual dashboard to orchestrate real-time data synchronization across systems.
Modernizzazione del DWH legacy

Man mano che le fonti di dati e le esigenze di reporting cambiano, un data warehouse esistente potrebbe richiedere più di una semplice manutenzione ordinaria. Aggiorniamo i modelli di dati e le pipeline obsoleti, trasferiamo i carichi di lavoro quando la piattaforma attuale diventa un ostacolo e automatizziamo le attività ripetitive di gestione dei dati laddove è opportuno farlo.

IT operations team tracks software patch rollout in real time via a mobile device interface.
Integrazione tra BI e analisi dei dati

I nostri esperti collegano il data warehouse agli strumenti di BI e analisi già utilizzati dai vostri team. A seconda della configurazione, possono importare i dati o eseguire query direttamente sul data warehouse. Le metriche condivise e le regole di reporting rimangono in un unico posto, invece di dover essere ricreate in ogni dashboard.

Accessing a centralized analytics portal to evaluate company operations and outcomes.
Assistenza e ottimizzazione

Dopo il lancio, il data warehouse continua ad adattarsi alle vostre esigenze in termini di dati e reportistica. Il nostro team è in grado di risolvere eventuali problemi relativi alle pipeline o ai dati, aggiungere nuove fonti, ottimizzare le query lente e aggiornare i modelli quando cambiano i requisiti aziendali.

The consulting team reviews analytics on screen, focusing on data-driven IT strategy and solutions.

Hai bisogno di modernizzare la tua infrastruttura per la gestione dei dati sanitari?

Fornitori di data warehouse per il settore sanitario

Se state valutando diverse piattaforme per un magazzino dedicato al settore sanitario, il vostro attuale ambiente cloud rappresenta un ottimo punto di partenza. Le opzioni riportate di seguito gestiscono i dati sanitari in modi diversi e presentano modelli di elaborazione e di tariffazione differenti.

Amazon-Redshift-Logo (1)

Amazon Redshift

Redshift si integra perfettamente quando la maggior parte dei dati è già ospitata su AWS. Funziona con S3 e AWS Glue, mentre HealthLake è in grado di esportare dati FHIR su S3 per analisi a valle tramite Redshift o altri servizi di analisi AWS.

Caratteristiche principali

  • SQL per dati strutturati e semi-strutturati
  • Accesso a S3 tramite Redshift Spectrum
  • Query federate ai database AWS supportati
  • Controlli di accesso a livello di riga e di colonna
  • Separazione tra risorse di calcolo e storage gestito
  • Servizio AWS conforme alla normativa HIPAA 

Prezzi

  • Prezzi on-demand per i cluster provisionati
  • Risorse di calcolo serverless fatturate in base all'utilizzo
  • Costi separati per lo stoccaggio gestito
  • Tariffe riservate per carichi di lavoro costanti
Azure Synapse Analytics

Azure Synapse Analytics

Synapse funziona bene quando i dati e i report sono già gestiti in Azure e i team utilizzano Power BI. Riunisce il data warehouse SQL e Spark in un unico spazio di lavoro, con pipeline per il trasferimento dei dati tra i servizi Azure. I dati FHIR provenienti dai servizi Health Data Services di Azure possono inoltre essere copiati in Synapse per essere analizzati.

Caratteristiche principali

  • SQL dedicato e serverless
  • Pool di Apache Spark
  • Query sul data lake Azure
  • Pipeline ETL/ELT integrate
  • Integrazioni ML Power BI e Azure
  • Analisi FHIR con Azure Health Data Services

Prezzi

  • SQL serverless con fatturazione in base ai dati elaborati
  • SQL dedicato fatturato in base al consumo di DWU
  • Spark fatturato in base all'utilizzo di vCore
  • Opzioni di pre-acquisto per carichi di lavoro garantiti

Per i team che desiderano maggiore libertà nella scelta dei provider cloud, Snowflake riduce la dipendenza del livello di data warehouse da un unico ecosistema. Funziona su AWS, Azure e Google Cloud, mentre i data warehouse virtuali separati consentono ai team di assegnare risorse di calcolo dedicate a carichi di lavoro diversi.

Caratteristiche principali

  • Opzioni di implementazione multi-cloud
  • Elaborazione indipendente per diversi carichi di lavoro
  • Magazzini multi-cluster su Enterprise Edition+
  • Supporto nativo dei dati semi-strutturati
  • Condivisione sicura dei dati
  • Assistenza PHI con Business Critical+

Prezzi

  • Crediti di calcolo basati sul consumo
  • Spese di deposito separate
  • Capacità su richiesta o prepagata 
  • Le tariffe variano a seconda del servizio cloud, della regione e dell’edizione
GCP BigQuery

Google BigQuery

BigQuery è la soluzione ideale per le organizzazioni che utilizzano già il modello Google Cloud o che desiderano un data warehouse serverless senza dover gestire cluster di elaborazione. L'API Cloud Healthcare consente di esportare risorse FHIR e metadati DICOM su BigQuery, offrendo ai team di analisi l'accesso ai dati sanitari tramite SQL.

Caratteristiche principali

  • Data warehouse SQL serverless
  • Separazione tra archiviazione ed elaborazione
  • Funzionalità di apprendimento automatico integrate
  • Query esterne e federate
  • Integrazione dell'API Cloud per il settore sanitario
  • BigQuery è coperto dall'accordo BAA HIPAA di Google Cloud

Prezzi

  • Risorse di calcolo on-demand fatturate in base ai dati elaborati
  • Tariffazione in base alla capacità, basata sugli slot
  • Spazio di archiviazione fatturato separatamente
  • Impegni disponibili per la capacità riservata

Costi e tempistiche

I budget per i data warehouse nel settore sanitario possono variare di oltre un ordine di grandezza. Un data mart di produzione di dimensioni limitate, con un paio di fonti ben strutturate, può costare circa $60.000–$100.000 e richiedere 2–4 mesi. Un data warehouse aziendale multisistema con migrazione dei dati storici e diversi data mart può raggiungere un costo compreso tra $400.000 e $1 milione o più e richiedere da 9 a 18 mesi o anche di più.

Scala del progettoAmbito di applicazione tipicoLinea temporaleBilancio di attuazioneCosti ricorrenti relativi al cloud e al software
Data mart di dipartimento1–2 sistemi sorgente, un unico reparto, cronologia limitata, reportistica BI di base2–4 mesi$60k–$100k$1k–$5k al mese
Data warehouse di medie dimensioni per il settore sanitario3–6 fonti, modello di dati condiviso, migrazione dei dati storici, 2–4 data mart, integrazione BI5–9 mesi$150k–$350k$5k–$20k al mese
DWH aziendale / lakehouseOltre 7 fonti, dati storici esaustivi, diversi mercati, integrazioni cliniche personalizzate, analisi avanzate9–18+ mesi$400k–$1m+da $20k a $80k+ al mese

Soluzioni sanitarie fornite da Innowise

Perché scegliere noi

Un progetto di DWH nel settore sanitario si colloca a metà strada tra l'ingegneria dei dati e il settore sanitario IT. Innowise vanta esperienza in entrambi i campi, supportata da certificazioni ISO pertinenti e da partnership con i fornitori di servizi cloud e di dati utilizzati nei progetti di data warehouse.

Esperienza nel settore sanitario

Vantiamo oltre 19 anni di esperienza nel settore sanitario IT, che comprende la gestione di cartelle cliniche elettroniche (EHR), sistemi di laboratorio, diagnostica per immagini e piattaforme sanitarie connesse. Tale esperienza è fondamentale quando i flussi di lavoro clinici o gli standard relativi ai dati sanitari determinano la progettazione del data warehouse.

Competenze nel campo dell'ingegneria dei dati

I nostri team dedicati ai dati utilizzano Snowflake, BigQuery, Amazon Redshift e Azure Synapse, insieme agli strumenti ETL/ELT e di orchestrazione che li supportano. Ciò significa che possiamo progettare il data warehouse in base allo stack esistente del cliente, anziché a una piattaforma specifica.
Certificazioni pertinenti

Innowise è in possesso delle certificazioni ISO 9001, ISO 27001 e ISO 13485, relative rispettivamente alla qualità, alla sicurezza delle informazioni e ai dispositivi medici.

Registro delle consegne

Il nostro portfolio comprende oltre 1.600 progetti in diversi settori e oltre 60 soluzioni IT nel settore sanitario. Per un’azienda che opera nel campo della medicina di precisione, noi miglioramento delle pipeline di dati e dell'infrastruttura AWS utilizzato per elaborare dati diagnostici provenienti da più fonti.

Esperienza in materia di sicurezza e conformità

I nostri team sanitari operano nel rispetto dei requisiti HIPAA e GDPR e degli standard di scambio dei dati sanitari quali HL7 v2 e FHIR. Tale esperienza risulta fondamentale quando dati sanitari sensibili vengono trasferiti dal data warehouse ai sistemi clinici soggetti a normative.

Partnership tecnologiche

In qualità di partner di AWS, Microsoft, Google Cloud e Databricks, Innowise mette a disposizione competenze certificate sulle piattaforme per i progetti di DWH e può avvalersi del supporto dei fornitori qualora dovessero sorgere problemi specifici relativi alle piattaforme.

ISO 13485 certification.
ISO 9001 certification.
ISO/IEC 27001 certification.
GDPR
Select partner AWS
Google_Cloud_Partner

Conclusione

Non inizierei un progetto di data warehouse sanitario cercando di trasferire tutti i set di dati in un unico posto. Scegliete invece un problema di reporting o di analisi che valga la pena risolvere e collegate solo i sistemi necessari per tale attività. Ad esempio, potreste iniziare con il reporting sul ciclo dei ricavi o con l’analisi delle riammissioni. Una volta che il sistema funziona, potrete decidere di cosa avrà bisogno il data warehouse in seguito, in base alla domanda effettiva. 

Questo approccio dovrebbe essere mantenuto man mano che il progetto si espande. È opportuno aggiungere nuove fonti o data mart solo quando vi è una ragione chiara, anziché cercare di anticipare ogni possibile esigenza futura. L’importante è mantenere coerenti le definizioni e le regole di accesso man mano che il data warehouse si espande e assicurarsi che i requisiti di conformità siano sempre soddisfatti. 

Se avete bisogno di assistenza esterna, gli specialisti di Hub Innowise per il settore sanitario e farmaceutico IT possiamo analizzare il vostro data warehouse esistente o aiutarvi a crearne uno su misura per i vostri sistemi sanitari e le vostre esigenze di reporting, tenendo conto dei requisiti di conformità relativi ai dati sanitari.
FAQ

Un data warehouse sanitario conserva dati già elaborati per la reportistica e l'analisi. Un data lake, invece, contiene solitamente volumi maggiori di dati grezzi o leggermente elaborati. In molte architetture, il data lake ospita set di dati più ampi, mentre il data warehouse contiene i dati di cui i team hanno bisogno per le analisi cliniche, finanziarie o operative ricorrenti.

I tempi variano a seconda dell'ambito, dei sistemi di origine e della qualità dei dati. La realizzazione di un data mart mirato con poche integrazioni può richiedere dai 2 ai 4 mesi. L'implementazione di un data warehouse aziendale di grandi dimensioni nel settore sanitario può richiedere dai 9 ai 18 mesi o più, qualora il progetto preveda la migrazione di dati legacy, integrazioni multiple e diversi data mart.

La scelta del modello di data warehouse sanitario più adatto dipende dal numero di team che necessitano dei dati e dall’opportunità che questi utilizzino le stesse definizioni di reporting. Un modello aziendale supporta il reporting a livello dell’intera organizzazione, mentre i data mart indipendenti si concentrano su reparti specifici o casi d’uso specifici. Un modello ibrido combina un nucleo condiviso con data mart più mirati. La progettazione del data warehouse sanitario dovrebbe riflettere i casi d’uso che è necessario supportare in via prioritaria.

Sì. Possiamo modernizzare il vostro data warehouse sanitario esistente senza sostituirlo tutto in una volta. Il nostro team ricostruisce le pipeline obsolete, rivede i modelli di dati, trasferisce determinati carichi di lavoro e integra nuovi strumenti di analisi in modo graduale. L’automazione del data warehouse sanitario riduce inoltre il lavoro manuale nell’acquisizione dei dati e nei controlli periodici sulla qualità dei dati.
Innowise progetta il data warehouse in conformità con i requisiti HIPAA sin dall'inizio, con l'accesso alle informazioni sanitarie protette (PHI) limitato in base al ruolo e controlli di sicurezza integrati nei flussi di dati. Inoltre, convalidiamo i dati mentre transitano nel data warehouse, verificando la presenza di mappature errate, record di pazienti duplicati o valori alterati prima che questi possano influire sulla reportistica.
Mostra tutto

Indice dei contenuti

    Contattaci

    Prenota una chiamata oppure compila il modulo qui sotto e ti ricontatteremo non appena avremo elaborato la richiesta.

    Inviaci un messaggio vocale
    Allega i documenti
    Carica il file

    È possibile allegare 1 file di dimensioni massime di 2 MB. Formati di file validi: pdf, jpg, jpeg, png.

    Facendo clic su «Invia», acconsenti al trattamento dei tuoi dati personali da parte di Innowise in conformità con la nostra Informativa sulla privacy per fornirti informazioni pertinenti. Inviando il tuo numero di telefono, accetti che possiamo contattarti tramite chiamate vocali, SMS e app di messaggistica. Potrebbero essere applicati costi per chiamate, messaggi e traffico dati.

    Puoi anche inviarci la tua richiesta
    a contact@innowise.com
    Cosa succede dopo?
    1

    Una volta ricevuta e presa in carico la richiesta, ti ricontatteremo per approfondire le esigenze del progetto e firmare un NDA per tutelare la riservatezza.

    2

    Dopo aver chiarito esigenze, obiettivi e aspettative, il nostro team elabora una proposta che definisce le attività previste, la composizione del team, le tempistiche e i costi stimati.

    3

    Fisseremo un incontro per discutere la proposta e definire tutti i dettagli.

    4

    Infine, firmeremo il contratto e inizieremo subito a lavorare sul tuo progetto.

    Altri servizi che copriamo

    arrow