Entrepôt de données dans le secteur de la santé : avantages, architecture et cas d'utilisation

21 septembre 2026 12 minutes de lecture
Aleh Yafimau, Healthcare and MedTech Delivery Manager..
Consultant en santé IT
Expert certifié
Chaque article publié sur Innowise est rédigé par des auteurs dotés d'une expérience concrète. Ils maîtrisent le sujet au-delà de la théorie et apportent un éclairage issu de projets réels.
Plus de 19 ans d'expérience
Expert certifié
Plus de 19 ans d'expérience
Aleh fait le lien entre les besoins cliniques et l'exécution technique. Il applique une connaissance approfondie du domaine pour s'assurer que les systèmes MedTech ne sont pas seulement conformes, mais aussi suffisamment fiables pour avoir un impact mesurable sur les soins de santé dans le monde réel.
Expertise
Informatique de santé Medtech Algorithmes
Parlonsen

Principaux enseignements

  • Lorsque les données relatives aux patients, aux demandes de remboursement, aux analyses de laboratoire, aux opérations financières et aux activités opérationnelles sont stockées dans différents systèmes, l'établissement de rapports nécessite généralement un rapprochement manuel des informations provenant de ces différentes sources. A hentrepôt de données de santé regroupe les données issues de ces systèmes afin que les équipes puissent les utiliser à des fins de reporting et d'analyse.
  • Même l'entrepôt de données le mieux conçu ne peut pas compenser une mauvaise qualité des données. Des problèmes tels que les doublons dans les dossiers des patients, les formats incohérents et les définitions contradictoires peuvent nuire à la fiabilité des rapports.
  • Le modèle d'entrepôt de données définit l'étendue du partage des données et des définitions communes. Un entrepôt de données d'entreprise (DWH) sert à l'établissement de rapports à l'échelle de l'organisation, tandis que les « data marts » sont conçus autour de services spécifiques ou de cas d'utilisation particuliers. Les architectures hybrides combinent les deux. 
  • L'analyse de rentabilité doit s'articuler autour des décisions que le centre de données doit permettre de prendre, qu'il s'agisse de la santé publique et de l'évaluation des risques pour les patients, de la recherche clinique, de l'analyse des demandes de remboursement ou encore de la planification des effectifs et des capacités.
Résumé par l'IA

Si vos dossiers patients, vos résultats d'analyses, vos demandes de remboursement et vos données opérationnelles sont dispersés dans différents systèmes, obtenir une réponse fiable peut demander plus de travail que l'analyse elle-même. Les équipes peuvent être amenées à recouper les dossiers et à vérifier la signification réelle des chiffres avant de pouvoir les exploiter. A entrepôt de données de santé (DWH) regroupe les données issues de ces systèmes et les structure en vue de la création de rapports et de l'analyse.

Dans cet article, je vais vous expliquer comment est conçu un entrepôt de données (DWH) dédié au secteur de la santé et quelles sont les fonctionnalités qui comptent dans la pratique. Nous aborderons également les principaux modèles d’entrepôt de données, les cas d’utilisation courants dans le secteur de la santé, les avantages opérationnels, les défis liés à la mise en œuvre, ainsi que les décisions à prendre avant le lancement du projet.

Qu'est-ce qu'un entrepôt de données de santé ?

​ entrepôt de données de santé Il s'agit d'un environnement centralisé où les données issues de différents systèmes de santé sont nettoyées, harmonisées et préparées en vue de la production de rapports et de l'analyse. Il permet de combiner les données des dossiers médicaux électroniques (DME) et des dossiers de santé électroniques (DSE) avec les données relatives aux demandes de remboursement, les résultats de laboratoire, les données issues du portail patient, les enregistrements des systèmes ERP ou CRM, ainsi que les données provenant d'appareils connectés.

Une base de données opérationnelle sert généralement à prendre en charge une application et ses opérations quotidiennes. Un entrepôt de données (DWH) est conçu pour répondre à des questions nécessitant des données provenant simultanément de plusieurs systèmes. Si un hôpital souhaite comprendre pourquoi le nombre de réadmissions est en hausse, par exemple, les analystes peuvent comparer les diagnostics et l’historique des traitements avec les demandes de remboursement, les résultats d’analyses et les données relatives au personnel, au lieu d’extraire chaque ensemble de données séparément.

Contrairement à un entrepôt de données (DWH), un lac de données stocke généralement des données avant qu'elles n'aient été structurées en vue d'une utilisation analytique spécifique. Il peut contenir de grands volumes de données brutes ou légèrement traitées, dans différents formats. Un entrepôt de données (DWH), en revanche, contient des données préparées que les équipes peuvent utiliser pour la business intelligence (BI), les rapports récurrents et les analyses continues.

Base de données opérationnelleEntrepôt de donnéesLac de données
Objectif principalExécuter les transactions quotidiennes des applicationsRegrouper les données provenant de plusieurs systèmes sous une forme permettant aux équipes de les exploiter et de les analyserConserver de grands volumes de données de différents types en vue d'une utilisation ultérieure
Sources des donnéesDonnées créées et utilisées par les applications opérationnellesDonnées issues des dossiers médicaux électroniques (DME), des systèmes de gestion des demandes de remboursement, des progiciels de gestion intégrée (ERP), des systèmes de gestion de la relation client (CRM) et d'autres systèmes cliniques ou de gestion d'entrepriseDes données provenant de nombreuses sources, notamment des données structurées, semi-structurées et non structurées
Comment les données sont-elles stockées ?Structuré en fonction des besoins de l'applicationNettoyées et organisées en fonction des besoins en matière de reporting et d'analyseSouvent conservée proche de sa forme d'origine et structurée lorsque le cas d'utilisation l'exige
Utilisation courante dans le domaine de la santéTransactions liées au dossier médical électronique (DME), rendez-vous ou activités CRMRapports inter-systèmes, intelligence d'affaires et analyse des données de santéEnsembles de données à grande échelle, analyses exploratoires ou charges de travail d'apprentissage automatique

Architecture d'un entrepôt de données dans le secteur de la santé

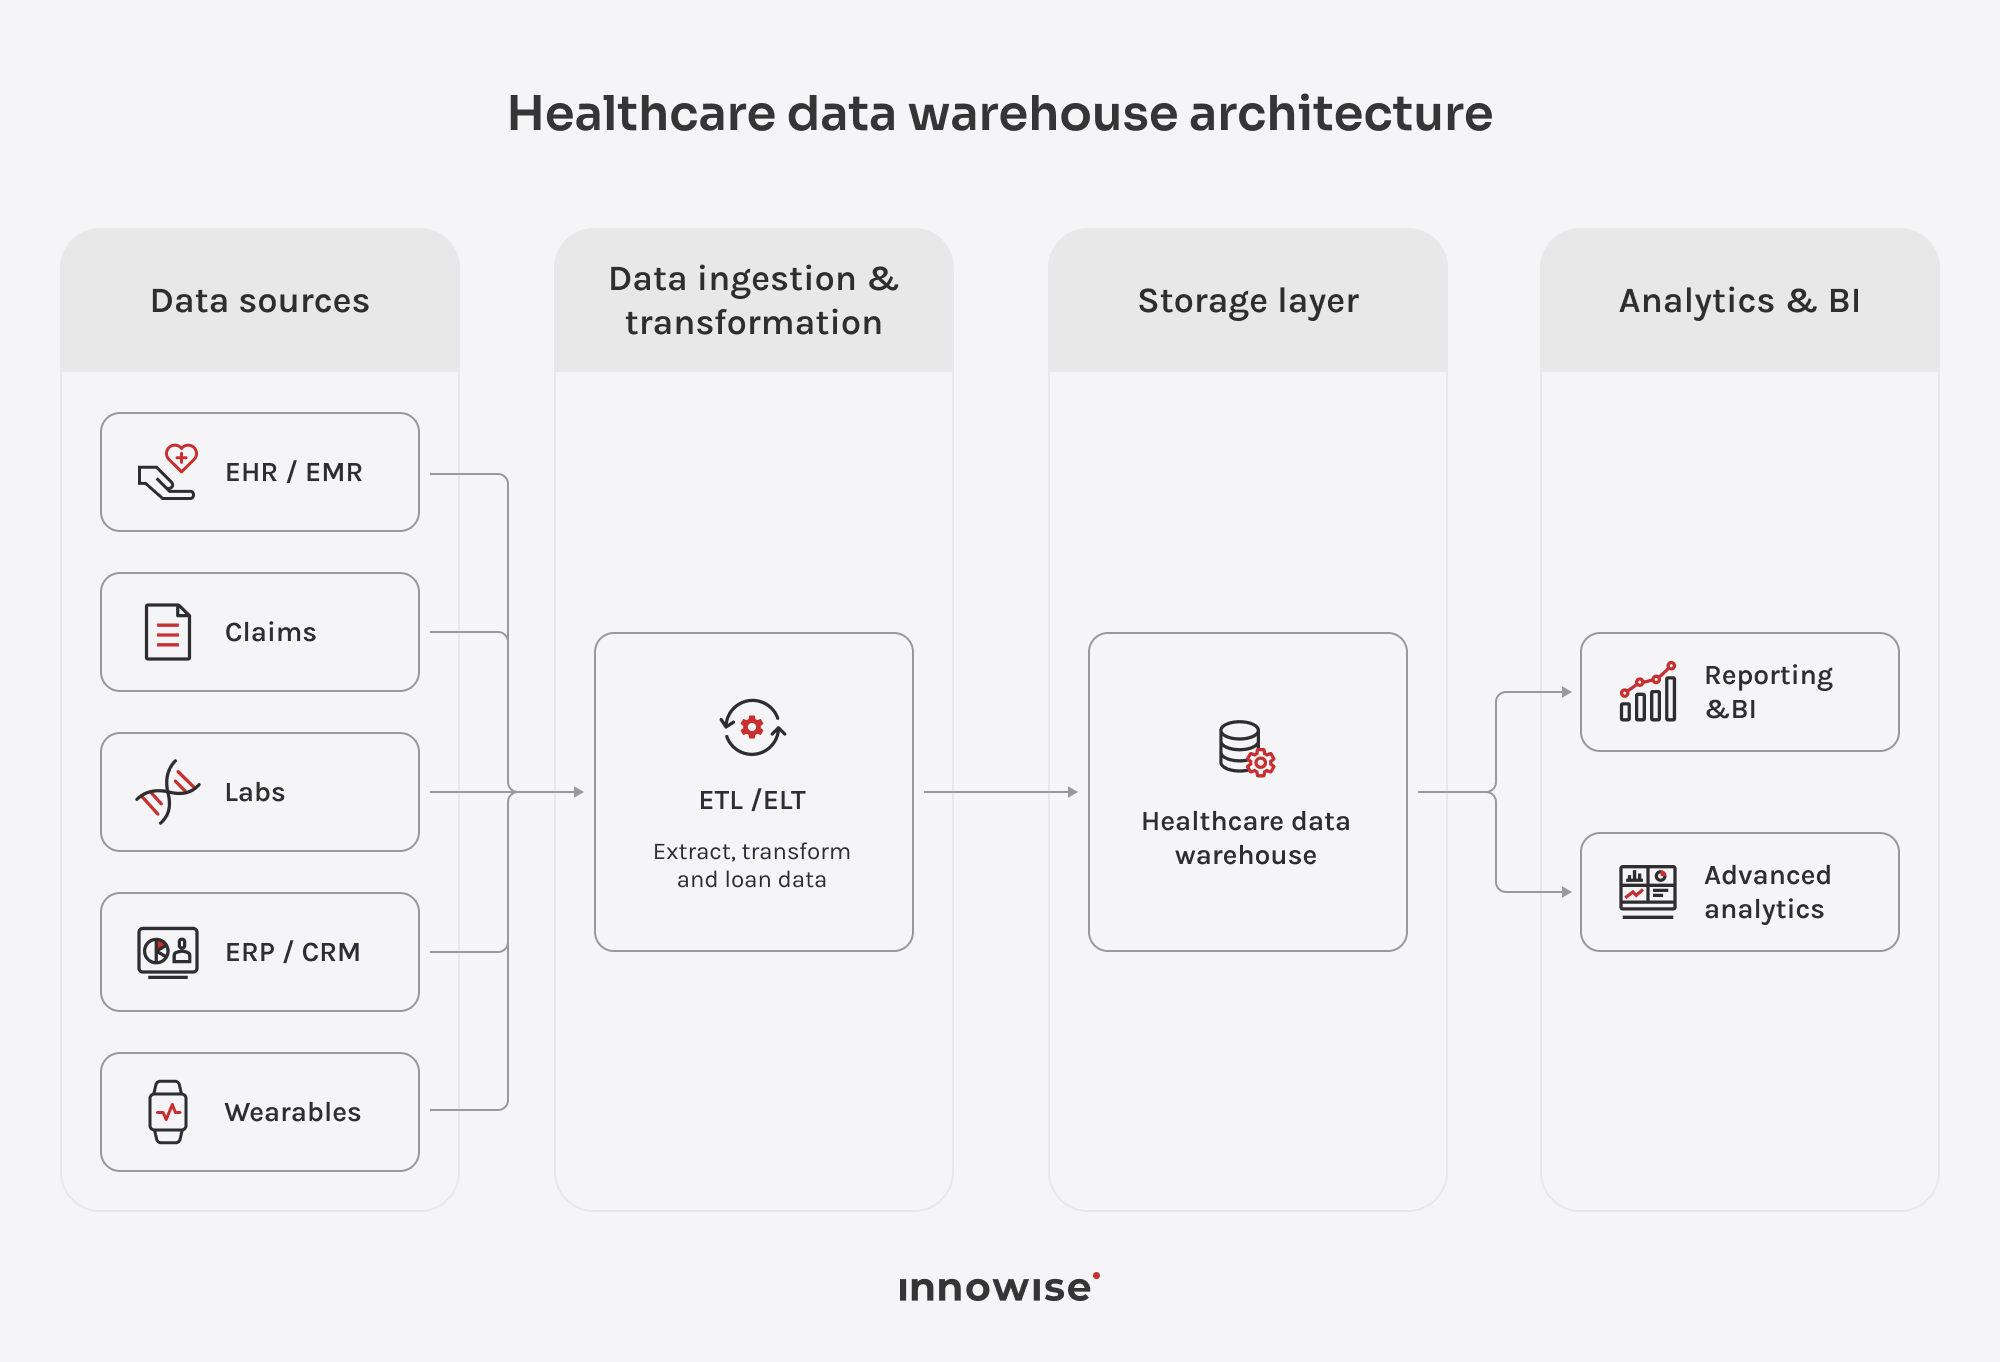
Pour mieux comprendre le fonctionnement d'un entrepôt de données de santé, examinons les principales couches qui le composent. Chacune d'entre elles joue un rôle spécifique dans le transfert des données depuis les systèmes sources vers le stockage, puis dans leur mise à disposition pour la création de rapports, l'analyse et les applications.

Sources des données

La couche source comprend les systèmes déjà utilisés dans le cadre des activités cliniques et opérationnelles, tels que les dossiers médicaux électroniques (DME) et les dossiers de santé électroniques (DSE), les plateformes de prise en charge des demandes de remboursement, les systèmes LIS et RIS/PACS, ainsi que les logiciels ERP ou CRM. Un même patient ou événement peut être enregistré différemment selon ces systèmes ; il est donc nécessaire d'harmoniser les formats et de faire correspondre les identifiants avant de pouvoir exploiter ces données conjointement.

Ingestion et ETL/ELT

Cette couche collecte les données sources et les prépare en vue de leur analyse. Avec l'ETL, les données sont transformées avant d'être chargées dans l'entrepôt ; avec l'ELT, la transformation a lieu après le chargement. Le processus peut également inclure la normalisation des formats, la suppression des doublons et le stockage temporaire.

Stockage

La couche de stockage conserve les données historiques dans une structure conçue pour le reporting et l'analyse. Selon l'architecture, elle peut également fournir des « data marts » destinés à un service spécifique ou à un cas d'utilisation particulier.

Analyse de données et BI

Les outils de BI exploitent les données de l'entrepôt pour générer des tableaux de bord et des rapports récurrents, tandis que les analystes peuvent effectuer des requêtes ad hoc sur ce même ensemble de données. Les équipes disposent ainsi d'une source commune pour leurs analyses, ce qui leur évite de devoir recréer la logique pour chaque rapport.

Applications

Les données du data warehouse peuvent également alimenter des applications cliniques ou métier en aval. Les outils de recherche ou les systèmes de planification, par exemple, peuvent exploiter les données préparées issues du data warehouse au lieu de se connecter séparément à chaque système source.

Vous avez besoin d'une vue d'ensemble fiable sur les données cliniques et opérationnelles ?

Principales caractéristiques et fonctionnalités

Maintenant que nous avons abordé l'architecture, je vais passer en revue les fonctionnalités que vous êtes susceptible de retrouver dans un entrepôt de données dédié au secteur de la santé. Chaque organisation présente des spécificités, mais les besoins sont souvent similaires lorsqu'il s'agit de regrouper des données provenant de différents systèmes tout en garantissant leur exploitabilité à des fins de reporting et d'analyse.

Intégration des données et ETL/ELT

Les systèmes de santé stockent souvent les mêmes informations de manière différente. Un dossier médical électronique (DME), une plateforme de prise en charge des demandes de remboursement ou un système de laboratoire peut utiliser des champs et des formats différents pour des enregistrements comparables. Les pipelines ETL et ELT collectent ces données et les harmonisent dans l’entrepôt de données en vue de leur analyse. En fonction de la fréquence à laquelle les données évoluent, les pipelines peuvent s’exécuter selon un calendrier défini, ne charger que les nouveaux enregistrements ou traiter les mises à jour au fur et à mesure de leur arrivée.

Les données de santé font également l'objet de modifications rétroactives : les résultats d'analyses sont corrigés, les consultations sont mises à jour ou annulées, et les demandes de remboursement sont ajustées ou invalidées. Les pipelines doivent appliquer ces modifications aux enregistrements déjà chargés ; sinon, une nouvelle génération du rapport du mois dernier risquerait de ne plus correspondre à la source.

Qualité des données et déduplication

Les doublons dans les dossiers des patients et les valeurs contradictoires peuvent fausser les rapports une fois que les données parviennent dans l'entrepôt de données. Les contrôles de qualité permettent de détecter les données manquantes ou invalides, tandis que les règles de mise en correspondance aident à relier les dossiers appartenant à un même patient d'un système à l'autre. Les équipes ont besoin de ce nettoyage avant de comparer les résultats ou d'élaborer des analyses.

Gestion des métadonnées

Les métadonnées expliquent la signification de chaque champ et d'où proviennent les données. Elles enregistrent également les modifications apportées avant que les données n'atteignent l'entrepôt. Les analystes peuvent ainsi remonter jusqu'à la source d'un chiffre affiché dans un tableau de bord et vérifier quelle définition a été utilisée.

Gouvernance des données

La gouvernance des données définit qui est propriétaire des données et quelles définitions chacun doit utiliser. En l'absence de règles claires, deux services peuvent utiliser le même entrepôt de données et pourtant communiquer des chiffres différents pour un même indicateur. Les propriétaires et les gestionnaires des données examinent les modifications et veillent à la cohérence de ces définitions au fil du temps.

Sécurité et contrôle d'accès

Un entrepôt de données de santé peut contenir des informations médicales protégées (PHI) ainsi que des données opérationnelles ou financières sensibles ; l'accès ne peut donc pas être le même pour tout le monde. Les autorisations permettent de limiter ce qu'un utilisateur peut voir en fonction de son rôle et, si nécessaire, jusqu'au niveau de lignes ou de colonnes spécifiques. Le chiffrement protège les données en stockage et lors de leur transfert, tandis que les journaux d'audit indiquent qui y a accédé.

Prise en charge des données structurées et semi-structurées

La plupart des rapports récurrents utilisent des tables structurées, mais les systèmes de santé génèrent également des données dans d’autres formats. Les API et les appareils connectés, par exemple, peuvent envoyer des données au format JSON. Un entrepôt de données peut traiter ces données sans avoir à convertir au préalable chaque champ en une table fixe. Les fichiers non structurés, tels que les images médicales, sont généralement conservés dans un lac de données ou un système de stockage d’objets et sont reliés aux données de l’entrepôt lorsque cela s’avère nécessaire.

Évolutivité et performance

À mesure que le volume de données stockées et le nombre de requêtes augmentent, l'entrepôt de données doit continuer à garantir une réactivité optimale des rapports. Les plateformes peuvent recourir au partitionnement, à l'indexation, à la mise en cache ou à des ressources de calcul distinctes pour gérer des charges de travail plus importantes sans avoir à remanier l'architecture de l'entrepôt de données.

Interopérabilité

Un entrepôt de données de santé doit échanger des données avec les dossiers médicaux électroniques (DME), les systèmes de laboratoire et d'autres plateformes cliniques. Les normes HL7, telles que FHIR et HL7 v2, fournissent aux équipes des formats communs pour ces échanges, ce qui réduit le recours au mappage personnalisé. Les systèmes hérités ou propriétaires peuvent toutefois nécessiter des connecteurs personnalisés avant que l'entrepôt puisse exploiter leurs données.

Dans le cadre de projets liés au secteur de la santé, je ne considérerais pas les résultats ou les coûts de manière isolée. Un entrepôt de données (DWH) permet de comparer des éléments tels que la durée d’hospitalisation et les réadmissions avec l’utilisation des ressources et le temps de travail du personnel. C’est essentiel dans le cadre des soins axés sur la valeur, où il faut à la fois comprendre le résultat obtenu et ce qu’il a fallu pour y parvenir.
Philip Tikhanovich, Head of Big Data.
Philip Tikhanovich
Chef du service Big Data

Intégrations d'entrepôts de données dans le secteur de la santé

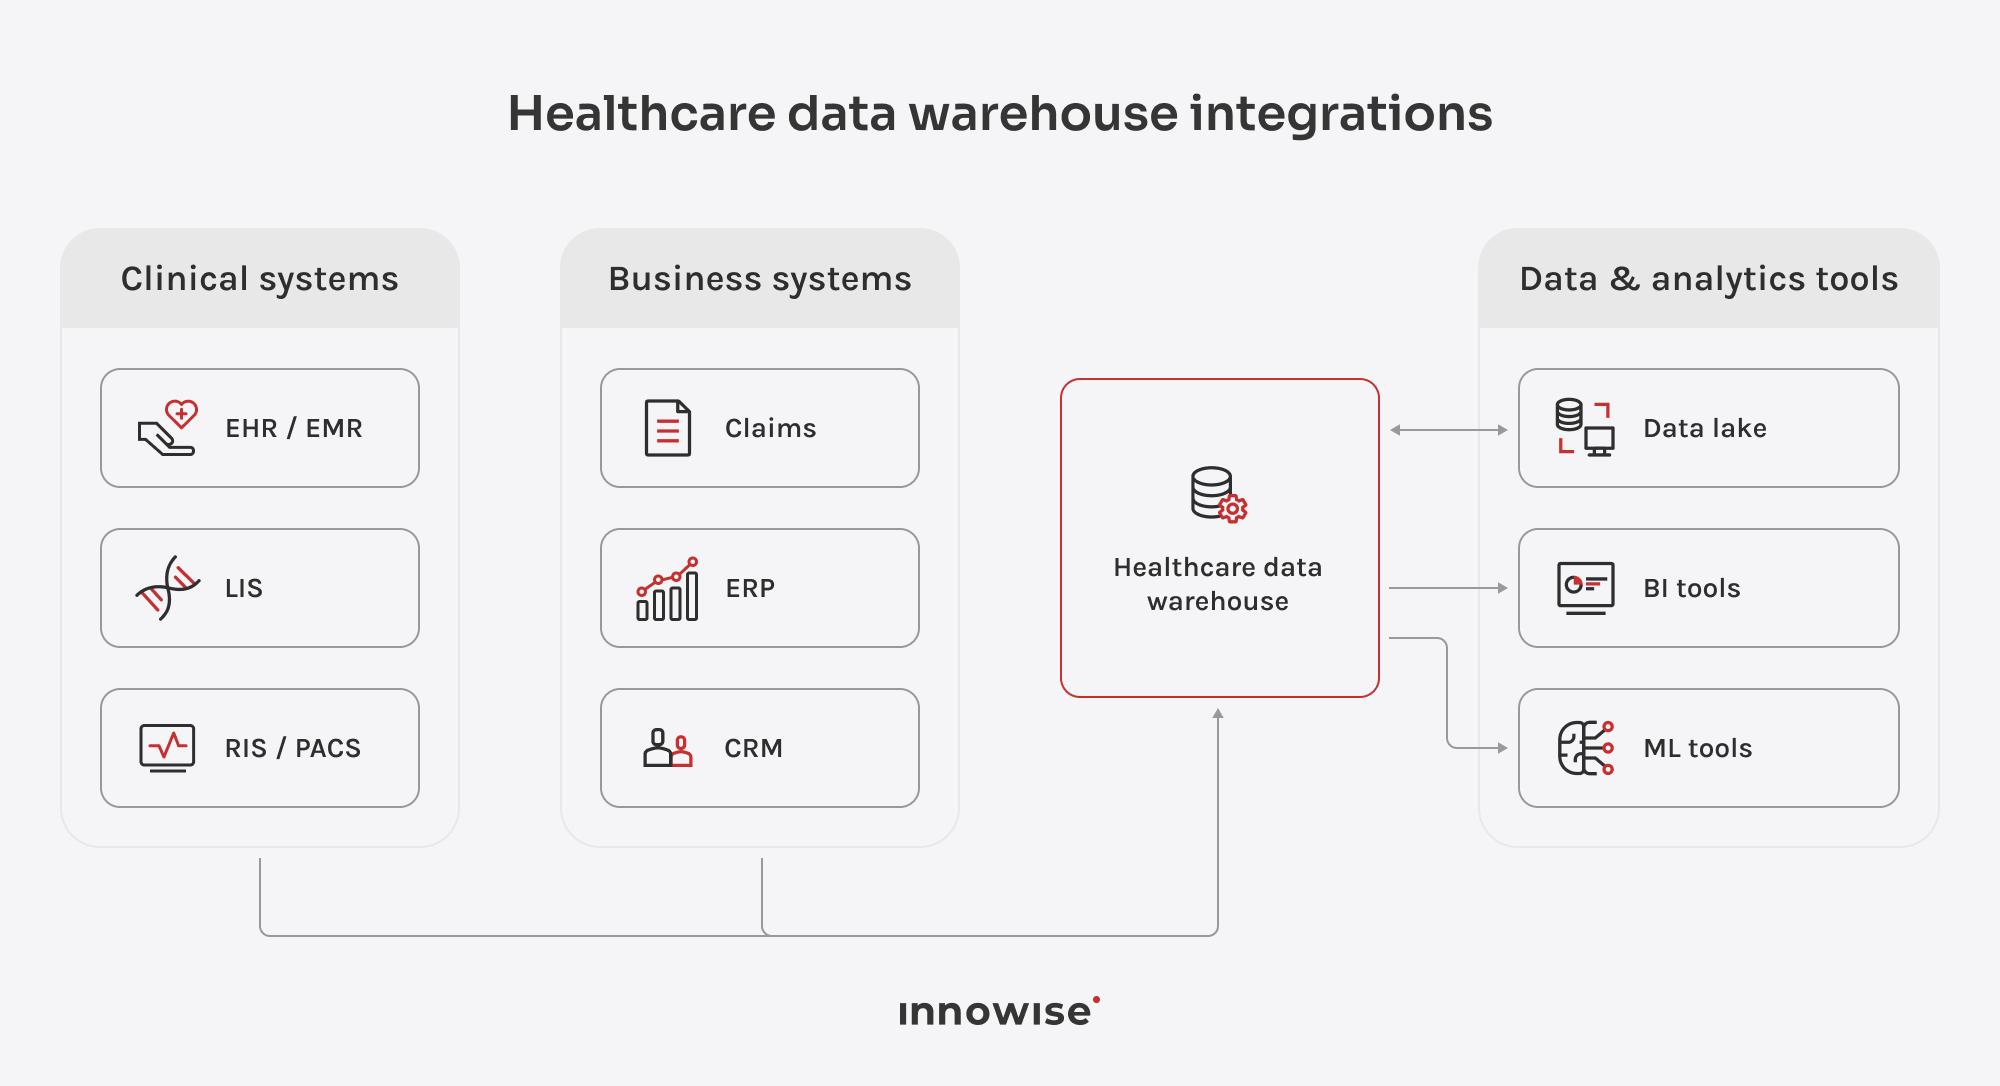
Si vous mettez en place un entrepôt de données cliniques dans le secteur de la santé, vous connecterez généralement les systèmes que vos équipes utilisent déjà au quotidien. Les intégrations les plus courantes permettent d'importer des données provenant de systèmes cliniques et métier, puis de les mettre à la disposition des outils de BI et d'apprentissage automatique.

Systèmes cliniques

Les systèmes de DME (dossier médical électronique) et de DME (dossier médical informatisé) transmettent généralement des données cliniques structurées via des API FHIR ou des flux HL7 v2. Le protocole FHIR convient bien aux ressources telles que les « patients » et les « consultations », tandis que le protocole HL7 v2 reste couramment utilisé pour les événements hospitaliers et les résultats de laboratoire. Les systèmes LIS (systèmes d'information de laboratoire) utilisent souvent des messages HL7 v2 ORU pour transmettre les résultats d'analyses vers l'entrepôt de données.

La radiologie fonctionne différemment, car les données d'imagerie sont généralement conservées en dehors de l'entrepôt proprement dit. Le système PACS ou le stockage objet conserve les images, tandis que l'entrepôt stocke le rapport et les métadonnées de l'examen, avec des liens vers le fichier DICOM correspondant.

Systèmes d'entreprise

Les systèmes de gestion des demandes de remboursement indiquent les montants facturés par les prestataires et ceux remboursés par les payeurs. Aux États-Unis, l'échange de données s'effectue souvent via des transactions X12, notamment les fichiers de demandes de remboursement 837 et les fichiers de décompte 835. La conservation des données tant au niveau de la demande qu'au niveau des lignes de facturation permet aux analystes de comparer les coûts totaux avec les services individuels qui les composent.

Les systèmes ERP fournissent des données sur les coûts et les effectifs, tandis que les systèmes CRM recensent les interactions avec les patients en dehors du dossier médical. Lorsque les équipes combinent ces informations avec les données cliniques, elles peuvent se pencher sur des questions telles que : les rappels de rendez-vous améliorent-ils le taux de présence ? Les effectifs sont-ils adaptés à l'activité clinique ?.

Données et analyses

Un « data lake » stocke des données brutes ou moins structurées avant que les équipes ne les préparent pour l'entrepôt de données. Certains ensembles de données peuvent être nettoyés dans le « data lake », puis chargés dans l'entrepôt. Dans certaines configurations, l'entrepôt interroge directement les données du « data lake » au lieu de les copier au préalable.

Les outils de BI tels que Power BI ou Tableau se connectent à l'entrepôt de données via des connecteurs natifs ou ODBC/JDBC et lisent les données préparées. Les plateformes d'apprentissage automatique utilisent les données historiques de l'entrepôt pour l'entraînement ou l'évaluation, puis renvoient les résultats des modèles, tels que les scores de risque, vers l'entrepôt de données à des fins de reporting ou pour d'autres applications.

Avantages pour l'entreprise

Si vous évaluez la rentabilité d'un entrepôt de données dédié au secteur de la santé, je vous conseille d'examiner les changements que cela implique pour les équipes qui utilisent ces données. C'est dans les avantages d'un entrepôt de données d'entreprise dans le secteur de la santé, énumérés ci-dessous, que cet impact se manifeste généralement le plus clairement.

Des rapports plus rapides

Au lieu d'extraire des données de plusieurs systèmes et de les rapprocher manuellement, les équipes peuvent travailler à partir des données déjà préparées dans l'entrepôt. La création des rapports récurrents demande moins d'efforts, et les analystes peuvent consacrer davantage de temps à l'analyse des chiffres plutôt qu'à leur compilation.

Vue unifiée du patient

Les données cliniques, les dossiers de remboursement et les autres informations relatives aux patients peuvent être mises en relation entre les différents systèmes sources afin d'offrir aux équipes une vision plus complète de l'historique d'un patient. Cela facilite le suivi des soins d'une consultation à l'autre, sans avoir à passer d'un dossier à l'autre.

De meilleures décisions cliniques

Les cliniciens et les analystes peuvent exploiter les données historiques provenant de l'ensemble de l'établissement pour répondre à des questions qui font appel à plusieurs systèmes. Ce contexte plus large facilite la prise de décision concernant les schémas thérapeutiques, les risques pour les patients et la qualité des soins.

Optimisation des coûts et des ressources

Le recoupement des données cliniques avec les données financières ou opérationnelles permet aux hôpitaux de mieux cerner l'affectation de leurs ressources. Les équipes peuvent ainsi comparer les volumes de prestations avec les effectifs ou les coûts, et s'appuyer sur ces résultats pour planifier leurs capacités.

Une meilleure analyse des sinistres

Une fois que les demandes de remboursement et les données cliniques sont regroupées dans un même entrepôt de données, les analystes peuvent comparer les prestations facturées aux soins consignés par les praticiens. Ils peuvent ainsi déterminer les raisons pour lesquelles les assureurs ont rejeté certaines demandes ou les ont sous-remboursées, et repérer les problèmes récurrents en matière de facturation.

Analyse prédictive

Comme la base de données centralise l'historique des données, les équipes peuvent s'en servir pour anticiper l'évolution probable de la situation. Un modèle peut ainsi signaler les patients présentant un risque accru de réadmission ou prévoir les périodes de forte demande. Les équipes soignantes et opérationnelles peuvent alors planifier plus tôt les soins de suivi ou les besoins en personnel.

Soutien à la recherche

Les chercheurs ont souvent besoin de dossiers portant sur un grand nombre de patients et couvrant de longues périodes. Un entrepôt de données leur fournit des données prêtes à être utilisées pour des analyses de cohortes ou des études rétrospectives, sans qu'ils aient à reconstituer à chaque fois l'ensemble de données à partir de systèmes distincts.

Analyse des soins axés sur la valeur

Dans le cadre des soins axés sur la valeur, les équipes doivent savoir si les ressources qu'elles utilisent permettent réellement d'obtenir de meilleurs résultats. Lorsque la base de données relie les résultats aux données d'utilisation des ressources, les analystes peuvent comparer différents groupes de patients et déterminer si une augmentation des dépenses ou un recours plus important aux services se traduit par de meilleurs résultats en matière de soins.

Défis courants liés aux entrepôts de données (DWH) dans le secteur de la santé

Les avantages que j’ai évoqués plus haut s’accompagnent de quelques défis liés à la mise en œuvre, mais ceux-ci sont bien plus faciles à gérer lorsqu’on les anticipe dès le départ. Une équipe expérimentée est capable d’identifier bon nombre de ces risques avant qu’ils ne se traduisent par des retouches ou des problèmes de reporting. Voici ceux sur lesquels je garderais un œil dès le début.

Fragmentation des données et interopérabilité

Un système peut identifier un patient à l'aide de son numéro de dossier médical, tandis qu'un autre utilise un identifiant différent. Les formats de données peuvent également varier. Les équipes doivent établir correctement les correspondances entre ces différences et mettre à jour ces correspondances chaque fois qu'un système source subit une modification.

Mauvaise qualité des données

Un entrepôt de données hérite des problèmes des systèmes qui l'alimentent. Des valeurs manquantes ou des codes incohérents peuvent générer des rapports peu fiables et compromettre les analyses ultérieures. Les équipes doivent détecter ces problèmes avant que d'autres rapports ou modèles ne commencent à s'appuyer sur ces mêmes données.

Dossiers patients en double

Un même patient peut apparaître plusieurs fois lorsque les systèmes utilisent des identifiants différents ou contiennent des informations personnelles légèrement différentes. Les règles de mise en correspondance doivent permettre d'identifier ces doublons sans regrouper par erreur les dossiers de personnes différentes.

Sécurité et vie privée

Un entrepôt de données de santé peut contenir à la fois des dossiers médicaux et des données financières et opérationnelles, mais tous les utilisateurs ne doivent pas nécessairement avoir accès à l'ensemble de ces informations. Les cliniciens peuvent avoir besoin de détails concernant les patients, tandis que les équipes financières peuvent se contenter des données de facturation. Définissez les droits d'accès en fonction des rôles et vérifiez les autorisations chaque fois que vous ajoutez une nouvelle source de données.

Gouvernance

Les équipes ont besoin de règles claires pour déterminer à qui appartiennent les données partagées et qui prend les décisions les concernant. Par exemple, si deux services calculent un même indicateur de manière différente, quelqu’un doit choisir la définition que tout le monde utilisera. Il en va de même pour l’autorisation d’accès aux données sensibles.

Adaptation des volumes de données

À mesure que le référentiel accumule des données sur plusieurs années et intègre de nouvelles sources, les requêtes peuvent ralentir et les coûts de stockage augmenter. Les équipes doivent donc planifier l'organisation des données plus anciennes et déterminer leur durée de conservation, afin que cette croissance ne complique pas la production des rapports quotidiens.

Manque d'expertise interne en ingénierie des données

Il se peut que votre équipe connaisse bien les systèmes de santé, mais qu'elle ait peu d'expérience dans la mise en place d'un entrepôt de données autour de ceux-ci. Dans ce cas, des ingénieurs de données externes peuvent vous aider à concevoir les pipelines et le modèle de données, tandis que votre équipe interne définit les besoins auxquels les données doivent répondre.

Modèles d'entrepôts de données dans le secteur de la santé

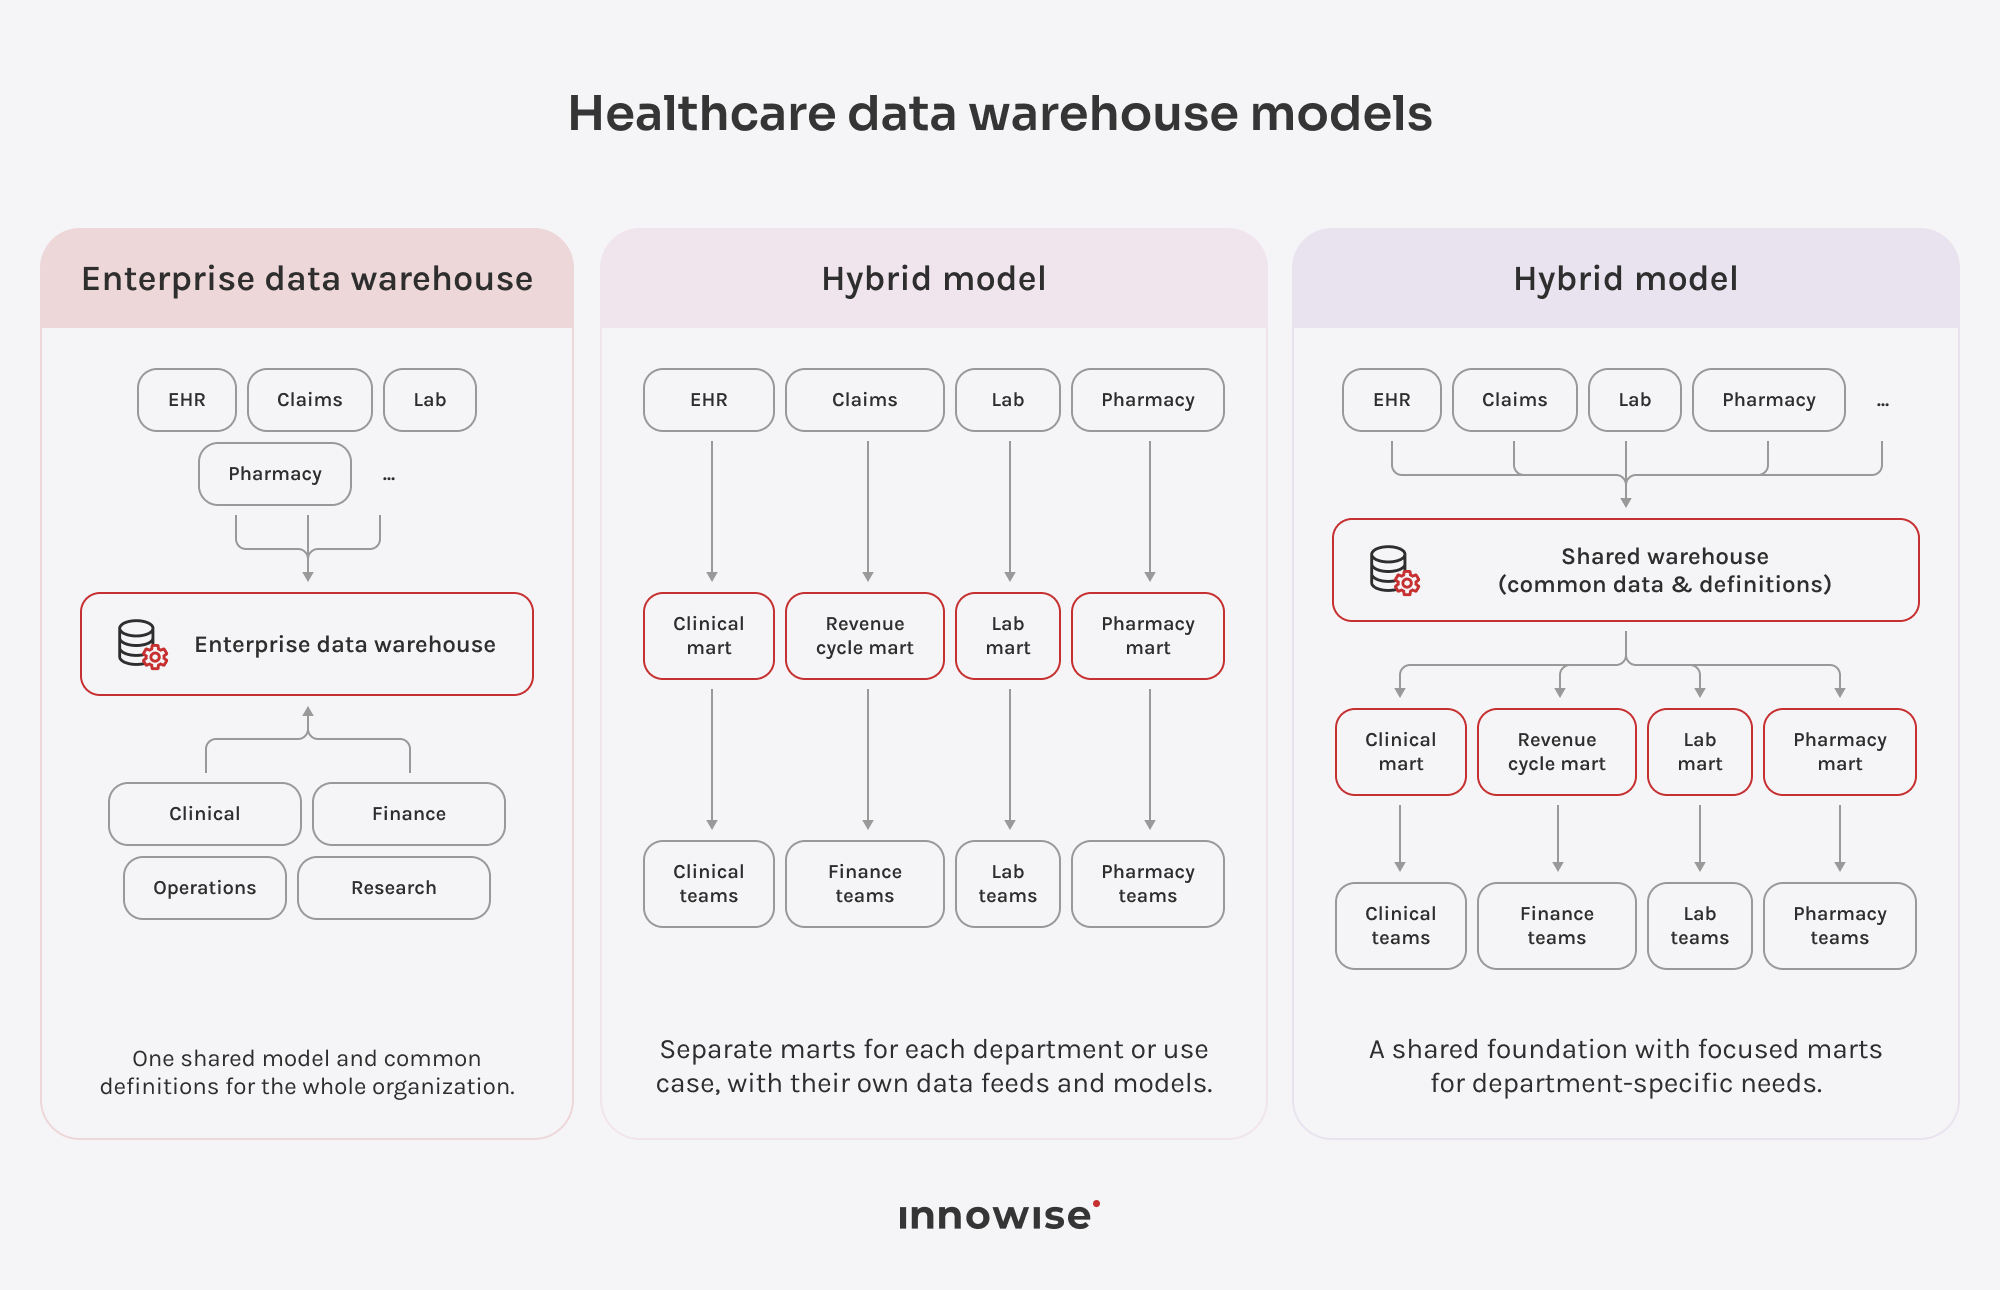
Le choix du modèle de data warehouse adapté au secteur de la santé dépend du degré de centralisation souhaité pour la gestion des données et du niveau d'autonomie dont chaque service a besoin. Dans la pratique, les organisations ont généralement le choix entre trois modèles :

Entrepôt de données d'entreprise

Dans le secteur de la santé, un entrepôt de données d'entreprise utilise un modèle de données commun à l'ensemble de l'organisation, ce qui permet aux différents services de travailler avec des définitions et des règles de reporting cohérentes. Les équipes cliniques et financières, par exemple, peuvent ainsi calculer la durée moyenne de séjour de la même manière, au lieu de définir cet indicateur séparément dans leurs propres rapports.

Au niveau des données, les équipes peuvent normaliser les entités fondamentales telles que les patients, les consultations, les prestataires et les établissements, puis mapper les enregistrements des systèmes sources à ces structures partagées. En contrepartie, elles doivent s’accorder sur ces définitions dès le début et veiller à ce qu’elles restent cohérentes à mesure que l’entrepôt de données s’enrichit. Cela nécessite davantage de travail en amont, en particulier dans une grande organisation où la terminologie et les besoins en matière de reporting évoluent constamment. Une fois que de nombreux rapports s’appuient sur le modèle partagé, même une modification mineure d’une définition fondamentale peut avoir des répercussions sur plusieurs équipes à la fois.

Data marts indépendants

Un « data mart » indépendant est axé sur un service ou un cas d'utilisation analytique spécifique, plutôt que sur la modélisation des données de l'ensemble de l'organisation. Une équipe d'oncologie, par exemple, peut créer un « data mart » autour des systèmes cliniques dont elle a besoin, tandis que les analystes du cycle de chiffre d'affaires en créent un autre axé sur les données relatives aux demandes de remboursement et à la facturation.

Comme chaque « mart » a une portée plus restreinte, les équipes peuvent souvent mettre en place les premiers rapports plus rapidement. À mesure que de nouveaux marts sont ajoutés, un même système source peut nécessiter des pipelines et des mappages distincts pour chacun d’entre eux. Les définitions peuvent également varier d’un service à l’autre. Et comme les marts stockent souvent des données déjà structurées ou synthétisées pour un cas d’utilisation particulier, elles peuvent ne pas contenir les détails nécessaires à une analyse différente ultérieure.

Modèle hybride

Un modèle hybride associe un entrepôt de données d'entreprise partagé à des « data marts » conçus pour des services spécifiques ou des besoins analytiques particuliers. Les données de base et les définitions partagées restent dans la couche centrale, tandis que chaque « data mart » adapte ces données à ses propres besoins en matière de reporting. Comme les « data marts » puisent leurs données dans l'entrepôt, les équipes n'ont pas besoin de mettre en place une intégration distincte vers chaque système source.

Cette configuration permet aux organisations d'ajouter de nouveaux « marts » à mesure que les besoins en matière de reporting évoluent, sans avoir à modéliser dès le départ tous les cas d'utilisation futurs. Le plus difficile consiste à déterminer ce qui doit être standardisé au niveau central et ce qui peut rester spécifique à un « mart » donné. Si une trop grande partie de la logique est intégrée dans les « marts » individuels, les définitions risquent de diverger au fil du temps.

Vous envisagez de mettre en place un entrepôt de données (DWH) dédié au secteur de la santé et vous évaluez les différentes options ?

Cas d'utilisation du DWH dans le secteur de la santé

Les établissements de santé utilisent les entrepôts de données pour des tâches très variées, en fonction des données qu'ils collectent et des décisions qu'ils doivent prendre. Les exemples d'entrepôts de données dans le secteur de la santé présentés ci-dessous illustrent comment cela se traduit concrètement dans le cadre des activités cliniques et opérationnelles.

Population Health Management

Les équipes chargées de la santé publique exploitent les données issues des bases de données pour repérer des groupes de patients présentant des besoins de soins similaires. Elles peuvent, par exemple, identifier les personnes dont le dépistage ou le suivi est en retard et transmettre ces listes aux équipes de terrain.

Gestion des maladies chroniques

Dans le cas des maladies chroniques, les équipes soignantes doivent pouvoir constater les évolutions entre deux consultations. Une base de données centralisée permet de regrouper les résultats d’analyses et l’historique des traitements médicamenteux d’une consultation à l’autre, en y ajoutant, le cas échéant, les données relevées par des appareils connectés. Cet historique global aide les équipes à repérer les changements dans l’état de santé d’un patient et à déterminer si un suivi plus précoce s’impose.

Analyse prédictive des risques chez les patients

Les équipes s'appuient sur les données historiques stockées dans l'entrepôt de données pour estimer quels patients présentent un risque plus élevé de réadmission ou de non-présentation à un rendez-vous. Ces scores sont généralement communiqués aux cliniciens via un système de gestion des soins ou de suivi. Leur réintégration dans le DME lui-même nécessite généralement une intégration distincte : les éditeurs de DME ont en effet tendance à exercer un contrôle strict sur les droits d'écriture.

Recherche et essais cliniques

La recherche de participants éligibles à une étude commence souvent par une longue liste de critères d'inclusion et d'exclusion. Les chercheurs peuvent d'abord appliquer ces critères à des données anonymisées issues d'un entrepôt de données afin de réduire le nombre de candidats potentiels avant d'examiner les dossiers individuels. Dans le cadre d'une recherche menant sur plusieurs sites, les équipes peuvent également regrouper les dossiers provenant de différents établissements au sein d'une structure commune avant de procéder à l'analyse.

Analyse du cycle de facturation et des demandes de remboursement

Des problèmes de paiement peuvent survenir à tout moment entre la facturation initiale et le remboursement final. En croisant les données cliniques, de facturation et de demandes de remboursement, les équipes chargées des recettes peuvent identifier à quel stade une demande de remboursement est bloquée et déterminer si le même motif de refus revient systématiquement pour un payeur ou une intervention en particulier.

Planification des effectifs et des capacités

Les responsables comparent le nombre de patients par service et par équipe avec les effectifs prévus pour ces mêmes horaires. Si un service se retrouve régulièrement à court de personnel certains jours ou pendant les périodes de forte affluence, ils peuvent adapter les plannings futurs pour tenir compte de cette tendance.

Optimisation des coûts d'exploitation

Lorsque les données financières sont mises en relation avec l'activité clinique, les équipes peuvent identifier l'origine réelle des dépenses d'exploitation. Elles peuvent comparer les dépenses par intervention, par établissement ou par type de soins, et chercher à comprendre pourquoi les coûts sont plus élevés dans certains domaines que dans d'autres.

Processus de mise en œuvre

Chaque projet de data warehouse dédié au secteur de la santé démarre différemment. Les étapes à suivre dépendent de vos systèmes actuels, de la qualité de vos données et des objectifs que vous souhaitez atteindre avec ce data warehouse. Voici comment nous procédons généralement.

01
Découverte

Notre équipe définit les cas d'utilisation initiaux en matière de reporting ou d'analyse pour la première version et identifie les personnes qui en ont besoin. Nous vérifions également quels sont les systèmes sources concernés et recensons les contraintes réglementaires avant de prendre des décisions architecturales.

02
Évaluation des données

Avant de mettre en place des pipelines, nous inspectons chaque source pour détecter les données manquantes et les formats incohérents, puis nous vérifions s'il existe des doublons. Les résultats nous indiquent ce qui peut rester tel quel et les cas où des règles de nettoyage sont nécessaires, avant que ces problèmes n'affectent les rapports de production.

03
Architecture

Nos architectes de données choisissent le modèle d'entrepôt de données en fonction de l'étendue du partage des données et des définitions requis par les équipes. Ils conçoivent ensuite les couches d'ingestion et de stockage en fonction des systèmes de l'entreprise et déterminent comment les outils d'analyse accéderont à l'entrepôt de données.

04
Choix de la technologie

Une fois l'architecture définie, l'équipe choisit la plateforme, l'approche ETL/ELT et les outils de BI ou de ML en fonction du volume de données et de l'environnement technologique existant. Les contraintes budgétaires et les exigences de conformité réduisent la liste des options, en particulier lorsque des contrôles d'accès ou la journalisation des audits sont requis.

05
Intégration

Les ingénieurs de données relient l'entrepôt de données aux systèmes sources. En fonction de l'environnement, ils peuvent utiliser les normes FHIR ou HL7 v2 pour les données cliniques, X12 pour les demandes de remboursement aux États-Unis, ainsi que des API ou des connecteurs natifs pour les applications métier. Tester chaque flux à l'aide de données réelles permet de détecter rapidement les erreurs de mappage.

06
Développement

Les ingénieurs Innowise mettent en place des pipelines qui normalisent les formats et éliminent les doublons avant d'appliquer les définitions métier convenues. Si la conception prévoit des data marts, ils les créent au niveau de la couche partagée plutôt que de se reconnecter à chaque source.

07
Migration et tests

L'équipe importe les données historiques et les recoupe avec les sources d'origine afin de détecter les valeurs manquantes ou modifiées. Les analystes testent ensuite les rapports à la lumière des cas d'utilisation définis lors de la phase de découverte, tandis que les utilisateurs métier examinent les résultats avant la mise en production.

08
Lancement

Lors du lancement, notre équipe exécute souvent les anciens et les nouveaux rapports en parallèle afin que les utilisateurs puissent comparer les chiffres avant de basculer vers le nouveau système. Nous surveillons également de près les premières utilisations en production, car c'est souvent à ce stade que se révèlent les problèmes liés aux données ou aux performances qui n'avaient pas été détectés lors des tests.

09
Soutien

Après la mise en service, nous surveillons les performances, ajoutons de nouvelles sources et assurons le suivi des processus de gouvernance qui garantissent la cohérence des définitions partagées. Il s'agit généralement de l'une des phases les plus longues du projet et de l'une des plus faciles à sous-estimer lors de la planification.

arrow-icon. arrow-icon.
01 Découverte

Notre équipe définit les cas d'utilisation initiaux en matière de reporting ou d'analyse pour la première version et identifie les personnes qui en ont besoin. Nous vérifions également quels sont les systèmes sources concernés et recensons les contraintes réglementaires avant de prendre des décisions architecturales.

arrow-icon. arrow-icon.
02 Évaluation des données

Avant de mettre en place des pipelines, nous inspectons chaque source pour détecter les données manquantes et les formats incohérents, puis nous vérifions s'il existe des doublons. Les résultats nous indiquent ce qui peut rester tel quel et les cas où des règles de nettoyage sont nécessaires, avant que ces problèmes n'affectent les rapports de production.

arrow-icon. arrow-icon.
03 Architecture

Nos architectes de données choisissent le modèle d'entrepôt de données en fonction de l'étendue du partage des données et des définitions requis par les équipes. Ils conçoivent ensuite les couches d'ingestion et de stockage en fonction des systèmes de l'entreprise et déterminent comment les outils d'analyse accéderont à l'entrepôt de données.

arrow-icon. arrow-icon.
04 Choix de la technologie

Une fois l'architecture définie, l'équipe choisit la plateforme, l'approche ETL/ELT et les outils de BI ou de ML en fonction du volume de données et de l'environnement technologique existant. Les contraintes budgétaires et les exigences de conformité réduisent la liste des options, en particulier lorsque des contrôles d'accès ou la journalisation des audits sont requis.

arrow-icon. arrow-icon.
05 Intégration

Les ingénieurs de données relient l'entrepôt de données aux systèmes sources. En fonction de l'environnement, ils peuvent utiliser les normes FHIR ou HL7 v2 pour les données cliniques, X12 pour les demandes de remboursement aux États-Unis, ainsi que des API ou des connecteurs natifs pour les applications métier. Tester chaque flux à l'aide de données réelles permet de détecter rapidement les erreurs de mappage.

arrow-icon. arrow-icon.
06 Développement

Les ingénieurs Innowise mettent en place des pipelines qui normalisent les formats et éliminent les doublons avant d'appliquer les définitions métier convenues. Si la conception prévoit des data marts, ils les créent au niveau de la couche partagée plutôt que de se reconnecter à chaque source.

arrow-icon. arrow-icon.
07 Migration et tests

L'équipe importe les données historiques et les recoupe avec les sources d'origine afin de détecter les valeurs manquantes ou modifiées. Les analystes testent ensuite les rapports à la lumière des cas d'utilisation définis lors de la phase de découverte, tandis que les utilisateurs métier examinent les résultats avant la mise en production.

arrow-icon. arrow-icon.
08 Lancement

Lors du lancement, notre équipe exécute souvent les anciens et les nouveaux rapports en parallèle afin que les utilisateurs puissent comparer les chiffres avant de basculer vers le nouveau système. Nous surveillons également de près les premières utilisations en production, car c'est souvent à ce stade que se révèlent les problèmes liés aux données ou aux performances qui n'avaient pas été détectés lors des tests.

arrow-icon. arrow-icon.
09 Soutien

Après la mise en service, nous surveillons les performances, ajoutons de nouvelles sources et assurons le suivi des processus de gouvernance qui garantissent la cohérence des définitions partagées. Il s'agit généralement de l'une des phases les plus longues du projet et de l'une des plus faciles à sous-estimer lors de la planification.

Services de stockage de données dans le domaine de la santé

Si vous créez un entrepôt de données (DWH) dédié au secteur de la santé à partir de zéro, vous aurez besoin d’un accompagnement différent de celui nécessaire pour la refonte ou l’extension d’un entrepôt existant. Innowise peut intervenir à n’importe quelle étape et prendre en charge les tâches requises par votre projet.

  • Conseil en matière d'entrepôts de données dans le secteur de la santé
  • Architecture et design
  • Développement d'un entrepôt de données (DWH)
  • Intégration et migration des données
  • Modernisation d'un entrepôt de données (DWH) existant
  • Intégration de la BI et de l'analyse de données
  • Assistance et optimisation

Conseil en matière d'entrepôts de données dans le secteur de la santé

Si vous rencontrez déjà des problèmes de reporting ou si votre entrepôt actuel ne répond plus à vos besoins, nous déterminons ensemble les changements à apporter. Notre équipe examine la configuration actuelle et compare les options disponibles. À partir de là, nous vous aidons à définir les cas d'utilisation prioritaires.

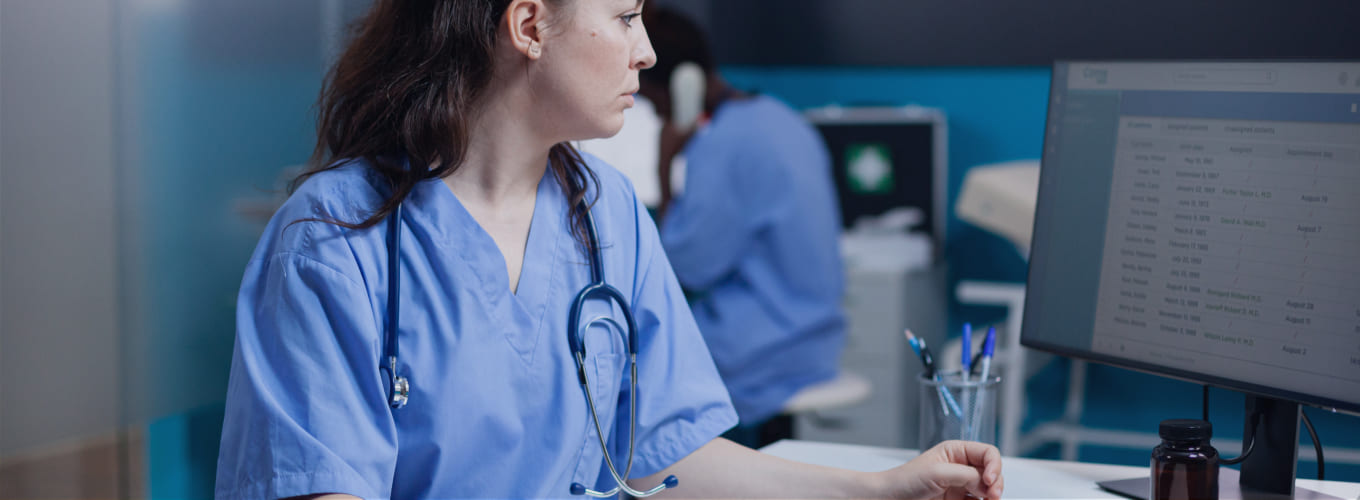
Nurse reviews lab results and medication history in EHR system before patient rounds.

Architecture et design

Une fois les exigences définies, nos architectes conçoivent une architecture de stockage adaptée à vos systèmes et à vos charges de travail prévues. Ils déterminent comment les principaux composants s'interconnectent et où sont stockées les données partagées. Cette architecture peut ensuite s'adapter à de nouvelles sources de données ou à de nouveaux besoins en matière de reporting à mesure qu'ils apparaissent.

Building layouts and style guides for a new web application project.

Développement d'un entrepôt de données (DWH)

Une fois la conception validée, nos ingénieurs mettent en place l'entrepôt de données (DWH), y compris la logique de transformation et les data marts nécessaires. Ils intègrent des contrôles de qualité et de sécurité tout au long du développement, afin que l'entrepôt puisse prendre en charge les rapports et les analyses requis par le projet.

IT specialist analyzing software code during an evening sprint session.

Intégration et migration des données

Nous connectons l'entrepôt de données aux systèmes de dossiers médicaux électroniques (DME/DME), de gestion des demandes de remboursement, de laboratoire, d'ERP/CRM et à d'autres systèmes sources. Les données historiques sont ensuite transférées vers le modèle cible, après avoir subi les mappages et les transformations nécessaires. Avant la mise en production, des contrôles de rapprochement comparent les données migrées à leurs sources d'origine.

Data engineer interacts with a visual dashboard to orchestrate real-time data synchronization across systems.

Modernisation d'un entrepôt de données (DWH) existant

À mesure que les sources de données et les besoins en matière de reporting évoluent, un entrepôt de données existant peut nécessiter davantage qu’une simple maintenance courante. Nous mettons à jour les modèles de données et les pipelines obsolètes, nous déplaçons les charges de travail lorsque la plateforme actuelle devient un frein, et nous automatisons les tâches répétitives de gestion des données lorsque cela s’avère pertinent.

IT operations team tracks software patch rollout in real time via a mobile device interface.

Intégration de la BI et de l'analyse de données

Nos experts relient le data warehouse aux outils de BI et d'analyse que vos équipes utilisent déjà. Selon la configuration, ils peuvent importer des données ou interroger directement le data warehouse. Les indicateurs partagés et les règles de reporting sont centralisés au même endroit, ce qui évite de devoir les recréer dans chaque tableau de bord.

Accessing a centralized analytics portal to evaluate company operations and outcomes.

Assistance et optimisation

Une fois mis en service, l'entrepôt de données évolue en fonction de vos données et de vos besoins en matière de reporting. Notre équipe est en mesure de résoudre les problèmes liés aux pipelines ou aux données, d'ajouter de nouvelles sources, d'optimiser les requêtes lentes et de mettre à jour les modèles lorsque les besoins de l'entreprise changent.

The consulting team reviews analytics on screen, focusing on data-driven IT strategy and solutions.
Conseil en matière d'entrepôts de données dans le secteur de la santé

Si vous rencontrez déjà des problèmes de reporting ou si votre entrepôt actuel ne répond plus à vos besoins, nous déterminons ensemble les changements à apporter. Notre équipe examine la configuration actuelle et compare les options disponibles. À partir de là, nous vous aidons à définir les cas d'utilisation prioritaires.
Nurse reviews lab results and medication history in EHR system before patient rounds.
Architecture et design

Une fois les exigences définies, nos architectes conçoivent une architecture de stockage adaptée à vos systèmes et à vos charges de travail prévues. Ils déterminent comment les principaux composants s'interconnectent et où sont stockées les données partagées. Cette architecture peut ensuite s'adapter à de nouvelles sources de données ou à de nouveaux besoins en matière de reporting à mesure qu'ils apparaissent.

Building layouts and style guides for a new web application project.
Développement d'un entrepôt de données (DWH)

Une fois la conception validée, nos ingénieurs mettent en place l'entrepôt de données (DWH), y compris la logique de transformation et les data marts nécessaires. Ils intègrent des contrôles de qualité et de sécurité tout au long du développement, afin que l'entrepôt puisse prendre en charge les rapports et les analyses requis par le projet.

IT specialist analyzing software code during an evening sprint session.
Intégration et migration des données

Nous connectons l'entrepôt de données aux systèmes de dossiers médicaux électroniques (DME/DME), de gestion des demandes de remboursement, de laboratoire, d'ERP/CRM et à d'autres systèmes sources. Les données historiques sont ensuite transférées vers le modèle cible, après avoir subi les mappages et les transformations nécessaires. Avant la mise en production, des contrôles de rapprochement comparent les données migrées à leurs sources d'origine.

Data engineer interacts with a visual dashboard to orchestrate real-time data synchronization across systems.
Modernisation d'un entrepôt de données (DWH) existant

À mesure que les sources de données et les besoins en matière de reporting évoluent, un entrepôt de données existant peut nécessiter davantage qu’une simple maintenance courante. Nous mettons à jour les modèles de données et les pipelines obsolètes, nous déplaçons les charges de travail lorsque la plateforme actuelle devient un frein, et nous automatisons les tâches répétitives de gestion des données lorsque cela s’avère pertinent.

IT operations team tracks software patch rollout in real time via a mobile device interface.
Intégration de la BI et de l'analyse de données

Nos experts relient le data warehouse aux outils de BI et d'analyse que vos équipes utilisent déjà. Selon la configuration, ils peuvent importer des données ou interroger directement le data warehouse. Les indicateurs partagés et les règles de reporting sont centralisés au même endroit, ce qui évite de devoir les recréer dans chaque tableau de bord.

Accessing a centralized analytics portal to evaluate company operations and outcomes.
Assistance et optimisation

Une fois mis en service, l'entrepôt de données évolue en fonction de vos données et de vos besoins en matière de reporting. Notre équipe est en mesure de résoudre les problèmes liés aux pipelines ou aux données, d'ajouter de nouvelles sources, d'optimiser les requêtes lentes et de mettre à jour les modèles lorsque les besoins de l'entreprise changent.

The consulting team reviews analytics on screen, focusing on data-driven IT strategy and solutions.

Vous avez besoin de moderniser votre infrastructure de gestion des données de santé ?

Fournisseurs de solutions d'entrepôt de données pour le secteur de la santé

Si vous comparez différentes plateformes pour un entrepôt de données de santé, votre environnement cloud actuel constitue un bon point de départ. Les options présentées ci-dessous traitent les données de santé de manière différente, et leurs modèles de calcul et de tarification varient également.

Amazon-Redshift-Logo (1)

Amazon Redshift

Redshift s'intègre naturellement lorsque la plupart de vos données se trouvent déjà sur AWS. Il est compatible avec S3 et AWS Glue, tandis que HealthLake peut exporter des données FHIR vers S3 en vue d'une analyse en aval via Redshift ou d'autres services d'analyse AWS.

Caractéristiques principales

  • SQL pour les données structurées et semi-structurées
  • Accès à S3 via Redshift Spectrum
  • Requêtes fédérées vers les bases de données AWS prises en charge
  • Contrôles d'accès au niveau des lignes et des colonnes
  • Séparation entre la puissance de calcul et le stockage géré
  • Service AWS conforme à la loi HIPAA 

Tarification

  • Tarification à la demande pour les clusters provisionnés
  • Ressources de calcul sans serveur facturées à l'utilisation
  • Frais de stockage géré distincts
  • Tarification réservée pour les charges de travail stables
Azure Synapse Analytics

Azure Synapse Analytics

Synapse est particulièrement adapté lorsque vos données et vos rapports sont déjà gérés dans Azure et que vos équipes utilisent Power BI. Il réunit le stockage de données SQL et Spark au sein d'un même espace de travail, avec des pipelines permettant de transférer les données entre les services Azure. Les données FHIR provenant des services de données de santé Azure peuvent également être copiées dans Synapse à des fins d’analyse.

Caractéristiques principales

  • SQL dédié et sans serveur
  • Pools Apache Spark
  • Requêtes sur le lac de données Azure
  • Pipelines ETL/ELT intégrés
  • Intégrations ML Power BI et Azure
  • Analyses FHIR avec les services de données de santé Azure

Tarification

  • SQL sans serveur facturé en fonction du volume de données traitées
  • SQL dédié facturé en fonction de l'utilisation en DWU
  • Spark facturé en fonction de l'utilisation de vCore
  • Options d'achat anticipé pour les charges de travail engagées

Pour les équipes qui souhaitent bénéficier d’une plus grande liberté de choix entre les différents fournisseurs de cloud, Snowflake réduit la dépendance de la couche d’entrepôt de données vis-à-vis d’un écosystème unique. La plateforme fonctionne sur AWS, Azure et Google Cloud, tandis que des entrepôts virtuels distincts permettent aux équipes d’affecter des ressources de calcul spécifiques à différentes charges de travail.

Caractéristiques principales

  • Options de déploiement multicloud
  • Capacité de calcul indépendante pour différentes charges de travail
  • Entrepôts multi-clusters sur Enterprise Edition+
  • Prise en charge native des données semi-structurées
  • Partage sécurisé des données
  • Assistance PHI avec Business Critical+

Tarification

  • Crédits de calcul basés sur la consommation
  • Frais de stockage distincts
  • Capacité à la demande ou prépayée 
  • Les tarifs varient selon le cloud, la région et l'édition
GCP BigQuery

Google BigQuery

BigQuery convient aux entreprises qui utilisent déjà Google Cloud ou qui souhaitent disposer d'un entrepôt de données sans serveur, sans avoir à gérer de clusters de calcul. L'API Cloud Healthcare permet d'exporter des ressources FHIR et des métadonnées DICOM vers BigQuery, offrant ainsi aux équipes d'analyse un accès aux données de santé via SQL.

Caractéristiques principales

  • Entrepôt de données SQL sans serveur
  • Séparation du stockage et de la puissance de calcul
  • Fonctionnalités d'apprentissage automatique intégrées
  • Requêtes externes et fédérées
  • Intégration de l'API Cloud pour le secteur de la santé
  • BigQuery est couvert par l'accord d'affaires HIPAA (BAA) de Google Cloud

Tarification

  • Ressources de calcul à la demande facturées en fonction du volume de données traitées
  • Tarification de la capacité en fonction des créneaux horaires
  • Stockage facturé séparément
  • Engagements disponibles pour la capacité réservée

Coût et calendrier

Les budgets consacrés aux entrepôts de données de santé peuvent varier de plus d’un ordre de grandeur. Un data mart de production limité, alimenté par quelques sources de données propres, peut coûter entre environ $60 000 et $100 000 et prendre entre 2 et 4 mois. Un entrepôt d'entreprise multi-systèmes, comprenant la migration des données historiques et plusieurs data marts, peut atteindre un coût compris entre $400 000 et $1 million, voire plus, et nécessiter entre 9 et 18 mois, voire davantage.

Échelle du projetPortée typeChronologieBudget d'exécutionCoûts récurrents liés au cloud et aux logiciels
Data mart du département1 à 2 systèmes sources, un seul service, historique limité, rapports BI de base2 à 4 mois$60k–$100k$1k–$5k/mois
Entrepôt de données de taille moyenne dédié au secteur de la santé3 à 6 sources, modèle de données partagé, migration des données historiques, 2 à 4 entrepôts de données, intégration BI5 à 9 mois$150k–$350k$5k–$20k/mois
DWH d'entreprise / « lakehouse »Plus de 7 sources, des données historiques exhaustives, plusieurs plateformes, des intégrations cliniques sur mesure, des analyses avancées9 à 18 mois et plus$400k–$1m+$20k–$80k+ par mois

Solutions de santé proposées par Innowise

Pourquoi nous choisir ?

Un projet de data warehouse (DWH) dans le secteur de la santé se situe à la croisée de l'ingénierie des données et du secteur de la santé IT. Innowise possède une expérience dans ces deux domaines, attestée par des certifications ISO pertinentes et des partenariats avec les fournisseurs de solutions cloud et de données utilisés dans les projets de data warehouse.

Expérience dans le secteur de la santé

Nous disposons de plus de 19 ans d’expérience dans le secteur de la santé (IT), notamment dans les domaines des dossiers médicaux électroniques (DME), des systèmes de laboratoire, de l’imagerie médicale et des plateformes de santé connectées. Cette expérience est déterminante lorsque les flux de travail cliniques ou les normes relatives aux données de santé influencent la conception de l’entrepôt de données.

Expertise en ingénierie des données

Nos équipes chargées des données travaillent avec Snowflake, BigQuery, Amazon Redshift et Azure Synapse, ainsi qu’avec les outils ETL/ELT et d’orchestration qui les accompagnent. Cela signifie que nous pouvons concevoir l’entrepôt de données en fonction de l’infrastructure existante du client, plutôt que de nous limiter à une plateforme privilégiée.

Certifications pertinentes

Innowise est certifiée ISO 9001, ISO 27001 et ISO 13485, normes relatives respectivement à la qualité, à la sécurité de l'information et aux dispositifs médicaux.

Relevé des livraisons

Notre expérience compte plus de 1 600 projets dans divers secteurs et plus de 60 solutions IT dans le domaine de la santé. Pour une entreprise spécialisée dans la médecine de précision, nous amélioration des pipelines de données et de l'infrastructure AWS utilisé pour traiter des données de diagnostic provenant de plusieurs sources.

Expérience en matière de sécurité et de conformité

Nos équipes de soins de santé respectent les exigences de la loi HIPAA et du RGPD, ainsi que les normes d'échange de données de santé telles que HL7 v2 et FHIR. Cette expertise s'avère particulièrement utile lors du transfert de données de santé sensibles entre l'entrepôt de données et les systèmes cliniques soumis à une réglementation.

Partenariats technologiques

En tant que partenaire d'AWS, de Microsoft, de Google Cloud et de Databricks, Innowise apporte une expertise certifiée en matière de plateformes aux projets d'entrepôt de données (DWH) et peut s'appuyer sur l'assistance des fournisseurs lorsque des problèmes spécifiques à une plateforme surviennent.

ISO 13485 certification.
ISO 9001 certification.
ISO/IEC 27001 certification.
GDPR
Select partner AWS
Google_Cloud_Partner

Conclusion

Je ne commencerais pas un projet d'entrepôt de données de santé en essayant de regrouper tous les ensembles de données au même endroit. Je choisirais plutôt un problème lié au reporting ou à l'analyse qui mérite d'être résolu, et je ne connecterais que les systèmes nécessaires à cette tâche. Par exemple, vous pourriez commencer par le reporting sur le cycle de chiffre d'affaires ou l'analyse des réadmissions. Une fois que cela fonctionne, vous pourrez déterminer les besoins suivants du data warehouse en fonction de la demande réelle. 

Cette approche doit être maintenue à mesure que le projet prend de l'ampleur. N'ajoutez de nouvelles sources ou de nouveaux data marts que lorsqu'il existe une raison claire de le faire, plutôt que d'essayer de anticiper tous les besoins futurs possibles. L'essentiel est de veiller à la cohérence des définitions et des règles d'accès à mesure que l'entrepôt de données s'étend, et de s'assurer que les exigences de conformité sont toujours respectées. 

Si vous avez besoin d'une aide extérieure, les spécialistes de Pôle Santé et Industrie pharmaceutique Innowise de IT peut analyser votre entrepôt de données existant ou vous aider à en créer un adapté à vos systèmes de santé et à vos besoins en matière de reporting, tout en tenant compte des exigences de conformité applicables aux données de santé.

FAQ

Un entrepôt de données de santé stocke des données préparées à des fins de reporting et d'analyse. Un lac de données contient généralement des volumes plus importants de données brutes ou peu traitées. Dans de nombreuses architectures, le lac de données stocke des ensembles de données plus vastes, tandis que l'entrepôt contient les données dont les équipes ont besoin pour leurs analyses cliniques, financières ou opérationnelles récurrentes.

Les délais varient en fonction de l’ampleur du projet, des systèmes sources et de la qualité des données. La mise en place d’un data mart ciblé comportant quelques intégrations peut prendre entre 2 et 4 mois. La mise en place d’un entrepôt de données d’entreprise de plus grande envergure dans le secteur de la santé peut prendre entre 9 et 18 mois, voire plus, lorsque le projet inclut la migration de données existantes, de multiples intégrations et plusieurs data marts.

Le choix du modèle de data warehouse adapté au secteur de la santé dépend du nombre d'équipes qui ont besoin de ces données et de la nécessité ou non d'utiliser les mêmes définitions pour le reporting. Un modèle d'entreprise prend en charge le reporting à l'échelle de l'organisation, tandis que les « marts » indépendants se concentrent sur des services ou des cas d'utilisation spécifiques. Un modèle hybride combine un noyau partagé avec des « marts » plus ciblés. La conception d'un data warehouse dédié au secteur de la santé doit refléter les cas d'utilisation que vous devez prendre en charge en priorité.

Oui. Nous pouvons moderniser votre entrepôt de données de santé existant sans avoir à le remplacer d'un seul coup. Notre équipe remanie les pipelines obsolètes, révise les modèles de données, migre certaines charges de travail et intègre progressivement de nouveaux outils d'analyse. L'automatisation de l'entrepôt de données de santé permet également de réduire le travail manuel lié à l'ingestion des données et aux contrôles récurrents de la qualité des données.

Innowise conçoit dès le départ son entrepôt de données en respectant les exigences de la loi HIPAA, avec un accès aux informations médicales protégées (PHI) limité en fonction des rôles et des contrôles de sécurité intégrés aux flux de données. Nous validons également les données au fur et à mesure de leur transit dans l'entrepôt, en vérifiant l'absence de mappages incorrects, de doublons dans les dossiers des patients ou de valeurs altérées avant qu'ils n'affectent les rapports.

Montrer tout

Table des matières

    Contactez-nous

    Réserver un appel ou remplissez le formulaire ci-dessous et nous vous contacterons dès que nous aurons traité votre demande.

    Envoyez-nous un message vocal
    Joindre des documents
    Charger fichier

    Vous pouvez joindre un fichier d'une taille maximale de 2 Mo. Formats de fichiers valables : pdf, jpg, jpeg, png.

    En cliquant sur « Envoyer », vous consentez au traitement de vos données personnelles par Innowise conformément à notre Politique de confidentialité afin de vous fournir des informations pertinentes. En soumettant votre numéro de téléphone, vous acceptez que nous puissions vous contacter par appels vocaux, SMS et applications de messagerie. Des frais d'appel, de message et de transfert de données peuvent s'appliquer.

    Vous pouvez également nous envoyer votre
    demande à contact@innowise.com
    Que se passe-t-il ensuite?
    1

    Une fois que nous aurons reçu et traité votre demande, nous vous contacterons pour détailler les besoins de votre projet et signer un accord de confidentialité.

    2

    Après avoir examiné vos souhaits, vos besoins et vos attentes, notre équipe élaborera une proposition de projet avec l'étendue des travaux, la taille de l'équipe, les délais et les coûts estimés projet avec l'étendue des travaux, la taille de l'équipe, les délais et les coûts estimés.

    3

    Nous prendrons rendez-vous avec vous pour discuter de l'offre et régler les détails.

    4

    Enfin, nous signons un contrat et commençons immédiatement à travailler sur votre projet.

    Autres services couverts

    arrow