Wiadomość została wysłana.
Przetworzymy Twoją prośbę i skontaktujemy się z Tobą tak szybko, jak to możliwe.
Formularz został pomyślnie przesłany.
Więcej informacji można znaleźć w skrzynce pocztowej.
Każdy może podłączyć model do interfejsu czatu. Niewiele zespołów dokłada dodatkowych starań w zakresie wyszukiwania, cytowania, kontroli dostępu i kontroli jakości. Innowise to robi, więc LLM wytrzymuje każdy etap poza fazą pilotażową.
Innowise tworzy LLM domeny, dodaje oceny i MLOps oraz dokumentuje własność, zarządzanie i podręczniki wdrażania. Utrzymujesz stałą jakość odpowiedzi w miarę skalowania wykorzystania w zespołach.

Popraw spójność odpowiedzi na wszystkich kanałach i przyspiesz cykle zatwierdzania. Dostosowujemy podpowiedzi, narzędzia i poręcze, które są unikalne dla Twoich zasad i wizerunku marki.

Dokładność jest jednym z najważniejszych czynników ograniczających konieczność konserwacji i wprowadzania poprawek. Innowise dostraja modele na zweryfikowanych przykładach i podpowiedziach w stylu produkcyjnym, a następnie przeprowadza testy regresji na skrajnych przypadkach, aby jeszcze bardziej wzmocnić modele.

Zmiany są dobre, ale trudne do przyjęcia. Pomagamy zespołom zachować znajomość ich codziennych narzędzi, łącząc sieci LLMN z CRM, biurami obsługi i magazynami dokumentów, a następnie dołączając SSO, role i monitorowanie. Wszystko jest identyfikowalne. Bez alienacji.

Potrzebujesz funkcji LLM, a nie tylko punktu końcowego? Nasi programiści LLM dostarczają UX, API, analizy i pętle informacji zwrotnych. Szybko uruchamiasz i ulepszasz dzięki danym o użytkowaniu, testom A/B i cotygodniowym prezentacjom.

Sparuj LLM z ML w celu tworzenia rankingów, wykrywania intencji, wyznaczania tras i przewidywania. Nasi inżynierowie ML tworzą potoki i kontrole dryfu, które utrzymują wyniki na odpowiednim poziomie w miarę zmian danych.

Specjaliści ds. bezpieczeństwa wzmacniają RAG za pomocą uprawnień, zabezpieczeń przed wstrzyknięciem monitu, filtrów PII i ścieżek audytu. Testy czerwonego zespołu weryfikują kontrole, zanim użytkownicy uzyskają dostęp.

Wybór modelu rozpoczyna się od testów porównawczych zadań, limitów opóźnień i budżetu. Architekci projektują routing, strategię kontekstową, buforowanie i rozwiązania awaryjne, aby utrzymać przewidywalne koszty.
Innowise tworzy LLM domeny, dodaje oceny i MLOps oraz dokumentuje własność, zarządzanie i podręczniki wdrażania. Utrzymujesz stałą jakość odpowiedzi w miarę skalowania wykorzystania w zespołach.

Popraw spójność odpowiedzi na wszystkich kanałach i przyspiesz cykle zatwierdzania. Dostosowujemy podpowiedzi, narzędzia i poręcze, które są unikalne dla Twoich zasad i wizerunku marki.

Dokładność jest jednym z najważniejszych czynników ograniczających konieczność konserwacji i wprowadzania poprawek. Innowise dostraja modele na zweryfikowanych przykładach i podpowiedziach w stylu produkcyjnym, a następnie przeprowadza testy regresji na skrajnych przypadkach, aby jeszcze bardziej wzmocnić modele.

Zmiany są dobre, ale trudne do przyjęcia. Pomagamy zespołom zachować znajomość ich codziennych narzędzi, łącząc sieci LLMN z CRM, biurami obsługi i magazynami dokumentów, a następnie dołączając SSO, role i monitorowanie. Wszystko jest identyfikowalne. Bez alienacji.

Potrzebujesz funkcji LLM, a nie tylko punktu końcowego? Nasi programiści LLM dostarczają UX, API, analizy i pętle informacji zwrotnych. Szybko uruchamiasz i ulepszasz dzięki danym o użytkowaniu, testom A/B i cotygodniowym prezentacjom.

Sparuj LLM z ML w celu tworzenia rankingów, wykrywania intencji, wyznaczania tras i przewidywania. Nasi inżynierowie ML tworzą potoki i kontrole dryfu, które utrzymują wyniki na odpowiednim poziomie w miarę zmian danych.

Specjaliści ds. bezpieczeństwa wzmacniają RAG za pomocą uprawnień, zabezpieczeń przed wstrzyknięciem monitu, filtrów PII i ścieżek audytu. Testy czerwonego zespołu weryfikują kontrole, zanim użytkownicy uzyskają dostęp.

Wybór modelu rozpoczyna się od testów porównawczych zadań, limitów opóźnień i budżetu. Architekci projektują routing, strategię kontekstową, buforowanie i rozwiązania awaryjne, aby utrzymać przewidywalne koszty.

Explore how we manage data, model risks, human oversight, security, and governance across AI projects
Our AI policy
Przekształć powtarzalną pracę w zautomatyzowane przepływy: selekcja zgłoszeń, pytania i odpowiedzi dotyczące dokumentów, wersje robocze raportów i routing. Zespoły spędzają mniej czasu na zadaniach kopiuj-wklej, a więcej na podejmowaniu decyzji i dostarczaniu.
Korzystaj z odpowiedniego modelu dla każdego zadania i kontroluj wydatki na tokeny dzięki buforowaniu, grupowaniu i limitom użycia. Mniejsza liczba godzin pracy ręcznej na żądanie obniża koszty operacyjne w obszarze wsparcia i zaplecza.
Przyspiesz wewnętrzne cykle, takie jak zatwierdzenia, przeglądy i wyszukiwanie wiedzy. Pracownicy otrzymują odpowiedzi z cytatami z zatwierdzonych źródeł, co zmniejsza liczbę zwrotów i utrzymuje ciągłość pracy między funkcjami.
Zwiększ konwersję i sprzedaż dzięki lepszym odpowiedziom na pytania dotyczące produktów, szybszym ofertom i spersonalizowanym kontaktom opartym na danych. Zespoły sprzedaży reagują szybciej i otrzymują wiadomości o wyższej jakości.
Wdrażaj te same możliwości LLM w zespołach, regionach i kanałach przy użyciu współdzielonych szyn ochronnych, ról dostępu i monitorowania. Nowe przypadki użycia są dostarczane szybciej po wdrożeniu podstawowej platformy.
Udzielaj klientom szybszych i dokładniejszych odpowiedzi za pośrednictwem asystentów, którzy odwołują się do Twojej bazy wiedzy i stosują Twój ton. Eskalacje trafiają do właściwego agenta z kontekstem, zwiększając satysfakcję i powtarzalność transakcji.
Skuteczność produktów opartych na modelach LLM zależy od funkcji wyszukiwania, oceny, kontroli dostępu oraz zarządzania kosztami. Nasi certyfikowani architekci Claude pomagają nam budować te podstawy w systemach opartych na platformie Claude.
Twórz systemy łączące modele, RAG, cytaty i wykorzystanie narzędzi, aby zapewnić bardziej uzasadnione odpowiedzi. Użytkownicy otrzymują odpowiedzi oparte na odpowiednim kontekście biznesowym.
Skonfiguruj testy, karty wyników i procesy przekazywania informacji zwrotnej, aby zapewnić dokładność, spójność i wiarygodność wyników generowanych przez duże modele językowe (LLM). Ułatwi to monitorowanie jakości i jej stopniowe doskonalenie.
Projektuj rozwiązania oparte na modelach LLM z funkcjami kontroli uprawnień, ochrony danych oraz bezpiecznego przetwarzania informacji wrażliwych. Każdy użytkownik widzi wyłącznie te dane, do których ma uprawnienia dostępu.
Zoptymalizuj wykorzystanie modeli, zapytania, buforowanie i routing, aby zapewnić równowagę między wydajnością, opóźnieniami i kosztami. Dzięki temu koszty operacyjne pozostają przewidywalne wraz ze wzrostem wykorzystania.

Polegaj na jednym zespole, który obejmuje cały obszar: LLM + NLP, backend, DevOps i bezpieczeństwo. Dostarczamy cytaty, dzienniki audytu, zestawy ewaluacyjne i monitorowanie od pierwszego dnia, a następnie utrzymujemy stałą jakość w miarę ewolucji treści i użytkowania.


Każdy projekt LLM zaczyna się od trudnego pytania: co powinien robić model, a czego nie może robić nigdy. Nasz zespół podąża za przepływem dostaw, który utrzymuje zakres, jakość, bezpieczeństwo i koszty eksploatacji widoczne od pierwszego dnia.
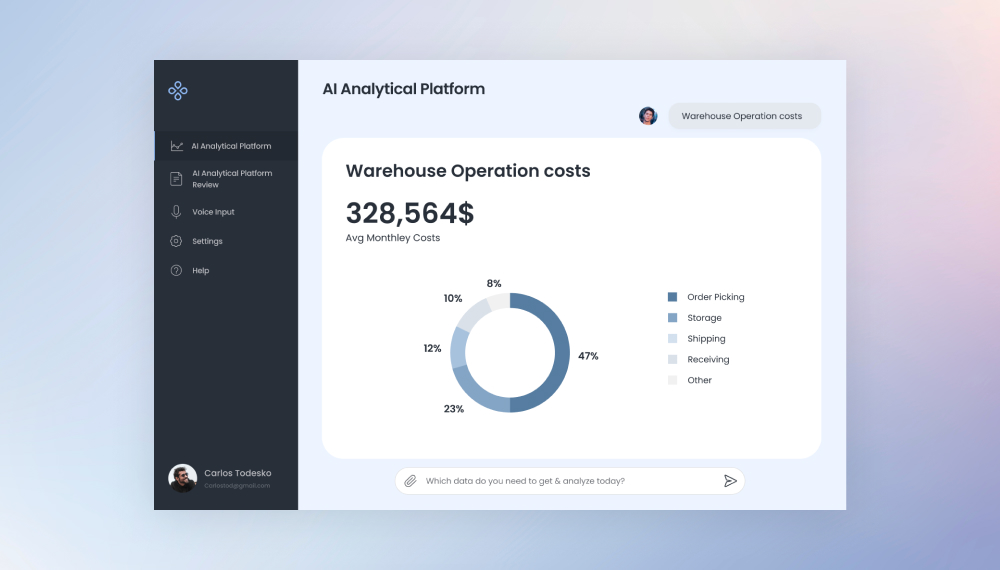
Zespoły bankowe i fintechowe używają copilotów Innowise LLM do obsługi KYC, podsumowań przypadków oszustw i raportowania analitycznego. Użytkownicy Engine integrują je z podstawowymi systemami i utrzymują reguły dostępu, dzienniki i ścieżki audytu.

Detaliczne zespoły operacyjne i e-commerce otrzymują funkcje LLM, które odpowiadają na pytania dotyczące produktów, podsumowują recenzje i pomagają pracownikom zarządzać zapasami i cenami. Innowise łączy asystentów z katalogiem, POS i danymi klientów z dostępem opartym na rolach.

Zespoły marketingowe wykorzystują Innowise LLM do tworzenia wariantów tekstów, grupowania słów kluczowych, analiz odbiorców i raportowania. Integracje ze stosami MarTech i AdTech zapewniają, że wyniki są zgodne z marką, mierzalne i łatwe do zatwierdzenia.

Zespoły medialne otrzymują przepływy pracy LLM do tagowania metadanych, podsumowań scenariuszy, notatek dotyczących praw autorskich i obsługi przesyłania strumieniowego. Innowise pobiera kontekst z DAM i CMS, dzięki czemu odpowiedzi pozostają oparte na zatwierdzonych treściach.

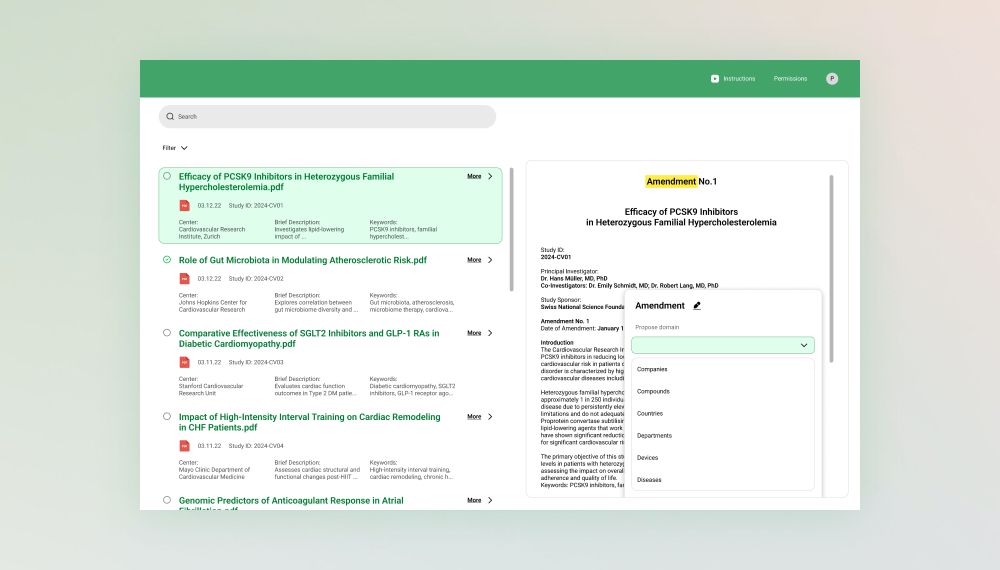
Zespoły kliniczne otrzymują asystentów LLM do obsługi wiadomości od pacjentów, podsumowań wizyt i wyszukiwania protokołów. Innowise dodaje kontrolę bezpieczeństwa, rejestrowanie i integracje, dzięki czemu zespoły działają szybko, jednocześnie chroniąc wrażliwe dane.

Platformy e-learningowe otrzymują funkcje LLM do czatu z korepetytorami, generowania treści i wsparcia kursów dla uczniów i administratorów. Innowise integruje się z danymi LMS i dodaje moderację, analitykę i dostęp oparty na rolach.

Zespoły ds. podróży automatyzują obsługę rezerwacji, szkice planów podróży, pytania i odpowiedzi dotyczące zasad oraz obsługę zakłóceń za pomocą urządzeń Innowise LLM. Integracja z systemami rezerwacji i CRM pomaga agentom reagować szybciej i z mniejszą liczbą błędów.

Zespoły motoryzacyjne korzystają z LLM w celu uzyskania odpowiedzi na pytania i odpowiedzi dotyczące podręcznika technika, wsparcia dealera, wyszukiwania części i podsumowań diagnostyki. Innowise łączy asystentów z dokumentami inżynieryjnymi i danymi pojazdu z kontrolą dostępu i monitorowaniem.


Oszacujemy wartość, ryzyko, harmonogram i wysiłek związany z budową w krótkim sprincie odkrywczym
Byłem pod wrażeniem jakości kodu od samego początku. Częstotliwość i styl komunikacji były rzeczowe i nigdy nie było ich więcej niż potrzeba, ale też nie mniej.
Przekroczyli nasze oczekiwania i reagują na nasze prośby o zmiany lub dodatkowe informacje. Ich komunikacja jest łatwa i skuteczna. Doskonale rozumieją powierzone im zadania, co pozwala im zaoferować najbardziej odpowiednie podejście do rozwoju.
Trening LLM obejmuje przygotowanie zbioru danych, wybór modelu i dostrojenie go do określonych zadań. Proces ten obejmuje czyszczenie danych, wybór cech, dostrajanie hiperparametrów i ocenę pod kątem rzeczywistych przypadków w celu zapewnienia dokładności.
Tak, LLM można dostroić przy użyciu danych specyficznych dla domeny, co poprawia wydajność w ukierunkowanych zadaniach, takich jak czat wsparcia, podsumowanie dokumentów lub rekomendacje sprzedaży. Dopracowanie wymaga dostosowania parametrów w oparciu o rzeczywiste dane, aby zapewnić trafność.
LLM są wykorzystywane w obsłudze klienta (chatboty), tworzeniu treści (generowanie tekstu), wyszukiwarkach (rozumienie zapytań) i analizie danych (podsumowanie). Mogą również pomóc w automatyzacji zadań, takich jak generowanie raportów, wykrywanie oszustw i systemy rekomendacji.
Chociaż LLM doskonale radzą sobie ze zrozumieniem języka, mogą generować halucynacje lub nieprawidłowe informacje. Wymagają również znacznych zasobów obliczeniowych do szkolenia i są wrażliwe na jakość danych. Dlatego wdrażamy RAG i dostrajanie, aby zarządzać tym ryzykiem.
LLM to zaawansowane modele AI szkolone na dużych zbiorach danych tekstowych. Rozumieją i generują tekst podobny do ludzkiego. Branże takie jak opieka zdrowotna, finanse, handel detaliczny i edukacja wykorzystują LLM do obsługi klienta, analizy danych, generowania treści i nie tylko.
Programiści Innowise LLM pracują z szeroką gamą modeli AI, w tym OpenAI GPT, BERT, T5 i zastrzeżonymi modelami dostosowanymi do konkretnych przypadków użycia. Oceniamy i wybieramy najlepsze modele w oparciu o wymagania dotyczące dokładności, kosztów i skalowalności.
ChatGPT to potężny LLM do konwersacji, ale jest to jeden z wielu modeli o unikalnych możliwościach. Chociaż doskonale nadaje się do zadań konwersacyjnych, w przypadku specjalistycznych zastosowań (takich jak opieka zdrowotna lub finanse), do uzyskania optymalnych wyników może być wymagany bardziej niestandardowy lub precyzyjnie dostrojony model.
The cost of LLM development depends on what you need. A solution built on an existing model costs less than a custom one with fine-tuning and a RAG pipeline. Running costs come mainly from model usage, infrastructure, and monitoring. After a discovery phase and a pilot, you get an estimate for both the initial build and ongoing operation and support.
It depends on the setup. For third-party LLM integration, we can send requests to the provider’s API in a region you choose, or host the model in your own cloud or on-premises so your data stays in your environment. Either way, we decide which data reaches the model and use enterprise agreements that keep it out of training.
You own the custom code, RAG pipeline, prompts, and configuration we build for your LLM solution, and we hand them over with documentation. Third-party models and open-source components stay under their own licenses, which we also list for you.
Wiadomość została wysłana.
Przetworzymy Twoją prośbę i skontaktujemy się z Tobą tak szybko, jak to możliwe.